


runesleo

ピーク時のランク 6
期間 8.8年
現在、コンテンツはありません
今日1日でClaudeの1週間分の利用枠を20%使ってしまい、ちょっと焦っている😅 このペースだと、木曜には使い切ってしまいそうだ。
振り返ると、利用枠を消費したのは大きな仕事ではなく、雑用を自分でやらせていたせいだった。スクリプト作成、イベントのチェック、設定変更など、何でもClaude自身にやらせていた。
午後に役割分担を変更した。Claudeは頭脳役に徹し、目標の分解、作業の割り振り、検収を担当する。継続的な業務ごとにGrok Botの責任者を1人ずつ置いて進めることにした。動画、オープンソース、クリエイター向けイベントにそれぞれ1人ずつ。
明日、今週を乗り切れるか見てみよう。
振り返ると、利用枠を消費したのは大きな仕事ではなく、雑用を自分でやらせていたせいだった。スクリプト作成、イベントのチェック、設定変更など、何でもClaude自身にやらせていた。
午後に役割分担を変更した。Claudeは頭脳役に徹し、目標の分解、作業の割り振り、検収を担当する。継続的な業務ごとにGrok Botの責任者を1人ずつ置いて進めることにした。動画、オープンソース、クリエイター向けイベントにそれぞれ1人ずつ。
明日、今週を乗り切れるか見てみよう。
「1つのAIが案を出し、1つが書き、1つがチェックする」。今日はこれを丸一日、実際に回してみました(Claudeが案出し+検収、Cursorがコードを書く)。そのまま使えるやり方にまとめました:
一、仕事を振るときは、この4点を明確にする
1. 変更するファイルと、触れてはいけないファイル
2. 完了の基準:たとえば「実データに対しては、まず変更内容のプレビューを出し、直接書き込んではならない」
3. 必ず追加するテスト。ただし、テストで実際のアカウントやデータに触れてはならない
4. 提出時に添付するもの:変更内容、テスト結果、変更プレビュー
二、検収時は「テストがすべて成功した」だけで済ませず、次の5つを1つずつ確認する
1. 肝心の処理は本当に実装されているか?(「不確定」を永遠に返すチェック関数を見つけたことがあります。テストはそれでもすべて成功していました)
2. 変更プレビューはあるか?プレビューを確認してから許可する(使える設定を壊してしまうバージョンを見つけたことがあります)
3. 失敗後に再試行したとき、同じ処理を二度実行してしまわないか?(再試行でメッセージを重複送信するケースを見つけました)
4. 実ファイルに書き込む前にバックアップを取るか、ワンクリックでロールバックできるか?
5. 「ついでに変更」した箇所に根拠はあるか?(サービスのアドレスを勝手に2つ変
最近、自分が参加したプロジェクトを振り返っていて、かなり身につまされる傾向に気づいた。
高値時の含み益はどれも悪くなく、何倍にもなったものもいくつかあった。
実際に利益確定できた額は、それほど多くない。
問題はプロジェクト選びではなく、どう売るかを事前に考えていなかったことだ。
今は自分にいくつかルールを決めている。
1. エントリー時に売却計画を書いておき、2倍になったらまず元本を回収する
2. 分割して売り、最高値を狙わない。売った後にさらに上がるのは、このルールのコストだ
3. 流動性を注視し、板の厚みや取引量が落ちたらすぐに一部を売る。売れない価格に意味はない
4. 振り返りでは2つの数字だけを見る。高値時の含み益と実際に利益確定した額。その差がどれくらいあったか
参加したら、一つは利益確定する。
@XCreators @Support クリエイターのサブスクリプション料金の変更が、9月21日から「保留中」のままです。1か月以上経ちますが、購読者にはまだ以前の料金が請求されています。
サポートチケットを送信したところ、担当者が折り返し連絡すると返信がありましたが、何も変わっていません。どなたか確認していただけますか? 🙏
サポートチケットを送信したところ、担当者が折り返し連絡すると返信がありましたが、何も変わっていません。どなたか確認していただけますか? 🙏
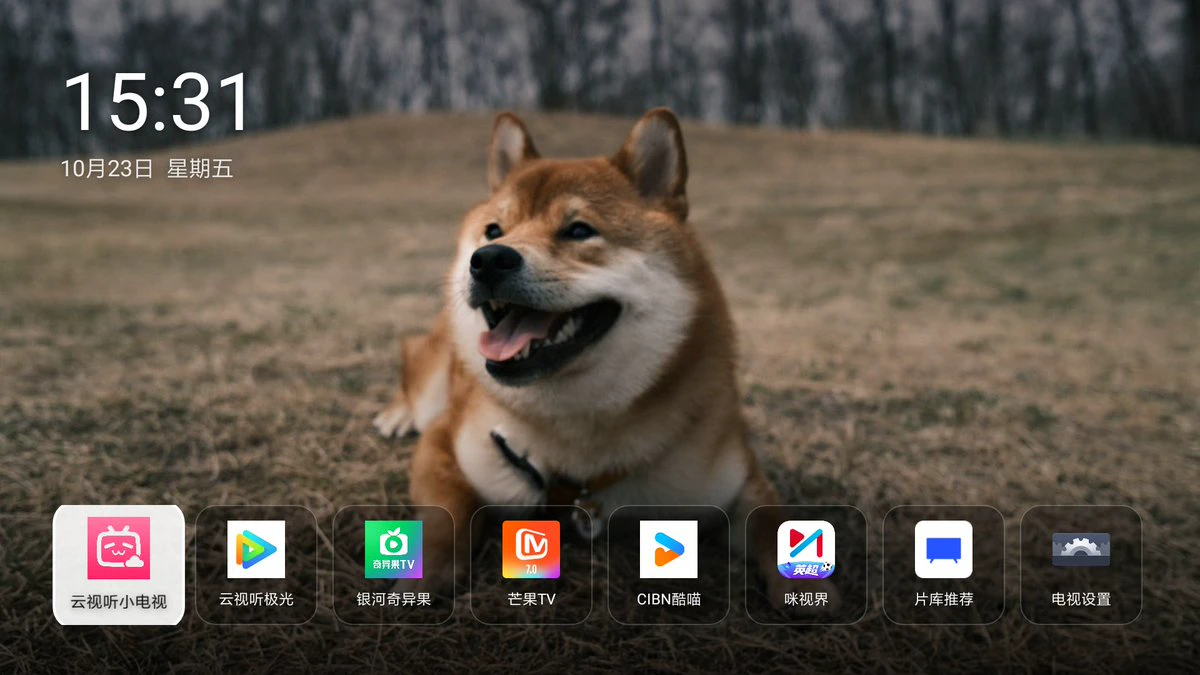
以前は、テレビやルーター、スピーカーのようなものは、買ったらそのままで、画面表示も広告も機能もメーカーの思いどおりだと思っていました。
この2日間、Claude Codeにリビングのテレビを改造してもらって、考えが変わりました。実はどれも家庭内ネットワークにつながった小さなコンピューターで、接続できればカスタマイズできるんです。
私がひと言言えば、こう変えてくれます:
「ホーム画面がダサい」→ 家の猫や犬の写真に変えて、よく使うアプリを下に並べる
「広告が多すぎる」→ DNSを変更して、広告とデータ送信を直接ブロック
「ちょっと重い」→ 使っていないバックグラウンドサービスを停止し、不要なアプリを削除
「テレビを消して」→ パソコンからひと言で電源オフ
最初から最後まで、私がリモコンを数回押しただけです。
あなたの家には、自分の思いどおりに改造したいネットワーク機器がほかにありますか?
Grok BotとClaudeを同時に使っているなら、そちらでは成果物の半分くらいが届いていない可能性が高いです。
AIチームが毎日やっている仕事は全部見えていると思っていました。調べてみると、会話は読めるのに、本当の成果物はクラウドPC内のファイルに書かれていました。クラウドPCは使われていないとネットワークが切断されるので、こちらから定期的に取りに行っても毎回タイムアウトし、エラーも出ません。
解決策は逆でした。こちらから取りに行くのではなく、Botが接続中のPCを使ってファイルをこちらにプッシュするようにします。記憶も双方向で同期し、競合した場合はローカルを優先します。修正したその日には、以前届かなかった成果物の大半が届きました。
もうひとつ落とし穴がありました。ファイルをコピーしたばかりだと、更新日時は新しくても、中身は実は1週間前のものだったりします。新旧を判断するには、AI自身がファイルに書き込んだ時刻を確認する必要があります。
オープンソースの小さなツールとSkillにまとめました。コマンドひとつで、各AIの会話、成果物、記憶が届いているか、新しいかを確認できます。複数のAIを一緒に使っている方は、そのまま使えます:
Cursorの利用枠は次のようになっています。Grok 4.7、Grok 4.6、Grok 4.5、Composer 2.5は週ごとの利用枠を共有しており、Autoも同じ枠を使います。
そのため、普段はAutoを使う必要はなく、Grok 4.7を直接選んで、設定をExtra Highにすれば大丈夫です。
今の使い分けは、Claudeの利用枠を使い切ったら、CursorのGrok 4.7に切り替えて代わりに使う、というものです。
そのため、普段はAutoを使う必要はなく、Grok 4.7を直接選んで、設定をExtra Highにすれば大丈夫です。
今の使い分けは、Claudeの利用枠を使い切ったら、CursorのGrok 4.7に切り替えて代わりに使う、というものです。
また launchd の落とし穴にはまった。
当番の AI がいて、定期的に codex exec を呼び出し、ほかの AI が提出した発見を仕分けしている。ターミナルで手動実行するとすべて正常なのに、launchd に定期実行させると何も処理されない。
調べてみると、launchd がプロセスを起動するとき、作業ディレクトリがルートディレクトリ / で、どの git リポジトリにも属していないのが原因だった。Codex はデフォルトで現在のディレクトリが git リポジトリかどうかを確認し、そうでなければ実行を拒否する。--skip-git-repo-check という引数を追加するだけで直り、ついでにデフォルトのコマンドが元に戻されないよう、テストも1つ追加した。
これは前回の python3 が brew relink されたときと同じ教訓だ。定期実行タスクと自分のターミナルは同じ環境ではない。「手動で実行したことがある」は、検証したことにはならない。
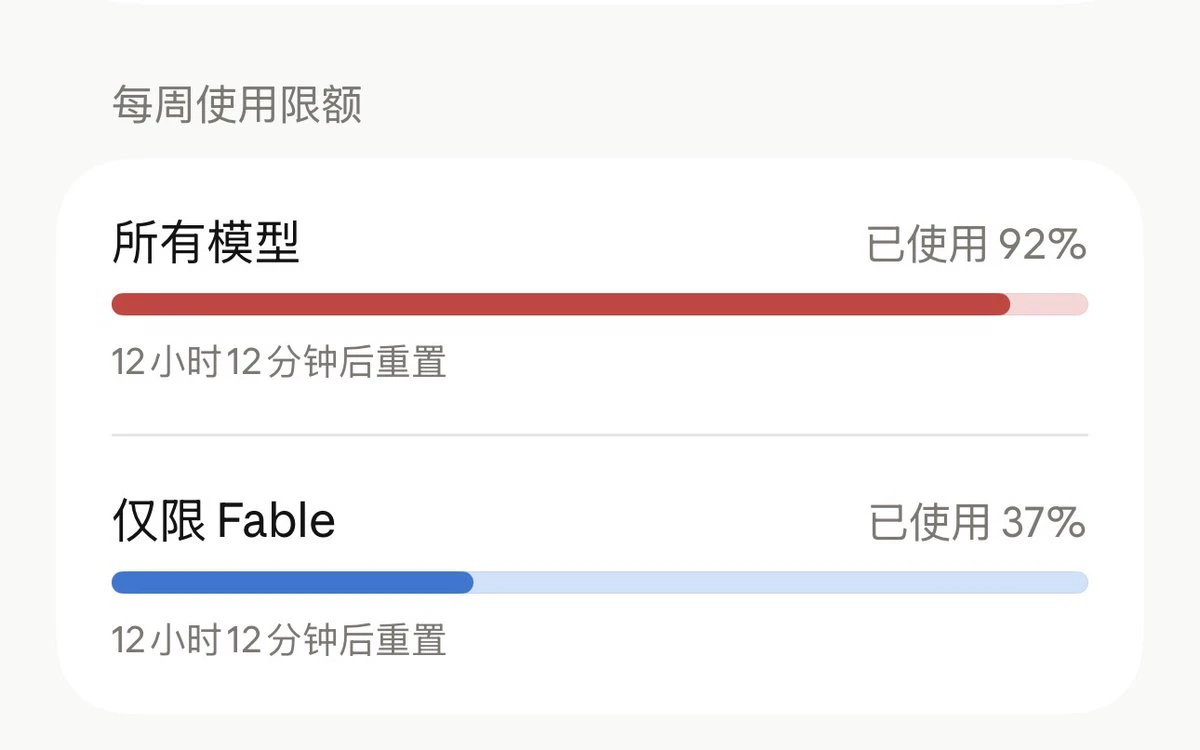
手動ではずっと Opus 5.5 だけを使っていたのに、今週は「Fable専用」の利用枠も37%使ってしまいました。
調べてみると、バックグラウンドで自動実行されるタスクが使っていました。以前、「自動タスクには一律で最強モデルを使う」と設定していたため、ルーターがデフォルトでそれらをすべてFableに割り当てていたのです。今週Fableで使われた量のうち、約4分の3は誰も見ていないバックグラウンドタスクによるものでした。
幸い、Fableには専用の利用枠があるので、バックグラウンドの作業に使っても無駄にはなりません。ただ、自分が手動で使うモデルと、実際に利用枠が消費される先は同じとは限らないことを覚えておく必要があります。
調べてみると、バックグラウンドで自動実行されるタスクが使っていました。以前、「自動タスクには一律で最強モデルを使う」と設定していたため、ルーターがデフォルトでそれらをすべてFableに割り当てていたのです。今週Fableで使われた量のうち、約4分の3は誰も見ていないバックグラウンドタスクによるものでした。
幸い、Fableには専用の利用枠があるので、バックグラウンドの作業に使っても無駄にはなりません。ただ、自分が手動で使うモデルと、実際に利用枠が消費される先は同じとは限らないことを覚えておく必要があります。
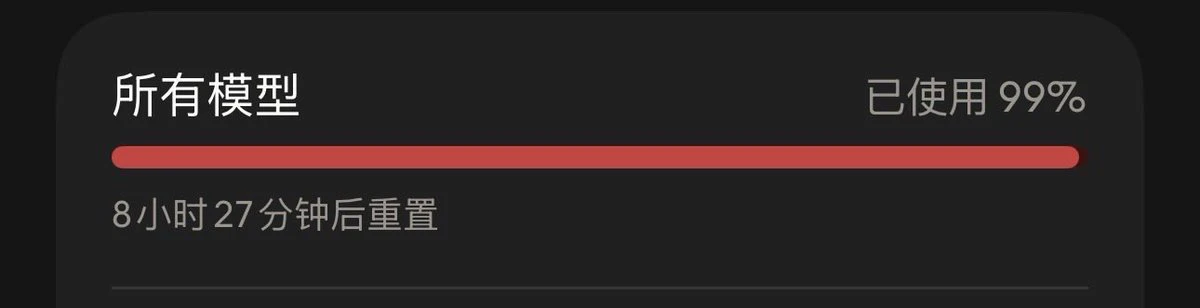
今週分のClaudeの利用枠を使い切ってしまった。これから8時間、何もせずに過ごすことになる。
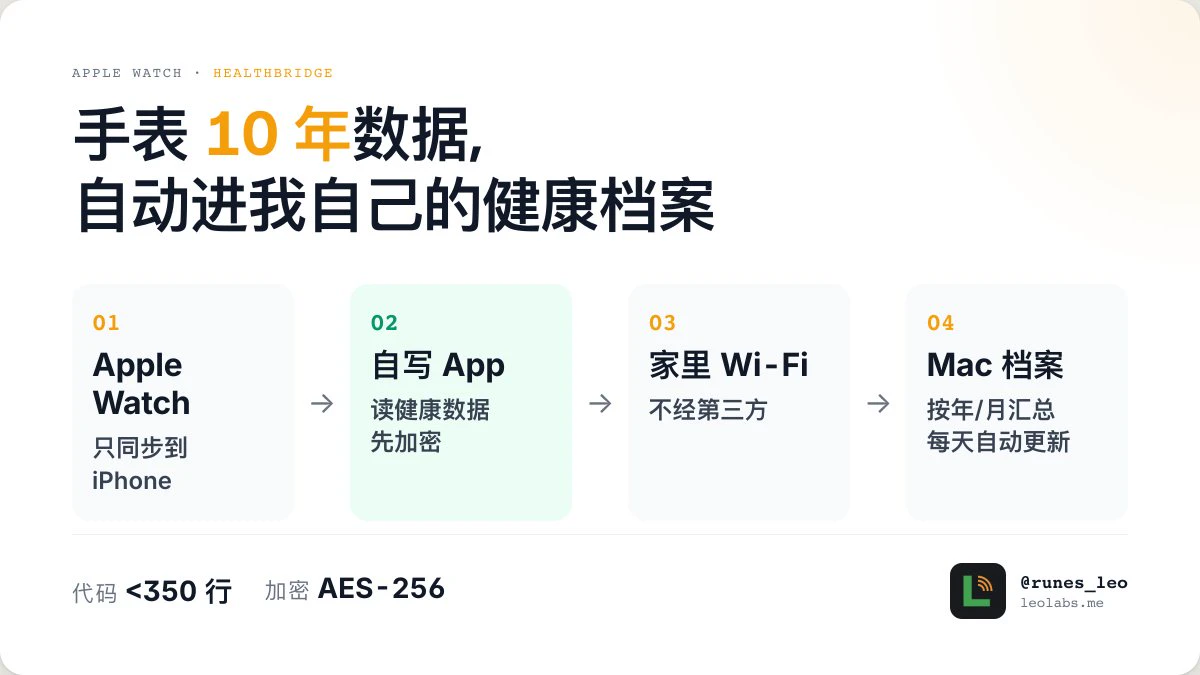
私の Apple Watch には10年分の健康データが眠っているのに、ずっとスマホで確認するしかありませんでした。
今日、AIを使って午後いっぱいかけ、歩数、心拍数、すべてのトレーニングを自分の健康記録に取り込みました。これからは毎日自動で更新されます。
先に結論を言うと、Apple WatchのデータはWi-Fiから直接読み取れません。
時計はiPhoneとしか同期せず、唯一の出口はiPhoneの「ヘルスケア」です。しかも、スマホにインストールされ、許可を与えたAppだけが読み取れます。
だから方法はひとつだけ。自分で小さなAppを書いて、データを運ぶ役にすることです。
このAppは350行未満で、AIが書きました:
· 歩数、アクティブ消費カロリー、運動時間、心拍数、すべてのトレーニングを読み取る
· 時計が新しいトレーニングを同期すると、システムがバックグラウンドで起動し、自動送信する
· ボタンひとつで過去のデータをすべて送信。私のデータは2016年までさかのぼります
無料のApple IDがあれば自分のスマホにインストールできます
健康データの扱いにはかなり厳しくしています:
· スマホ上でAES-256暗号化してから送信し、鍵そのものはネット上に送らない
· 家のWi-Fiにつながった自分のMacにだけ送信し、第三者を一切経由しない
· 改ざんされたもの、鍵が合わない
ChatGPT Proは今回の契約が11月中旬までなので、ひとまず更新しません。
最近、GPTの各モデルを実際の仕事に使ってみると、あまり使い勝手がよくありません。それに、10月30日からProのCodexとWorkの利用枠も半減します。
今後の主力は、判断と仕上げをClaudeに、Xの監視や情報収集をGrok BotとGrok Buildに、コーディングをCursorに任せます。
完全にやめるわけではありません。ChatGPTに本当に強力な新モデルが登場したり、価値のある大きなアップデートがあったりしたら、また契約します。サブスクリプションは習慣ではなく、モデルに合わせて選びます。
最近、GPTの各モデルを実際の仕事に使ってみると、あまり使い勝手がよくありません。それに、10月30日からProのCodexとWorkの利用枠も半減します。
今後の主力は、判断と仕上げをClaudeに、Xの監視や情報収集をGrok BotとGrok Buildに、コーディングをCursorに任せます。
完全にやめるわけではありません。ChatGPTに本当に強力な新モデルが登場したり、価値のある大きなアップデートがあったりしたら、また契約します。サブスクリプションは習慣ではなく、モデルに合わせて選びます。
AIに毎日いくつかの X Chat グループ向けに閲覧専用の日報を作らせていて、その中に、グループ内にルール変更やセキュリティリスクなどの兆候が出ていないか確認する項目があります。昨日、「ルール/リスクの変化」という報告が1件上がりました。開いてみると、実際の発言は、誰かがある書き方について「少し hacky だ」と言っていただけでした。英語のリスクワードは部分文字列でマッチする設定だったため、hacky の中にちょうど hack が含まれていて、ヒットしたのです。今は英単語を単語単位でマッチするように変更したので、この誤検知はなくなりました。
キーワードアラートで最も怖いのは、こうした誤検知です。何度も続くと誰も見なくなり、本当に問題が起きたときのアラートまで一緒に見過ごされてしまいます。中国語には自然な単語境界がないため、この問題については別の方法も考える必要があります。
キーワードアラートで最も怖いのは、こうした誤検知です。何度も続くと誰も見なくなり、本当に問題が起きたときのアラートまで一緒に見過ごされてしまいます。中国語には自然な単語境界がないため、この問題については別の方法も考える必要があります。
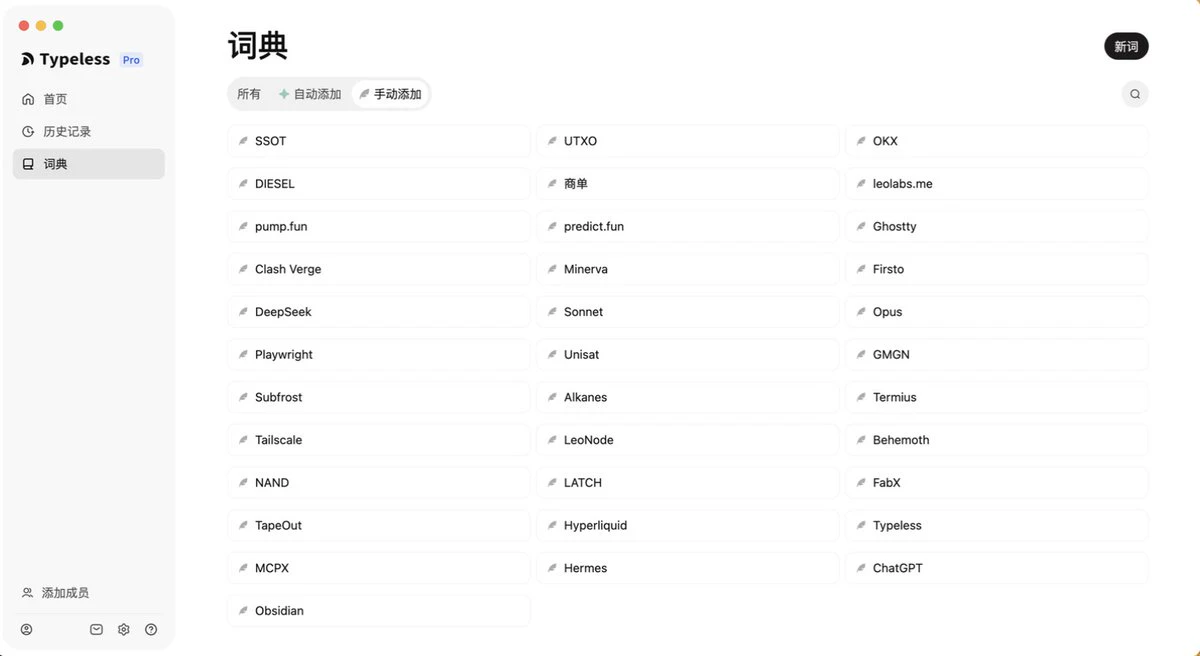
半年以上 Typeless を使ってきましたが、今日 AI に辞書の整理を手伝ってもらったところ、結果はかなり意外でした:
自動で追加された280個の単語のうち、110個は削除すべきものでした――「wait」「0号」「好几十u」のような細切れの単語や、同じ単語の複数の表記、さらには OpenClaw を OpenCloud と聞き間違えた誤った単語まで。辞書は本来、認識を助けるためのものなのに、これではかえって混乱の原因になります。
やり方はとても簡単です:
1. 音声入力の記録はすべてローカルにあるので、AI に自分が実際によく使う単語を集計してもらう
2. それを辞書と照合する:表記を統一し、間違ったものを削除し、不足しているものを追加する(今回は30個以上追加しました)
音声入力を使っている方は、定期的に整理してみるとよいと思います。数分で終わります。
- 1
数日前、私の X のダイレクトメッセージリクエストの通知が何度も重複して表示されていました。すでに処理したリクエストなのに、しばらくするとまたポップアップ表示されるのです。調べてみると、問題は重複排除用のフィンガープリントにありました。フィンガープリントはリクエストの全文から作られており、末尾には相手のプロフィールにあるフォロワー数が含まれていました。相手のフォロワーが1人増えるだけでフィンガープリントが変わり、システムは新しいリクエストだと判断していたのです。修正方法は簡単で、フォロワー数の部分をフィンガープリントから取り除き、変わらない部分だけを残せばよいのです。
私の判断では、重複排除を行う際、キーには安定した識別情報のフィールドだけを入れるべきです。フォロワー数や時刻、カウントのように変動する表示用の数値をキーに含めると、決して消えない重複の原因になってしまいます。
私の判断では、重複排除を行う際、キーには安定した識別情報のフィールドだけを入れるべきです。フォロワー数や時刻、カウントのように変動する表示用の数値をキーに含めると、決して消えない重複の原因になってしまいます。
募集|天気市場のデータソース、Polymarketの5分足バックテストデータはどこから入手していますか?
TGグループではここ数日、データについて繰り返し質問が出ており、主に次の3種類に集中しています:
· 天気市場のデータソースはどこで探せるか
· Polymarketの5分足レベルのバックテストデータはあるか
· PnLを確認できるサイトはあるか。できればPM上の帳簿上の利益と、手数料を差し引いた実際の利益を区別できるもの
毎回グループ内で個別に回答しても流れてしまうので、ここで皆さんが実際に使ったリストをまとめてみませんか。
1行で構いません:データの種類+入手先またはツール+遭遇した問題(遅延、項目不足、課金、それとも自分でスクレイピングが必要か)。
聞いたことがあるだけで、実際には使ったことがないものでも投稿して構いません。その場合は後ろに「未検証」と一言添えてください。
十分に集まったら、整理してここに掲載し直します。
POLYMARKET-0.85%
Metaのエンジニアリングチームは、直感に反する結論を共有しました。エージェントに与える知識が多いほど、間違いを犯しやすくなるというのです。
彼らは最初、何でも知っている万能エージェントを作りました。デモは問題ありませんでしたが、本番環境に投入すると、Aシステムの命名規則をBに適用するなど、別のシステムの文脈が混ざり始めました。改善策は、より良いプロンプトを書くことではなく、中央で調整するエージェントに何も覚えさせないことでした。1,300行のコードで、分類、フィールドの収集、チェック、作業の割り振りだけを担当させ、14個の専門エージェントがそれぞれ一つの領域を管理し、互いの情報は見えないようにしました。新しい要件には新しいエージェントを追加せず、処理フローの並べ替えで対応します。
私も7月に、自分用のAIルールを一度スリム化しました。全体では、どこでも守るべきルールを数個だけ残し、具体的な領域の細則は必要に応じて読み込むようにしました。その後、文脈が混ざることは大幅に減りました。
ChatGPTは昨日またひっそりとフロントエンドを変更した。私はウェブ版に自動で指示を送るスクリプトを使っていて、ずっと #prompt-textarea というidで入力欄を特定していたのだが、昨日突然見つけられなくなった――入力欄がProseMirrorのリッチテキストエディターに置き換えられ、あの古いidが直接なくなったのだ。こうした変更について公告は一切なく、自動化が壊れて初めて気づくしかない。教訓は、ウェブページのDOMに依存する自動化では、1つのidに固執せず、できるだけ予備のセレクターも用意しておくべきだということだ。そうしないと、相手が一度バージョンアップしただけで、連携全体がその場で沈黙してしまう。
昨日、私の自動化スクリプト群が突然一斉に動かなくなった。半日ほど調べて、コードの問題ではないことが分かった――brewのアップグレード時にpython3が自動的に3.15へ再リンクされ、新しいsite-packagesが空になっていて、以前pipでインストールした依存関係が一つも残っていなかった。さらに厄介なのは、スクリプトが依存関係の不足を明確に報告せず、importがわけもなく失敗することだ。後から監視に、毎日一度はpython3の依存関係が残っているか個別にcheckする処理を追加した。brewが何か変更しても、すぐに発見できる。システムのパッケージマネージャー任せで本番用の自動化を動かすなら、本当に注意しておいたほうがいい。向こうはこちらに確認もせず勝手にアップグレードしてくる。
もっと詳しく
人気の話題
#USEarningsSeason
22.53k 閲覧数2.98k件の議論
#GateWCTCS9GlobalTradingCompetition
462.32k 閲覧数7.66k件の議論
#BTCDropsBelow81000
126.73k 閲覧数38.15k件の議論
#USTechStocksSellOff
16.21k 閲覧数3.27k件の議論
#GateQ3ReportReleased
18.82k 閲覧数3.73k件の議論
#KOSPIFallsNearly4%
13.38k 閲覧数1.81k件の議論
#SpotGoldFallsBelow$4000
16.83k 閲覧数8.03k件の議論
#GateSquareNewCreatorProgram
36.28k 閲覧数6.85k件の議論
#MetaEarningsBeatExpectations
15.71k 閲覧数285件の議論
#DataCentersMayFaceOversupplyBy2028
7.83k 閲覧数2.41k件の議論