Para iniciantes que estão mapeando os limites das capacidades de IA, um modelo de mundo responde se um sistema consegue antecipar as consequências de ações, não se consegue escrever respostas fluentes. As seções abaixo abordam a definição, o ciclo de previsão, três abordagens técnicas, a seleção de tarefas entre modelo de mundo e LLM, as diferenças em relação à geração de vídeo, os casos de uso e os limites de avaliação. Conceitos relacionados aparecem nos conteúdos explicativos do Gate Learn sobre superinteligência (ASI) e IA privada.
Principais conclusões
- A capacidade central é a previsão condicionada à ação: dado um estado e uma ação, gerar o próximo estado, ou a próxima representação, para planejamento e controle.
- Três abordagens comuns: RL baseado em modelo (MBRL) / treinamento por imaginação, simulação interativa generativa e representações preditivas no estilo JEPA.
- Grandes modelos de linguagem se destacam na previsão do próximo token, e geradores de vídeo, na continuidade visual. Nenhum dos dois equivale automaticamente a um modelo de mundo planejável.
- A avaliação deve observar física simulada incorretamente, desvio em horizontes longos, falhas fora da distribuição, métricas rigorosas e a fronteira com simuladores programados manualmente.
O que é um modelo de mundo e qual problema ele resolve?
Um modelo de mundo responde a uma questão prática: antes de um agente agir, ele consegue estimar de forma confiável o que acontecerá em seguida? Sem essa capacidade, o aprendizado depende de tentativa e erro no mundo real, algo frequentemente caro, lento ou inseguro, e o planejamento offline se torna difícil.
Em robótica, direção autônoma, agentes de jogos e treinamento por simulação, especialmente para agentes incorporados em ambientes virtuais ou físicos, o feedback é caro ou arriscado. Por exemplo, uma política de direção inadequada pode causar um acidente real antes de aprender. Um modelo de mundo transfere a “tentativa de ações” para dinâmicas aprendidas: avança no espaço latente ou de observação e, em seguida, aplica uma política mais robusta ao mundo real. Esse objetivo difere de sistemas conversacionais que principalmente reproduzem conhecimento. Ele se aproxima mais da antecipação causal em um ambiente interativo.
A entrada do glossário da NVIDIA sobre modelos de mundo os descreve como representações internas que ajudam a IA a compreender e prever como o mundo físico evolui; o texto de Yann LeCun, A Path Towards Autonomous Machine Intelligence, posiciona modelos de mundo preditivos em um caminho rumo a uma inteligência mais autônoma; e o trabalho “World Models”, de David Ha, de 2018, ajudou a definir a abordagem moderna baseada em aprendizado. Um agente normalmente observa apenas partes do ambiente, portanto o estado completo não está disponível diretamente. Em todas essas perspectivas, a previsão existe para apoiar decisões.
Como funciona um modelo de mundo? Estado, ação e ciclo de previsão
O teste mais consistente para um sistema orientado a modelos de mundo é a previsão condicionada à ação: se as entradas incluem explicitamente a ação de um agente, ou sinal de controle, e se a saída é o próximo estado ou a próxima representação condicionada a essa ação.
O ciclo geralmente se resume a três etapas: codificar observações em um estado; condicionar esse estado a uma ação candidata; prever o próximo estado, enquanto o ambiente muda após essa ação e retorna novas observações. Opcionalmente, a previsão pode avançar como um novo ponto de partida. Uma política ou planejador compara trajetórias imaginadas com base em recompensa, risco ou restrições e então executa uma ação; uma nova observação reinicia a codificação.
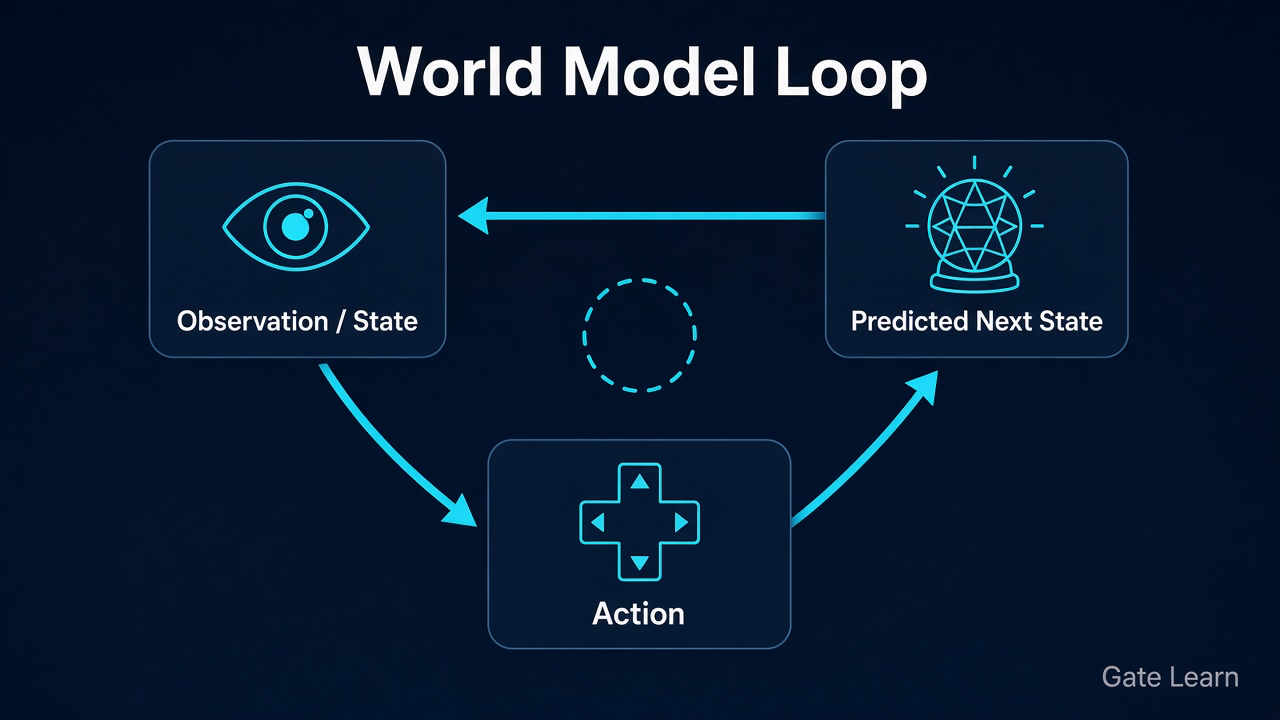
Figura 1. Ciclo do modelo de mundo: observação/estado mais ação gera um próximo estado previsto, que alimenta o próximo ciclo.
Muitos sistemas práticos evitam prever longos horizontes em pixels brutos e, em vez disso, aprendem dinâmicas latentes: comprimem dados visuais de alta dimensão em um estado compacto e avançam nesse espaço. Simulações no espaço latente reduzem o ruído visual e tornam o treinamento por imaginação mais barato. Ainda é necessário validar, com tarefas posteriores e verificações fora da distribuição, se o estado latente permanece fiel à física real, especialmente porque o ambiente físico é apenas parcialmente observado e deve ser inferido por meio de feedback.
Quais são as principais abordagens técnicas para modelos de mundo?
“Modelo de mundo” é um rótulo amplo que abrange várias famílias técnicas, não o nome de um único algoritmo. A escolha começa pelo objetivo: políticas controláveis, simulação interativa em pixels ou representações abstratas transferíveis.
| Abordagem |
Ideia central |
Melhor aplicação |
Principal custo |
| MBRL / treinamento por imaginação |
Aprende dinâmicas e, em seguida, treina uma política com simulações do modelo (Dreamer) |
Controle, jogos, RL eficiente em amostras |
Erro do modelo compromete a política; desvio |
| Simulação interativa generativa |
Aprende um ambiente interativo que gera os próximos quadros/observações |
Aumento de dados, mundos de vídeo interativos |
Aparência ≠ física; avaliação cara |
| Representações preditivas JEPA |
Prevê embeddings futuros ou mascarados no espaço de representação (I-JEPA) |
Aprendizado de representações, previsão abstrata para planejamento |
Não gera pixels; exige uma pilha de controle |
Uma abordagem pode se concentrar em um modelo de vídeo que prevê quadros futuros, enquanto outra busca dinâmicas latentes prontas para planejamento, em vez de reconstrução visual completa.
As três abordagens podem coexistir: métodos no estilo Dreamer enfatizam o treinamento de políticas por imaginação; modelos generativos de mundo em vídeo enfatizam a simulação visual interativa; e o I-JEPA da Meta AI demonstra previsão em um espaço de embeddings conjunto, em vez de reconstruir cada pixel. Sistemas diferentes também adotam receitas de treinamento distintas, dependendo de aprenderem com pares de entrada e saída, simulações de controle ou embeddings preditivos. Primeiro alinhe a tarefa e, depois, discuta os nomes.
Como os modelos de mundo diferem de LLMs e da geração de vídeo?
Os três “preveem”, mas, dentro da IA generativa, preveem objetos diferentes e diferem quanto ao condicionamento por ação: LLMs preveem o próximo token, geradores de vídeo preveem a aparência do próximo quadro e sistemas orientados a modelos de mundo preveem como o estado evolui após uma ação.
| Dimensão |
Modelo de mundo |
Grande modelo de linguagem (LLM) |
Geração de vídeo |
| Alvo principal da previsão |
Próximo estado / dinâmicas latentes, geralmente condicionados à ação |
Próximo token / estrutura de texto |
Aparência do próximo quadro ou clipe |
| Relação com ação |
A previsão condicionada à ação é o eixo de decisão |
Normalmente sem ciclo de controle físico |
Pode ser condicionado a texto/primeiro quadro, mas não é executável |
| Uso típico |
Planejamento, controle, IA incorporada |
Linguagem, escrita, orquestração de ferramentas |
Geração de conteúdo, prévias, simulações interativas |
| Confusão comum |
Capacidade de conversar = modelo de mundo |
Escrever sobre física = habilidade física |
Quadros fotorrealistas = dinâmicas corretas |
Assim, um gerador de vídeo semelhante ao Sora pode exibir quadros coerentes com alta fidelidade visual e até aparente consistência espacial, e pode receber o rótulo de “modelo de mundo em vídeo”. No entanto, essas características isoladamente não comprovam compreensão física. Sem uma interface de ação estável, transições de estado verificáveis e um ciclo de planejamento, a categoria correta continua sendo vídeo generativo. Um sistema mais robusto também pode avaliar sequências de ações para apoiar planejamento e tomada de decisões, não apenas renderizar passivamente visões prováveis. Um LLM pode descrever “o que acontece se você empurrar o copo”, mas isso não cria dinâmicas de ambiente que possam ser simuladas e avaliadas.
A IA incorporada é um contexto frequente: braços robóticos e robôs móveis precisam de inteligência espacial, ou seja, raciocinar sobre layouts, movimento e mudanças no mundo físico, além de prever contato e deslocamento antes de tocar em objetos, pois muitas interações são difíceis de reverter quando o movimento começa. A previsão condicionada à ação permite que os sistemas descartem trajetórias que falham em simulação ou no espaço latente antes de arcar com o custo de colisões reais. Demonstrações podem inicializar comportamentos, mas não substituem o aprendizado baseado em interação.
Jogos e aprendizado por reforço baseado em modelo são outra área central. Métodos no estilo Dreamer aprimoram políticas em trajetórias imaginadas, permitindo obter controle utilizável com menos interações reais. Ideias semelhantes são transferidas para registros de controle industrial nos quais um simulador programado manualmente é incompleto, mas há um histórico abundante de observações, pois o modelo tenta capturar as dinâmicas do sistema a partir desse histórico.
Direção autônoma, programação de armazéns e simulações multiagente também incorporam componentes de modelo de mundo, não como substituição completa das pilhas de planejamento, mas como uma camada de consequências de curto horizonte. Testes virtuais e dados de vídeo selecionados costumam ser usados para treinar e avaliar esses componentes em diferentes cenários antes da implantação real. Qualquer sistema de controle que precise “pensar antes de agir” pode incluir um módulo de modelo de mundo.
Quais vantagens, riscos e limites são importantes ao avaliar modelos de mundo?
O benefício é a eficiência de amostras e uma tentativa e erro mais segura: imaginar dentro de um modelo pode reduzir a exploração perigosa, e previsões condicionadas à ação podem basear o planejamento em dinâmicas inspecionáveis. Limites e riscos costumam surgir quando um modelo parece correto, mas não é confiável, pois uma representação interna bem elaborada não equivale a um comportamento que resiste à implantação.
| Mecanismo |
O que você observa |
Por que pode passar despercebido |
Perguntas de verificação |
| Física simulada incorretamente |
Trajetórias suaves que violam conservação ou contato |
A visão confia na fluência visual |
As quantidades essenciais são conservadas? Objetos podem atravessar outros objetos? |
| Desvio em horizontes longos |
Simulações curtas funcionam; as longas entram em colapso |
Demonstrações favorecem clipes curtos |
Como o erro cresce com as etapas? Há replanejamento? |
| Falha fora da distribuição |
Falha com novos objetos, iluminação ou intervalos de ação |
Pontuações dentro da distribuição parecem robustas |
Há protocolo OOD? Os modos de falha são públicos? |
| Avaliação rigorosa |
Não há uma pontuação compartilhada para “compreensão do mundo” |
O sucesso da tarefa absorve a métrica |
Além da pontuação da tarefa, o erro de previsão é informado? |
| Fronteira com simuladores programados manualmente |
Modelos aprendidos são tratados como mecanismos verificados |
O marketing mistura simulador e modelo de mundo |
Quais restrições são codificadas? Quais são apenas ajustes? |
A transferência para a realidade é difícil devido à lacuna entre simulação e mundo real. Bons testes devem perguntar se o modelo prevê resultados controláveis sob ações, e não apenas imagens plausíveis.
Use a tabela como uma lista de verificação de alegações: confirme uma interface condicionada à ação, exija evidências de longo horizonte e fora da distribuição e, por fim, separe “parece bom” de “as dinâmicas são planejáveis”. Sem essas evidências, uma descrição mais segura é “inclui componentes de modelo de mundo ou objetivos de pesquisa”, e não “possui um modelo de mundo completo”. Como os agentes têm capacidade limitada, a avaliação deve se concentrar no estado relevante para o objetivo, e não na reprodução completa da cena.
Resumo
Os modelos de mundo levam a IA de “consegue conversar / consegue desenhar” para “consegue antecipar as consequências de ações”, como prever que um robô derrubará um copo se seguir o caminho errado. O núcleo operacional é um ciclo fechado de estado, ação e previsão, sendo a previsão condicionada à ação o eixo de decisão mais claro.
As três abordagens, MBRL/treinamento por imaginação, simulação interativa generativa e representações preditivas JEPA, atendem a objetivos diferentes e não são intercambiáveis. Em comparação com LLMs e geradores de vídeo, compare os alvos de previsão e as interfaces de ação. Na avaliação, priorize física simulada incorretamente, desvio, falha OOD, métricas rigorosas e fronteiras com simuladores.
Perguntas frequentes
O que é um modelo de mundo?
Um modelo de mundo é um modelo interno de dinâmicas aprendido, que representa como um ambiente pode mudar dado um estado atual, ou observação, e uma ação. O mundo em determinado momento é mais rico do que um agente pode observar diretamente, por isso o modelo resume as variáveis importantes para o planejamento, por exemplo, onde um robô termina após virar à esquerda. Seu objetivo é apoiar o planejamento e a tentativa e erro por imaginação, não apenas gerar texto ou aparência de vídeo.
Como um modelo de mundo difere de um grande modelo de linguagem?
Grandes modelos de linguagem preveem principalmente o próximo token e se destacam em linguagem e orquestração de conhecimento. Modelos de mundo preveem principalmente como o estado evolui após ações para controle e planejamento. Um LLM pode discutir física sem fornecer dinâmicas de ambiente que possam ser simuladas e avaliadas.
Como funciona um modelo de mundo?
Um ciclo típico codifica observações em um estado, condiciona esse estado a uma ação candidata, prevê o próximo estado após essa ação e pode avançar no espaço latente. Um planejador compara simulações imaginadas, executa uma ação e, em seguida, atualiza o estado com base em uma nova observação.
O Sora ou a geração de vídeo contam como modelo de mundo?
Não automaticamente. Se um sistema produz principalmente vídeos visualmente coerentes, sem uma interface estável condicionada à ação, transições de estado verificáveis e uso para planejamento, ele é melhor descrito como um gerador de vídeo. Ele se aproxima de um modelo de mundo apenas quando demonstra previsão condicionada à ação e um ciclo planejável.
Como um modelo de mundo difere de um simulador tradicional?
Simuladores tradicionais geralmente codificam regras e restrições físicas programadas manualmente, enquanto modelos de mundo orientados por dados costumam ser aprendidos com redes neurais. Modelos aprendidos podem ser mais flexíveis e mais próximos do ruído de sensores, mas também são mais propensos a física simulada incorretamente e desvio em horizontes longos, portanto não devem ser considerados equivalentes a um mecanismo de física verificado.