À medida que a IA generativa se expande do treinamento de modelos para aplicações comerciais em larga escala, o foco da concorrência no mercado de computação para IA também está mudando. As empresas não precisam apenas treinar modelos mais avançados, mas também processar solicitações de usuários continuamente com custos controlados, executar agentes de IA, gerar voz e fornecer serviços interativos em tempo real. Nesse contexto, a arquitetura especializada de aceleração de inferência representada pela Groq tem atraído cada vez mais atenção. Este artigo analisa o posicionamento corporativo da Groq, a tecnologia LPU, o modelo de negócios da GroqCloud e a concorrência do setor para avaliar seu papel na infraestrutura de inferência de IA, bem como os desafios técnicos e comerciais enfrentados pela abordagem de chips especializados.
Principais pontos
- A Groq é uma empresa de tecnologia focada em inferência de IA. Suas principais tecnologias incluem chips LPU, compiladores e infraestrutura de inferência de suporte.
- O treinamento e a inferência de IA têm diferentes requisitos computacionais. A inferência em tempo real dá importância especial ao tempo até o primeiro token, à velocidade de geração e à estabilidade do serviço.
- As LPUs da Groq otimizam cargas de trabalho específicas de inferência de IA por meio de SRAM no chip, execução determinística e codesign de hardware e software.
- A GroqCloud transforma capacidades computacionais subjacentes em APIs de nuvem, permitindo que desenvolvedores chamem modelos de IA compatíveis.
- LPUs e GPUs diferem em arquitetura e cenários de aplicação. O desempenho geral não pode ser avaliado apenas com base na velocidade de geração de um único token.
- A competitividade comercial de longo prazo da Groq depende da escalabilidade dos chips, de seu ecossistema de software, dos custos de inferência, da demanda dos clientes e do retorno sobre o investimento em infraestrutura.
O que é a Groq? Qual é seu papel na cadeia de valor da computação para IA?
A Groq é uma empresa de tecnologia focada em computação para inferência de IA. Ela foi fundada em 2016 por Jonathan Ross, que participou anteriormente do projeto Google TPU. A empresa desenvolve principalmente chips especializados de aceleração de IA, compiladores e sistemas de computação para inferência, além de fornecer capacidades de inferência de modelos a desenvolvedores e empresas por meio de serviços como a GroqCloud.
É importante observar que Groq e Grok não são o mesmo produto. Groq é um nome de tecnologia relacionado à infraestrutura de computação para IA, enquanto Grok é um modelo de inteligência artificial e produto de assistente desenvolvido pela xAI. Embora seus nomes sejam semelhantes, eles pertencem a empresas diferentes e têm posicionamentos técnicos e modelos de negócios distintos.
Na cadeia de valor de IA, a Groq está posicionada principalmente na camada de infraestrutura computacional. Uma aplicação completa de IA generativa normalmente envolve desenvolvimento de modelos, capacidade computacional de treinamento, implantação de inferência, interfaces de aplicação e serviços para usuários finais. O principal negócio da Groq não é desenvolver modelos de chat de uso geral para consumidores. Em vez disso, seu objetivo é fornecer ambientes de inferência de alto desempenho para diferentes modelos.
Por exemplo, ao criar um assistente de IA em tempo real, os desenvolvedores podem selecionar um modelo já treinado e usar um serviço de inferência para processar a entrada do usuário. O modelo compreende perguntas e gera conteúdo, enquanto a plataforma computacional subjacente determina a velocidade de execução do modelo e quantos recursos computacionais cada solicitação consome.
A otimização desse processo computacional está no centro da proposta de valor da Groq. Por meio de processadores e sistemas de software especialmente projetados, a Groq reduz a sobrecarga de execução para determinadas tarefas de inferência, permitindo que os modelos gerem respostas mais rapidamente.
Esse posicionamento significa que a oportunidade de mercado da Groq depende não apenas de um modelo específico de IA se tornar popular, mas também da demanda por inferência em todo o setor de IA generativa, das arquiteturas de modelos e das mudanças nos custos computacionais.
Por que o setor de IA está dando mais atenção à computação para inferência?
A computação para IA geralmente pode ser dividida em duas etapas: treinamento e inferência. O treinamento envolve o uso de grandes volumes de dados para ajustar os parâmetros do modelo, permitindo que ele adquira capacidades como compreensão de linguagem e reconhecimento de imagens. A inferência se refere a um modelo treinado que recebe uma nova entrada e gera uma saída com base em seus parâmetros existentes.
Ambos exigem recursos computacionais, mas suas cargas de trabalho diferem significativamente. O treinamento de modelos normalmente envolve o processamento de grandes conjuntos de dados, o cálculo de gradientes e a atualização de parâmetros. Ele enfatiza a computação paralela em larga escala, a capacidade de memória e a coordenação entre vários dispositivos. A inferência, por outro lado, precisa gerar resultados rapidamente em resposta às solicitações dos usuários. Isso é especialmente importante em aplicações de chat, voz e automação, nas quais os tempos de resposta afetam diretamente a experiência do usuário.
Para modelos de linguagem de grande porte, o processo de inferência geralmente inclui duas etapas: Prefill e Decode. O Prefill processa o prompt de entrada e estabelece o estado computacional relevante, enquanto o Decode gera Tokens subsequentes um por vez. Como os modelos de linguagem autorregressivos geralmente precisam prever o próximo Token com base no conteúdo já gerado, o processo de geração contínua impõe exigências significativas à eficiência de acesso à memória e aos agendamentos computacionais.
Usuários de aplicativos de chat comuns podem tolerar uma breve espera. No entanto, em assistentes de voz em tempo real, atendimento ao cliente automatizado e cenários interativos de IA, a latência de resposta pode afetar diretamente o quão natural uma conversa parece. Se um modelo demora muito para gerar a primeira parte de uma resposta ou se sua velocidade de saída for insuficiente para a comunicação em tempo real, ele poderá ter dificuldade em atender aos requisitos práticos de negócios, mesmo que o próprio modelo seja altamente capaz.
O desenvolvimento de agentes de IA aumentou ainda mais a demanda por inferência. Diferentemente de interações pontuais de perguntas e respostas, um agente de IA pode precisar chamar vários modelos, analisar dados externos, executar operações de ferramentas e verificar resultados. Uma única tarefa de usuário pode gerar várias rodadas de raciocínio interno e diversas solicitações de API, aumentando o consumo computacional total.
Como resultado, a concorrência em infraestrutura de IA está se expandindo além da simples busca por maiores capacidades de treinamento de modelos. Agora, ela também se concentra na entrega de serviços de inferência com menor latência, maior throughput e custos mais razoáveis.
No entanto, o crescimento da demanda por inferência não significa que a computação para treinamento esteja se tornando menos importante. O treinamento de novos modelos, o ajuste fino de modelos e a prestação de serviços de inferência podem continuar crescendo simultaneamente. A diferença é que os requisitos de hardware para diferentes tarefas computacionais estão se tornando mais especializados.
Quais são as principais características da abordagem tecnológica LPU da Groq?
LPU é o termo técnico usado pela Groq para descrever seu processador especializado de inferência. Em comparação com GPUs de uso geral projetadas para uma ampla variedade de tarefas computacionais, o design da LPU é mais voltado para computação, movimentação de dados e controle de latência em cargas de trabalho específicas de IA.
A tecnologia LPU da Groq pode ser compreendida por meio de três aspectos: memória no chip, execução determinística e compiladores.
Como a SRAM no chip afeta a eficiência de acesso aos dados?
A computação moderna para IA é limitada não apenas pelas capacidades aritméticas de um chip, mas também pela velocidade de acesso e transferência de dados. Durante a inferência de modelos de linguagem de grande porte, as unidades de computação precisam acessar continuamente os pesos do modelo e dados intermediários. Se os dados não puderem ser entregues a tempo, o processador poderá não utilizar plenamente seus recursos, mesmo que tenha alta capacidade computacional teórica.
Uma característica importante das LPUs da Groq é a ênfase na SRAM no chip, ou memória estática de acesso aleatório. A SRAM geralmente oferece menor latência de acesso e pode ajudar os processadores a ler rapidamente os dados necessários. Em comparação com projetos que dependem de memória externa de alta largura de banda e maior capacidade, essa arquitetura busca reduzir a sobrecarga de acesso a dados para determinadas tarefas computacionais.
A SRAM também apresenta limitações de custo e capacidade. Considerando a mesma área de chip, a SRAM geralmente não consegue fornecer a mesma escala de armazenamento que a memória externa de alta capacidade. Portanto, a implantação de modelos com maior número de parâmetros pode exigir coordenação entre vários chips, particionamento de modelos e otimização em nível de sistema para atender aos requisitos de capacidade.
Isso significa que a SRAM no chip não é inerentemente superior a todas as outras arquiteturas de memória. Seu valor depende do modelo e da carga de trabalho específicos, bem como da capacidade do sistema computacional de coordenar efetivamente o armazenamento e a transferência de dados.
Por que a execução determinística é importante?
Outro elemento fundamental do design da Groq é a execução determinística. Nessa abordagem arquitetural, o compilador pode planejar antecipadamente um grande número de operações computacionais e transferências de dados, permitindo que o processador opere de acordo com um cronograma de execução predeterminado.
As GPUs tradicionais geralmente precisam oferecer suporte a diversas tarefas computacionais, agendamento dinâmico e ambientes de software complexos, o que lhes proporciona grande versatilidade. A Groq, por outro lado, busca reduzir parte da incerteza associada ao agendamento em tempo de execução e à coordenação de recursos por meio de planos de execução mais explícitos.
Para inferência de baixa latência, o tempo de execução previsível tem valor prático. Quando as empresas fornecem serviços de IA em tempo real, elas se preocupam não apenas com a velocidade média de resposta, mas também com a variação de latência entre diferentes solicitações. Se um serviço ocasionalmente apresentar atrasos significativos nas respostas, a experiência do usuário poderá ser afetada mesmo que o desempenho médio seja alto.
A execução determinística não significa que todas as solicitações terão exatamente o mesmo tempo de resposta. A latência real ainda pode ser afetada por fatores como comprimento da entrada, comprimento da saída, estratégias de agrupamento, carga do sistema e condições de rede.
Como o compilador contribui para a otimização de desempenho da LPU?
A abordagem tecnológica da Groq não depende apenas do hardware para melhorar o desempenho. Ela enfatiza o codesign de hardware e software. O compilador precisa analisar o grafo computacional do modelo e mapear as operações relevantes para os recursos de computação e armazenamento do chip.
Nesse processo, o compilador é responsável não apenas por converter o modelo em instruções executáveis, mas também por organizar transferências de dados, sequências de computação e uso de recursos para que diferentes unidades computacionais possam operar juntas de acordo com um plano predeterminado.
Esse design permite uma otimização profunda para modelos compatíveis, mas também impõe exigências significativas à cadeia de ferramentas de software. Quando as estruturas dos modelos, os tipos de operadores ou os requisitos de inferência mudam, a plataforma precisa aprimorar continuamente seu compilador e ambiente de execução.
Portanto, a competitividade tecnológica da Groq vem não apenas do próprio chip LPU, mas também de seu compilador, de suas capacidades de adaptação de modelos e da eficiência coordenada de todo o seu sistema de inferência.
Como a GroqCloud transforma a capacidade computacional das LPUs em um serviço comercial?
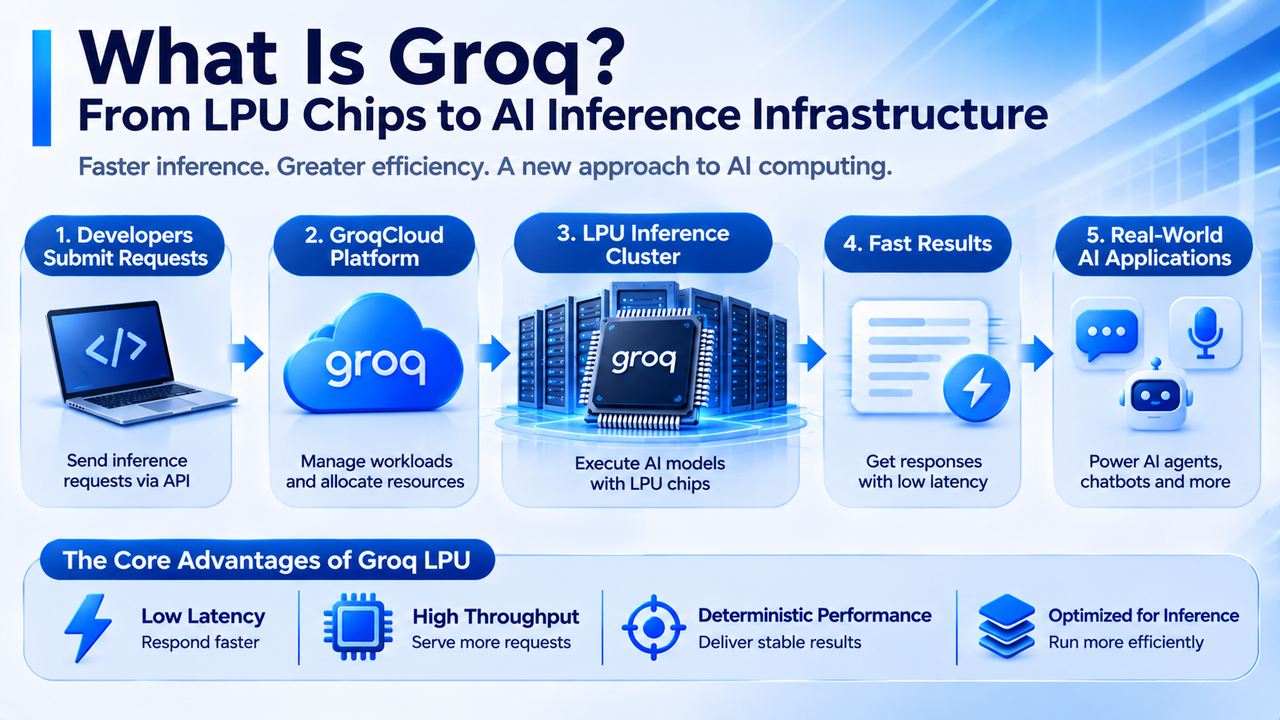
A GroqCloud é o serviço de inferência de IA baseado em nuvem da Groq para desenvolvedores e empresas. Ela integra chips subjacentes, clusters computacionais e ambientes de execução de modelos em serviços acessíveis por APIs. Isso permite que os clientes usem a infraestrutura de inferência da Groq sem precisar comprar e implantar chips especializados por conta própria.
Em uma aplicação típica, os desenvolvedores primeiro selecionam um modelo compatível com a plataforma e, em seguida, enviam texto ou outros tipos de entrada por meio de uma API. A GroqCloud recebe a solicitação, atribui a tarefa computacional relevante ao sistema de inferência subjacente e retorna o resultado gerado à aplicação. Esse processo envolve agendamento de solicitações, execução de modelos, gerenciamento de recursos e transmissão de resultados.
Para clientes empresariais, o principal valor do uso de um serviço de inferência em nuvem é uma menor barreira à implantação de infraestrutura. Construir um cluster de computação para IA de forma independente normalmente exige a compra de hardware, a configuração de redes, a implantação de modelos e a manutenção do ambiente de execução. O uso de um serviço de inferência por meio de API converte parte do investimento fixo em infraestrutura em despesas de serviço que variam conforme o uso comercial.
A plataforma da Groq também está se expandindo de uma única API de inferência para serviços mais abrangentes de infraestrutura empresarial. Seu portfólio de produtos inclui infraestrutura computacional especializada, uma pilha de software de inferência e recursos de governança e controle de nível empresarial para atender a diferentes requisitos dos clientes quanto a desempenho, métodos de implantação e permissões de gerenciamento.
No entanto, o valor comercial de um serviço de inferência em nuvem não depende inteiramente da velocidade do chip. As empresas também devem considerar suporte a modelos, estabilidade da API, disponibilidade do serviço, segurança de dados e custos por solicitação. Se uma plataforma oferecer suporte apenas a uma gama limitada de modelos ou operadores, ela poderá não atender a todos os requisitos de aplicações empresariais, mesmo que forneça baixa latência para tarefas específicas.
Em termos de modelos de receita, os serviços de inferência em nuvem normalmente podem cobrar com base no uso do modelo, na quantidade de Tokens processados ou na capacidade computacional reservada. Diferentes métodos de precificação criam diferentes requisitos de gerenciamento de recursos. A cobrança baseada no uso depende mais do volume real de solicitações, enquanto os serviços de capacidade reservada exigem atenção aos contratos de clientes, à entrega de recursos e à utilização dos equipamentos.
Portanto, a capacidade da GroqCloud de comercializar sua tecnologia depende, em última análise, de sua capacidade de transformar as vantagens de desempenho subjacentes das LPUs em serviços de inferência estáveis, escaláveis e competitivos em custo.
Como a parceria da Groq com a NVIDIA altera seu posicionamento no setor?
A relação da Groq com a NVIDIA é um contexto importante para entender seu atual posicionamento no setor.
Em dezembro de 2025, a Groq e a NVIDIA firmaram um acordo não exclusivo de licenciamento de tecnologia de inferência de IA. De acordo com divulgações de ambas as partes, a NVIDIA obteve uma licença para a tecnologia de inferência relevante da Groq, enquanto o fundador da Groq, Jonathan Ross, o então presidente Sunny Madra e alguns membros da equipe se juntaram à NVIDIA. A Groq continuou a operar como empresa independente sob a liderança do CEO Simon Edwards, e seu negócio GroqCloud permaneceu em operação.
Essa transação significa que o valor tecnológico da Groq se reflete não apenas na venda independente de serviços de inferência, mas também em sua entrada no ecossistema mais amplo de computação para IA por meio do licenciamento de tecnologia.
Em março de 2026, a NVIDIA apresentou ainda a arquitetura de aceleração de inferência Groq 3 LPX e a combinou com a plataforma Vera Rubin. A solução relacionada busca distribuir cargas de trabalho entre GPUs e LPUs com base nas características computacionais das diferentes etapas da inferência de IA, com o objetivo de melhorar a eficiência da inferência de baixa latência. Esse desenvolvimento reflete a crescente complexidade da concorrência no mercado de chips de IA. No passado, chips especializados de inferência eram frequentemente vistos como possíveis substitutos das GPUs. Em arquiteturas de computação heterogênea, no entanto, diferentes tipos de processadores também podem executar tarefas complementares.
Por exemplo, GPUs podem lidar com computação paralela em larga escala e alguns cálculos de atenção adequados à sua arquitetura, enquanto LPUs podem lidar com tarefas computacionais mais sensíveis ao tempo de execução e à latência de transferência de dados. Por meio de agendamento em nível de sistema, os dois tipos de processadores podem trabalhar juntos na mesma carga de trabalho de inferência.
No entanto, arquiteturas heterogêneas também introduzem complexidade adicional de engenharia. Os sistemas precisam coordenar transferências de dados, alocação de tarefas e gerenciamento de memória entre diferentes dispositivos. Se a sobrecarga de comunicação entre dispositivos for muito alta, as vantagens teóricas de hardware poderão não se traduzir integralmente em desempenho prático.
Em agosto de 2026, a Groq também anunciou que havia ingressado no programa NVIDIA Cloud Partner, fortalecendo ainda mais seu posicionamento como operadora de infraestrutura de nuvem para IA. Portanto, a Groq não pode mais ser descrita simplesmente como uma empresa de chips totalmente independente do ecossistema da NVIDIA e focada exclusivamente em desafiar as GPUs. Seu negócio atual inclui serviços independentes de inferência em nuvem, tecnologia de chips especializados e cooperação de infraestrutura com a NVIDIA.
Como o modelo de negócios da Groq está se adaptando ao crescimento do mercado de inferência de IA?
A demanda comercial no mercado de inferência de IA vem principalmente de aplicações empresariais, serviços para desenvolvedores e produtos de IA que operam continuamente. Diferentemente do treinamento de modelos, que geralmente é baseado em projetos e ocorre em etapas, os serviços de inferência precisam fornecer capacidade computacional continuamente à medida que o tráfego de usuários varia. Por isso, eles dão maior ênfase à utilização de recursos, aos custos unitários e à estabilidade do serviço.
O modelo de negócios da Groq pode ser compreendido em três níveis.
-
Construção de infraestrutura de inferência. A Groq precisa criar capacidade computacional utilizável por meio de chips, servidores, redes e data centers. Esses ativos só podem dar suporte a solicitações de clientes e gerar receita após a conclusão da implantação de equipamentos, da adaptação de modelos e do lançamento dos serviços.
-
Serviços de inferência em nuvem. A GroqCloud transforma a capacidade computacional em APIs que os desenvolvedores podem chamar, sem exigir que os clientes gerenciem diretamente os chips subjacentes. Para o provedor de serviços, o crescimento da receita depende do número de clientes, do volume de solicitações, da precificação dos serviços e da retenção de clientes.
-
Serviços de infraestrutura empresarial. Algumas empresas podem exigir recursos computacionais dedicados, métodos específicos de implantação ou requisitos mais rigorosos de governança. Essas necessidades podem criar relações mais estáveis e duradouras com os clientes, mas também exigem maior investimento em engenharia, operações e suporte ao cliente.
Em junho de 2026, a Groq anunciou que havia assegurado US$ 650 milhões em financiamento para crescimento a fim de expandir seu negócio global de nuvem para inferência de IA, com a meta de atingir aproximadamente 200 MW de capacidade de infraestrutura até 2027. Na época, a empresa divulgou que operava 13 data centers em várias regiões, atendia mais de 5 milhões de desenvolvedores e processava dezenas de trilhões de Tokens de IA por semana.
Esses números podem ser usados para observar o ritmo de expansão dos negócios, mas não demonstram diretamente a lucratividade. O número de desenvolvedores, o volume de Tokens e a quantidade de data centers refletem, respectivamente, o alcance de usuários, a atividade dos serviços e a escala da infraestrutura. Eles não equivalem à receita real, ao lucro ou ao fluxo de caixa livre.
Por exemplo, suponha que o número de Tokens processados por uma plataforma de inferência a cada mês aumente 100%, mas o preço por Token diminua 40% devido à concorrência de mercado. Nesse caso, o crescimento da receita poderá ser menor do que o crescimento do uso. Se os custos de construção e operação da infraestrutura também aumentarem no mesmo período, as margens de lucro poderão ser ainda mais afetadas.
Portanto, analisar o potencial de comercialização da Groq exige a consideração simultânea do crescimento da demanda por inferência, da precificação dos serviços, da utilização dos equipamentos e das despesas de capital. O valor de mercado não pode ser avaliado apenas com base na velocidade de execução dos modelos.
Quais desafios técnicos e de escalabilidade a Groq enfrenta?
Embora os chips especializados de inferência possam ser otimizados para cargas de trabalho específicas, a Groq ainda enfrenta desafios decorrentes de mudanças nos modelos, da escalabilidade de hardware e da concorrência de mercado.
Adaptação de modelos. As arquiteturas de modelos de IA continuam a evoluir rapidamente. Diferentes modelos podem usar mecanismos de atenção, escalas de parâmetros, precisões computacionais e estratégias de inferência distintos. Se um processador especializado for compatível com mais modelos, seu compilador, ambiente de execução e ferramentas de software relacionadas precisarão ser atualizados continuamente.
Isso também significa que uma vantagem de desempenho obtida por uma geração de chips em um modelo específico pode não se estender diretamente a todos os novos modelos. À medida que a inferência de contexto longo, os modelos de mistura de especialistas e a computação multimodal se desenvolvem, os sistemas computacionais subjacentes precisam se adaptar continuamente a novas cargas de trabalho.
Escalabilidade entre vários chips. As LPUs da Groq enfatizam a SRAM no chip e a execução determinística, mas grandes modelos frequentemente exigem recursos de armazenamento e computação além da capacidade de um único chip. Quando um modelo é distribuído entre vários chips, o sistema precisa coordenar transferências de dados e sequências computacionais entre dispositivos.
Se a comunicação entre vários chips for ineficiente, a vantagem de baixa latência de um único chip poderá ser reduzida. Portanto, interconexões de chips, largura de banda do sistema e capacidades de agendamento do compilador são fatores importantes para determinar se uma arquitetura especializada de inferência pode escalar.
Custos de construção de infraestrutura. Mesmo que os chips ofereçam alta eficiência computacional, a construção de um data center de IA ainda exige conexões de energia, espaço físico, sistemas de refrigeração e infraestrutura de rede. À medida que seus serviços de inferência se expandem, a Groq também precisará arcar com os custos de capital e operacionais correspondentes.
Concorrência de mercado. GPUs da NVIDIA, GPUs da AMD, TPUs do Google e outros aceleradores especializados de IA competem pela demanda de computação para inferência. Diferentes plataformas podem ter vantagens em compatibilidade de modelos, throughput, latência, custo e ecossistemas de software.
Para clientes empresariais, a escolha final geralmente não é determinada por uma única métrica de desempenho. Ela depende dos custos totais do serviço, da compatibilidade das aplicações e da confiabilidade operacional de longo prazo. Portanto, a capacidade da abordagem tecnológica da Groq de estabelecer competitividade sustentável depende não apenas da própria arquitetura LPU, mas também de a empresa conseguir continuar expandindo o suporte de software, melhorar a utilização de recursos computacionais e controlar o custo da expansão da infraestrutura.
O que a Groq representa para os chips de IA e o setor de computação?
A abordagem tecnológica representada pela Groq reflete a transição gradual do setor de computação para IA, de arquiteturas centradas em aceleradores de uso geral para sistemas de computação heterogênea otimizados para diferentes cargas de trabalho. Nos estágios iniciais do desenvolvimento da IA generativa, as capacidades de treinamento foram um importante motor do progresso do setor. À medida que mais modelos entram em aplicações práticas, os serviços de inferência começam a criar uma demanda computacional contínua, aumentando os requisitos empresariais de baixa latência, eficiência de custos e estabilidade de serviços.
Isso cria espaço para o desenvolvimento de chips especializados de inferência. Ao otimizar hardware e software para processos computacionais específicos, arquiteturas especializadas podem alcançar vantagens de desempenho ou custo em determinadas tarefas.
No entanto, isso não significa que as GPUs serão completamente substituídas por chips especializados de inferência. As GPUs têm amplos ecossistemas de software, extenso suporte a modelos e capacidades de computação de uso geral, o que permite sua adaptação a diversas cargas de trabalho de treinamento e inferência. Os aceleradores especializados podem, em vez disso, desempenhar um papel em modelos específicos, etapas computacionais ou cenários de baixa latência.
A cooperação tecnológica entre a NVIDIA e a Groq sugere ainda que futuros data centers de IA poderão implantar simultaneamente diferentes tipos de dispositivos computacionais e coordená-los por meio de sistemas de agendamento de software. Essa abordagem poderia melhorar a utilização de recursos computacionais, mas também aumentaria a complexidade do design e da gestão do sistema.
Para o setor de infraestrutura de IA, o foco da concorrência pode se expandir gradualmente do desempenho teórico de chips individuais para a capacidade de fornecer sistemas computacionais completos. O desempenho dos chips, a largura de banda de memória, as interconexões de dispositivos, os compiladores, a eficiência energética e as operações de serviços em nuvem podem afetar o retorno comercial final.
O desenvolvimento da Groq também demonstra que a infraestrutura de inferência de IA não é apenas uma questão de fabricação de chips. Trata-se de um setor integrado que abrange arquitetura de hardware, otimização de software, construção de data centers e prestação de serviços comerciais.
Conclusão
A Groq é uma empresa de tecnologia focada em computação para inferência de IA. Sua arquitetura LPU utiliza elementos de design como SRAM no chip, execução determinística e agendamento por compilador para melhorar a eficiência de execução em cargas de trabalho específicas de IA. A GroqCloud transforma capacidades computacionais subjacentes em serviços de inferência em nuvem, permitindo que desenvolvedores e empresas utilizem a infraestrutura relevante por meio de APIs.
À medida que as aplicações de IA se expandem além do treinamento de modelos para interações em tempo real, agentes de IA e serviços empresariais em operação contínua, a latência de inferência, o throughput e o custo se tornam métricas técnicas cada vez mais importantes. A arquitetura especializada de inferência representada pela Groq oferece ao setor de computação para IA uma abordagem alternativa às GPUs de uso geral.
Ao mesmo tempo, o licenciamento de tecnologia e a cooperação de infraestrutura da Groq com a NVIDIA mostram que chips especializados de inferência e GPUs não precisam ter uma relação puramente competitiva. Os futuros data centers de IA poderão adotar cada vez mais arquiteturas de computação heterogênea, nas quais diferentes processadores executam tarefas adequadas às suas respectivas características.
No entanto, vantagens técnicas em chips especializados não se traduzem automaticamente em sucesso comercial. A Groq ainda precisa lidar com adaptação de modelos, escalabilidade entre vários chips, custos de infraestrutura e lucratividade de serviços em nuvem. Seu desenvolvimento de longo prazo dependerá de sua capacidade de transformar suas vantagens de desempenho em inferência em demanda estável dos clientes, receita sustentável e retornos razoáveis sobre o capital.
Perguntas frequentes
Que tipo de empresa é a Groq?
A Groq é uma empresa de tecnologia focada em computação para inferência de IA. Suas principais áreas de negócios incluem processadores especializados LPU, sistemas computacionais de inferência e serviços de inferência em nuvem GroqCloud.
Groq e Grok são o mesmo produto?
Não. A Groq é uma empresa de tecnologia relacionada à infraestrutura de inferência de IA, enquanto o Grok é um modelo de inteligência artificial e produto de assistente desenvolvido pela xAI.
O que é a LPU da Groq?
A LPU é um processador especializado de inferência de IA projetado pela Groq. Ela enfatiza SRAM no chip, execução determinística, agendamento por compilador e computação de baixa latência.
Como a LPU da Groq difere de uma GPU da NVIDIA?
As LPUs dão maior ênfase à otimização da computação e da transferência de dados para tarefas específicas de inferência, enquanto as GPUs oferecem capacidades mais amplas de computação paralela e ecossistemas de software. O desempenho real depende do modelo, do tamanho do lote, dos requisitos de latência e do ambiente de implantação.
A Groq foi adquirida pela NVIDIA?
Em novembro de 2026, a Groq continua operando como empresa independente. As duas partes firmaram um acordo não exclusivo de licenciamento de tecnologia em dezembro de 2025, e alguns membros da equipe da Groq se juntaram à NVIDIA. Isso não significa que a NVIDIA tenha concluído uma aquisição integral da Groq.
O que é a GroqCloud?
A GroqCloud é o serviço de inferência de IA baseado em nuvem da Groq. Ela permite que os desenvolvedores chamem modelos compatíveis com a plataforma por meio de APIs sem precisarem comprar e implantar o hardware computacional subjacente por conta própria.
Por que a Groq atraiu atenção no mercado de computação para IA?
A abordagem tecnológica da Groq otimiza a latência, a transferência de dados e a eficiência de execução na inferência de IA. Isso está alinhado aos requisitos de eficiência computacional de aplicações de IA em tempo real, agentes de IA e serviços empresariais de inferência.
A Groq possui sua própria criptomoeda?
A Groq é uma empresa de infraestrutura de computação para IA. Seus negócios de LPU e GroqCloud não dependem de um token de criptomoeda nativo. Tokens de terceiros com nomes semelhantes não devem ser tratados diretamente como ativos emitidos ou endossados pela Groq.