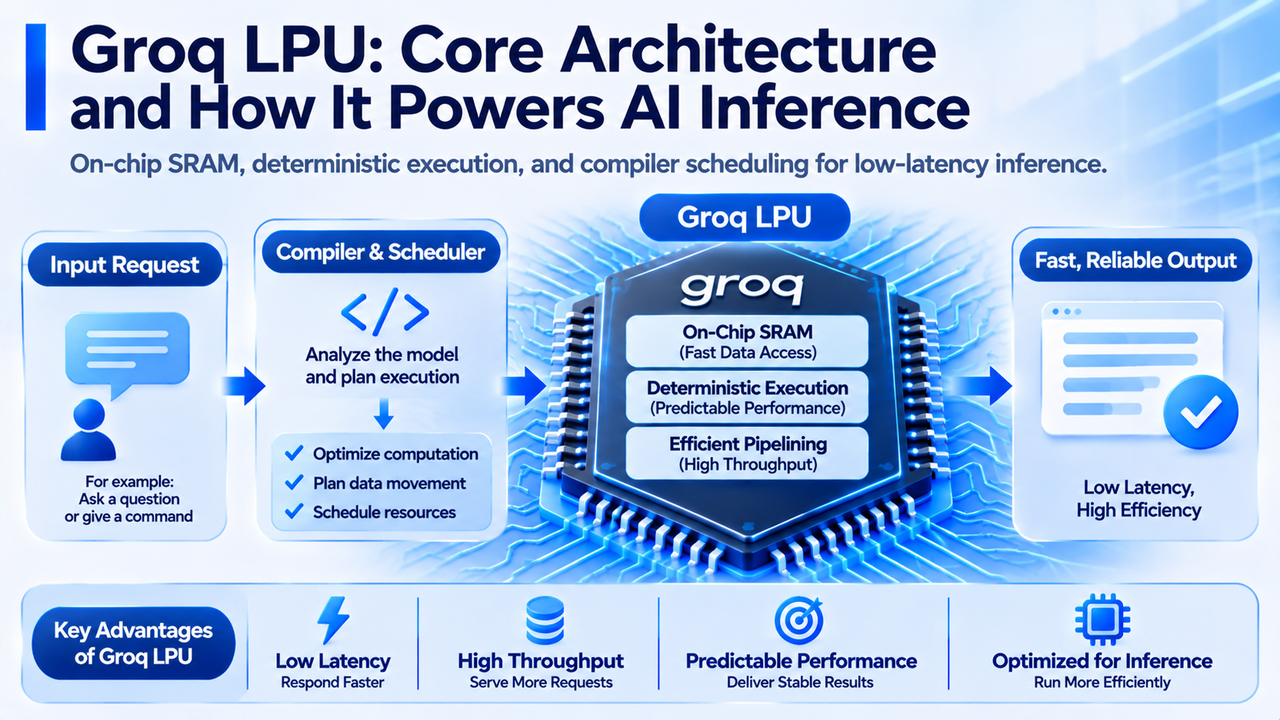
Ao contrário das GPUs, projetadas para uma ampla variedade de tarefas de computação massivamente paralelas, as LPUs da Groq usam uma arquitetura que prioriza SRAM no chip, agendamento estático pelo compilador e execução determinística. Essa abordagem busca reduzir a transferência de dados e a sobrecarga de agendamento em tempo de execução durante a inferência, fornecendo capacidades computacionais mais direcionadas para aplicações de IA em tempo real.
À medida que os modelos de linguagem de grande porte são cada vez mais utilizados em atendimento ao cliente inteligente, interações por voz, agentes de IA e automação empresarial, os requisitos de inferência vão além da simples maximização da velocidade de processamento e passam a incluir latência de resposta, estabilidade do serviço e custos computacionais por unidade. A abordagem de aceleradores dedicados representada pelas LPUs da Groq oferece à infraestrutura de IA uma opção técnica distinta das arquiteturas tradicionais de computação de uso geral. Este artigo apresenta em detalhes como as LPUs da Groq funcionam, analisa como a SRAM, a execução determinística e os compiladores afetam o desempenho da inferência e discute seus cenários aplicáveis e limitações técnicas.
Principais conclusões
-
A LPU da Groq é um processador dedicado projetado para cargas de trabalho de inferência de IA, com foco em baixa latência, execução previsível e transferência de dados eficiente.
-
A inferência de modelos de linguagem de grande porte geralmente consiste em duas etapas: prefill e decode. Essas etapas têm requisitos diferentes de poder computacional e largura de banda de memória.
-
As LPUs da Groq usam SRAM no chip para encurtar determinados caminhos de acesso a dados, mas sua capacidade de armazenamento no chip relativamente limitada também gera requisitos para a implantação de modelos e o escalonamento com vários chips.
-
A execução determinística e o agendamento estático pelo compilador podem reduzir parte da sobrecarga de agendamento em tempo de execução, mas não significam que todas as solicitações terão exatamente o mesmo tempo de resposta.
-
As LPUs apresentam vantagens potenciais em aplicações de baixa latência, como geração de texto em tempo real e interações por voz. Seu desempenho real ainda depende do modelo, da carga de trabalho, da configuração do sistema e do preço do serviço.
O que é a LPU da Groq? Como ela difere dos aceleradores tradicionais de IA?
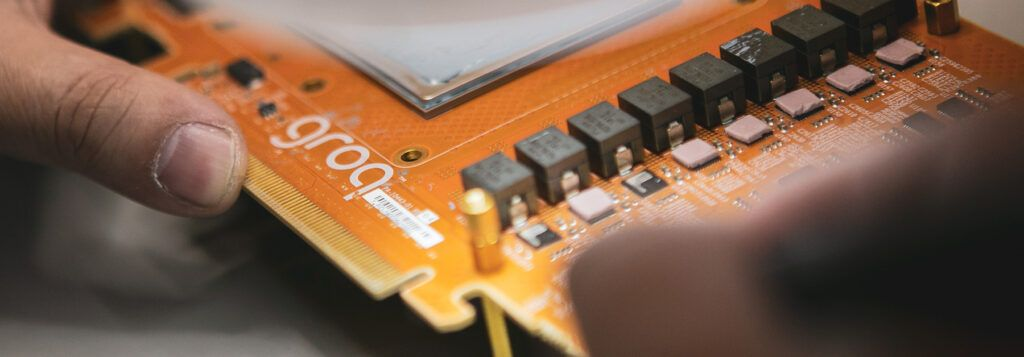
A LPU da Groq é um processador dedicado de inferência de IA desenvolvido pela Groq. LPU significa Language Processing Unit. Seu design busca otimizar a movimentação de dados, a execução de cálculos e o controle de latência na inferência de modelos de linguagem, em vez de fornecer recursos de computação de uso geral para todos os tipos de tarefas.
Para entender o posicionamento técnico das LPUs, primeiro é necessário reconhecer as diferentes abordagens de design utilizadas pelos aceleradores de IA. As GPUs foram originalmente projetadas principalmente para processamento gráfico. Posteriormente, foram amplamente adotadas para treinamento e inferência de aprendizado profundo devido às suas capacidades de computação paralela em larga escala e ao seu ecossistema de software maduro. Aceleradores dedicados, como as TPUs, aumentam a eficiência de execução de tarefas computacionais específicas ao otimizar operações para aprendizado de máquina.
As LPUs da Groq dão ainda mais ênfase à coordenação entre o compilador e o hardware. Sua arquitetura busca planejar os cálculos e a transferência de dados antes da execução de um modelo, permitindo que o chip conclua tarefas de acordo com um cronograma predeterminado e, assim, reduza parte da sobrecarga gerada pelo agendamento dinâmico.
Essa abordagem de design está intimamente relacionada à direção tecnológica Tensor Streaming Processor (TSP), apresentada pela Groq em seu desenvolvimento inicial. Ao organizar recursos computacionais, armazenamento no chip e caminhos de transferência de dados, o processador permite que as operações do modelo sejam executadas na sequência definida pelo compilador.
É importante observar que LPU não é uma categoria padronizada do setor para todos os processadores de modelos de linguagem. Trata-se de uma denominação técnica usada pela Groq. Diferentes fabricantes podem utilizar diferentes designs de chips ou alcançar inferência de baixa latência por meio de GPUs, ASICs ou outros aceleradores dedicados.
Portanto, avaliar o valor técnico das LPUs da Groq exige mais do que considerar o nome do processador. É necessário analisar como elas lidam com o acesso a dados, o agendamento de cálculos e a comunicação entre vários chips durante a inferência.
Por que os modelos de linguagem de grande porte precisam de computação de baixa latência?
A inferência de modelos de linguagem de grande porte refere-se ao processo em que um modelo recebe uma entrada e usa seus parâmetros treinados para gerar uma saída. Para modelos de linguagem autorregressivos comuns, a inferência geralmente consiste em duas etapas: prefill e decode. A etapa de prefill processa principalmente o prompt do usuário e estabelece o estado computacional necessário para a geração subsequente. Como essa etapa pode processar vários tokens de entrada simultaneamente, ela geralmente apresenta fortes características de computação paralela.
A etapa de decode gera tokens de saída um por vez. O modelo normalmente precisa prever o próximo token com base na entrada existente e no conteúdo gerado anteriormente, portanto há dependências entre várias etapas de geração. Como resultado, essas etapas não podem ser totalmente paralelizadas com a mesma facilidade que alguns cálculos de treinamento.
Essa distinção significa que o desempenho de inferência não pode ser medido por uma única métrica.
Tempo até o primeiro token (TTFT) mede o tempo entre o início de uma solicitação e a geração do primeiro token de saída. Ele afeta principalmente por quanto tempo os usuários percebem que precisam aguardar uma resposta.
Velocidade de geração de tokens mede quantos tokens um modelo pode gerar por unidade de tempo após começar a produzir uma saída. Ela afeta diretamente a fluidez da geração contínua de texto. Throughput refere-se a quantas solicitações ou tokens um sistema consegue processar em determinado período e reflete a capacidade geral de processamento de um serviço de inferência sob uma carga concorrente relativamente alta.
Por exemplo, duas plataformas de inferência podem executar o mesmo modelo de linguagem, mas a Plataforma A pode oferecer geração de tokens mais rápida para uma solicitação de usuário individual, enquanto a Plataforma B pode alcançar maior throughput geral ao processar centenas de solicitações simultaneamente.
Isso significa que baixa latência e alto throughput não são exatamente o mesmo objetivo de desempenho. Um sistema otimizado para interação em tempo real com um único usuário pode não apresentar as mesmas vantagens em todos os cenários de processamento em lote ou de alta concorrência.
Para assistentes de voz, tradução em tempo real e aplicações interativas de IA, o TTFT e a velocidade de geração contínua são especialmente importantes. Os usuários geralmente esperam que o sistema comece a responder rapidamente e continue produzindo conteúdo natural e fluente.
Para tarefas como análise offline de documentos e processamento de dados em lote, o tempo de resposta imediato de uma solicitação individual pode ser menos importante. Em vez disso, as empresas podem se concentrar mais no throughput geral e nos custos de processamento por unidade.
Uma das prioridades de design das LPUs da Groq é otimizar a eficiência de execução para cargas de trabalho de inferência sensíveis ao tempo de resposta.
Como as LPUs da Groq usam SRAM para melhorar a eficiência de acesso a dados?
O desempenho dos processadores modernos de IA depende não apenas de quantas operações suas unidades computacionais podem executar, mas também de os dados conseguirem chegar a essas unidades em tempo hábil.
Durante a inferência de modelos de linguagem de grande porte, os processadores leem repetidamente os pesos do modelo, acessam resultados intermediários e mantêm dados relacionados ao contexto. Se os dados não puderem ser lidos com rapidez suficiente, até mesmo um chip com alto poder computacional teórico pode não operar em plena capacidade porque estará aguardando dados.
Esse problema é comumente conhecido como gargalo de memória.
Uma das principais características arquitetônicas das LPUs da Groq é a ênfase no uso de SRAM no chip, ou memória estática de acesso aleatório, para armazenamento e acesso a dados.
A SRAM geralmente oferece baixa latência de acesso e pode ser integrada diretamente ao chip do processador. Em comparação com dados acessados por uma interface de memória externa, o armazenamento no chip pode encurtar os caminhos de transferência de dados e reduzir parte da sobrecarga de acesso.
Para entender esse design, é útil comparar as características básicas da SRAM e da memória de alta largura de banda (HBM).
| Dimensão de comparação |
SRAM |
HBM |
| Localização típica |
Dentro do chip do processador |
Uma pilha de memória independente dentro do pacote do processador |
| Principais vantagens |
Baixa latência de acesso e integração estreita |
Maior capacidade e alta largura de banda agregada |
| Principais limitações |
Alto custo de área e capacidade limitada |
O acesso a dados ainda requer uma interface de memória |
| Usos típicos |
Cache e memória de trabalho no chip |
Dados em larga escala, como pesos do modelo e ativações |
| Relevância para a inferência |
Otimiza determinados caminhos de acesso a dados |
Suporta modelos maiores e estados computacionais |
No entanto, não se pode simplesmente presumir que a SRAM é mais rápida do que a HBM em todas as situações ou que o uso de SRAM elimina o gargalo de memória. O desempenho real também depende do layout dos dados, dos padrões de acesso paralelo, da largura de banda da memória e da arquitetura do modelo.
As principais limitações da SRAM são sua densidade de armazenamento e seu custo de área no chip. Para modelos de linguagem com um grande número de parâmetros, a SRAM em um único processador geralmente é insuficiente para armazenar todos os pesos do modelo e estados de execução.
Por isso, a Groq precisa usar coordenação entre vários chips e alocação de dados em nível de sistema para executar modelos em sistemas computacionais maiores. Isso significa que as vantagens das LPUs não vêm inteiramente da SRAM presente em um chip individual. Em vez disso, resultam do design geral do armazenamento no chip, dos pipelines computacionais, das interconexões entre chips e dos compiladores.
Como a execução determinística e o agendamento pelo compilador afetam o desempenho da inferência?
A execução determinística é outro conceito fundamental para entender a arquitetura da LPU da Groq. Sua ideia central é determinar, tanto quanto possível antes de um programa ser executado, a ordem de execução das operações computacionais, os caminhos de transferência de dados e a alocação de recursos, reduzindo a necessidade de tomar decisões temporárias de agendamento durante a execução.
Nas arquiteturas tradicionais de computação de uso geral, os processadores precisam se adaptar a diferentes tipos de programas e cargas de trabalho. Para melhorar a utilização de recursos, os sistemas normalmente incluem agendamento dinâmico de tarefas, gerenciamento de cache e outros mecanismos de tempo de execução. Esses designs oferecem flexibilidade considerável, mas também podem introduzir sobrecarga adicional de agendamento.
As LPUs da Groq usam uma abordagem de design diferente. Antes da execução de um modelo, o compilador analisa seu grafo computacional e cria um plano de execução para operações computacionais e movimentação de dados. O processador então opera de acordo com esse plano, permitindo que os dados se movam entre diferentes unidades computacionais de maneira ordenada. Por exemplo, um modelo de linguagem pode precisar executar continuamente operações de matriz, funções de ativação e outros cálculos. O compilador pode organizar antecipadamente quando essas tarefas serão executadas em diferentes recursos computacionais e coordenar as transferências de dados necessárias.
Essa abordagem é semelhante a planejar antecipadamente cada etapa de uma linha de produção para que diferentes estágios possam trabalhar em conjunto de acordo com um ritmo predeterminado.
Para a inferência de IA, a execução determinística tem três implicações principais.
-
Ela pode reduzir parte da sobrecarga de agendamento em tempo de execução. O processador não precisa redeterminar a ordem de execução de cada tarefa em cada estágio computacional, o que pode ajudar a melhorar a eficiência de execução para cargas de trabalho específicas.
-
Ela pode tornar os tempos de execução dos cálculos mais previsíveis. Para serviços de IA em tempo real, um desempenho de resposta consistente é tão importante quanto uma baixa latência média. A execução determinística não significa que o tempo de resposta das solicitações reais de API será completamente fixo. O comprimento da entrada, a quantidade de tokens de saída, a fila de solicitações, a transmissão pela rede e a carga do serviço ainda podem causar diferenças na latência de ponta a ponta.
-
O agendamento estático também pode reduzir a flexibilidade de algumas tarefas computacionais. Se um modelo tiver fluxo de controle dinâmico complexo ou se o caminho de execução precisar mudar frequentemente com base em resultados em tempo real, o compilador poderá precisar usar estratégias de processamento adicionais.
Portanto, o valor da execução determinística não está em eliminar toda a incerteza. Em vez disso, para tarefas computacionais adequadas, ela melhora a eficiência de utilização dos recursos de hardware por meio de um planejamento de execução mais explícito.
Por que as LPUs da Groq são adequadas para inferência de IA de baixa latência?
O design de baixa latência das LPUs da Groq não depende de uma única tecnologia. Ele resulta dos efeitos combinados da SRAM no chip, da execução determinística, da otimização pelo compilador e das interconexões em nível de sistema. Durante a geração por modelos de linguagem de grande porte, o modelo precisa executar cálculos continuamente e gerar tokens subsequentes com base nos resultados existentes. Se um processador puder reduzir parte dos atrasos de acesso a dados e da sobrecarga de agendamento em tempo de execução, ele poderá reduzir o tempo necessário para etapas sucessivas de geração.
Isso é particularmente relevante para a etapa de decode. Como modelos autorregressivos geralmente precisam gerar tokens um por vez, a latência de cada etapa de geração se acumula e, em última análise, afeta a velocidade de saída de texto percebida pelos usuários. No entanto, os gargalos de desempenho de diferentes tarefas de inferência nem sempre são os mesmos. O processamento de prompts longos pode depender mais de capacidades de computação paralela em larga escala, enquanto a geração contínua pode ser mais afetada pelo acesso à memória e pela latência de execução passo a passo.
Portanto, o desempenho real das LPUs da Groq deve ser avaliado em conjunto com o tipo de modelo, o comprimento da entrada, o comprimento da saída e o número de solicitações simultâneas.
Do ponto de vista das aplicações, os seguintes tipos de serviços são particularmente sensíveis à inferência de baixa latência.
Interações por voz em tempo real. Um assistente de voz precisa converter a fala do usuário em texto, chamar um modelo de linguagem para gerar uma resposta e, em seguida, produzir o resultado por síntese de voz. Se o modelo de linguagem gerar respostas lentamente, a conversa poderá apresentar pausas perceptíveis.
Agentes de IA interativos. Ao realizar tarefas, um agente de IA pode precisar chamar um modelo de linguagem várias vezes para determinar a próxima ação. Cada atraso de inferência afeta o tempo total de conclusão da tarefa, portanto reduzir o tempo de espera de inferências individuais pode melhorar a experiência do usuário.
Atendimento ao cliente inteligente e aplicações em tempo real. Serviços online que atendem um grande número de usuários precisam não apenas responder rapidamente, mas também controlar as variações de latência entre solicitações para manter uma qualidade de serviço estável.
No entanto, baixa latência não significa necessariamente o menor custo computacional por unidade. Por exemplo, uma plataforma de inferência pode processar uma solicitação individual em alta velocidade, mas, se seu custo de aquisição de hardware for alto ou recursos significativos permanecerem ociosos sob baixa carga, seu custo real de serviço por milhão de tokens ainda poderá exceder o de outras soluções. Por outro lado, outra plataforma pode gerar tokens mais lentamente para solicitações individuais, mas atender muitos usuários simultaneamente por meio de processamento em lote, alcançando, em última análise, um custo médio menor.
Portanto, ao selecionar uma plataforma de inferência, as empresas precisam equilibrar latência, throughput, custo e compatibilidade de modelos, em vez de tomar uma decisão baseada apenas em tokens por segundo.
Quais são as limitações técnicas das LPUs da Groq?
Embora as LPUs da Groq sejam especificamente otimizadas para inferência de IA, uma arquitetura dedicada não significa que elas superarão outras soluções em todas as tarefas computacionais. Suas principais limitações técnicas envolvem capacidade de memória, escalonamento com vários chips, compatibilidade de modelos e custo do sistema.
Limitações de capacidade da SRAM no chip. Como a SRAM tem densidade de armazenamento relativamente baixa, a quantidade de armazenamento disponível no chip de um único chip é limitada. Quando os parâmetros do modelo e os estados de execução excedem a capacidade de um único chip, os cálculos e os dados precisam ser distribuídos por um sistema com vários chips.
Por exemplo, um modelo de linguagem de grande porte pode exigir dezenas de gigabytes ou mais de armazenamento. Geralmente é difícil armazenar todos esses dados usando apenas a SRAM no chip de um único chip. Portanto, o sistema precisa distribuir o modelo entre vários processadores e usar interconexões entre chips para realizar as trocas de dados necessárias.
Essa abordagem pode aumentar o tamanho dos modelos que podem ser implantados, mas também aumenta a complexidade do design do sistema.
Sobrecarga de comunicação entre vários chips. Mesmo que uma LPU individual possa executar cálculos rapidamente, a velocidade geral de inferência ainda pode ser afetada pela largura de banda de interconexão, pela latência de comunicação e pelas estratégias de alocação de dados quando o modelo exige transferências frequentes de dados entre chips. Em sistemas de inferência em larga escala, o desempenho depende não apenas do poder computacional de um processador individual, mas também da operação coordenada de todo o cluster de chips.
Compatibilidade de modelos. As LPUs da Groq dependem de compiladores para mapear os cálculos dos modelos ao hardware dedicado e, por isso, exigem suporte de software correspondente. Quando novos modelos de IA introduzem diferentes operadores computacionais, mecanismos de atenção ou métodos de execução dinâmica, a plataforma pode precisar atualizar seu compilador e ambiente de execução. Em comparação com GPUs de uso geral, que contam com amplos ecossistemas de software, os processadores dedicados de inferência exigem desenvolvimento contínuo de software para se adaptar às tecnologias de modelos em rápida evolução.
Custos de infraestrutura e comerciais. As vantagens de desempenho das LPUs exigem um sistema computacional completo. A implantação real ainda envolve custos de fabricação de chips, servidores, redes, energia e instalações de refrigeração. Para provedores de serviços de inferência em nuvem, a utilização dos equipamentos e a demanda dos clientes também determinam o retorno sobre o investimento.
Portanto, as LPUs da Groq devem ser avaliadas em conjunto com suas condições reais de implantação. Uma alta velocidade de geração de tokens em determinado teste não demonstra diretamente maior eficiência de custos em todos os modelos e cenários comerciais.
O que as LPUs da Groq representam para o futuro da infraestrutura de inferência de IA?
O desenvolvimento das LPUs da Groq reflete a especialização crescente do mercado de computação de IA. À medida que as aplicações de IA generativa se expandem, as empresas começam a selecionar arquiteturas computacionais mais especializadas com base em diferentes cargas de trabalho, em vez de se concentrarem apenas no desempenho máximo teórico de um único processador.
No treinamento de modelos, a computação paralela em larga escala, a capacidade de memória e a comunicação entre vários dispositivos continuam importantes. Na inferência, TTFT, velocidade de geração contínua, throughput concorrente e custo por token tornaram-se métricas comerciais mais diretas.
As diferenças entre as tarefas computacionais criam espaço para o desenvolvimento de chips dedicados à inferência. Ao mesmo tempo, processadores dedicados e GPUs não têm necessariamente uma relação puramente substitutiva. Em março de 2026, a NVIDIA apresentou uma arquitetura de inferência que combina o Groq 3 LPX com a plataforma Vera Rubin, explorando como diferentes tipos de dispositivos computacionais podem lidar com tarefas de inferência adequadas às suas respectivas características.
Essa direção reflete a tendência de desenvolvimento da computação heterogênea. No futuro, os data centers de IA poderão implantar simultaneamente GPUs, aceleradores dedicados de inferência e outros dispositivos computacionais, com sistemas de software coordenando a execução de diferentes tarefas.
Por exemplo, recursos de GPU adequados podem ser usados para cargas de trabalho que exigem processamento paralelo em larga escala, enquanto processadores dedicados de inferência podem oferecer vantagens para determinadas tarefas de geração altamente sensíveis à latência. No entanto, computação heterogênea não significa que simplesmente adicionar mais tipos de chips melhorará a eficiência. Os sistemas também precisam lidar com comunicação entre dispositivos, agendamento de tarefas, compatibilidade de software e custos de infraestrutura.
Para o setor de chips de IA, isso significa que a concorrência está se expandindo do desempenho de componentes individuais de hardware para a eficiência de sistemas computacionais completos. A arquitetura do processador, os compiladores, os sistemas de memória, as tecnologias de interconexão e as operações de serviços em nuvem podem se tornar fatores determinantes para o desempenho final e o valor comercial.
A abordagem tecnológica representada pelas LPUs da Groq fornece um exemplo específico dessa mudança. Seu valor de longo prazo dependerá não apenas da velocidade de inferência de determinada geração de chips, mas também de sua capacidade de continuar se adaptando à evolução dos modelos e transformar desempenho técnico em serviços computacionais estáveis e escaláveis.
Conclusão
A LPU da Groq é um processador dedicado projetado para inferência de IA. Ela usa tecnologias como SRAM no chip, execução determinística e agendamento estático pelo compilador para otimizar o acesso a dados e a execução de cálculos para determinadas cargas de trabalho de modelos de linguagem de grande porte.
Em comparação com GPUs de uso geral, as LPUs da Groq dão maior ênfase à baixa latência e à previsibilidade de execução para tarefas de inferência específicas. Esse design é adequado para explorar a otimização de desempenho em aplicações como geração de texto em tempo real, interações por voz e agentes de IA, mas isso não significa que as LPUs possam substituir as GPUs em todos os modelos e cenários computacionais.
Ao mesmo tempo, a capacidade da SRAM, a comunicação entre vários chips, a adaptação de modelos e os custos de infraestrutura continuam sendo questões importantes que as arquiteturas dedicadas de inferência precisam enfrentar.
À medida que o setor de IA se expande do desenvolvimento de modelos para aplicações em larga escala, a concorrência em computação de inferência está mudando da simples maximização do poder computacional para a otimização de latência, throughput, custo e eficiência geral do sistema. O desenvolvimento das LPUs da Groq mostra que aceleradores dedicados podem desempenhar um papel mais importante na futura infraestrutura de IA, mas seu valor real ainda precisa ser validado por meio de cargas de trabalho específicas e resultados de implantação comercial.
Perguntas frequentes
O que é a LPU da Groq?
A LPU da Groq é um processador dedicado de inferência de IA desenvolvido pela Groq. Ela usa principalmente tecnologias como SRAM no chip, execução determinística e agendamento pelo compilador para otimizar tarefas específicas de inferência de modelos de linguagem.
Quais são as principais diferenças entre LPUs e GPUs?
As LPUs dão maior ênfase à otimização da execução e da transferência de dados para tarefas de inferência específicas, enquanto as GPUs oferecem amplas capacidades de computação paralela e um ecossistema de software maduro. As diferenças de desempenho dependem do modelo específico e do ambiente de execução.
Por que as LPUs da Groq usam SRAM?
A SRAM fornece acesso a dados no chip com baixa latência, o que pode ajudar a reduzir a sobrecarga de leitura de dados em determinadas tarefas de inferência. No entanto, a capacidade da SRAM é limitada, portanto a implantação de modelos grandes geralmente exige coordenação entre vários chips.
O que significa execução determinística?
Execução determinística significa planejar, tanto quanto possível antes de um programa ser executado, a ordem dos cálculos, as transferências de dados e a alocação de recursos. Isso pode reduzir parte da sobrecarga de agendamento em tempo de execução e tornar a execução dos cálculos mais previsível.
As LPUs da Groq podem ser usadas para treinamento de modelos de IA?
As LPUs da Groq são projetadas principalmente para cargas de trabalho de inferência e não se destinam principalmente ao treinamento de modelos de grande porte de uso geral. Seu suporte real depende da arquitetura de hardware e do conjunto de ferramentas de software.
As LPUs da Groq são sempre mais rápidas do que as GPUs da NVIDIA para inferência?
Não necessariamente. Diferentes modelos, comprimentos de entrada, comprimentos de saída, níveis de concorrência e ambientes de teste podem afetar os resultados. Uma velocidade mais alta de geração de tokens para um único usuário não significa necessariamente melhor throughput geral ou menores custos por token.
Por que as LPUs da Groq são adequadas para agentes de IA?
Agentes de IA podem precisar realizar várias chamadas de inferência em sequência. Reduzir a latência de resposta de cada solicitação pode reduzir o tempo de execução da tarefa geral, mas o resultado final também depende de chamadas de ferramentas, transmissão pela rede e outras etapas de processamento.