


rickawsb

用戶暫無簡介
最近我總會想起一句脊背發涼的話:
天寶初年大唐盛世裡的長安人怎麼也想不到,他們中的大多數會死於隨後的安史之亂
天寶初年大唐盛世裡的長安人怎麼也想不到,他們中的大多數會死於隨後的安史之亂
看著這幾天各種關於 AI 安全的爭吵
無論正反
我只想說
雪崩時,沒有一片雪花是無辜的
無論正反
我只想說
雪崩時,沒有一片雪花是無辜的
能跑在本地的開源模型 2 個月能達到 openai astra 目前的水準嗎?
《The Information》援引知情人士稱:Astra 使用了有限的循環深度(recurrent depth / looped transformer)——生成下一個 token 前,同一組層會對內部狀態多跑幾圈;報導將此描述為提升表現、同時減少可見思維鏈的一項技術。
如果這是真的,那麼這對開源模型來說是一件大好事,因為比起大型模型,循環深度對小型模型的效能提升更大。
因為循環深度可以讓一部分原本需要靠更大參數量獲得的能力,改為在推理時靠更多計算換回來。代價是更高的推理計算。
更重要的是,循環深度和 MoE 架構存在明顯的結構性協同,天然比 dense Transformer 更適合 MoE 架構。因為 MoE 循環時,每一輪可以呼叫不同專家,因此同一套共享層可以在不同循環裡執行不同計算
之前已經有論文研究發現,透過循環深度技術能讓 35 億的模型跑出 500 億模型的評分
雖然最終無法確認 2 個月之內開源小模型就一定能達到 astra 水平,但在架構上,顯然有更大優勢。接下來 astra 等級的模型能力可能會以比之前前沿模型更快的速度,被開源小模型趕上
所以。。。
顯卡是不是又要再漲價了?
《The Information》援引知情人士稱:Astra 使用了有限的循環深度(recurrent depth / looped transformer)——生成下一個 token 前,同一組層會對內部狀態多跑幾圈;報導將此描述為提升表現、同時減少可見思維鏈的一項技術。
如果這是真的,那麼這對開源模型來說是一件大好事,因為比起大型模型,循環深度對小型模型的效能提升更大。
因為循環深度可以讓一部分原本需要靠更大參數量獲得的能力,改為在推理時靠更多計算換回來。代價是更高的推理計算。
更重要的是,循環深度和 MoE 架構存在明顯的結構性協同,天然比 dense Transformer 更適合 MoE 架構。因為 MoE 循環時,每一輪可以呼叫不同專家,因此同一套共享層可以在不同循環裡執行不同計算
之前已經有論文研究發現,透過循環深度技術能讓 35 億的模型跑出 500 億模型的評分
雖然最終無法確認 2 個月之內開源小模型就一定能達到 astra 水平,但在架構上,顯然有更大優勢。接下來 astra 等級的模型能力可能會以比之前前沿模型更快的速度,被開源小模型趕上
所以。。。
顯卡是不是又要再漲價了?
- 1
astra 強到什麼程度呢?
我有一個半自動客服的複雜工作流程,gpt 5.6 sol high 執行時人工參與至少需要每個專案半小時
astra 將這個時間縮短到了 5 分鐘
同時任務成功率大幅提升(還沒來得及統計,但目測至少翻倍)
但不得不說,token 消耗得真快啊。
我有一個半自動客服的複雜工作流程,gpt 5.6 sol high 執行時人工參與至少需要每個專案半小時
astra 將這個時間縮短到了 5 分鐘
同時任務成功率大幅提升(還沒來得及統計,但目測至少翻倍)
但不得不說,token 消耗得真快啊。
知名機器人公司Wandercraft 9 月 4 日宣布,其 Calvin‑40 工業人形機器人已經獲得 12 家大型企業客戶,涵蓋汽車、物流、零售、醫療和國防。
有意思的是,公司沒有試圖一開始就讓機器人完成所有人類任務,而是先集中在:
輪胎、箱子、面板、推車、包裹等物料搬運。
然後才逐步向揀選、分類等更精細的任務擴展。
Wandercraft 的路線與近期 Hyundai、Geek+、農業機器人等訊號越來越一致:
先解決狹窄但高價值的工作流程 → 部署 → 資料 → 擴展能力。
透過在不同環境和任務中累積的資料,來提升模型能力;透過多種專用性部署,提升機器人的通用性。
其實不只是人形機器人的部署,機器人的形態也是一樣,應該先專用,再通用
大多數使用者並不在意機器人是不是人形,只在意能不能把工作完成
有意思的是,公司沒有試圖一開始就讓機器人完成所有人類任務,而是先集中在:
輪胎、箱子、面板、推車、包裹等物料搬運。
然後才逐步向揀選、分類等更精細的任務擴展。
Wandercraft 的路線與近期 Hyundai、Geek+、農業機器人等訊號越來越一致:
先解決狹窄但高價值的工作流程 → 部署 → 資料 → 擴展能力。
透過在不同環境和任務中累積的資料,來提升模型能力;透過多種專用性部署,提升機器人的通用性。
其實不只是人形機器人的部署,機器人的形態也是一樣,應該先專用,再通用
大多數使用者並不在意機器人是不是人形,只在意能不能把工作完成
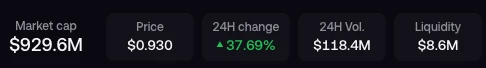
讓一個幣漲到 10 億,需要多少資金?現在的龍一告訴我們,只需要不到 900 萬
而如果現在某個玩家想套現 100 萬,那麼市值就會瞬間變成 8 億,
很多榜一大哥,一個人的持倉,按目前的幣價,就能把盤子砸歸零
為什麼說加密是賭場?因為最後能從牌桌上拿錢離開的,往往只有極少數
而如果現在某個玩家想套現 100 萬,那麼市值就會瞬間變成 8 億,
很多榜一大哥,一個人的持倉,按目前的幣價,就能把盤子砸歸零
為什麼說加密是賭場?因為最後能從牌桌上拿錢離開的,往往只有極少數
巴菲特在將資本市場比作「附帶賭場的教堂」
對幣圈來說,這輪是從賭場升級為教堂的巨大機會
對幣圈來說,這輪是從賭場升級為教堂的巨大機會
這樣一個劇變時代,投資者應該既要極度樂觀,又要極度保守
極度樂觀,確保不錯過時代紅利
極度保守,確保能在任何黑天鵝發生時存活。
極度樂觀,確保不錯過時代紅利
極度保守,確保能在任何黑天鵝發生時存活。
AI(幾乎)能解答一切的時代
問題比答案重要
好問題價值千金
問題比答案重要
好問題價值千金
AI 將以肉眼可見的速度推動無人區工業化和工業區無人化
某種意義上,消費者現在購買部分舊型號消費電子產品、電腦,相當於間接買到了廠商過去囤下來的「低價儲存設備」。
但這個窗口不會永久存在。
隨著舊庫存逐漸耗盡,高價 DRAM 和 NAND 會進入新的生產批次。廠商最終只能在幾種選擇之間權衡:漲價、降低記憶體和 SSD 容量,或者乾脆減少低端產品供應。
但這個窗口不會永久存在。
隨著舊庫存逐漸耗盡,高價 DRAM 和 NAND 會進入新的生產批次。廠商最終只能在幾種選擇之間權衡:漲價、降低記憶體和 SSD 容量,或者乾脆減少低端產品供應。
DRAM0.00%
如果按照過去一年的數字線性外推,
Google 近一年 AI token 活動量約每 4.4 個月翻倍;
全球 H100 等效算力約每 6.8 個月翻倍;
AI 資料中心滿載功率能力約每 9.9 個月翻倍。
一年後,算力供需緊張程度一年後大約變成現在的 1.95 倍
上面還沒考慮隨著 AI 能力增強不斷解鎖的新使用場景。。。
Google 近一年 AI token 活動量約每 4.4 個月翻倍;
全球 H100 等效算力約每 6.8 個月翻倍;
AI 資料中心滿載功率能力約每 9.9 個月翻倍。
一年後,算力供需緊張程度一年後大約變成現在的 1.95 倍
上面還沒考慮隨著 AI 能力增強不斷解鎖的新使用場景。。。
GOOGLG-0.52%
ai驱动的这波半导体快速进步将显著推动量子计算发展,因为:
→ 器件一致性和晶圆良率提高
→ 更多低温合格器件进入封装
→ cryo-CMOS、复用和垂直互连解除I/O瓶颈
→ 提高封装后合格率及同时控制、读出能力
这些都是量子计算所需的核心能力
→ 器件一致性和晶圆良率提高
→ 更多低温合格器件进入封装
→ cryo-CMOS、复用和垂直互连解除I/O瓶颈
→ 提高封装后合格率及同时控制、读出能力
这些都是量子计算所需的核心能力
機器人的最終形態是人形,沒錯
但受限於靈巧手等技術和成本的限制,以及受益於模型的快速發展、3D 列印與個人化訂製的成熟,未來兩三年,機器人更可能先成為可快速改變形態以適應不同專門任務的半通用機器。
但受限於靈巧手等技術和成本的限制,以及受益於模型的快速發展、3D 列印與個人化訂製的成熟,未來兩三年,機器人更可能先成為可快速改變形態以適應不同專門任務的半通用機器。
支付巨頭Stripe以75 億美元的天價收購了僅在90天前估值還只有13 億美元的OpenRouter。
這筆Stripe歷史上最大規模的收購原因之一,是因為stripe認為人工智慧的「奇點」已於2026年1月1日正式到來。
OpenRouter為開發者提供了一個統一的介面,使大家能夠存取400多種AI模型。自2023年8月以來,該平台的每週Token交易量實現了驚人的24000倍增長,這種Token消耗量的指數級增長被視為智慧時代的新「摩爾定律」。
在AI模型變得日益繁雜、異質、價格波動且可靠性不一的背景下,大多數公司不願意將自己綁定在單一模型上,也無力親自管理所有模型。OpenRouter正是解決這一痛點的關鍵,它可以根據任務的複雜性、價格、速度和可靠性,自動將工作分配給最合適的模型。
Stripe之所以將2026年1月1日界定為「奇點」,是因為其內部私有指標在這一刻出現了非同尋常的急劇轉折:
首先,自2026年初開始,Stripe平台上新成立企業的數量呈現出拋物線式的垂直上升。
其次,Stripe提供了一個長達7年鮮有人問津的命令列介面(CLI),該介面的使用量在今年早些時候突然呈爆炸式增長。
這並非因為產品增加了新功能,而是因為Coding Agent發現了這個工具,並開始自主使用它來建構與Stripe相關的服務。
這兩個現象揭示了一個核心趨勢:大量新創公司在使用軟體和AI
這筆Stripe歷史上最大規模的收購原因之一,是因為stripe認為人工智慧的「奇點」已於2026年1月1日正式到來。
OpenRouter為開發者提供了一個統一的介面,使大家能夠存取400多種AI模型。自2023年8月以來,該平台的每週Token交易量實現了驚人的24000倍增長,這種Token消耗量的指數級增長被視為智慧時代的新「摩爾定律」。
在AI模型變得日益繁雜、異質、價格波動且可靠性不一的背景下,大多數公司不願意將自己綁定在單一模型上,也無力親自管理所有模型。OpenRouter正是解決這一痛點的關鍵,它可以根據任務的複雜性、價格、速度和可靠性,自動將工作分配給最合適的模型。
Stripe之所以將2026年1月1日界定為「奇點」,是因為其內部私有指標在這一刻出現了非同尋常的急劇轉折:
首先,自2026年初開始,Stripe平台上新成立企業的數量呈現出拋物線式的垂直上升。
其次,Stripe提供了一個長達7年鮮有人問津的命令列介面(CLI),該介面的使用量在今年早些時候突然呈爆炸式增長。
這並非因為產品增加了新功能,而是因為Coding Agent發現了這個工具,並開始自主使用它來建構與Stripe相關的服務。
這兩個現象揭示了一個核心趨勢:大量新創公司在使用軟體和AI
市場還沒意識到,這次 AI 對加密將帶來兩個本質的改變:
1、PoW 將產生真正價值,而不僅僅是無用的計算;
2、市場參與者將由人變成代理程式。
建立在真實價值上的及由代理程式高效參與的 DeFi 及各種生態,其爆發所能達到的市值很可能是之前週期所能達到的十倍百倍
1、PoW 將產生真正價值,而不僅僅是無用的計算;
2、市場參與者將由人變成代理程式。
建立在真實價值上的及由代理程式高效參與的 DeFi 及各種生態,其爆發所能達到的市值很可能是之前週期所能達到的十倍百倍
熱門話題
#美聯儲即將公布利率決定
31.72k 瀏覽量3.83k 人討論中
#CLARITY法案未獲通過
148.83k 瀏覽量7.35k 人討論中
#牛熊未定閒錢該放哪
64.13k 瀏覽量4.81k 人討論中
#BTC下跌3.3%
44.83k 瀏覽量458 人討論中
#OpenAI擬IPO前融資估值1.2萬億美元
69.87k 瀏覽量3.33k 人討論中
#美股加密概念股普跌
54.24k 瀏覽量4.1k 人討論中
#Meme代幣全線回調
27.36k 瀏覽量1.87k 人討論中
#Gate廣場中秋團圓局
2.48k 瀏覽量2.19k 人討論中
#Altera秘密提交IPO申請
26.16k 瀏覽量616 人討論中
#ETH 跌破 2400 美元
21.77k 瀏覽量1.26k 人討論中