Cluster Protocol 並非完全依賴中心化雲端服務,而是旨在讓個人與中小型企業(SME)接入由 GPU 資源組成的分散式網路。其模式主要用於釋放閒置或可用的運算能力,將其投入 AI 工作負載,同時建立一套依據 GPU 提供者貢獻程度發放獎勵的框架。
關鍵要點
- Cluster Protocol 是一種算力證明協議,用於去中心化 AI 運算。
- 該專案結合了 GPU 資源、去中心化基礎設施與全同態加密(FHE)。
- 其開源模式讓更廣泛的社群得以參與去中心化 AI 基礎設施的開發。
- GPU 提供者可以貢獻運算資源,並依據參與程度獲得獎勵。
- FHE 主要用於協助 AI 工作負載處理加密資料,無需以明文形式公開底層資訊。
- Cluster Protocol 旨在讓個人與中小型企業更便利地使用去中心化 AI 運算。
- CP 是與 Cluster Protocol 相關聯的原生代幣,可在 Gate 進行現貨交易。
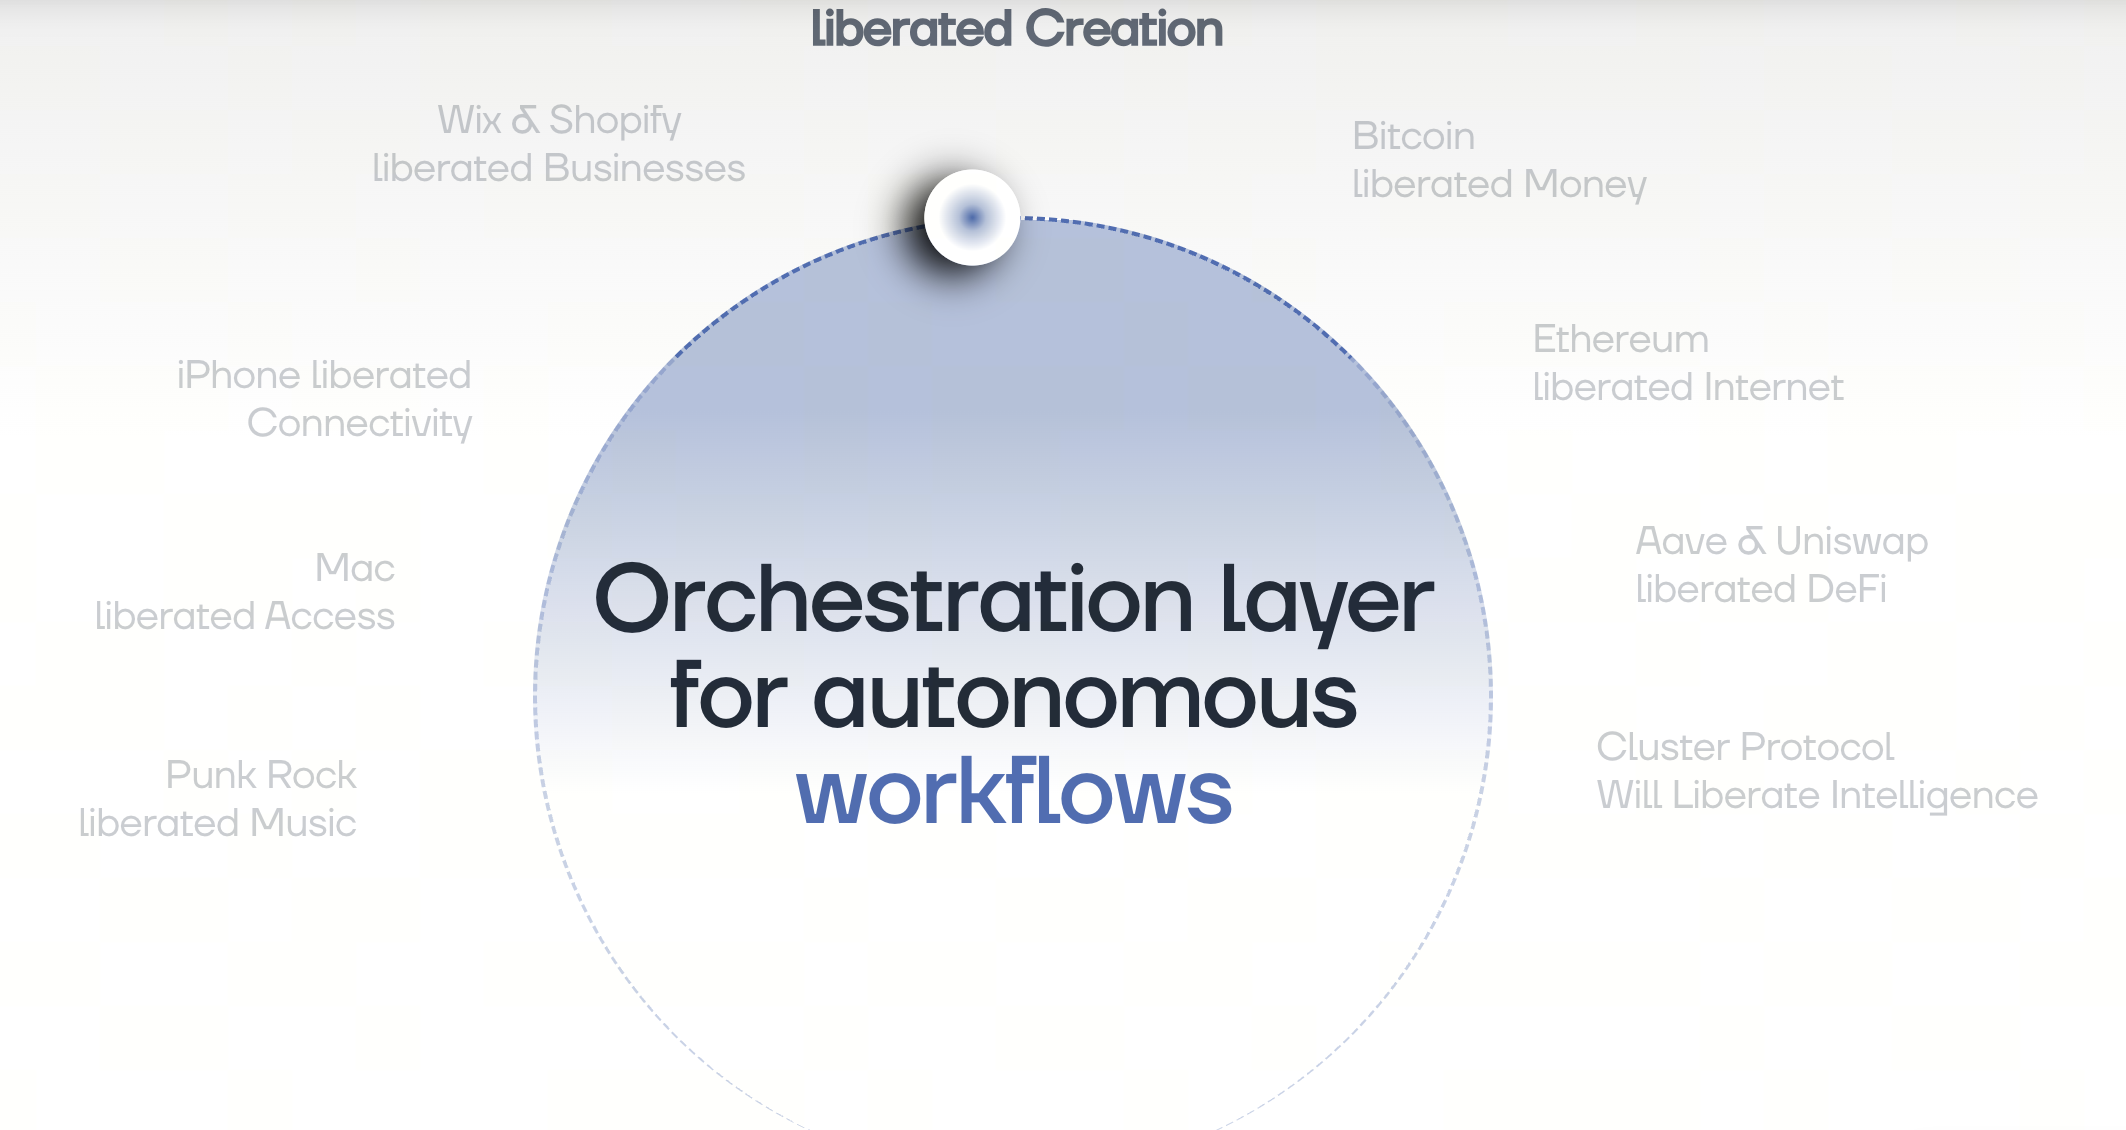
什麼是 Cluster Protocol?
Cluster Protocol 是一種去中心化運算協議,專注於透過分散式 GPU 資源支援 AI 模型的開發與推理。其核心理念是讓不同參與者提供運算資源並加入共享網路,為高度中心化的 AI 運算基礎設施建立替代方案。
該協議將自身定位為算力證明協議,意味著運算貢獻是其網路模型的重要組成部分。Cluster Protocol 不僅將 GPU 視為硬體,也試圖建立一套機制,用於衡量及驗證運算資源,並據此發放獎勵。
Cluster Protocol 同時也是一個開源社群。透過這種模式,開發者、GPU 提供者、研究人員及其他參與者均可參與去中心化 AI 基礎設施的開發。結合分散式運算與開源開發,旨在圍繞去中心化 AI 模型建立更廣泛的生態系統。
Cluster Protocol 如何運作?
Cluster Protocol 建立在將 AI 工作負載與分散式運算資源相互連接的理念之上。擁有可用 GPU 的參與者可以向網路貢獻運算能力,AI 相關工作負載則可使用這些資源。
去中心化運算模式有望更充分地利用原本可能閒置的運算資源。工作負載不必完全依賴大型中心化資料中心,也可以分散至參與網路的各台機器上。
在此模式下,算力證明機制至關重要,因為網路需要藉此區分實際的運算貢獻與僅僅聲稱擁有可用硬體的行為。透過將獎勵與運算參與程度掛鉤,Cluster Protocol 旨在激勵 GPU 提供者貢獻可靠資源。
隨著協議持續發展,工作負載分配、驗證與獎勵的具體實作方式可能會有所變化。因此,使用者應參考 Cluster Protocol 最新的技術文件,以了解實作層面的詳細資訊。
什麼是算力證明?
算力證明是一種用於證明參與者已向網路貢獻運算資源的機制。在去中心化運算系統中,這類驗證十分重要,因為參與者可能位於不同地區,並執行網路無法直接控制的硬體。
對 Cluster Protocol 而言,算力證明為將運算貢獻與獎勵掛鉤提供了基礎。參與者貢獻 GPU 運算能力,網路評估相關運算工作,協議則可利用這些資訊判定參與者的貢獻程度。
這種模式不同於部分區塊鏈採用的傳統工作量證明系統。工作量證明通常透過競爭性流程利用運算來保障區塊鏈網路安全;而去中心化 AI 基礎設施中的算力證明,則可著重於讓運算本身服務於 AI 模型訓練或推理等工作負載。
這項差異十分重要,因為其目標並非單純消耗運算能力。Cluster Protocol 旨在將運算資源用於具備實際用途的 AI 相關工作負載。
Cluster Protocol 為什麼使用 GPU?
GPU 對現代 AI 尤為重要,因為許多 AI 工作負載需要大量平行運算。訓練與執行機器學習模型可能涉及處理大型資料集,並同時執行大量數學運算。
中心化 AI 基礎設施通常依賴大型專業硬體叢集來處理這些工作負載。然而,GPU 也分散在個人使用者、開發者、研究機構與企業手中,其中許多裝置可能並未持續使用。
Cluster Protocol 的去中心化模式旨在將這些分散的資源與 AI 工作負載連接起來。若能有效協調運算資源,由眾多小型提供者組成的網路便有望支援 AI 基礎設施,而不要求每項工作負載都依賴單一中心化提供者。
對 GPU 所有者而言,這為可用運算能力提供了另一種潛在用途。參與者可以將閒置硬體貢獻給去中心化 AI 工作負載,並依據協議規則獲得獎勵,而非讓硬體長期處於閒置狀態。
FHE 在 Cluster Protocol 中發揮什麼作用?
全同態加密(Fully Homomorphic Encryption,簡稱 FHE)是一種可直接對加密資料執行運算的密碼學技術。對去中心化 AI 而言,其重要性源自分散式運算所面臨的隱私挑戰。
在傳統運算環境中,應用程式可能需要存取明文資料才能進行處理。若將工作負載交由第三方或分散式運算提供者處理,敏感資訊便可能暴露給基礎設施營運者。
FHE 引入了不同的處理模式。資料可在維持加密的狀態下執行特定運算,之後再由獲得授權的一方解密結果。
Cluster Protocol 將 FHE 納入其去中心化 AI 運算方案,目標是在降低向單一 GPU 提供者暴露敏感輸入資料需求的同時,讓分散式運算資源參與 AI 相關工作負載。
不過,FHE 可能需要大量運算資源,其實際效能取決於具體的密碼學方案、工作負載、硬體及實作方式。因此,FHE 應被視為一種隱私技術,而不應被視為能自動確保去中心化 AI 系統各個層面安全的保證。
為什麼隱私對去中心化 AI 很重要?
AI 應用可能處理各類資訊,範圍從公開資料集到企業專有資訊及其他敏感資料。將運算任務轉移至去中心化網路會帶來額外挑戰:使用者如何利用分散式運算,同時避免每個基礎設施提供者直接存取正在處理的資料?
這正是隱私保護運算可以發揮作用的地方。透過採用 FHE 等技術,去中心化 AI 基礎設施有望將執行運算的能力與查看底層資料的能力分離。
對個人使用者而言,這可能使去中心化 AI 更適合處理涉及私人資訊的工作負載。對中小型企業而言,這可能讓其在無需直接向第三方 GPU 提供者披露敏感商業資料的情況下,使用分散式運算資源。
實際的隱私保障仍取決於完整的系統架構,包括加密實作、金鑰管理、軟體安全性,以及建立在協議之上的應用程式。
GPU 提供者如何獲得獎勵?
GPU 提供者會向 Cluster Protocol 網路貢獻運算資源。該協議的獎勵模式旨在建立經濟誘因,鼓勵參與者將硬體提供給去中心化 AI 工作負載使用。
這構成一種雙向關係。使用者與 AI 開發者可以使用分散式運算資源,GPU 提供者則可因貢獻這些資源而獲得補償。
可持續的去中心化運算網路需要平衡雙方利益。若獎勵不足,提供者可能缺乏維護硬體及保持可用性的動力;若運算需求不足,提供者也可能缺少貢獻資源的機會。
因此,Cluster Protocol 的算力證明模式與其激勵機制密切相關。驗證有效運算貢獻的能力,有助於為在參與網路的 GPU 提供者之間分配獎勵奠定基礎。
誰可以使用 Cluster Protocol?
Cluster Protocol 旨在支援去中心化 AI 生態系統中的多類參與者。
GPU 提供者
擁有合適 GPU 資源的個人或組織可以向網路貢獻運算能力,為運算硬體服務於 AI 工作負載提供一種方式。
AI 開發者
開發者可以使用去中心化運算資源支援 AI 模型工作負載,而不必完全依賴中心化基礎設施提供者。
中小型企業
中小型企業可以使用分散式運算資源與注重隱私的基礎設施,而無需自行建置大型 AI 資料中心。
開源貢獻者
由於 Cluster Protocol 重視開源社群,開發者與研究人員可以透過軟體開發、研究、基礎設施改進及其他參與方式,為生態系統作出貢獻。
Cluster Protocol 與去中心化 AI
去中心化 AI 是指將 AI 基礎設施、運算、資料或模型開發的部分環節分散至多個參與者之間,而不是將其集中於少數中心化組織內部。
Cluster Protocol 尤其關注其中的運算環節。其模式將分散式 GPU 資源與用於驗證運算貢獻、保護處理期間資料的機制結合起來。
隨著 AI 工作負載持續增加,這種模式回應了兩項日益重要的挑戰:運算資源取得與資料隱私。中心化提供者可以提供顯著的規模優勢,但去中心化基礎設施有望創造額外的運算能力來源,並降低對單一基礎設施提供者的依賴。
這種模式的有效性最終取決於網路參與度、可用 GPU 容量、工作負載需求、驗證機制及隱私保護技術效能等因素。
什麼是 CP 代幣?
CP 是與 Cluster Protocol 相關聯的代幣,也是該專案整體經濟生態的一部分,並與協議的去中心化運算模式相關。
CP 的具體用途與代幣經濟學可能取決於協議的實作方式及未來發展。使用者應區分代幣本身與運算基礎設施:持有 CP 不會自動取得 GPU 運算能力,而提供運算資源也不一定代表每位參與者都會以相同方式使用 CP。
隨著 Cluster Protocol 生態系統持續發展,CP 的作用可能與網路參與、激勵機制及其他協議功能建立更緊密的聯繫。目前的代幣詳情應以該專案最新的官方文件為準。
CP 可以在哪裡交易?
CP 可在 Gate 進行現貨交易。
交易前,使用者應核實交易所顯示的目前交易對、充值與提現網路,以及其他資產資訊。
Cluster Protocol 的潛在優勢是什麼?
分散式運算資源
Cluster Protocol 有望聚合來自不同參與者的 GPU 資源,為 AI 工作負載建立去中心化的運算能力來源。
隱私保護運算
FHE 主要用於透過允許在加密資料上執行特定運算來提升資料隱私。
對 GPU 提供者的激勵
算力證明模式可以將有效的運算貢獻與獎勵掛鉤,從而激勵參與者提供 GPU 運算能力。
提升小型參與者的可及性
對於無法營運大型中心化資料中心的個人與中小型企業而言,去中心化基礎設施有望讓其更容易使用 AI 運算資源。
開源開發
開源社群能讓開發者與研究人員檢視、改進並擴展相關基礎設施,從而有望支援更多參與者加入生態系統。
Cluster Protocol 面臨哪些風險?
Cluster Protocol 也面臨去中心化 AI 和分散式運算網路通常存在的多項挑戰。
運算效能風險: 與傳統處理方式相比,FHE 可能帶來額外的運算開銷。因此,去中心化 AI 工作負載的效率在很大程度上取決於實作方式與硬體效能。
網路協調風險: 去中心化 GPU 網路必須協調不同機器、地點及硬體配置之間的資源。與受控營運的中心化資料中心相比,維持穩定效能可能更加困難。
提供者可靠性風險: 不同 GPU 提供者的線上時間、頻寬、硬體規格與維護計畫可能存在差異。協議需要建立相應機制來管理這些差異。
安全風險: 加密可以提升隱私性,但無法消除所有安全風險。軟體漏洞、金鑰管理故障、惡意節點與應用層缺陷仍可能影響去中心化 AI 系統。
採用風險: 去中心化運算網路的長期實用性取決於供給與需求兩方面。網路既需要足夠多的 GPU 提供者,也需要充足的 AI 工作負載,才能建立可持續的生態系統。
代幣風險: CP 是一種加密資產,可能經歷顯著的市場波動。其市場價值可能無法直接反映網路上正在進行的運算活動規模。
去中心化 AI 運算的未來是什麼?
隨著模型規模持續擴大、AI 應用日益普及,AI 基礎設施越來越依賴運算能力。這為能夠補充傳統中心化提供者的替代性基礎設施模式創造了機會。
去中心化 AI 運算試圖透過將分散的硬體轉化為協調資源來把握這一機遇。Cluster Protocol 等專案則專注於結合運算激勵與隱私技術,讓這種模式更具實用性。
去中心化 AI 的長期發展可能取決於分散式網路能否提供具競爭力的效能、可靠的基礎設施、充分的隱私保護及具吸引力的經濟模式。對 Cluster Protocol 而言,其 GPU 網路、開發者社群、AI 工作負載及配套應用的成長,將是值得關注的重要因素。
結語
Cluster Protocol 是一種算力證明協議與開源社群,專注於去中心化 AI 運算。其模式結合分散式 GPU 資源與全同態加密,以應對 AI 基礎設施面臨的兩項重要挑戰:運算能力取得與資料隱私。
Cluster Protocol 透過為 GPU 提供者建立激勵,並將其資源與 AI 工作負載連接起來,旨在建構更加分散式的運算環境。同時,FHE 提供了注重隱私的層,有助於降低運算期間暴露敏感資料的需求。
該專案的長期潛力將取決於實際採用情況,而不僅是其概念本身。網路容量、工作負載需求、運算效率、安全性、隱私實作方式,以及 CP 代幣的作用,都是可能影響其生態系統發展的因素。
常見問題
什麼是 Cluster Protocol?
Cluster Protocol 是一種算力證明協議與開源社群,專注於去中心化 AI 模型和分散式 GPU 運算。
什麼是算力證明?
算力證明是一種用於驗證或衡量網路內運算貢獻的機制。在 Cluster Protocol 中,該機制用於將 GPU 資源與獎勵關聯起來。
Cluster Protocol 中的 FHE 是什麼?
FHE 是全同態加密(Fully Homomorphic Encryption)的縮寫。這是一種密碼學技術,支援直接在加密資料上執行特定運算,從而實現隱私保護運算。
誰可以向 Cluster Protocol 提供運算能力?
擁有合適 GPU 資源的個人與組織,在符合協議技術要求的前提下,可以作為運算提供者參與其中。
CP 有什麼用途?
CP 是與 Cluster Protocol 相關聯的代幣。其具體用途取決於協議目前的實作方式及發展情況。
CP 可以在哪裡交易?
CP 可透過 CP/USDT 交易對在 Gate 進行現貨交易。
Cluster Protocol 是 DePIN 專案嗎?
Cluster Protocol 具備去中心化實體基礎設施網路(DePIN)的一些特徵,因為它協調分散式實體運算資源。不過,具體定位仍應結合其算力證明與去中心化 AI 基礎設施模式來理解。
* 投資有風險,入市須謹慎。本文不作為 Gate 提供的投資理財建議或其他任何類型的建議。
* 在未提及 Gate 的情況下,複製、傳播或抄襲本文將違反《版權法》,Gate 有權追究其法律責任。
分享
目錄


相關文章
Solana需要 L2 和應用程式鏈?
Sui:使用者如何利用其速度、安全性和可擴充性?
Morpho 代幣經濟學深入解析:MORPHO 的應用、分配方式與價值邏輯
Morpho vs Aave:深入解析 DeFi 借貸協議的機制與結構差異
USD.AI 效益來源解析:AI 基礎設施貸款如何創造收益