Square
Seguindo
Em alta
Notícias
Notificações
Perfil

torygreen

vip
Ainda não há conteúdo
Nível máximo VIP 03.2 ano(s)
0
Seguindo
17
fan
112
Curtida
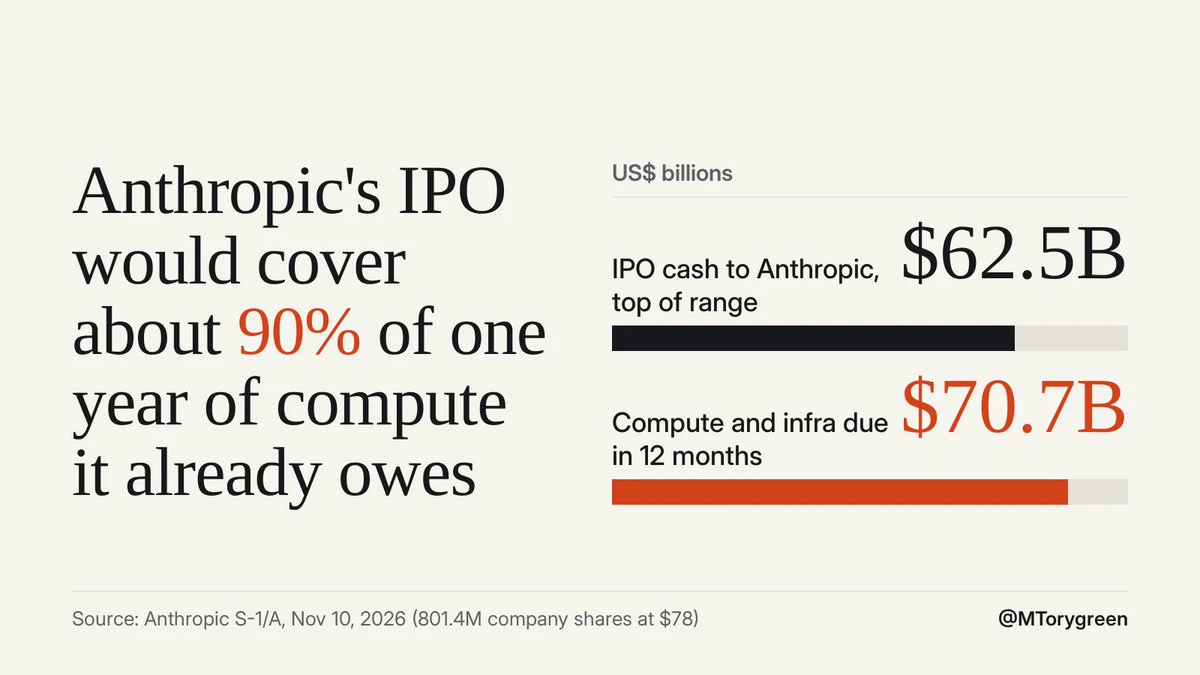
.@AnthropicAI poderia levantar cerca de $62B para si no IPO.
Ela já tem US$ 69,8 bilhões em compromissos com computação + infraestrutura vencendo nos próximos 12 meses.
Isso meio que coloca a escala da IA de ponta em perspectiva. Dá para realizar um dos maiores IPOs de todos os tempos, e a maior parte desse dinheiro equivale, mais ou menos, a um ano de computação com o qual você já se comprometeu.
E eles estão reservando boa parte dessa capacidade com 12–18 meses de antecedência, antes que alguém saiba qual modelo estará na liderança até lá.
Os mercados públicos estão basicamente prestes a co
post-image
O uso de IA pode continuar crescendo mais rápido do que a inteligência fica mais barata?
O IPO da @AnthropicAI pode chegar a uma avaliação de cerca de US$ 1,5 trilhão, enquanto a Ramp vê o volume de tokens crescer 37% em um mês, os gastos aumentarem apenas 9% e os preços combinados da OpenAI + Anthropic caírem quase 27%.
Ao mesmo tempo, modelos de pesos abertos como o DeepSeek já estão na fronteira em programação e outras tarefas por uma fração minúscula do custo.
A Anthropic continua crescendo apesar de tudo isso, o que é impressionante. Mas, com 79% da receita vinculada ao uso e quase $895B
RAMP+0,70%
OPENAI-0,04%
DEEPSEEK-2,21%
44 de 45 medidas locais sobre data centers nas cédulas eleitorais foram favoráveis a restrições nesta semana.
E alguns dos maiores estados em expansão de IA acabaram de mudar de mãos:
O Texas elegeu Gina Hinojosa, que afirma que o desenvolvimento de novos data centers deve ser suspenso até que haja proteções em vigor. Só o Texas representa cerca de 25% da capacidade planejada nos EUA.
A Geórgia elegeu Keisha Lance Bottoms, que fez campanha pela suspensão de novos data centers. Atlanta tem atualmente ~2,9 GW em construção, o maior pipeline da América do Norte.
Ohio elegeu Amy Acton, que afirmou
post-image
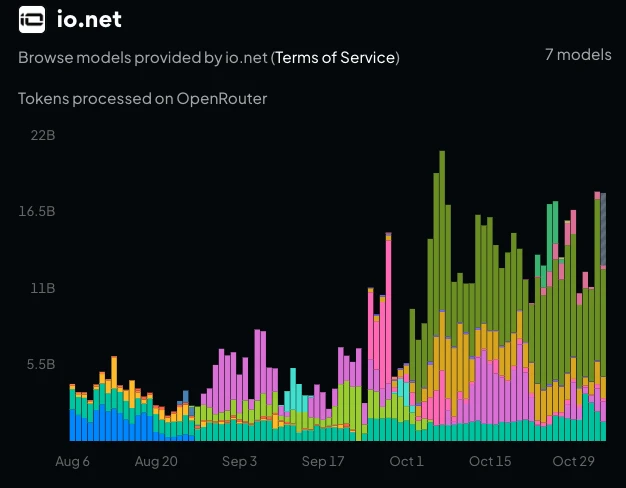
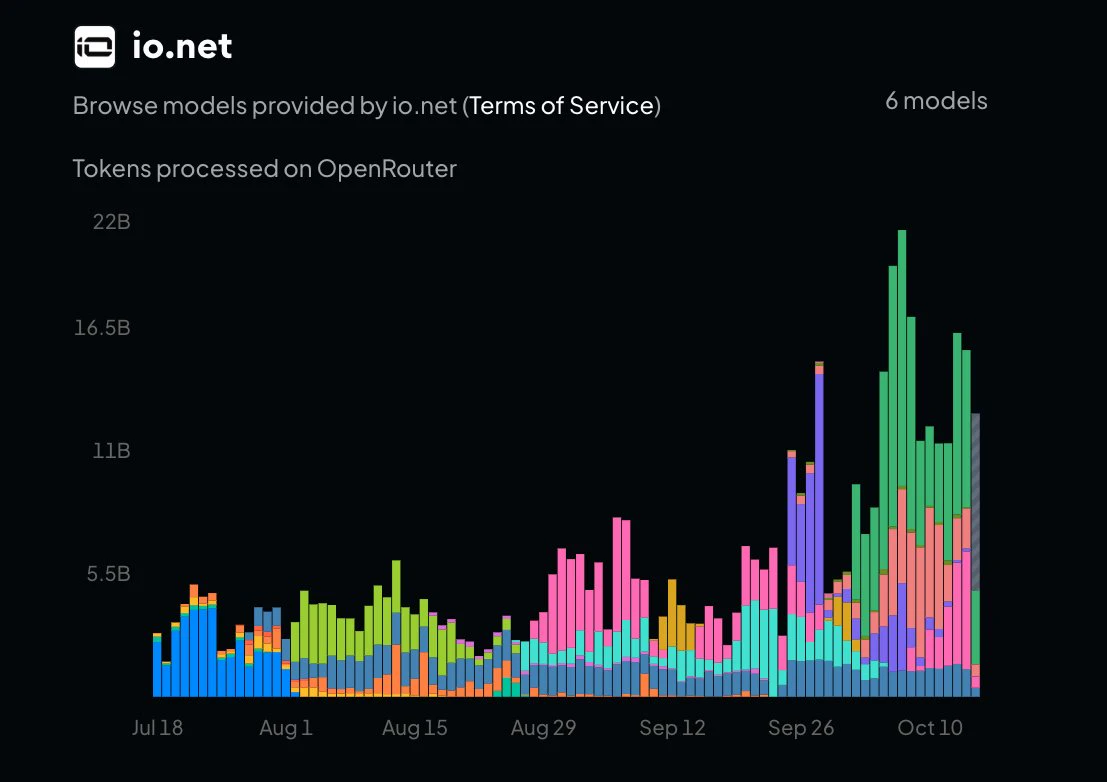
.@ionet processou cerca de 416 bilhões de tokens pelo OpenRouter em outubro.
Sustentar cerca de 13,4 bilhões de tokens por dia em uma rede distribuída de GPUs é quando a arquitetura começa a ser realmente testada.
O roteamento entre hardwares variados, a manutenção de uma latência previsível e a capacidade de tornar as falhas invisíveis para o usuário passam a ser muito mais importantes quando o tráfego é tão constante.
No geral, foi um mês muito forte para a ionet e uma boa amostra de como a rede poderia ser em uma escala muito maior.
post-image
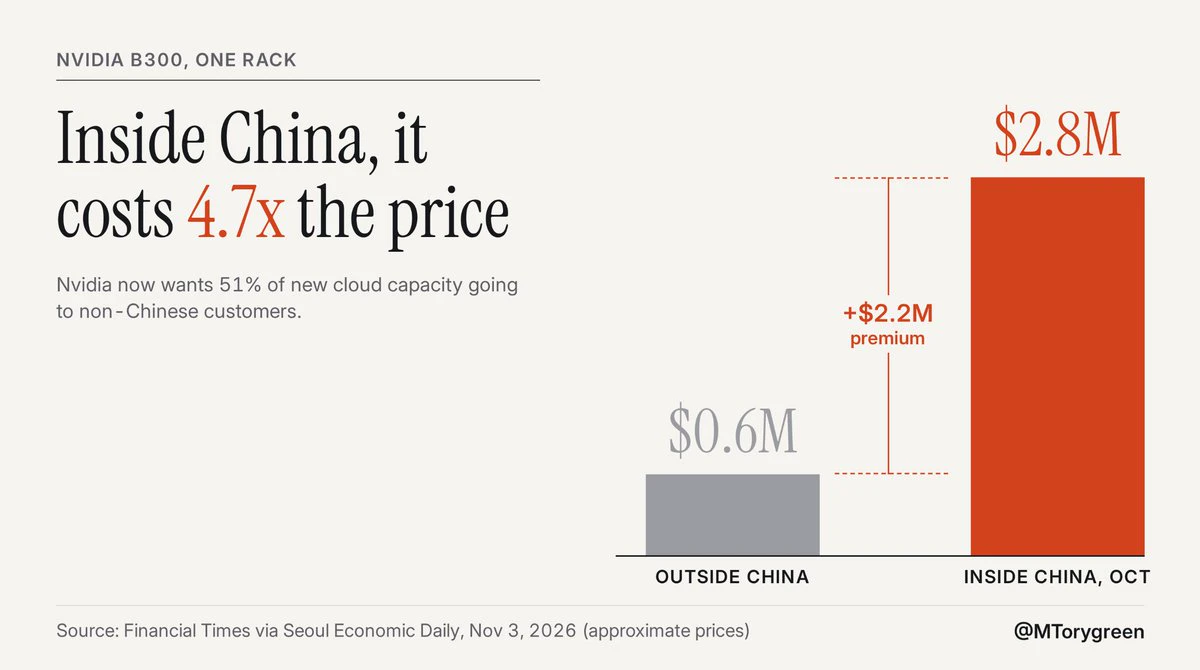
O mesmo rack B300: cerca de $600k fora da China, cerca de US$ 2,8 milhões dentro dela. Não é de se admirar que os laboratórios chineses simplesmente aluguem capacidade no exterior.
Agora, a Nvidia está dizendo aos provedores de nuvem que pelo menos 51% da nova capacidade precisa ser destinada a clientes não chineses (via FT). Os acordos existentes ficam isentos.
Os que me preocupariam são os neoclouds asiáticos cuja demanda depende inteiramente dos laboratórios chineses. Uma operadora de Singapura já diz que é difícil encontrar compradores não chineses fora dos EUA. Se não conseguirem preench
post-image
NVDA-5,47%
  • 7
Mesmo modelo. Mesmas tarefas. 88% menos tokens.
Pesquisadores reconstruíram o loop em torno do DeepSeek Harness, e os tokens por tarefa do HumanEval caíram de 96 mil para 11,6 mil. Ele também resolveu mais tarefas: de 71% para 86%.
Grande parte do que os agentes consomem é o loop repensando um trabalho que já havia sido concluído após cada chamada de ferramenta. Elimine isso e a conta cai cerca de 8 vezes, sem mexer nos pesos.
Se você está prevendo a demanda por inferência com base nos tokens por tarefa de hoje, uma grande parte desse número se deve apenas à ineficiência do harness. E os harne
DEEPSEEK-2,21%
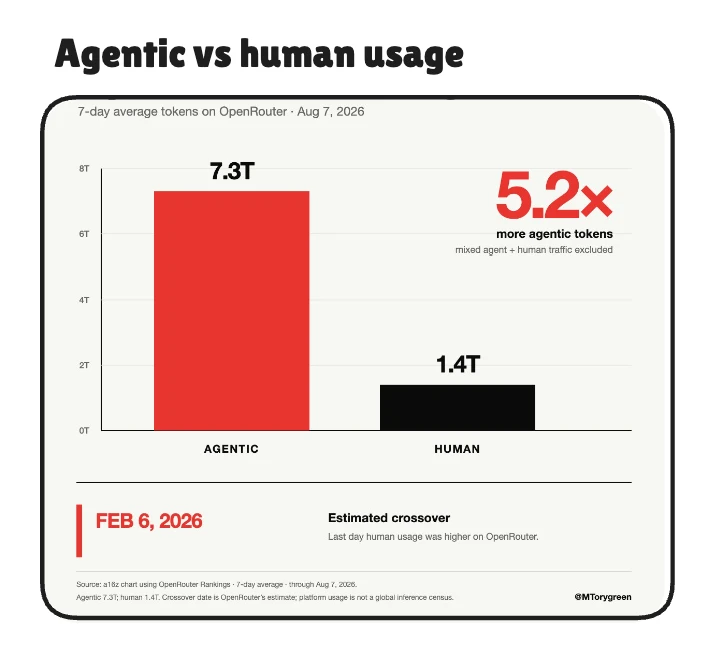
6 de fev. aparentemente foi o último dia em que humanos consumiram mais tokens do que agentes na @OpenRouter.
O uso semanal passou de 0,5 trilhão de tokens em jan. de 2025 para 128,4 trilhões em set. de 2026. Cerca de 250x em 20 meses.
Acho que essa primeira estatística importa muito mais do que a maioria dos gráficos de crescimento de usuários de IA.
Os humanos têm um limite bem claro para quanto de IA conseguem usar em um dia. Os agentes podem funcionar durante a noite, tentar novamente, chamar outros agentes e continuar consumindo capacidade computacional a velocidades absurdas.
Quando as m
post-image
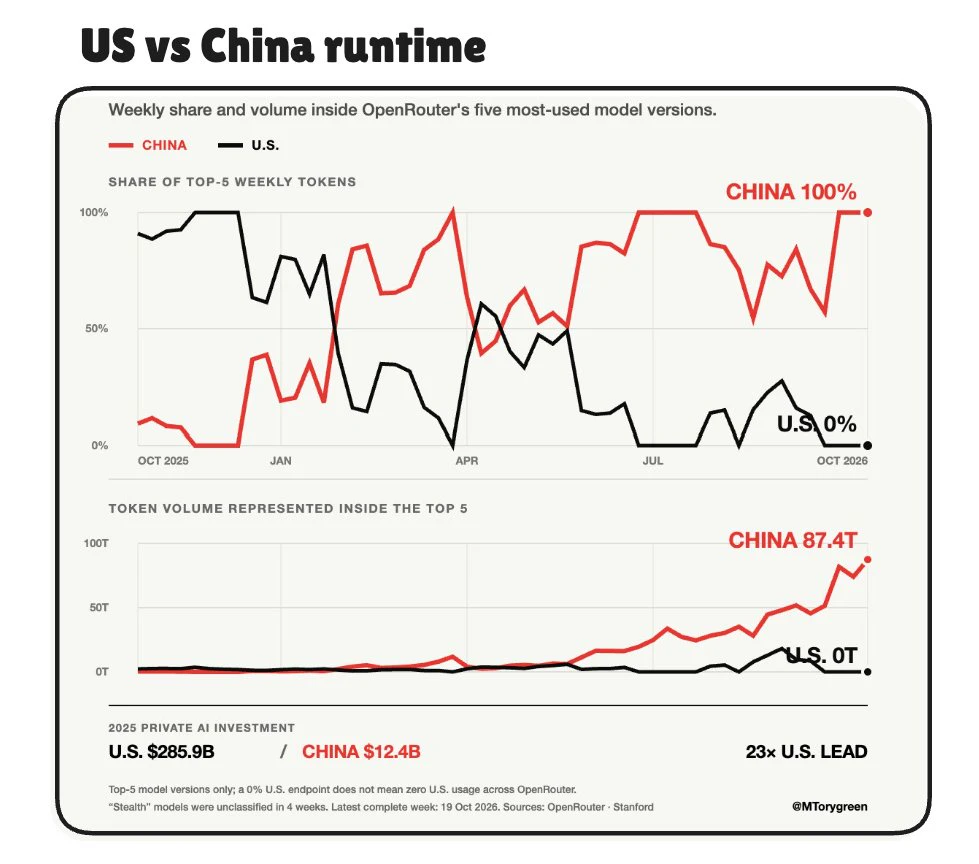
Os EUA investiram cerca de 23 vezes mais capital privado em IA do que a China.
Enquanto isso, os 5 modelos mais usados no OpenRouter eram chineses e processaram cerca de 74 trilhões de tokens.
Essa divisão é bastante surpreendente.
Os laboratórios dos EUA estão vencendo a corrida pelo capital, mas os modelos chineses estão se espalhando pela parte da stack com que os desenvolvedores interagem todos os dias: inferência, agentes, ferramentas de programação e cargas de trabalho baratas de API.
Se isso continuar se acumulando, a China não precisa gastar mais que os EUA para ganhar influência. Bast
post-image
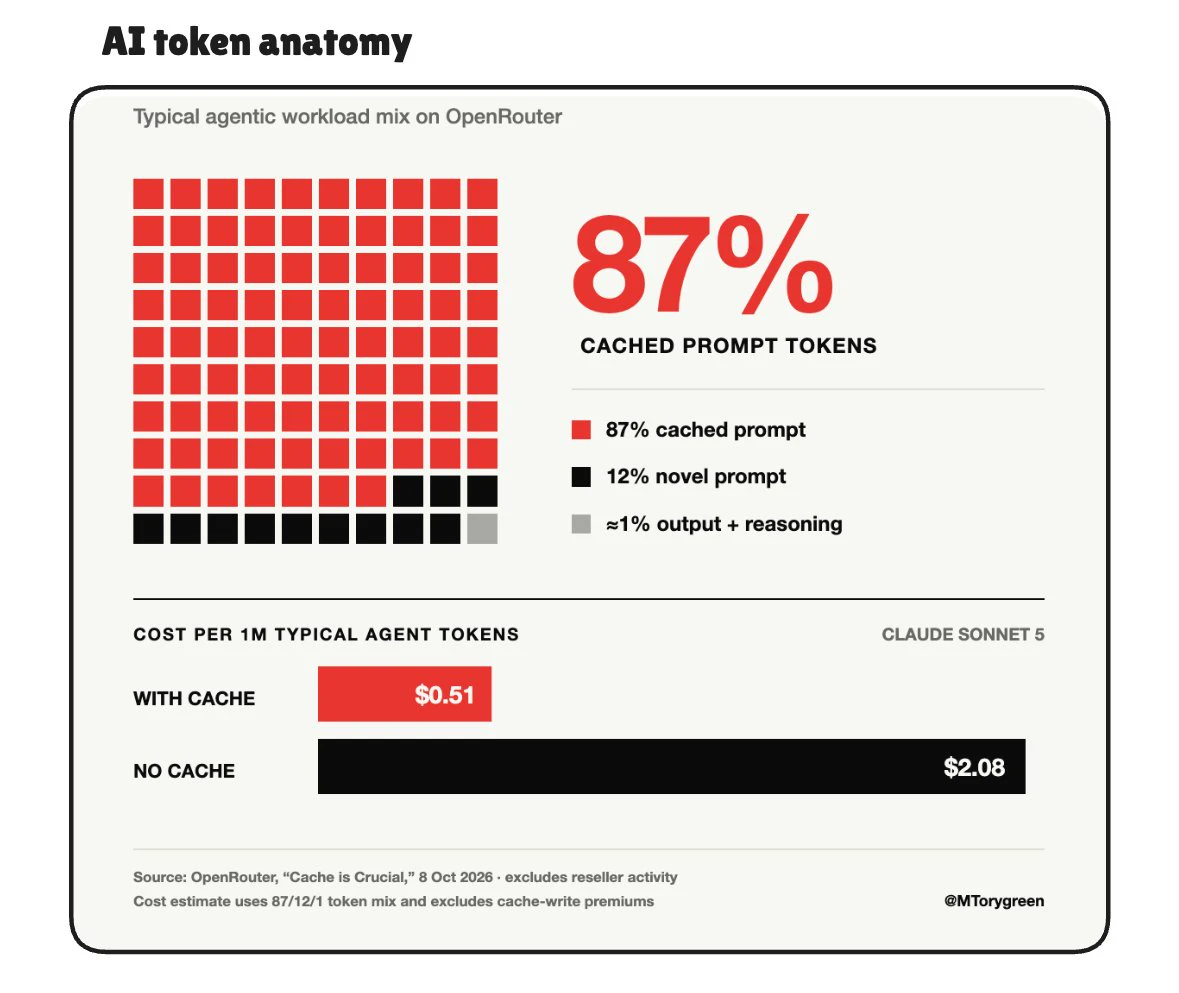
Quase 90% dos tokens de agentes na @OpenRouter são leituras de cache.
A saída + o raciocínio representam apenas ~1%.
E as chaves de API de agentes já consomem ~7x mais tokens do que as usadas por humanos.
Faz sentido quando você vê como os agentes realmente funcionam. A cada etapa, o prompt do sistema, as definições de ferramentas, os arquivos, as chamadas anteriores de ferramentas + o estado da conversa passam novamente pelo modelo.
Um agente em execução por muito tempo basicamente se torna um enorme conjunto de trabalho que precisa permanecer aquecido.
Os provedores também estão se adaptando
post-image
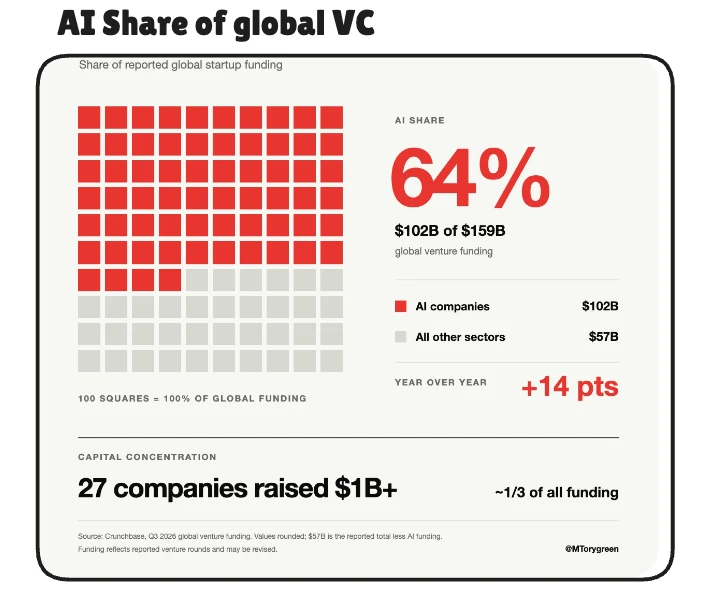
A IA ficou com 64% do financiamento global de capital de risco no 3º trimestre.
$102B de um total de US$ 159 bilhões.
E, de algum modo, o dinheiro está ficando mais concentrado ao mesmo tempo.
27 empresas captaram rodadas de mais de US$ 1 bilhão e absorveram cerca de 1/3 de todo o financiamento global. Rodadas de mais de US$ 100 milhões representaram quase 90% do financiamento em estágio avançado.
A IA de ponta está começando a se parecer menos com investimentos convencionais em software e mais com indústria pesada, com custos iniciais absurdos.
Poder computacional, data centers, treinamento,
post-image
A IA pode acabar forçando as empresas a parar de operar com base no conhecimento tribal.
Os agentes não conseguem contornar as coisas que os humanos fazem de algum jeito: decisões presas em reuniões, prioridades na cabeça de alguém, exceções estranhas que todos conhecem, mas que ninguém registrou.
@AnthropicAI já está esbarrando nisso. Eles têm aproximadamente 6 horas-agente em operação para cada hora de funcionário humano, mas esses agentes ainda passam a maior parte do tempo interativo esperando pelas pessoas.
Os funcionários estão criando instruções permanentes, monitores, revisores-agentes
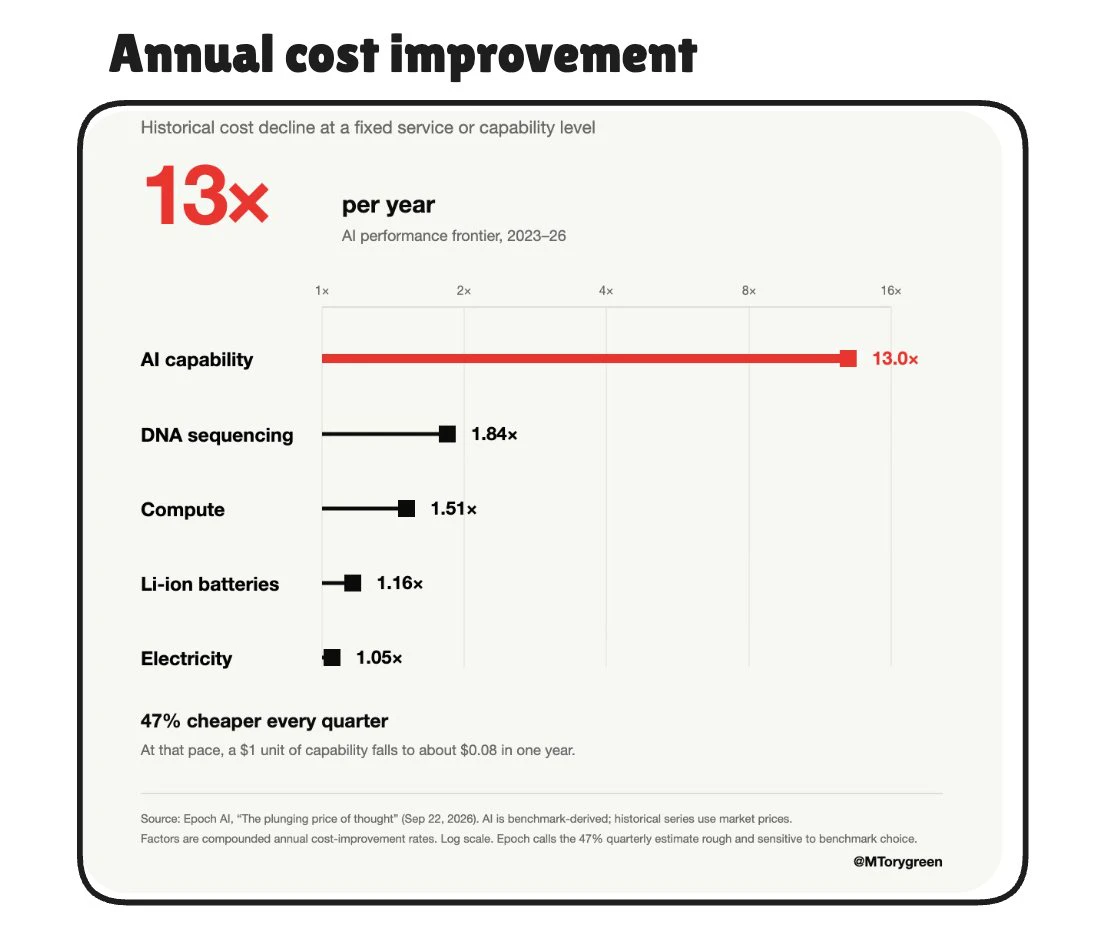
Uma unidade de capacidade de IA de US$ 1 hoje cai para cerca de 8 centavos um ano depois, se a curva atual se mantiver.
47% mais barata a cada trimestre significa que uma capacidade fixa fica basicamente pela metade do preço a cada ~100 dias.
O hardware subjacente não está avançando nem perto desse ritmo.
O desempenho/preço dos chips de IA melhorou ~49% ao ano desde 2023. A capacidade dos modelos ajustada pela qualidade está ficando ~13 vezes mais barata.
Portanto, a maior parte da compressão está acontecendo acima do silício: arquiteturas melhores, treinamento, quantização, serving + competiç
post-image
LUNA-2,88%
  • 1
.@ionet está em cerca de 165 bilhões de tokens até @OpenRouter nos primeiros 13 dias de outubro.
Isso já representa cerca de 1,8x tudo o que fizemos em julho.
Se o ritmo atual se mantiver, outubro ficará em algum ponto próximo de 4x o volume total de julho.
Sinceramente, isso me importa mais do que a quantidade bruta de GPUs.
A produção útil por GPU implantada continua aumentando à medida que os modelos esparsos melhoram e a stack de serving fica mais otimizada. Assim, a rede pode crescer em duas direções ao mesmo tempo: mais hardware entrando em operação e mais trabalho sendo extraído do que
post-image
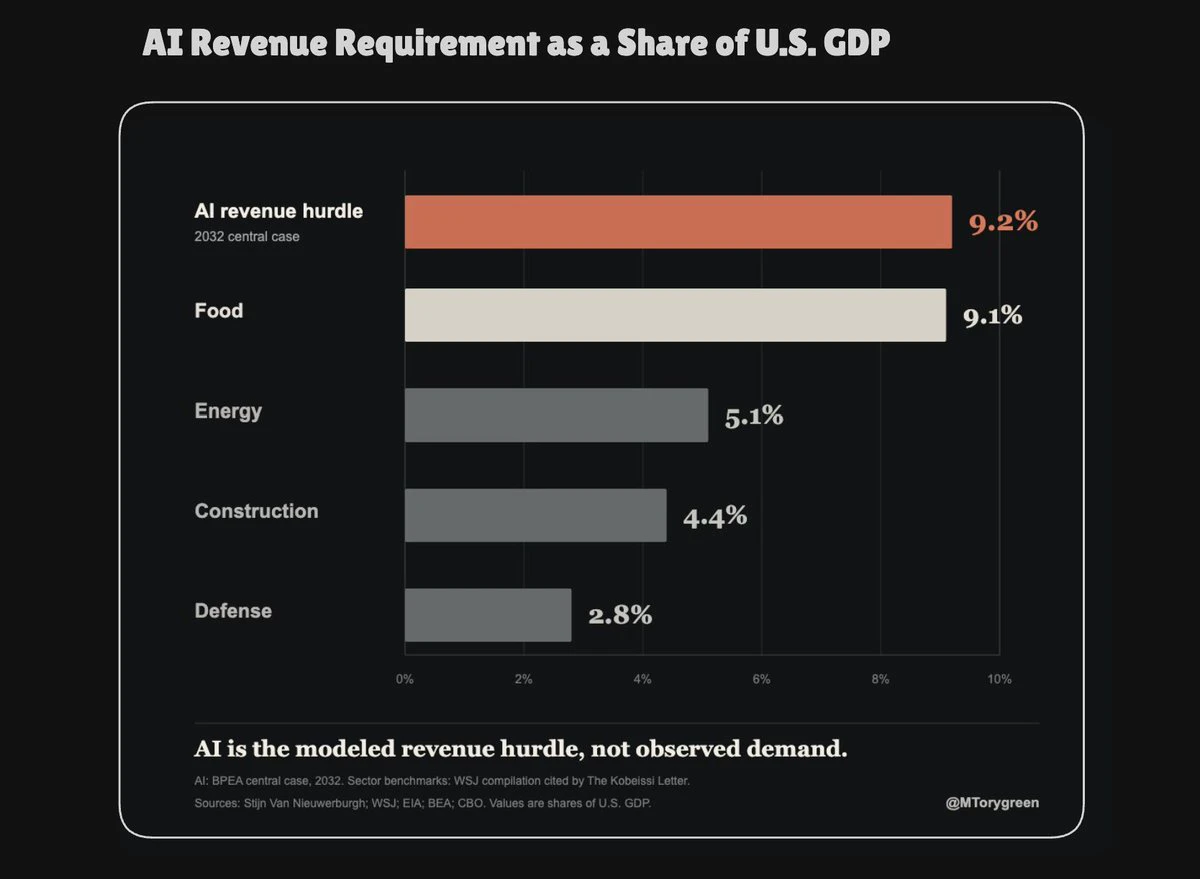
Até 2032, as contas atuais da expansão da IA exigem cerca de 183 GW de capacidade gerando ~US$ 6,90 por hora-GPU faturada a 80% de utilização.
Isso representa uma quantidade enorme de infraestrutura que precisa permanecer ocupada.
O cenário central de Van Nieuwerburgh pressupõe uma base de capital de ~US$ 9,6 trilhões, retornos desalavancados de 10%, margens de fluxo de caixa operacional de 50% e uma vida útil de seis anos para os equipamentos de TI.
Nesse cenário, o sistema precisa de US$ 3,725 trilhões em receita anual, cerca de 9,2% do PIB projetado dos EUA.
Altere as premissas, e essa exig
post-image
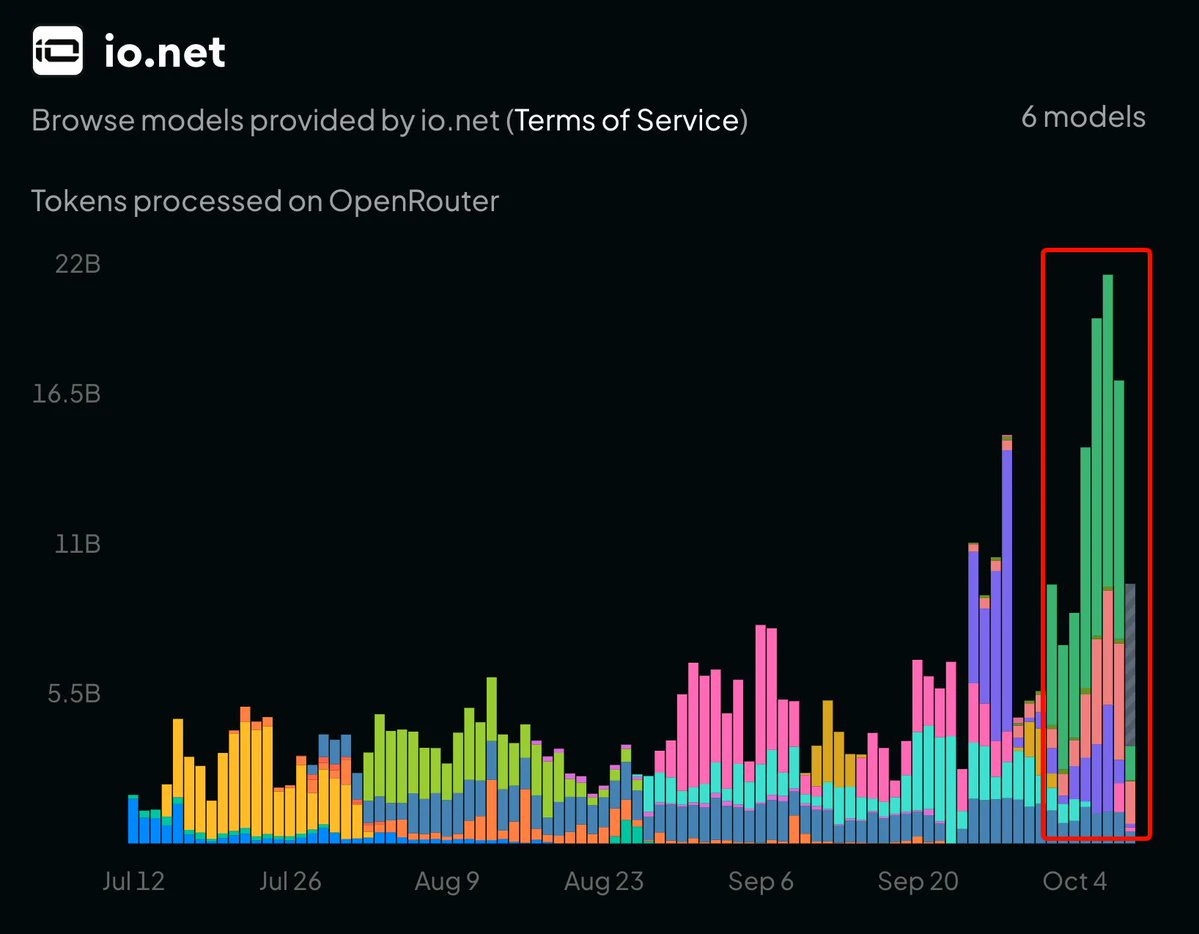
.@ionet processou quase tantos tokens por meio de @OpenRouter na primeira semana de outubro quanto em todo o mês de julho.
~92 bilhões de tokens em julho
~86 bilhões de tokens de 1º a 7 de outubro
20,9 bilhões apenas em 7 de outubro
As mesmas máquinas.
O que mais gosto é como o volume está aparecendo.
Grande parte do volume recente está fluindo por modelos esparsos como MiMo, Gemma e Nemotron, nos quais apenas uma pequena fração do modelo é ativada a cada token. Combine isso com melhor processamento em lotes, cache, roteamento e infraestrutura de serving, e a economia da mesma frota de GPUs co
post-image
Podemos estar subestimando enormemente por quanto tempo a computação de IA permanece economicamente útil.
Sistemas 8x A100 com 6 anos ainda estão sendo vendidos por US$ 75 mil–US$ 85 mil, cerca de 40% do seu preço original de ~$199K . Aparentemente, os credores de infraestrutura de IA modelam um valor residual mais próximo de 25%.
O erro pode estar em tratar GPUs antigas como celulares antigos.
Uma A100 não se torna inútil quando a próxima geração é lançada; o provedor pode rebaixá-la com atualizações de software. Ela apenas é rebaixada de categoria.
O treinamento de fronteira avança, enquanto
MSFT-2,15%
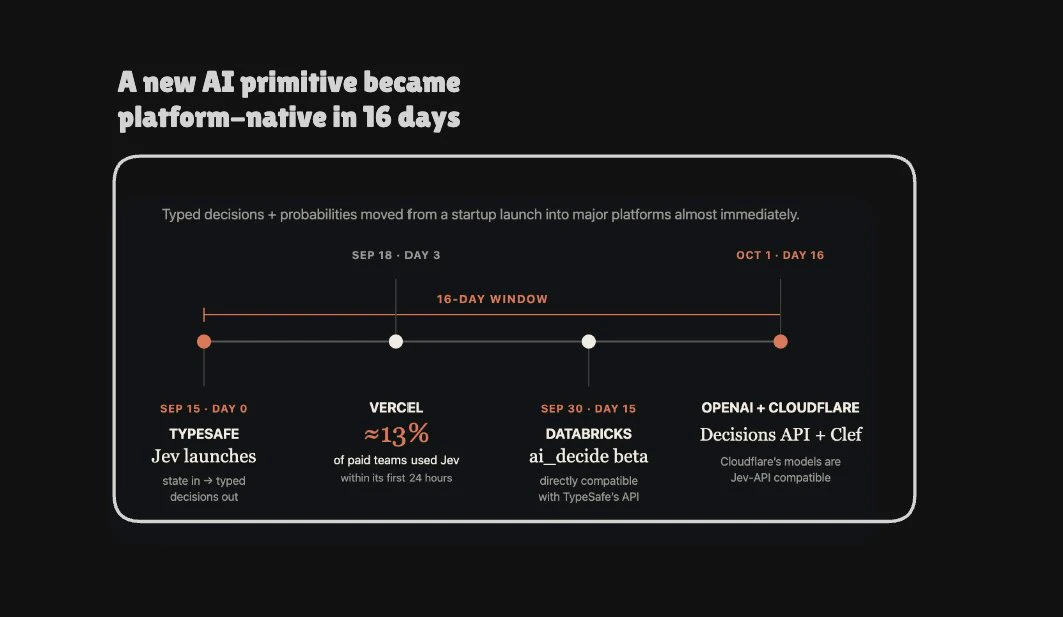
Jev talvez seja o exemplo perfeito de quão rápido uma boa ideia de IA é comoditizada hoje.
Ele foi lançado em 15 de setembro. Em duas semanas, OpenAI, Databricks + Cloudflare já estavam lançando soluções baseadas na mesma primitiva. O Clef-flash da Cloudflare é até compatível com Jev e afirma ter uma latência mediana ~13x menor.
Então, a demanda não era o problema. A ideia era simplesmente fácil de absorver assim que todos viram que funcionava.
Parece que o diferencial aqui precisa ser o ciclo de feedback, dados proprietários + distribuição.
Jev encontrou a categoria. Todos os outros aparecera
post-image
OPENAI-0,04%
NET+4,13%
  • 6
  • 1
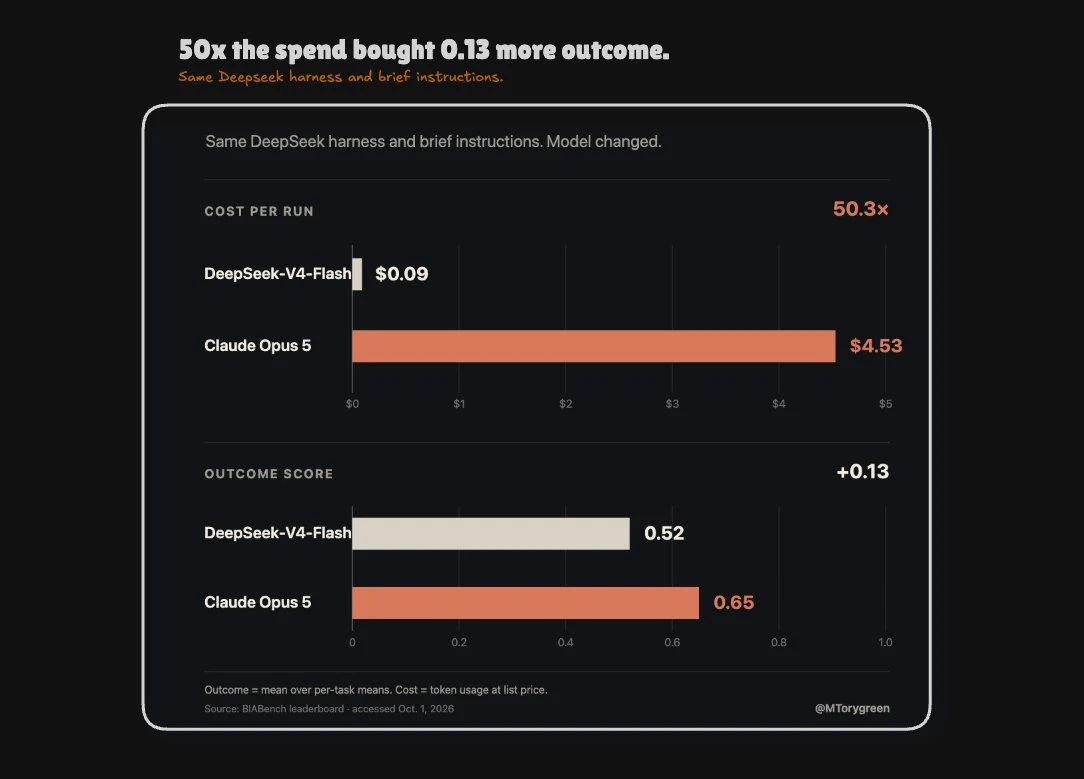
Mesmo harness do Deepseek, mesma instrução curta e:
Deepseek-v4-flash marca 0,52 no BIABench.
Claude Opus 5 chega a 0,65.
Então, gastar cerca de 50x mais compra apenas 0,13 a mais na pontuação em 16 tarefas reais de análise de bioimagens.
E a cauda problemática quase não muda. Algumas tarefas 3D + séries temporais permanecem abaixo de 0,19 em todos os agentes, enquanto repetir o mesmo modelo pode gerar uma variação maior do que trocar completamente de modelo.
Eu provavelmente usaria o modelo barato no volume rotineiro e depois encaminharia os casos incertos para humanos ou ferramentas especial
post-image
Depositar mais