Para leitores que escolhem por tarefa, o ponto principal não é “qual lado é mais forte”, mas se a falha prejudica mais como absurdo fluente ou como desvio nas dinâmicas. As seções abaixo comparam um modelo de mundo com um LLM em alvos de previsão, dados/avaliação, tarefas adequadas, regras de combinação e interpretações equivocadas. Os limites de capacidade ficam ao lado de Superinteligência (ASI); os limites de implantação ficam ao lado de IA privada.
Principais conclusões
- Modelos de mundo otimizam dinâmicas latentes/próximo estado condicionadas por ação; LLMs otimizam o próximo token e a estrutura textual.
- Prefira modelos de mundo para planejamento e controle incorporados; prefira LLMs para redação, perguntas e respostas com recuperação de informações e chamada de ferramentas.
- Quando uma tarefa exige tanto uma interface de linguagem quanto dinâmicas de ambiente simuláveis, combine os dois em vez de tratá-los como substitutos.
- Os modos de falha são diferentes: LLMs frequentemente falham por alucinação de linguagem; modelos de mundo, por desvio nas dinâmicas e física falsa.
O que é um modelo de mundo?
Um modelo de mundo é um sistema de dinâmicas aprendido: dado um estado atual (ou observação) e uma ação candidata, ele prevê como o ambiente mudará para que um agente possa testar movimentos por meio de simulação antes de planejar. O eixo de decisão mais claro é a previsão condicionada por ação, não a fluência em conversas.
Ao contrário de sistemas que apenas geram texto ou aparência, pilhas orientadas a modelos de mundo conectam previsões a ciclos de planejamento, controle ou treinamento por simulação. Abordagens comuns incluem RL baseado em modelo, por exemplo, Dreamer, simulação interativa generativa e previsão de representações no estilo JEPA; os objetivos diferem, portanto, nomes de marcas não são intercambiáveis.
O que é um modelo de linguagem de grande porte?
Um modelo de linguagem de grande porte (LLM) é um modelo generativo treinado em grandes corpora de texto, tendo a previsão do próximo token como objetivo central. Um LLM é eficaz em compreensão de linguagem, resumo, tradução, assistência para programação e orquestração de texto em várias etapas por meio de prompts e interfaces de ferramentas.
Um LLM pode descrever o mundo físico ou escrever etapas sobre “o que acontece se você empurrar um copo”, mas uma descrição não corresponde a dinâmicas de ambiente simuláveis e avaliáveis. Sem uma interface de ação e estado e verificações em ciclo fechado, tratar um LLM como controlador ou mecanismo de física é um erro de seleção, não um problema de “modelo pequeno demais”.
Como os alvos de previsão diferem?
A diferença central está no objeto de previsão: um modelo de mundo prevê o próximo estado ou as dinâmicas latentes após uma ação; um LLM prevê o próximo token e a estrutura textual. Ambos “preveem”, mas não compartilham o mesmo padrão de sucesso.
| Recurso |
Modelo de mundo |
LLM |
| Alvo de previsão |
Próximo estado/dinâmicas latentes, frequentemente condicionados por ação |
Próximo token/texto e seguimento de instruções |
| Relação com a ação |
A previsão condicionada por ação é o eixo de decisão |
Normalmente não modela um ciclo de controle físico |
| Forma de saída |
Estados, representações, trajetórias ou observações interativas |
Texto, código, argumentos de chamada de ferramentas |
| Critérios de sucesso |
Consequências verificáveis, capacidade de planejamento, erro rastreável |
Correção semântica, formato utilizável, citações verificáveis |
| Falha típica |
Desvio nas dinâmicas, física falsa |
Alucinação de linguagem, citações inventadas |
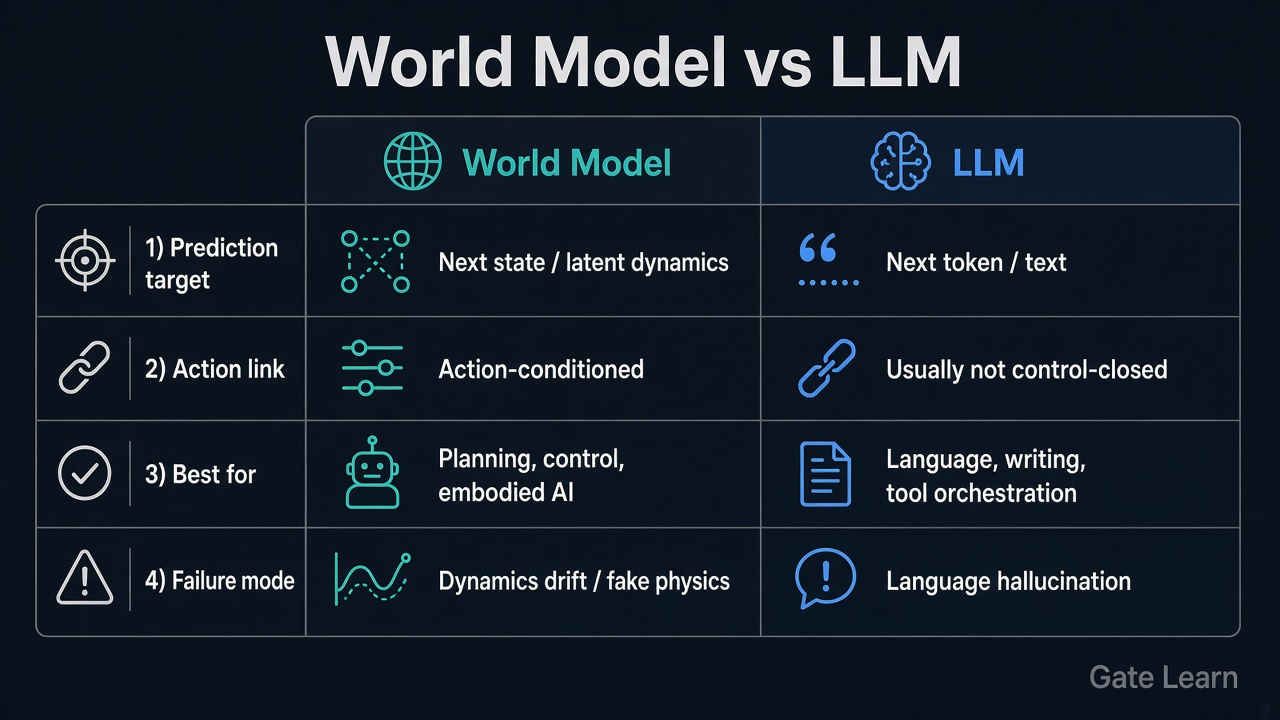
Figura 1. Contraste em quatro dimensões entre modelos de mundo e LLMs: alvo de previsão, relação com a ação, tarefas mais adequadas e modo de falha.
JEPA e LLMs são frequentemente confundidos. JEPA, por exemplo, I-JEPA da Meta AI, prevê representações futuras abstratas em um espaço de incorporações conjunto e é orientado a modelos de mundo; LLMs continuam sendo sistemas de modelagem de linguagem. Nomes semelhantes não implicam intercambiabilidade. Consulte o Glossário da NVIDIA: modelos de mundo e a discussão de LeCun sobre o caminho para a autonomia (A Path Towards Autonomous Machine Intelligence).
Como dados, saídas e avaliação diferem?
Os dados e a avaliação seguem o alvo de previsão: modelos de mundo se apoiam em trajetórias interativas, transições de estado, sinais de controle e, às vezes, vídeo; LLMs se apoiam em corpora, dados de instruções e, opcionalmente, registros de ferramentas. O consumo posterior determina as métricas de erro.
| Dimensão |
Modelo de mundo |
Modelo de linguagem de grande porte |
| Dados típicos |
Trajetórias de observação–ação–próxima observação/recompensa, às vezes incluindo vídeo |
Texto, diálogos, código, rastros de ferramentas |
| Saídas principais |
Próximo estado, dinâmicas latentes, trajetórias imaginadas |
Texto, respostas estruturadas, chamadas de função |
| Foco da avaliação |
Erro em várias etapas, sucesso da tarefa, robustez fora da distribuição |
Correção, fidelidade, formato e segurança |
| Problemas difíceis de detectar |
Física falsa com aparência suave; crescimento em horizontes longos |
Alucinações fluentes; citações que falham nas verificações |
Usar “escreva um parágrafo correto sobre física” para certificar um modelo de mundo, ou “o vídeo parece bom” para certificar um ciclo de controle de LLM, troca o eixo de avaliação. Primeiro, defina a saída verificável e, depois, escolha a família de modelos.
Quais tarefas são mais adequadas para modelos de mundo? Quais são mais adequadas para LLMs?
Comece identificando onde está o custo da falha, na física/controle ou na semântica/comunicação. Prefira modelos de mundo para o primeiro caso e LLMs para o segundo. Quando ambos forem necessários, use “é necessário combinar” em vez de forçar um único vencedor.
| Condição da tarefa |
Prefira modelo de mundo |
Prefira LLM |
Quando a combinação é necessária |
| Exige previsão explícita de ação → próximo estado |
Sim |
Não |
— |
| Exige uma interface em linguagem natural, geração de documentação/código |
Não |
Sim |
— |
| Planejamento incorporado; filtrar trajetórias com falha antes do contato, como na condução autônoma |
Sim |
Não, o LLM pode apenas explicar |
LLM para instruções; modelo de mundo para dinâmicas simuladas |
| Perguntas e respostas com recuperação de informações, redação, orquestração de ferramentas |
Não |
Sim |
— |
| Treinar uma política por simulação (MBRL) |
Sim |
Não |
O LLM pode redigir o texto da tarefa; as dinâmicas ainda exigem um modelo de mundo |
| Diálogo para objetivos com ciclo de controle executável |
Sozinho não é suficiente |
Sozinho não é suficiente |
É necessário combinar: o LLM analisa objetivos → o modelo de mundo/planejador executa |
“É necessário combinar” corresponde a uma estrutura comum: o LLM assume a intenção e a interface; o modelo de mundo, ou um simulador com dinâmicas aprendidas, assume a previsão de consequências e a filtragem de trajetórias. Remover qualquer um dos lados geralmente resulta no modo de falha do outro.
Quando você deve combinar os dois?
Combine-os quando uma tarefa incluir tanto um objetivo na camada de linguagem quanto consequências na camada do ambiente, sem discutir substituição. Uma cadeia típica funciona assim: o LLM transforma objetivos em subobjetivos ou restrições; o modelo de mundo simula ações candidatas; um planejador seleciona uma trajetória considerando custo e segurança; a execução retorna uma nova observação que atualiza o estado.
A combinação não consiste em “concatenar dois prompts”. As interfaces devem ser explícitas: quais objetivos estruturados o LLM gera, quais ações o modelo de mundo aceita e como o erro em várias etapas aciona o replanejamento ou uma alternativa conservadora. Sem esse contrato, os sistemas parecem “fala fluente, movimento inadequado” ou “trajetórias bonitas, instruções incompatíveis”.
O empilhamento rígido também não é adequado quando perguntas e respostas puramente documentais quase não exigem um modelo de mundo, ou quando o controle servo de baixo nível já conta com dinâmicas confiáveis e não precisa de um LLM geral. O valor da combinação vem da divisão de trabalho, não da quantidade de modelos.
Quais avaliações equivocadas e riscos surgem na escolha?
As interpretações equivocadas mais comuns são tratar “conseguir falar sobre física” como “conseguir executar física” e “quadros/trajetórias bonitos” como “dinâmicas passíveis de planejamento”. As famílias falham de formas distintas; misturar verificações de aceitação eleva o risco de implantação.
| Modo de falha |
Mais comum em |
Como aparece |
Risco de seleção |
Como identificar |
| Alucinação de linguagem |
LLM |
Fatos/citações fluentes, mas incorretos |
Única fonte de conhecimento ou “manual” de controle |
Exigir procedência, verificações por ferramentas e rejeitar alegações sem suporte |
| Desvio nas dinâmicas |
Modelo de mundo |
Etapas curtas funcionam; simulações longas se distorcem |
Confiança em ciclo aberto ao longo de horizontes extensos |
Representar o erro por horizonte; verificar o replanejamento |
| Física falsa |
Modelo de mundo |
Trajetórias suaves que violam contato/conservação |
Demonstrações visuais como aceitação da física |
Verificar penetração, energia e restrições de contato |
| Tratar um LLM como simulador |
Incompatibilidade de seleção |
A descrição em texto substitui transições de estado |
Tarefas incorporadas sem ciclo condicionado por ação |
Solicitar a interface de ação e o estado simulável |
| Tratar um modelo de mundo como mecanismo de chat |
Incompatibilidade de seleção |
Forçar a previsão de estado em perguntas e respostas de suporte |
Alto custo, experiência de linguagem fraca |
Perguntar se a qualidade do texto é a principal tarefa |
As verificações de risco devem estar vinculadas a gatilhos: se a tarefa é principalmente de correção semântica, priorize a governança de alucinações; se é principalmente de consequências de controle, priorize o desvio e a física falsa. Narrativas sobre capacidade não substituem verificações de aceitação.
Resumo
Modelos de mundo e modelos de linguagem de grande porte resolvem problemas de previsão diferentes: os primeiros visam consequências de ações e dinâmicas passíveis de planejamento; os últimos visam linguagem e orquestração de ferramentas. Para selecionar, defina qual lado assume o custo da falha e, depois, use a tabela de condições para uso individual ou combinação.
A previsão de representações no estilo JEPA é orientada a modelos de mundo e não é um LLM. No momento da aceitação, avalie a alucinação de linguagem separadamente do desvio nas dinâmicas/física falsa para que uma demonstração não esconda o outro modo de falha.
Perguntas frequentes
Qual é a diferença entre um modelo de mundo e um modelo de linguagem de grande porte?
Um modelo de mundo prevê principalmente o próximo estado ou as dinâmicas latentes após uma ação para planejamento e controle; um LLM prevê principalmente o próximo token para compreensão de linguagem, geração e orquestração de ferramentas. Ambos podem “gerar”, mas o sucesso significa consequências verificáveis, em comparação com semântica e formato utilizáveis.
Um modelo de mundo pode substituir um modelo de linguagem de grande porte?
Normalmente, não. Um modelo de mundo não fornece naturalmente uma interface de linguagem robusta ou orquestração de texto em larga escala; um LLM não fornece naturalmente dinâmicas simuláveis condicionadas por ação. Prefira LLMs para tarefas de linguagem e adicione componentes de modelo de mundo quando a tarefa exigir consequências no ambiente.
Quando você deve usar um modelo de mundo?
Use um sistema orientado a modelos de mundo quando a tarefa precisar prever o próximo estado a partir do estado e da ação e, em seguida, planejar, controlar ou testar movimentos por simulação. Casos típicos incluem planejamento incorporado, RL baseado em modelo e antecipação de consequências em horizontes curtos. Redação ou perguntas e respostas puramente documentais geralmente não são a aplicação principal.
Como JEPA e LLMs se relacionam?
JEPA (Joint Embedding Predictive Architecture) prevê representações futuras ou mascaradas no espaço de incorporações e pertence ao aprendizado de representações relacionado a modelos de mundo; LLMs se concentram na previsão do próximo token. Ambos podem fazer parte de uma pilha de agentes, mas os objetivos e as métricas diferem: JEPA não é “outro LLM”.
É possível usar os dois juntos?
Sim, e, para tarefas que combinam instruções em linguagem natural com execução em um ambiente, a combinação costuma ser necessária: o LLM analisa objetivos e restrições; o modelo de mundo ou planejador prevê consequências e filtra trajetórias. O ponto principal é uma interface clara e gatilhos de replanejamento, não encadear ambos em um único prompt.