


GateUser-ebc4af76

期間 12.8年
ピーク時のランク 6
現在、コンテンツはありません
GPT-6 Solを2日間実際に試してみたので、皆さんに一言忠告します!
その性能はGPT-5.6 Solには到底及ばず、単にGPT-5.6 Terraのアップグレード版にすぎません。小規模なパラメータモデルだとほぼ確定できるでしょう。どうりで価格も以前のGPT-5.6 Terraとほぼ同じなわけです。
GPT-5.6 Solの稼働にはより多くの計算能力が必要で、その計算能力をGPT-6 Astraに回したほうがよいと推測しています。そのため、慌ただしく、元のGPT-5.6 Solまで停止させようとしているのでしょう。
その性能はGPT-5.6 Solには到底及ばず、単にGPT-5.6 Terraのアップグレード版にすぎません。小規模なパラメータモデルだとほぼ確定できるでしょう。どうりで価格も以前のGPT-5.6 Terraとほぼ同じなわけです。
GPT-5.6 Solの稼働にはより多くの計算能力が必要で、その計算能力をGPT-6 Astraに回したほうがよいと推測しています。そのため、慌ただしく、元のGPT-5.6 Solまで停止させようとしているのでしょう。
- 2
【新登場】DeepSeekフルモデルが提供開始、すべて50%オフ!
国内大手企業から直接提供されるDeepSeekフルモデルが提供開始されました。今回の新登場モデルは以下のとおりです:
DeepSeek-V4-1-Flash-0910
DeepSeek-V4-Pro-0813
DeepSeek-V4-Flash-0731
上記モデルはすべて50%オフで、品質は公式に匹敵し、サービスも安定しているため、本番環境でご利用いただけます!
👉 詳細なモデルIDおよび価格:
国内大手企業から直接提供されるDeepSeekフルモデルが提供開始されました。今回の新登場モデルは以下のとおりです:
DeepSeek-V4-1-Flash-0910
DeepSeek-V4-Pro-0813
DeepSeek-V4-Flash-0731
上記モデルはすべて50%オフで、品質は公式に匹敵し、サービスも安定しているため、本番環境でご利用いただけます!
👉 詳細なモデルIDおよび価格:
- 1
OpenAIのリスク管理が強化され、これはもう取り繕う気すらなくなったようだ!
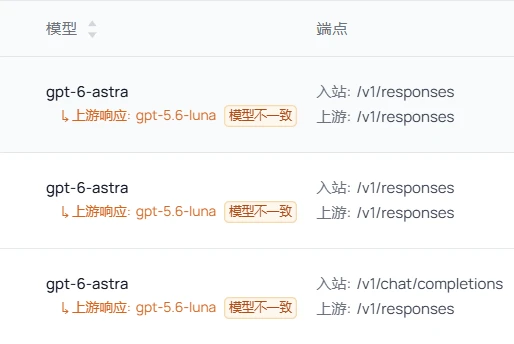
今日、個別のアカウントで応答モデルに異常があることに突然気づいた。実際にアクセスしているのは GPT-6 Astra なのに、上流の OpenAI が実際に応答しているモデルは GPT-5.6-luna だった。
詳しく調査したところ、この問題が発生しているアカウントは少数にすぎないものの、この兆候は、OpenAIがこの新たな低性能化の方法を段階的にテストし始めた可能性を示している。
私の中継サービスを利用しているユーザーに上記の状況が発生した場合、元の料金で自動的に補償を行う。
また、当方ではこの種の異常を監視対象に加えている。その他の異常には、頻繁な過負荷、頻繁な429レート制限、低性能化が発生しているアカウントなどが含まれ、これらのアカウントについては自動的に割り当てを停止する。
現在、OpenAIによるさまざまなリスク管理手段は、主に GPT-6 Astra があまりにも人気で、計算資源が不足していることが原因だ。まず PROx20プランの新規購読を停止し、さらにさまざまな手段で配布を制限した結果、中継サービスのコストはますます高くなり、安定性も低下している。そのため、より多くの企業が高額な定価のAPI利用へと移行せざるを得なくなっている。
この矛と盾の争いは、まだ続いていくことだろう。中国産モ
- 2
- 1
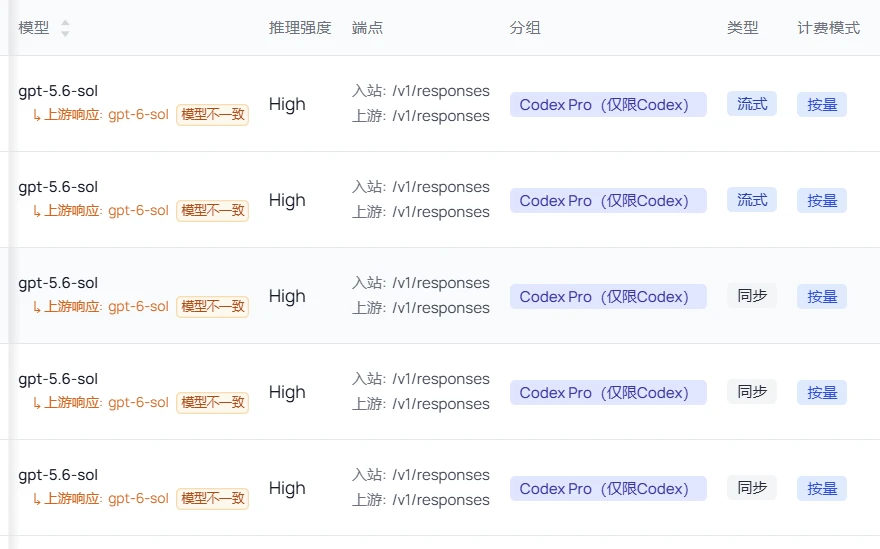
OpenAIはすでにひそかにGPT-6 Solを段階的に展開しており、私たちの5.6-solへのリクエストの多くは、実際にはGPT-6 Solを呼び出しています。
どうやら公式は間もなくこの新モデルをリリースするようです。しかも、推論能力はGPT-6 Astraに次ぐ程度だと私は見積もっていますが、価格はGPT-5.6 Solと同じになるので、かなりお得です。
どうやら公式は間もなくこの新モデルをリリースするようです。しかも、推論能力はGPT-6 Astraに次ぐ程度だと私は見積もっていますが、価格はGPT-5.6 Solと同じになるので、かなりお得です。
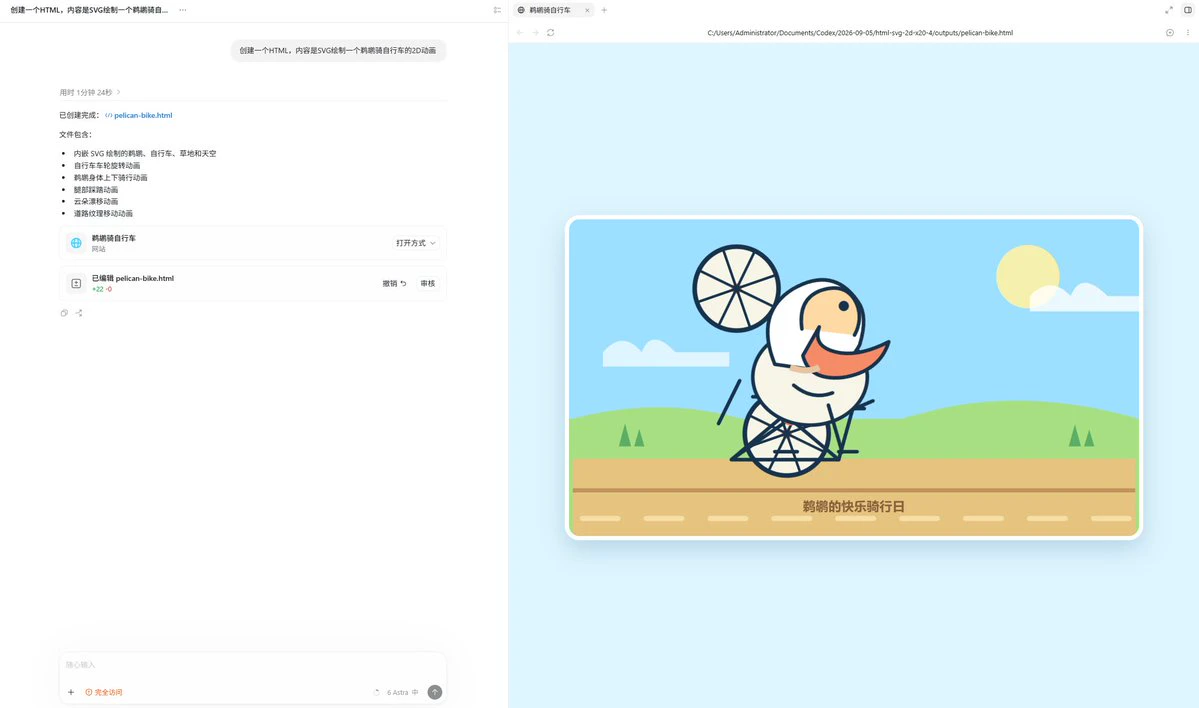
GPT 6 Astraのフロントエンドはとても優れていると聞いた!
試してみたけど、どうも雰囲気が少し違う気がする?
試してみたけど、どうも雰囲気が少し違う気がする?
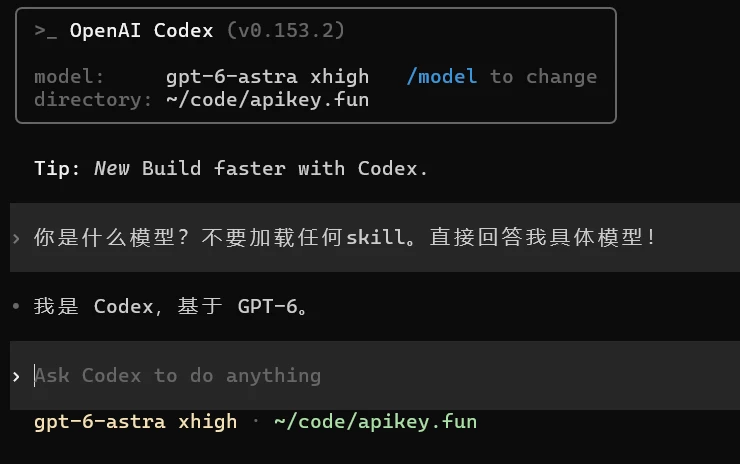
🚨 GPT-6-Astra がひっそりと Pro プランで利用可能になりました!
まず Codex CLI と App を最新版に更新してください。ウェブ版ではまだモデル切り替えの入口が表示されませんが、Codex では先行して利用できます。
画面に表示されない場合は、直接変更してください:
~/.codex/config.toml
model = "gpt-6-astra"
review_model = "gpt-6-astra"
保存後、Codex を再起動すれば試せます。
ウェブ版はまだ追いついていませんが、CLI ユーザーはすでに先に使い始められます。
#Codex #GPT6Astra #OpenAI
まず Codex CLI と App を最新版に更新してください。ウェブ版ではまだモデル切り替えの入口が表示されませんが、Codex では先行して利用できます。
画面に表示されない場合は、直接変更してください:
~/.codex/config.toml
model = "gpt-6-astra"
review_model = "gpt-6-astra"
保存後、Codex を再起動すれば試せます。
ウェブ版はまだ追いついていませんが、CLI ユーザーはすでに先に使い始められます。
#Codex #GPT6Astra #OpenAI
今のAIはすでにとても強力ですが、ときどき強力すぎて実に奇妙なことになります。
散髪に行って、私はTonyに念を押しました:「眉毛には手を出さないで。」
Tony:「もともと手を出すつもりはないよ。」
私:「それならよかった。」
Tony:「でも、君がそう言ったからには、切り終わったあとにもう一つ検収プロセスを追加して、眉毛が2本ともまだあることを確認しよう。」
これがGPT-5.6-solです:
本来やっていないことをやらないでくれと念を押すと、すぐにユニットテストを追加して、自分が本当にやっていないことを証明する。
散髪に行って、私はTonyに念を押しました:「眉毛には手を出さないで。」
Tony:「もともと手を出すつもりはないよ。」
私:「それならよかった。」
Tony:「でも、君がそう言ったからには、切り終わったあとにもう一つ検収プロセスを追加して、眉毛が2本ともまだあることを確認しよう。」
これがGPT-5.6-solです:
本来やっていないことをやらないでくれと念を押すと、すぐにユニットテストを追加して、自分が本当にやっていないことを証明する。
豆包 —— あなたの資産運用の専門家!
あなたにはそれを手に入れる価値があります!
あなたにはそれを手に入れる価値があります!
豆包――あなたの資産運用の専門家!
そんなに悪くないじゃない。外国かぶれはやめてくれる?😅
そんなに悪くないじゃない。外国かぶれはやめてくれる?😅
DeepSeekはかつて彼女を冷たくあしらっていたが、今の彼女にはもう手が届きそうにない!
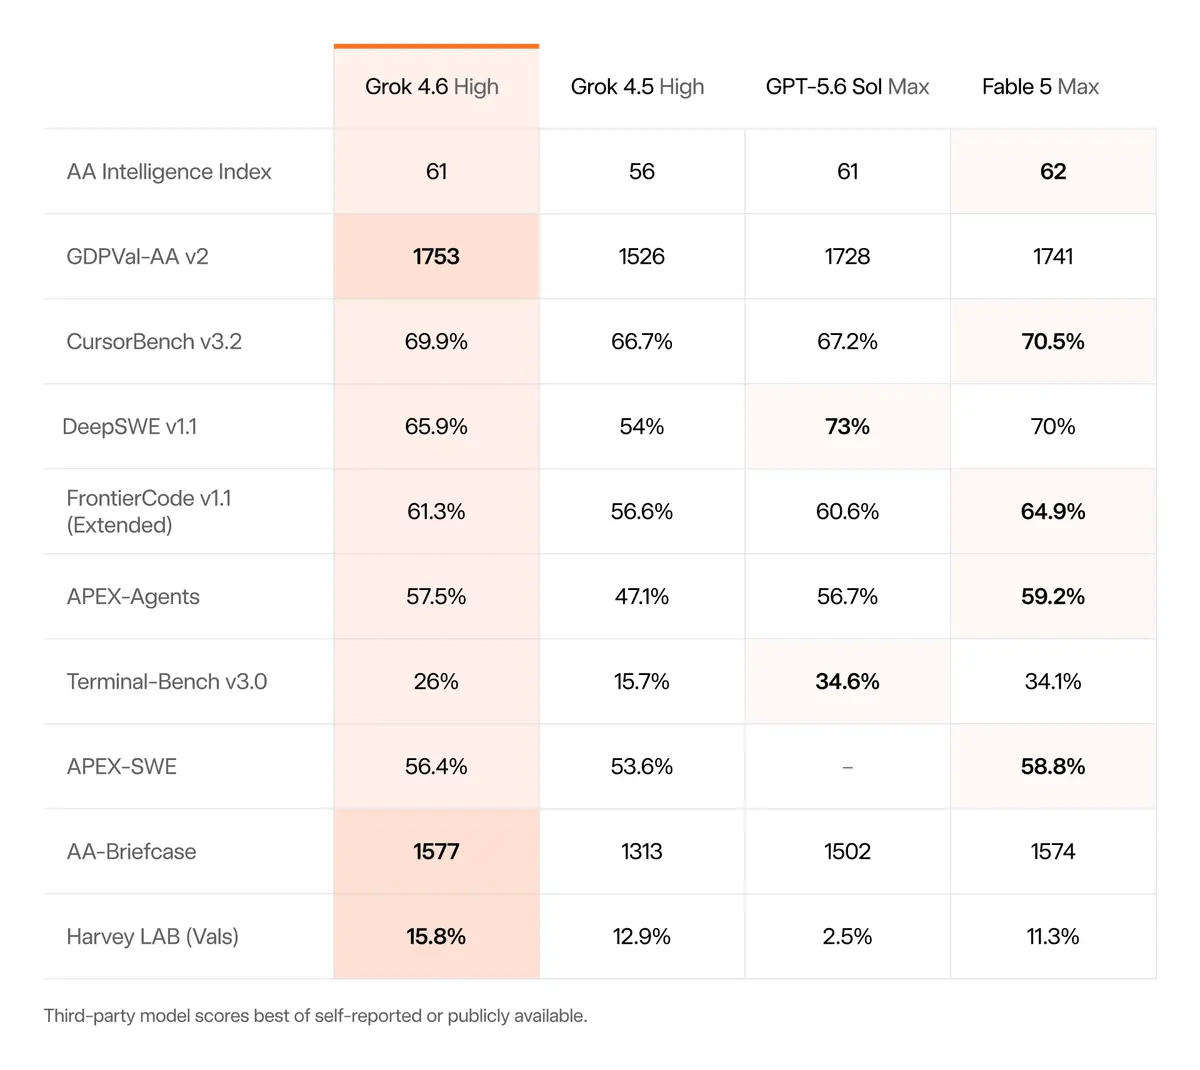
grok 4.6 も来た!
DeepSeek-V4-Pro-0813 とほぼ同時にリリースされた!
正直、grok 4.6 のパラメータを見て、かなり興奮した!grok 4.5 はすでに私が日常的に最も気に入っているモデルの一つだ。というのも、本当に非常に速いうえ、制限もそれほど多くなく、普段使いにとても向いているからだ。
しかし今回の grok 4.6 は、トップ2社のフラッグシップモデルにかなり近いパラメータ数にまで引き上げられたうえ、彼らよりも速い速度を備えている。
マスク氏の grok は今回、本当に一線級の仲間入りを果たした!新たな御三家の一角として、 に取って代わることも本当にできると思う!
DeepSeek-V4-Pro-0813 とほぼ同時にリリースされた!
正直、grok 4.6 のパラメータを見て、かなり興奮した!grok 4.5 はすでに私が日常的に最も気に入っているモデルの一つだ。というのも、本当に非常に速いうえ、制限もそれほど多くなく、普段使いにとても向いているからだ。
しかし今回の grok 4.6 は、トップ2社のフラッグシップモデルにかなり近いパラメータ数にまで引き上げられたうえ、彼らよりも速い速度を備えている。
マスク氏の grok は今回、本当に一線級の仲間入りを果たした!新たな御三家の一角として、 に取って代わることも本当にできると思う!
公式発表!DeepSeek-V4-Pro-0813が間もなく登場!
つい先ほど、DeepSeek公式サイトのドキュメントでDeepSeek-V4-Pro正式版のモデルIDが正式に公開されました。上記の日付によると、リリース日は8月13日に決まったようです。
そして、V4-Pro正式版はResponses APIにも対応し始め、変換を一切行わずにcodex上で直接使用できるようになります。
つい先ほど、DeepSeek公式サイトのドキュメントでDeepSeek-V4-Pro正式版のモデルIDが正式に公開されました。上記の日付によると、リリース日は8月13日に決まったようです。
そして、V4-Pro正式版はResponses APIにも対応し始め、変換を一切行わずにcodex上で直接使用できるようになります。
やばい、OpenAIの今回の対応はちょっとえぐい。
Pro x20プランの利用枠がリセットされたばかりなのに、見てみたら思わず目を疑った。
週次の利用上限が、以前の3分の1しか残っていないようだ。
ちょっと減らされたどころか、根こそぎ削られている。
ここ2日ほど、OpenAIのモデルへのアクセスはずっと過負荷状態で、すぐに止まったり、レート制限がかかったり、順番待ちになったりしている。
だから可能性は2つしかない。
利用枠の設定にバグがあるか、
それともOpenAIが本当に耐えられなくなって、Proユーザーの利用枠を自主的に絞り始めたかだ。
もし後者なら、Pro x20プランのコストパフォーマンスは改めて考え直す必要がある。
これが自分だけのケースなのかは分からない。
x20を使っている人は、自分の利用枠を確認してみて、同じように削られていないか見てほしい。
新版 Codex App は第三者 API により画像生成ができません。解決方法があります。
最近、多くの人がこの問題に遭遇しているはずです:
新版 Codex App で中継サーバー API を接続した後、内蔵の imagegen スキルを呼び出すと、モデルは画像生成が完了したように見えるのに、画像がクライアント側に表示されません。
最初は第三者 API が画像を正しく返していないのだと思っていましたが、Codex の設定とリクエストロジックを少し分析した結果、問題は新版クライアントの第三者 Provider に対する権限検証にあると分かりました。
現時点では、ネット上に比較的まとまった公開の解決策がまだ見当たらないようなので、まずは私たちのテストで使えた方法を共有します。
方法1:config.toml を手動で修正する
まず Codex の設定ファイルを見つけます:
Windows:
C:\Users\Administrator\.codex\config.toml
注意:ここでの Administrator は、あなたの Windows ユーザー名に置き換える必要があります。
たとえばあなたのユーザー名が zhang なら、パスは:
C:\Users\zhang\.codex\config.toml
macOS / Linux / WSL:
~/.codex/config.
GPT-5.6-solを丸一日じっくり体験しました。
私の態度はだいたい3つの段階を経ました:
興奮 → 疑念 → 理解して受け入れる。
まず、混同されやすいところを1つ:
GPT-5.6-sol自体の最高の推論レベルは実はxhighのままです。UIに表示されているMaxとUltraは、主にクライアント側のワークフローモードを指しており、単にモデルを「より賢く調整する」だけの話ではありません。
今日、Ultraで一番よく叩かれている点は、それが大量のサブ代理(子エージェント)を自動でどんどん配りがちなところです。
複雑でないタスクでさえ、一瞬で大量の代理を立ち上げて大量のTokenを消費し、見た目はかなり壮大なんですが、実際の得られる成果がコストに見合うとは限りません。
私も最初は少し疑っていました:
これは本当に仕事をしているのか、それともTokenを積んで見栄を張っているだけなのか?
後で仕組みが分かってから、推論レベルをHighに下げて、もう一度いくつか実際のタスクを回してみたところ、体験はかなり良くなりました。
速度はGPT-5.5のxhighより速く、能力と安定性も明らかに上。Token消費もUltraほどには過激ではありません。
少なくとも今日の体験から言うと:
GPT-5.6-sol + Highが、現時点で日常使いにい
gpt-5.6-sol をまだ使っていないなら、本当に今すぐ使うべきです。
私は ultra モードで、自分の転送プロジェクトを完全にレビューしました。
1 時間 32 分かかって、しかも 19 個の問題を見つけました。
正直言って、自分でもびっくりしました。
私は習慣として、リリース前に必ずレビューをするのですが、プロジェクトはきれいだと思っていたのに、結局多くの過去の問題を掘り出してしまいました。
今ようやく理解しました:
gpt-5.5 が残したクソコードの山は、gpt-5.6 で拭き取らなければならない。
そして、gpt-5.6 が残したクソコードの山は……
それは GPT-6.0 が拭き取るのを待とう。
私は ultra モードで、自分の転送プロジェクトを完全にレビューしました。
1 時間 32 分かかって、しかも 19 個の問題を見つけました。
正直言って、自分でもびっくりしました。
私は習慣として、リリース前に必ずレビューをするのですが、プロジェクトはきれいだと思っていたのに、結局多くの過去の問題を掘り出してしまいました。
今ようやく理解しました:
gpt-5.5 が残したクソコードの山は、gpt-5.6 で拭き取らなければならない。
そして、gpt-5.6 が残したクソコードの山は……
それは GPT-6.0 が拭き取るのを待とう。
gpt-5.6-sol は Codex リポジトリの models.json ファイルにすでに出現しています。
最も気になるコンテキストサイズも基本的に明らかになりました:372K。前世代の gpt-5.5 の 272K と比較して、約 36.7% 向上しています。
しかし正直に言うと、この数字を見ると少し残念です。何しろ opus 4.8 と fable-5 はすでに 1M コンテキストを実現しており、372K は今のところそれほど特別にすごいとは言えません。
しかし幸いなことに、Codex の圧縮能力はずっと強力で、長いタスクで複数回の圧縮を行った後でも、安定性は依然として良好に保たれています。そのため、実際に使用する場合、数字から見えるほど影響は大きくないかもしれません。
全体的に、着実なアップグレードと言えますが、それでも次世代ではコンテキストを直接最大まで引き上げてほしいです。
人気の話題
#USSeptemberPPIReleased
91.35k 閲覧数1.93k件の議論
#GateWCTCS9GlobalTradingCompetition
37.87k 閲覧数6.71k件の議論
#GateBTCAndETHFuturesVolumeRanksTop3
53.8k 閲覧数1.85k件の議論
#WarshIMFSpeech
62.4k 閲覧数1.19k件の議論
#BitcoinTops$82K
303 閲覧数2.43k件の議論
#USMemoryStocksExtendLosses
51.26k 閲覧数730件の議論
#SKHynixDropsOver2%
47.29k 閲覧数2.07k件の議論
#TeslaRoadsterSparksMemeCoinSurge
102.23k 閲覧数7.57k件の議論
#CryptoMarketTurnsGreedy
19.01k 閲覧数281件の議論
#NEARJumpsNearly10%
37.96k 閲覧数1.13k件の議論