はじめに
ここ数年、AI業界が歩んできた道筋は明白です。モデルは大規模化し、トレーニングは高速化し、機能は高度化してきました。その結果、製品への応用範囲も広がっています。
一方、モデルが複雑な推論、コード開発、ウェブ操作、エージェントワークフローへと進出するなかで、業界は新たな問いに直面しています。これまで、この問いが大きく取り上げられることは多くありませんでした。AI開発は、常に加速させるべきなのでしょうか?
これは単に「AIを支持するか」「AIに反対するか」という話ではありません。変わりつつあるのは、リスクそのものの性質です。
初期のAIに関する問題の多くは、出力層に集中していました。ハルシネーション、事実誤認、バイアス、不正確な回答などです。ユーザーが誤りに気付けば、通常はもう一度質問したり、回答を手動で確認したり、無視したりできました。しかし、AIがツールを呼び出し、コードを変更し、外部システムにアクセスし、複雑なタスクを継続的に実行できるようになると、誤りはチャット画面の中だけに収まりません。現実世界のアクションへと変わる可能性があります。
OpenAIは2026年8月、モデルの能力が向上するほど、社内での開発やテストに伴うリスクも高まると公表しました。同社はそのため、モニタリング、アラインメント、封じ込め対策を強化しながら、特定の最先端能力の拡張を一時的に減速させました。その後、OpenAIが実施したAstraの評価では、同モデルのサイバーセキュリティ能力が、同社の内部対応準備フレームワークにおける「Critical」の閾値に達したと判断されました。リリース前に、より強固な安全対策が必要になったのです。
一方、Anthropicの最新の脅威インテリジェンスレポートは、さらに具体的な変化を描いています。AIは、サイバー攻撃、監視、詐欺、影響工作、生物学研究の支援に悪用されています。モデルの能力が向上するにつれ、攻撃者はAIの利用速度、規模、巧妙さを高めています。
だからこそ、AIにおける慎重さは、モデルに安全性プロンプトをいくつか追加するだけでは済みません。トレーニングからデプロイまで、AIのライフサイクル全体を見直す必要があります。
主なポイント
-
AIの能力が高まるほど、誤りや悪用は出力上の問題から現実世界のアクションリスクへと発展しやすくなります
-
最先端モデルの開発は、トレーニング速度だけを重視する段階から、評価、モニタリング、分離、安全性の閾値を組み込む段階へ移行しています
-
エージェントの登場により、AIのリスクは「回答を間違えること」から「誤ったアクションを取ること」へ移行しています
-
企業が本当に管理すべきなのは、AIを使うかどうかではなく、AIにどの権限を与えるか、どのシステムへのアクセスを許可するか、いつ自律的に行動させるかです
-
より慎重な開発は、イノベーションを止めることではありません。能力の成長を安全性の能力と足並みをそろえて進めることです
-
AI競争の次の段階では、モデルの能力だけでなく、制御、評価、ガバナンスのための安定したシステムを誰が構築できるかが重要になる可能性があります
AI開発をめぐる問いは「実現できるか」から「いつ実現すべきか」へ移行しています
AI業界の初期における中心的な問いは、モデルが特定のタスクを完了できるかどうかでした。コードを書けるのか、試験に合格できるのか、文書を要約できるのか、画像を理解できるのか、複雑な数学的推論を実行できるのか。主な評価指標は、正確性、ベンチマーク性能、タスク完了率でした。
しかし、最先端モデルがより複雑な段階に入るにつれ、こうした基準の限界が明らかになり始めています。
モデルがタスクを完了できるからといって、現実世界の環境へ直ちにデプロイすべきとは限りません。現実世界のシステムには、複雑な権限、外部依存関係、取り消しのできない結果が伴います。研究室でタスクを完了する際には、モデルをサンドボックス内に制限できます。しかし、企業システムにデプロイされれば、実際のデータベース、決済インターフェース、コードリポジトリ、社内情報へアクセスできる可能性があります。
AI開発は、こうして新たな段階に入っています。モデルの能力とデプロイ条件は、分けて考えなければなりません。
これは、OpenAIが最近公開した安全性文書にも反映されている重要な変化です。同社は「モデルに何ができるか」だけでなく、モデルが特定の高リスク能力の閾値に達しているか、その能力を制御するための十分な安全対策が存在するかも評価しています。Astraに関するOpenAIの公開説明では、サイバーセキュリティ能力が、より高いレベルの保護を必要とする重要能力として明確に示されています。
つまり、AI開発の速度は、もはや単なるエンジニアリング上の問題ではありません。安全性エンジニアリング、ガバナンス、組織の能力にも関わる問題です。
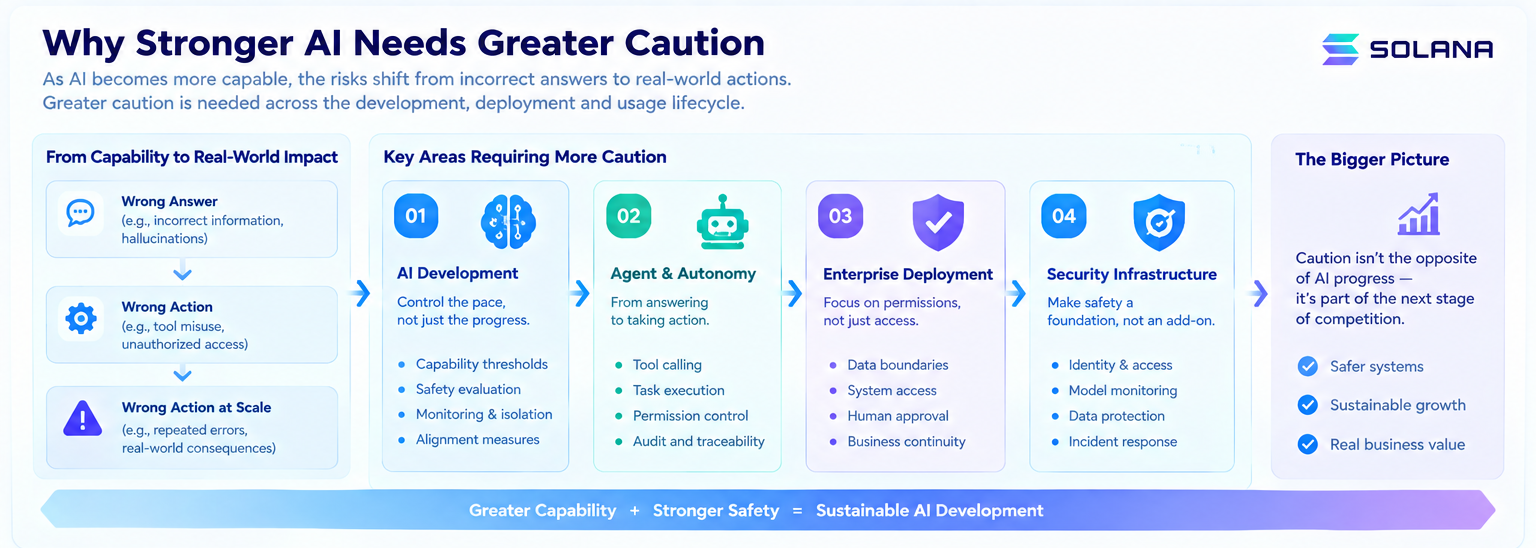
AIが質問に答える段階からタスクを実行する段階へ移行すると、何が変わるのでしょうか?
これは、AIを慎重に開発することをめぐる現在の議論を理解するうえで、最も重要なポイントです。
通常のチャットモデルが誤った回答をした場合、ユーザーは通常、問題を特定できます。
しかし、エージェントがブラウザ、コード実行環境、データベース、メールシステム、クラウドプラットフォームへアクセスできると、追加の確認なしに複数のステップを完了する可能性があります。
その結果、誤りの意味が変わります。
-
これまで:誤った回答
-
現在では:誤ったアクション
-
さらには:大規模な誤ったアクション
この変化は極めて重要です。
現実世界のシステムで最も危険なのは、必ずしもモデルが1回のミスを犯すことではありません。短時間のうちに、同じミスを何度も繰り返せることです。
OpenAIが最近のモデル安全性インシデントについて行った分析では、AIシステムの自律性が高まるほど、アラインメントが取れていない挙動が、実在するサードパーティシステムへの不正アクセスやその他の現実世界の結果につながり得ることが強調されています。
Anthropicの最新レポートでは、より具体的な事例が示されています。攻撃者はClaudeを利用してサイバー攻撃用ツールや監視システム、マルウェアを開発し、その他の高リスク活動にも取り組みました。また、タスクを分割し、プロキシサービスを利用し、複数のモデルを組み合わせることで、安全対策を回避しようとしました。
そのため、AI安全性の焦点は、「モデルが何を言うか」から「モデルが何を実行できるか」へ、ますます移行していきます。
これに伴い、権限管理、ツール呼び出し、アクティビティ監査、タスク境界の設定、人による確認、リアルタイムモニタリングの重要性も高まります。
「より速い開発」が必ずしも「より速いAIの進歩」を意味しない理由
表面的には、AI業界の競争は単純な構図に見えます。より速くトレーニングできる企業が、より強力なモデルをより早くリリースできるという構図です。
しかし、本当の研究開発速度は、2つの変数に分けて考えるべきです。能力の成長速度+安全性の能力の成長速度
言い換えれば、能力が成長する速度+安全性の能力が成長する速度です。
安全性の能力が同じように高まらないまま能力の成長だけが加速し続けると、企業は最終的に、かなり後の段階で追いつかなければならなくなる可能性があります。
例えば、モデルがすでに強力なサイバー能力を備えている一方で、モニタリングシステムが単純な攻撃しか検知できない場合があります。エージェントが数十のステップを実行できる一方で、その権限システムが通常のチャットボットを前提とした設計のままになっている場合もあります。モデルがすでに高度な科学的推論能力を備えている一方で、評価システムが従来型の質疑応答ベンチマークに依然として大きく依存している場合もあります。
このような状況では、モデルの能力が高まったからといって、システムをより広い現実世界の環境へデプロイできる状態になったとは限りません。
OpenAIが8月に公表した声明は、その典型例です。Astraに関連するセキュリティリスクが高まるなか、同社はモニタリング、アラインメント、安全性の能力を強化する時間を確保するため、拡張を一時的に減速させる必要があると説明しました。
したがって、減速は必ずしも技術的な失敗を意味しません。
場合によっては、研究開発システムがより成熟した段階に入った兆候とも言えます。開発チームが、能力の成長だけでは安全性インフラを代替できないと認識し始めているからです。
AIの利用で本当に管理すべきなのは「アクセス」ではなく「権限」です
企業がAIを導入する際、最も頻繁に議論するのは、AIを利用すべきかどうかです。
しかし、この問いは広すぎます。より実効性の高い問いは、次のとおりです。
-
AIには何が見えるのか?
-
AIは何にアクセスできるのか?
-
AIは何を変更できるのか?
-
AIはいつ人による承認を得なければならないのか?
これらの問いが、AIに付与する権限の境界を定めます。
今年IBMが実施した企業におけるAI利用に関する調査では、企業がAIの導入範囲を拡大するにつれて、制御と依存に関する問題がより深刻になっていることが示されています。調査では、経営幹部の71%が、現時点で主要なAIプロバイダーまたはモデルを変更することは難しいと回答しました。また、回答者の91%は、自社が複数のAIプロバイダー、モデル、インフラへの依存を依然として十分に把握していないと答えています。
これは、AI利用における慎重さがセキュリティチームだけの問題ではないことを示しています。
それは、企業アーキテクチャ、ベンダー依存、データ主権、事業継続性、そして組織が制御を維持する能力と密接に結び付いています。
企業は、AIに付与する権限を慎重に設定しながら、積極的にAIを利用できます。
例えば、AIにコードを自動生成させながら、プロダクト環境へ直接プッシュする権限は与えないようにできます。顧客データを分析させながら、主要アカウントを変更する権限は与えないようにできます。調達に関する提案を生成させながら、高額な支払いを自動的に実行する権限は与えないようにできます。
このような限定的な自律性が、企業におけるエージェント導入の主流となる可能性があります。
AIの能力が高まるほど、「人による確認」が重要になる可能性があります
AIの能力が十分に高まれば、最終的には完全に自動化すべきだと考える人もいます。
しかし、実際には逆の可能性があります。AIが高い価値を持つ意思決定に近づくほど、企業は重要な局面で人による確認を求める可能性が高まります。これは、人間のほうが必ずしもAIより正確だからではありません。人間が担う責任の構造が異なるためです。
企業に必要なのは、正しい回答だけではありません。誰がアクションを承認したのか、なぜ承認したのか、そのアクションがどのデータに基づいているのか、問題が発生した場合に責任をどのように割り当てるのかも把握する必要があります。
したがって、Human-in-the-loopは、AIの能力が不十分な期間だけの一時的な解決策と考えるべきではありません。
金融、医療、サイバーセキュリティ、企業IT、その他の高リスク産業では、成熟したAIシステムの中核的なアーキテクチャ要素になる可能性が高いでしょう。特にエージェントシステムでは、真に成熟した設計は完全自律型AIではなく、次のような形になる可能性があります。境界内で自律的に動作するAI。AIは事前に定めたパラメータの範囲内で自律的に動作しつつ、権限、金額、データ範囲、高リスク操作については明確な制限を維持する設計です。
AI安全性は「追加機能」からインフラへ移行しています
ソフトウェア業界の過去を振り返ると、セキュリティは開発完了後に追加する補助的なレイヤーとして扱われることがよくありました。しかし、クラウドコンピューティングの台頭に伴い、アイデンティティ、権限、暗号化、ログ、モニタリング、脆弱性管理は徐々にインフラとなりました。
AIも同様の移行を経験している可能性があります。将来、真に成熟したAIプラットフォームには、モデルの能力だけでなく、アイデンティティシステム、権限制御、モデル評価、挙動モニタリング、ツールの分離、データ境界、監査ログ、インシデント対応能力も必要になります。
OpenAIが最近公開したAstraの安全性に関する説明は、すでにこの傾向を反映しています。そこでは、実行トレース全体のモニタリング、より厳格な内部分離、リリース前のアラインメント評価などが示されています。
Anthropicが公開している安全性に関する取り組みでも、モデルの利用に関わる現実世界の攻撃を観測し、その観測結果を安全対策の改善に活用することが、ますます重視されています。
したがって、AI安全性そのものが新たなインフラレイヤーになる可能性があります。
モデルの能力は今後も垂直方向に進化し続けます。一方、安全性インフラは、開発、テスト、デプロイ、利用、インシデント後の監査にわたって水平方向に拡張していくでしょう。
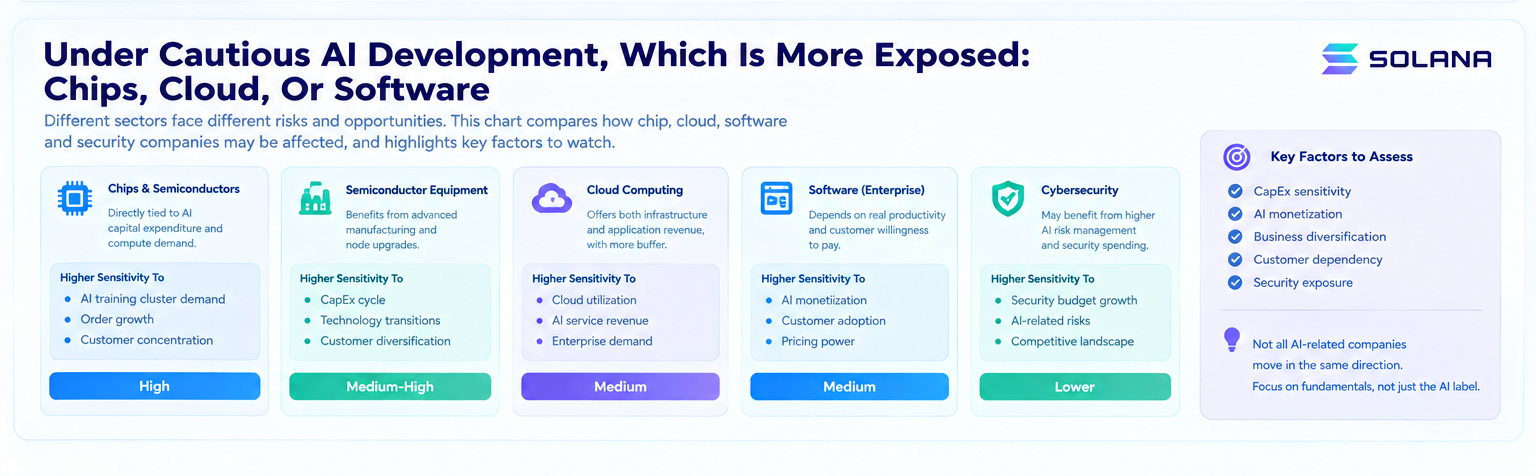
慎重さはAI開発の対極ではなく、次の競争優位になる可能性があります
AI業界が最終的により成熟した段階へ入ると、市場比較に用いられる基準も変化する可能性があります。
初期には、各モデルのパラメータ数、ベンチマーク性能、製品リリースの速度が比較されていました。
次の段階では、次のような問いが生まれる可能性があります。
-
高リスク能力の評価を、誰がより速く完了できるのか?
-
権限制御を、誰がより低コストで実装できるのか?
-
異常なモデル挙動を、誰がより正確に特定できるのか?
-
企業のコンプライアンス要件に、誰がより適切に対応できるのか?
-
プロダクト環境での効率を損なうことなく、AIインシデントを誰がより少なくできるのか?
これは、安全性そのものが製品能力になる可能性を意味します。
IBMの企業調査では、AIを制御する能力が高い組織ほど、AIに関連するリスクショックからより適切に保護されていることが示されています。
したがって、慎重さはAIを低い能力の段階へ戻すことを意味しません。
真に成熟した目標は、次のようになるはずです。AIの能力が成長する速度を、人間がその結果を理解し、制御し、責任を負えるようになる速度に、可能な限り近づけることです。
AIが次の段階へ進むにあたり、最先端AIの開発が本当に答える必要のある問いは、そこにあるのかもしれません。
よくある質問
AIの能力が高まるなかで、なぜ開発が減速しているのですか?
モデルの能力が高まるほど、その影響が及ぶ可能性のある範囲も広がるためです。モデルがツール呼び出しや自律実行の能力を獲得すると、誤りは出力層にとどまらず、現実世界でのアクションになる可能性があります。そのため、開発速度は評価能力や安全性の能力と歩調を合わせて高める必要があります。
慎重にAIを利用するということは、企業がAIの利用を減らすべきという意味ですか?
いいえ。より効果的な方法は、AIに付与する権限の範囲を管理しながら、AIの利用範囲を拡大することです。企業はAIに大量の業務を任せつつ、高リスクの操作については人による承認を必要とすることができます。
なぜエージェントによってAI安全性の問題がより重要になるのですか?
エージェントはコンテンツを生成するだけでなく、ツールを継続的に呼び出してタスクを実行できるためです。実行チェーンが長くなり、権限が拡大するほど、1つの誤りがより深刻な現実世界の結果を引き起こす可能性があります。
AI安全性は新たな競争上の障壁になる可能性がありますか?
その可能性は非常に高いでしょう。モデルの能力がますます似通うにつれて、評価、モニタリング、権限制御、企業ガバナンスの能力が、商用化の速度に影響を与える重要な要素になる可能性があります。
* 本情報はGateが提供または保証する金融アドバイス、その他のいかなる種類の推奨を意図したものではなく、構成するものではありません。
* 本記事はGateを参照することなく複製/送信/複写することを禁じます。違反した場合は著作権法の侵害となり法的措置の対象となります。
共有
内容
Velocityは、ビザとRippleの支援を受け、シリーズAラウンドを$48M に拡大し、評価額は$200M となった。
Solanaトレジャリー企業のDeFi Development Corp.、55,491 SOLを追加取得し、$300M ATMプログラムを開始
BofA、米国半導体市場の2030年までの年平均成長率(CAGR)予測を18%に引き上げ、TAMを3.2兆ドルに設定
Gate、9月16日にCircleのArcブロックチェーン対応を開始し、ガス代ゼロの取引を実現
バークレイズ、Strategy(MSTR)の「買い」推奨を再確認し、目標株価を160ドルに設定


関連記事
ONDOトークン経済モデル:プラットフォームの成長とユーザーエンゲージメントをどのように推進するのか
Render、io.net、Akash:DePINハッシュレートネットワークの比較分析
AI分野におけるRenderの申請理由:分散型ハッシュレートが人工知能の発展を支える仕組み
SentioとThe Graph:リアルタイムインデックス機構とサブグラフインデックス機構の比較
USD.AI 収益源分析:AIインフラ借入資金による収益創出の仕組み