AIの能力の境界を整理したい初心者にとって、ワールドモデルが答えるのは、システムが流暢な回答を書けるかどうかではなく、行動の結果を予測できるかどうかです。以下では、定義、予測ループ、3つの技術的アプローチ、ワールドモデルとLLMのタスク選択、動画生成との違い、ユースケース、評価上の境界を解説します。関連する概念については、Gate Learnのスーパーインテリジェンス(ASI)およびプライベートAIの解説もご覧ください。
要点
- 中核となる能力は、行動条件付き予測です。状態と行動を入力として、計画や制御に必要な次の状態(または次の表現)を出力します。
- 一般的な3つのアプローチは、モデルベース強化学習(MBRL)/イマジネーショントレーニング、生成型インタラクティブシミュレーション、JEPAスタイルの予測表現です。
- 大規模言語モデルは次トークン予測に、動画生成モデルは見た目の連続性の維持に優れていますが、いずれも自動的に計画可能なワールドモデルになるわけではありません。
- 評価では、偽の物理法則、長期予測でのドリフト、分布外データでの失敗、厳格な評価指標、手書きシミュレーターとの境界を確認する必要があります。
ワールドモデルとは何か、どのような問題を解決するのか?
ワールドモデルは、実務的な問いに答えるものです。エージェントが行動する前に、次に何が起こるかを信頼性高く推定できるでしょうか。この能力がなければ、学習は現実世界での試行錯誤に依存します。これは多くの場合、高コストで時間がかかり、安全性にも問題があります。また、オフラインでの計画も困難になります。
ロボティクス、自動運転、ゲームエージェント、シミュレーション学習、特に仮想環境または物理環境で動作する身体性エージェントでは、フィードバックの取得にコストやリスクが伴います。例えば、不適切な運転ポリシーは、学習する前に実際の事故を引き起こす可能性があります。ワールドモデルは、「行動を試す」ことを学習済みのダイナミクス内に移します。潜在空間または観測空間で将来をロールアウトし、その後、より強力なポリシーを現実世界に適用します。この目的は、主に知識を言い換える会話システムとは異なり、インタラクティブな環境における因果的な先見性に近いものです。
NVIDIAのワールドモデルに関する用語集では、ワールドモデルを、AIが物理世界の変化を理解・予測するのに役立つ内部表現として説明しています。Yann LeCunのA Path Towards Autonomous Machine Intelligenceでは、予測型ワールドモデルを、より自律的な知能に向けた道筋として位置付けています。また、David Haによる2018年の「World Models」の研究は、現代の学習ベースのアプローチを定義する一助となりました。エージェントは通常、部分的な観測しか得られないため、完全な状態を直接利用することはできません。これらの見方に共通するのは、予測が意思決定を支援するために存在するという点です。
ワールドモデルはどのように機能するのか?状態、行動、予測ループ
ワールドモデル指向のシステムを見極める最も安定した基準は、行動条件付き予測です。入力にエージェントの行動または制御信号が明示的に含まれているか、また出力がその行動を条件とした次の状態または次の表現になっているかを確認します。
このループは通常、3つのステップに要約できます。観測を状態にエンコードし、候補となる行動を条件として与え、その行動後の次の状態を予測します。その後、環境は行動に応じて変化し、新しい観測を返します。必要に応じて、その予測を新たな開始点としてさらに先へロールアウトします。ポリシーまたはプランナーは、報酬、リスク、制約に基づいて想定軌跡を比較してから実行します。新しい観測によって、エンコードが再開されます。
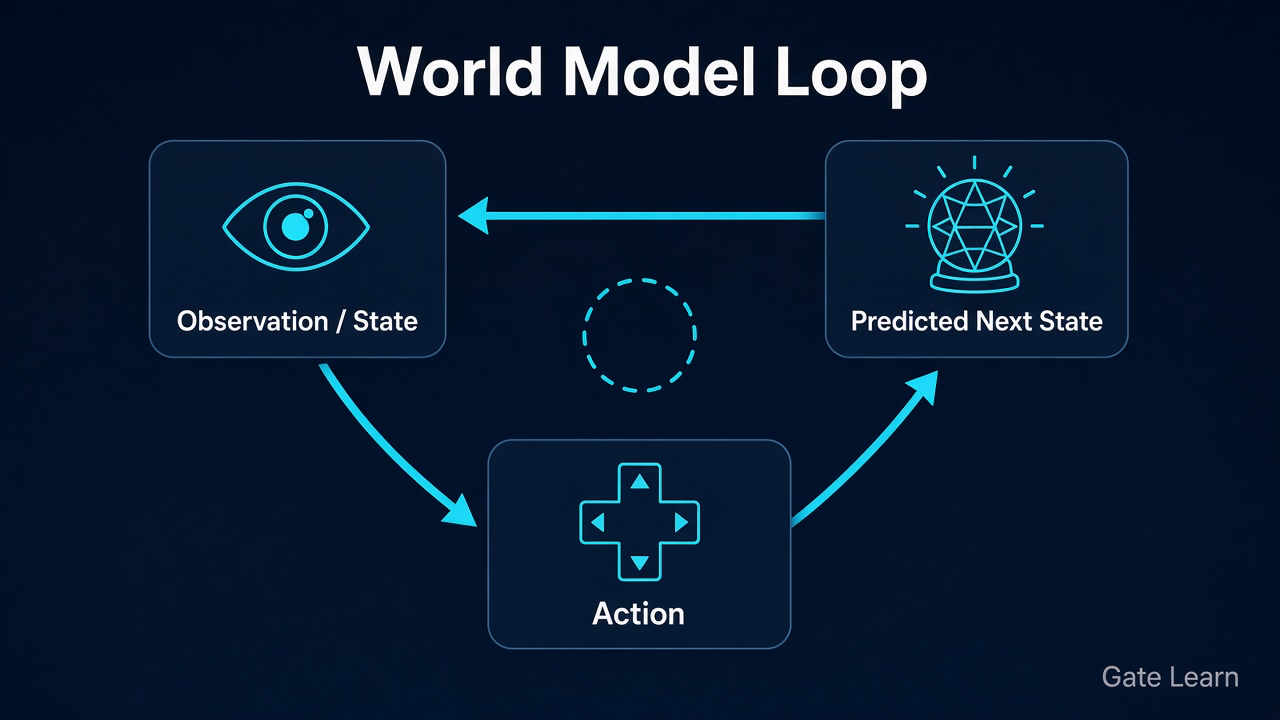
図1. ワールドモデルのループ:観測/状態と行動から予測された次の状態が得られ、それが次のサイクルに渡されます。
多くの実用システムでは、生のピクセルで長期予測を行う代わりに、潜在ダイナミクスを学習します。高次元の視覚データをコンパクトな状態に圧縮し、その空間で将来をロールアウトします。潜在空間でのロールアウトは視覚ノイズを減らし、イマジネーショントレーニングのコストを抑えます。ただし、潜在状態が実際の物理法則に忠実かどうかは、下流タスクと分布外データの検証を通じて確認する必要があります。特に、物理環境は部分的にしか観測できず、フィードバックを通じて推論する必要があるためです。
ワールドモデルの主な技術的アプローチとは?
「ワールドモデル」は単一のアルゴリズム名ではなく、複数の技術ファミリーにまたがる広い概念です。選択は、制御可能なポリシー、インタラクティブなピクセルシミュレーション、転用可能な抽象表現のいずれを目的とするかから始まります。
| アプローチ | 中核となる考え方 | 最適な用途 | 主なコスト |
|---|---|---|---|
| MBRL / イマジネーショントレーニング | ダイナミクスを学習し、モデルのロールアウトでポリシーを訓練する(Dreamer) | 制御、ゲーム、サンプル効率の高い強化学習 | モデル誤差がポリシーに悪影響を及ぼす。ドリフト |
| 生成型インタラクティブシミュレーション | 次のフレーム/観測を生成するインタラクティブ環境を学習する | データ拡張、インタラクティブな動画世界 | 見た目は物理法則と同義ではない。評価コストが高い |
| JEPA予測表現 | 表現空間内で将来またはマスクされた埋め込みを予測する(I-JEPA) | 表現学習、計画のための抽象的な予測 | ピクセル出力なし。制御スタックが必要 |
あるアプローチでは、将来のフレームを予測する動画モデルを中心に据える場合があります。一方、完全な視覚再構成ではなく、計画に利用できる潜在ダイナミクスを対象とするアプローチもあります。
この3つのアプローチは共存できます。Dreamerスタイルの手法は、イマジネーション内でポリシーを訓練することを重視します。生成型動画ワールドモデルは、インタラクティブな見た目のシミュレーションを重視します。Meta AIのI-JEPAは、すべてのピクセルを再構成するのではなく、共同埋め込み空間で予測を行う例です。また、入力・出力ペア、制御ロールアウト、予測埋め込みのどれから学習するかによって、システムごとに異なる学習手法が選択されます。名称を議論する前に、まずタスクを整合させる必要があります。
ワールドモデルはLLMや動画生成とどのように異なるのか?
いずれも「予測」を行いますが、生成AIの中では予測対象が異なり、行動条件付けにも違いがあります。LLMは次のトークンを予測し、動画生成モデルは次のフレームの見た目を予測し、ワールドモデル指向のシステムは行動後に状態がどのように変化するかを予測します。
| 観点 | ワールドモデル | 大規模言語モデル(LLM) | 動画生成 |
|---|---|---|---|
| 中核となる予測対象 | 次の状態/潜在ダイナミクス(多くの場合、行動条件付き) | 次のトークン/テキスト構造 | 次のフレームまたはクリップの見た目 |
| 行動との関係 | 行動条件付き予測が意思決定の軸 | 通常、物理的な制御ループはない | テキスト/最初のフレームを条件にできるが、実行可能とは限らない |
| 代表的な用途 | 計画、制御、身体性AI | 言語、文章作成、ツールオーケストレーション | コンテンツ生成、プレビュー、インタラクティブシミュレーション |
| よくある混同 | 会話能力=ワールドモデル | 物理法則について書ける=物理能力 | 写実的なフレーム=正確なダイナミクス |
そのため、Soraのような動画生成モデルは、高い視覚的忠実度と、見かけ上の空間的一貫性を持つ自然なフレームを表示でき、「動画ワールドモデル」と呼ばれることもあります。しかし、こうした特性だけで物理世界を理解しているとは証明できません。安定した行動インターフェース、検証可能な状態遷移、計画ループがなければ、正確な分類は生成型動画です。より強力なシステムは、単に起こりそうな視点を受動的に描画するだけでなく、行動列を評価して計画や意思決定を支援することもできます。LLMは「カップを少し押したらどうなるか」を説明できますが、それによってロールアウト可能で評価可能な環境ダイナミクスが生まれるわけではありません。
ワールドモデルはどこで一般的に使用されているのか?
身体性AIは利用頻度の高い領域です。ロボットアームや移動ロボットには、物理世界のレイアウト、移動、変化を推論する空間知能に加え、物体に触れる前に接触や移動の結果を予測する能力が必要です。多くの相互作用は、動き始めると元に戻すことが難しいためです。行動条件付き予測により、システムは実際の衝突コストを負う前に、シミュレーションまたは潜在空間で失敗する軌跡を除外できます。デモンストレーションは行動の初期化に役立ちますが、相互作用ベースの学習に取って代わるものではありません。
ゲームとモデルベース強化学習も、もう1つの中核領域です。Dreamerスタイルの手法は、想定された軌跡上でポリシーを改善するため、より少ない実際の相互作用で実用的な制御を実現できます。同様の考え方は、手書きシミュレーターが不完全である一方、観測履歴が豊富な産業制御ログにも適用できます。これは、モデルがその履歴からシステムダイナミクスを捉えようとするためです。
自動運転、倉庫スケジューリング、マルチエージェントシミュレーションにも、ワールドモデルのコンポーネントが組み込まれています。ただし、計画スタック全体を置き換えるものではなく、短期的な結果を扱うレイヤーとして利用されます。実環境への導入前には、仮想テストや選別済みの動画データを用いて、さまざまなシナリオでこれらのコンポーネントを訓練・評価することが一般的です。「行動する前に考える」必要がある制御システムには、ワールドモデルモジュールが搭載される可能性があります。
ワールドモデルを評価する際、どのような利点、リスク、限界が重要か?
利点は、サンプル効率と、より安全な試行錯誤です。モデル内で想定することで危険な探索を減らすことができ、行動条件付きの予測により、検査可能なダイナミクスに基づく計画が可能になります。一方、限界やリスクは、モデルが正しそうに見えても信頼できない場合に現れます。洗練された内部表現が、実運用に耐える行動と同じとは限りません。
| メカニズム | 観測される現象 | 見えにくい理由 | 確認すべき質問 |
|---|---|---|---|
| 偽の物理法則 | 保存則や接触条件に違反する滑らかな軌跡 | 視覚的な自然さを信頼してしまう | 主要な量は保存されるか?物体はすり抜けるか? |
| 長期予測でのドリフト | 短いロールアウトは問題ないが、長いものは崩壊する | デモは短いクリップを重視しがち | ステップ数に応じて誤差はどう増加するか?再計画はあるか? |
| 分布外データでの失敗 | 新しい物体、照明、行動範囲で破綻する | 分布内スコアは高く見える | OODプロトコルはあるか?失敗モードは公開されているか? |
| 厳格な評価 | 共通の「世界理解」スコアがない | タスク成功率に指標が吸収される | タスクスコア以外に予測誤差は報告されているか? |
| 手書きシミュレーターとの境界 | 学習モデルが検証済みエンジンとして扱われる | マーケティングでシミュレーターとワールドモデルが混同される | どの制約がハードコードされているか?どれが単なる適合にすぎないか? |
シミュレーションから現実への移転は、sim-to-realギャップにより困難です。適切なテストでは、単にもっともらしい映像ではなく、モデルが行動に応じた制御可能な結果を予測できるかを問うべきです。
この表は、主張を確認するためのチェックリストとして使用できます。まず行動条件付きインターフェースを確認し、次に長期的な証拠とOODの証拠を求め、最後に「見た目がよい」と「ダイナミクスが計画可能」を区別します。こうした証拠がなければ、「完全なワールドモデルを備えている」ではなく、「ワールドモデルのコンポーネントまたは研究目標を含む」と表現するほうが安全です。エージェントの能力には限りがあるため、評価はシーン全体の再現ではなく、目標に関連する状態に焦点を当てるべきです。
まとめ
ワールドモデルは、AIを「話せる/描ける」段階から、「行動の結果を予測できる」段階へと進めます。例えば、ロボットが誤った経路を取るとカップを倒すことを予測する、といった能力です。実用上の中核は、状態、行動、予測からなる閉ループであり、行動条件付き予測が最も明確な意思決定の軸となります。
MBRL/イマジネーショントレーニング、生成型インタラクティブシミュレーション、JEPA予測表現という3つのアプローチは、それぞれ異なる目的に対応しており、相互に置き換え可能ではありません。LLMや動画生成モデルと比較する際は、予測対象と行動インターフェースを確認してください。評価では、偽の物理法則、ドリフト、OODでの失敗、厳格な指標、シミュレーターとの境界を優先します。
FAQ
ワールドモデルとは何ですか?
ワールドモデルとは、現在の状態(または観測)と行動に応じて、環境がどのように変化する可能性があるかを表現する、学習済みの内部ダイナミクスモデルです。どの時点でも、世界はエージェントが直接観測できる内容よりも豊かです。そのため、モデルは、例えばロボットが左に曲がった後にどこに到達するかといった、計画に重要な変数を要約します。その目的は、テキストや動画の見た目を生成するだけではなく、イマジネーション内での計画と試行錯誤を支援することです。
ワールドモデルは大規模言語モデルとどのように異なりますか?
大規模言語モデルは主に次のトークンを予測し、言語や知識のオーケストレーションに優れています。一方、ワールドモデルは主に、制御と計画のために、行動後に状態がどのように変化するかを予測します。LLMは物理法則について議論できますが、ロールアウト可能で評価可能な環境ダイナミクスを提供するわけではありません。
ワールドモデルはどのように機能しますか?
典型的なループでは、観測を状態にエンコードし、候補となる行動を条件として与え、その行動後の次の状態を予測します。その後、潜在空間内でさらに先へロールアウトする場合があります。プランナーは想定されたロールアウトを比較し、行動を実行した後、新しい観測から状態を更新します。
Soraや動画生成はワールドモデルに該当しますか?
自動的に該当するわけではありません。システムが主に、見た目に一貫性のある動画を生成するだけで、安定した行動条件付きインターフェース、検証可能な状態遷移、計画での利用がなければ、動画生成モデルとして説明するほうが適切です。行動条件付き予測と計画可能なループが実証された場合にのみ、ワールドモデルに近づきます。
ワールドモデルは従来のシミュレーターとどのように異なりますか?
従来のシミュレーターは通常、手書きの物理法則や制約をエンコードします。一方、データ駆動型のワールドモデルは、多くの場合ニューラルネットワークによって学習されます。学習モデルはより柔軟で、センサーノイズにも近い可能性がありますが、偽の物理法則や長期予測でのドリフトも起こりやすく、検証済みの物理エンジンと同等であるとみなすべきではありません。
* 本情報はGateが提供または保証する金融アドバイス、その他のいかなる種類の推奨を意図したものではなく、構成するものではありません。
* 本記事はGateを参照することなく複製/送信/複写することを禁じます。違反した場合は著作権法の侵害となり法的措置の対象となります。
共有
内容


関連記事
Render、io.net、Akash:DePINハッシュレートネットワークの比較分析

AI分野におけるRenderの申請理由:分散型ハッシュレートが人工知能の発展を支える仕組み

USD.AI 収益源分析:AIインフラ借入資金による収益創出の仕組み

USD.AIトケノミクス:CHIPトークンの使用事例およびインセンティブメカニズムのデプス分析
Audiera GameFiデプス分析:Dance-to-EarnがAIとリズムゲームをどのように組み合わせているか