生成AIがモデル学習から大規模な商用アプリケーションへと拡大する中、AIコンピューティング市場における競争の焦点も変化しています。企業には、より強力なモデルを学習させるだけでなく、管理可能なコストでユーザーリクエストを継続的に処理し、AIエージェントを実行し、音声を生成し、リアルタイムのインタラクティブサービスを提供することが求められています。このような背景から、Groqに代表される専用推論アクセラレーションアーキテクチャへの注目が高まっています。本記事では、Groqの企業としての位置付け、LPU技術、GroqCloudのビジネスモデル、業界競争を取り上げ、AI推論インフラにおける同社の役割と、専用チップのアプローチが直面する技術的・商業的課題を分析します。
要点
- Groqは、AI推論に特化したコンピューティング技術企業です。中核技術には、LPUチップ、コンパイラ、関連する推論インフラが含まれます。
- AIの学習と推論では、求められるコンピューティング要件が異なります。リアルタイム推論では、特に最初のトークンが生成されるまでの時間、生成速度、サービスの安定性が重要です。
- GroqのLPUは、オンチップSRAM、決定論的実行、ハードウェアとソフトウェアの協調設計により、特定のAI推論ワークロードを最適化します。
- GroqCloudは、基盤となるコンピューティング能力をクラウドAPIとして提供し、開発者が対応AIモデルを呼び出せるようにします。
- LPUとGPUは、アーキテクチャおよび適用シナリオが異なります。単一トークンの生成速度だけで総合的な性能を評価することはできません。
- Groqの長期的な商業競争力は、チップの拡張性、ソフトウェアエコシステム、推論コスト、顧客需要、インフラ投資の収益性に左右されます。
Groqとは何か?AIコンピューティングのバリューチェーンでどのような役割を果たすのか?
Groqは、AI推論コンピューティングに特化した技術企業です。Google TPUプロジェクトに以前参加していたJonathan Rossによって2016年に設立されました。同社は主に、専用AIアクセラレーションチップ、コンパイラ、推論コンピューティングシステムを開発し、GroqCloudなどのサービスを通じて開発者や企業にモデル推論能力を提供しています。
GroqとGrokは同じ製品ではない点に注意が必要です。GroqはAIコンピューティングインフラに関連する技術名である一方、GrokはxAIが開発した人工知能モデルおよびアシスタント製品です。名称は似ていますが、異なる企業に属し、技術的な位置付けとビジネスモデルも異なります。
AIのバリューチェーンにおいて、Groqは主にコンピューティングインフラ層に位置付けられます。完全な生成AIアプリケーションには通常、モデル開発、学習用コンピューティング、推論デプロイメント、アプリケーションインターフェース、エンドユーザー向けサービスが含まれます。Groqの主な事業は、消費者向けの汎用チャットモデルを開発することではありません。代わりに、さまざまなモデル向けに高性能な推論環境を提供することを目指しています。
例えば、リアルタイムAIアシスタントを構築する場合、開発者はすでに学習済みのモデルを選択し、推論サービスを使用してユーザー入力を処理できます。モデルは質問を理解してコンテンツを生成し、基盤となるコンピューティングプラットフォームは、モデルをどれほど高速に実行できるか、また各リクエストがどれだけのコンピューティングリソースを消費するかを決定します。
このコンピューティングプロセスの最適化が、Groqの価値提案の中核です。Groqは、特別に設計されたプロセッサとソフトウェアシステムを通じて、特定の推論タスクにおける実行オーバーヘッドを削減し、モデルがより迅速に応答を生成できるようにします。
この位置付けは、Groqの市場機会が特定のAIモデルの人気だけでなく、生成AI業界全体における推論需要、モデルアーキテクチャ、コンピューティングコストの変化にも左右されることを意味します。
AI業界が推論コンピューティングにより注目している理由
AIコンピューティングは一般的に、学習と推論の2段階に分けられます。学習では、大量のデータを使用してモデルパラメータを調整し、モデルが言語理解や画像認識などの能力を獲得できるようにします。推論とは、学習済みモデルが新しい入力を受け取り、既存のパラメータに基づいて出力を生成することを指します。
どちらにもコンピューティングリソースが必要ですが、ワークロードは大きく異なります。モデル学習では通常、大規模なデータセットの処理、勾配の計算、パラメータの更新が行われます。大規模な並列コンピューティング、メモリ容量、複数デバイス間の連携が重視されます。一方、推論では、ユーザーリクエストに応じて迅速に結果を生成する必要があります。応答時間はユーザー体験に直接影響するため、これは特にチャット、音声、自動化アプリケーションにおいて重要です。
大規模言語モデルでは、推論プロセスは通常、PrefillとDecodeの2段階で構成されます。Prefillは入力プロンプトを処理して関連する計算状態を確立し、Decodeは後続のトークンを1つずつ生成します。自己回帰型言語モデルは通常、すでに生成されたコンテンツに基づいて次のトークンを予測する必要があるため、継続的な生成プロセスではメモリアクセス効率とコンピューティングスケジュールに大きな要求が生じます。
一般的なチャットアプリケーションのユーザーは、短時間の待機を許容する場合があります。しかし、リアルタイム音声アシスタント、自動カスタマーサービス、インタラクティブAIのシナリオでは、応答遅延が会話の自然さに直接影響する可能性があります。モデルが応答の最初の部分を生成するまでに長時間を要する場合や、リアルタイム通信に十分な出力速度を提供できない場合、モデル自体が高性能であっても、実用的なビジネス要件を満たすことが難しくなる可能性があります。
AIエージェントの発展により、推論への需要はさらに高まっています。一度限りの質問応答とは異なり、AIエージェントでは複数のモデル呼び出し、外部データの分析、ツール操作の実行、結果の検証が必要になる場合があります。1つのユーザータスクによって、複数回の内部推論と複数のAPIリクエストが発生し、総コンピューティング消費量が増加する可能性があります。
その結果、AIインフラにおける競争は、より高いモデル学習能力を追求するだけのものではなくなっています。現在では、より低いレイテンシー、より高いスループット、より妥当なコストで推論サービスを提供することにも重点が置かれています。
ただし、推論需要の増加は、学習用コンピューティングの重要性が低下することを意味するわけではありません。新しいモデルの学習、モデルのファインチューニング、推論サービスの提供は、いずれも同時に拡大し続ける可能性があります。違いは、異なるコンピューティングタスクに必要なハードウェアがより専門化している点です。
GroqのLPU技術アプローチの主な特徴は何か?
LPUは、Groqが専用推論プロセッサを表すために使用している技術用語です。幅広いコンピューティングタスク向けに設計された汎用GPUと比べ、LPUの設計は、特定のAIワークロードにおける演算、データ移動、レイテンシー制御により重点を置いています。
GroqのLPU技術は、オンチップメモリ、決定論的実行、コンパイラという3つの側面から理解できます。
オンチップSRAMはデータアクセス効率にどのように影響するのか?
現代のAIコンピューティングは、チップの演算能力だけでなく、データアクセスおよび転送の速度にも制約されます。大規模言語モデルの推論中、コンピューティングユニットはモデルの重みと中間データに継続的にアクセスする必要があります。データを適時に提供できなければ、理論上のコンピューティング能力が高くても、プロセッサはリソースを十分に活用できない可能性があります。
GroqのLPUの重要な特徴の1つは、オンチップSRAM(スタティック・ランダム・アクセス・メモリ)を重視していることです。SRAMは一般に低いアクセスレイテンシーを提供し、プロセッサが必要なデータを迅速に読み取るのに役立ちます。より大容量の外部広帯域メモリに依存する設計と比較して、このアーキテクチャは、特定のコンピューティングタスクにおけるデータアクセスのオーバーヘッドを削減することを目指しています。
SRAMにはコストと容量の制約もあります。同じチップ面積では、SRAMは一般に外部の大容量メモリと同等のストレージ規模を提供できません。そのため、より多くのパラメータを持つモデルをデプロイするには、容量要件を満たすために複数チップ間の連携、モデル分割、システムレベルの最適化が必要になる場合があります。
つまり、オンチップSRAMが他のすべてのメモリアーキテクチャより本質的に優れているわけではありません。その価値は、特定のモデルとワークロード、およびコンピューティングシステムがデータの保存と転送を効果的に連携できるかどうかに左右されます。
決定論的実行が重要な理由
Groqの設計におけるもう1つの重要な要素は、決定論的実行です。このアーキテクチャアプローチでは、コンパイラが多数のコンピューティング操作とデータ転送を事前に計画できるため、プロセッサはあらかじめ定められた実行スケジュールに従って動作できます。
従来のGPUは一般に、多様なコンピューティングタスク、動的スケジューリング、複雑なソフトウェア環境をサポートする必要があり、高い汎用性を備えています。一方、Groqは、より明確な実行計画を通じて、実行時のスケジューリングやリソース調整に伴う不確実性の一部を軽減しようとしています。
低レイテンシー推論では、予測可能な実行時間に実用的な価値があります。企業がリアルタイムAIサービスを提供する際には、平均応答速度だけでなく、異なるリクエスト間のレイテンシーのばらつきも重視します。平均性能が高くても、サービスで時折大きな応答遅延が発生する場合、ユーザー体験に影響を及ぼす可能性があります。
決定論的実行は、すべてのリクエストの応答時間が完全に同一になることを意味するものではありません。実際のレイテンシーは、入力長、出力長、バッチ処理戦略、システム負荷、ネットワーク状況などの要因によって依然として影響を受ける可能性があります。
コンパイラはLPUの性能最適化にどのように貢献するのか?
Groqの技術アプローチは、性能向上をハードウェアだけに依存していません。同社はハードウェアとソフトウェアの協調設計を重視しています。コンパイラは、モデルの計算グラフを分析し、関連する操作をチップのコンピューティングおよびストレージリソースにマッピングする必要があります。
このプロセスにおいて、コンパイラはモデルを実行可能な命令に変換するだけでなく、データ転送、計算順序、リソース使用率を配置し、異なるコンピューティングユニットがあらかじめ定められた計画に従って連携できるようにする役割も担います。
この設計により、対応モデルに対する深い最適化が可能になりますが、同時にソフトウェアツールチェーンにも大きな要求が生じます。モデル構造、演算子の種類、推論要件が変化する場合、プラットフォームはコンパイラとランタイム環境を継続的に改善する必要があります。
したがって、Groqの技術競争力はLPUチップそのものだけでなく、コンパイラ、モデル適応能力、推論システム全体の連携効率にも由来します。
GroqCloudはLPUコンピューティングをどのように商用サービスへ転換しているのか?
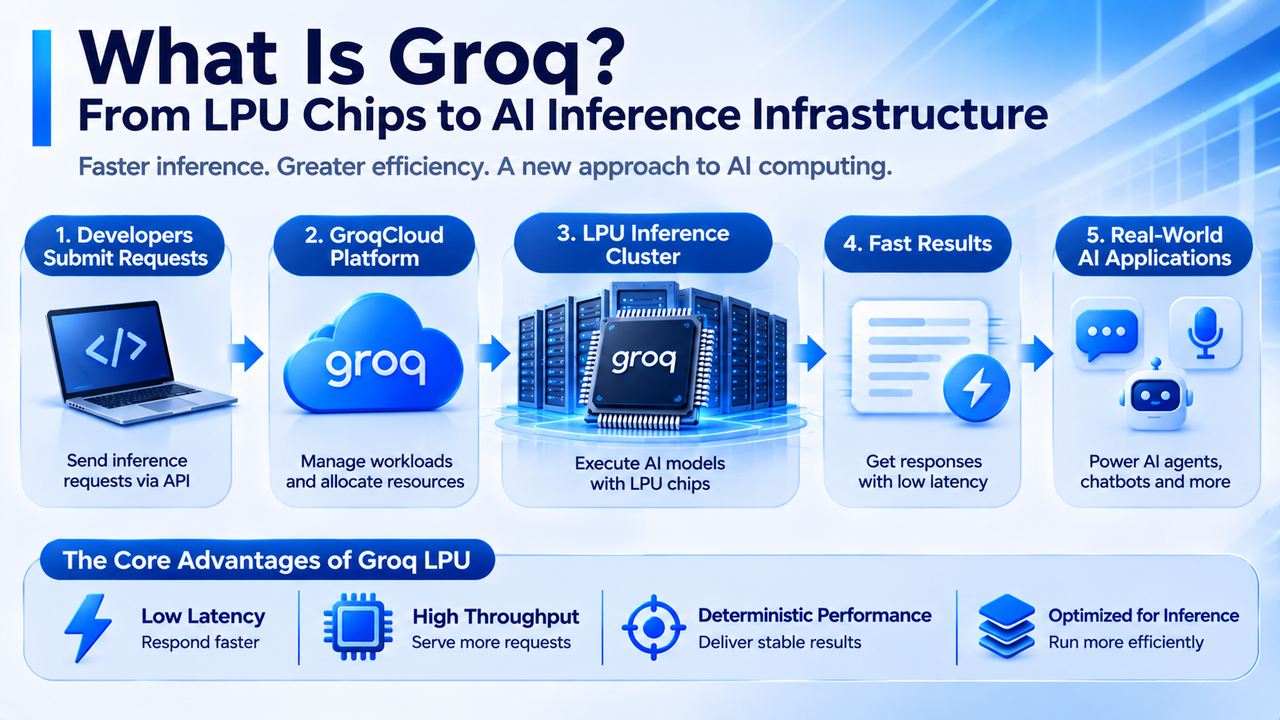
GroqCloudは、開発者および企業向けのGroqのクラウドベースAI推論サービスです。基盤となるチップ、コンピューティングクラスター、モデルランタイム環境を、APIを通じて利用可能なサービスに統合しています。これにより、顧客は専用チップを自ら購入・デプロイすることなく、Groqの推論インフラを利用できます。
一般的なアプリケーションでは、開発者はまずプラットフォームが対応するモデルを選択し、APIを通じてテキストまたは他の種類の入力を送信します。GroqCloudはリクエストを受信し、関連するコンピューティングタスクを基盤となる推論システムに割り当て、生成結果をアプリケーションに返します。このプロセスには、リクエストスケジューリング、モデル実行、リソース管理、結果の送信が含まれます。
企業顧客にとって、クラウド推論サービスを利用する主な価値は、インフラ導入の障壁を低くできることです。AIコンピューティングクラスターを独自に構築するには通常、ハードウェアの購入、ネットワークの構成、モデルのデプロイ、ランタイム環境の保守が必要です。APIを通じて推論サービスを利用することで、固定的なインフラ投資の一部を、事業利用量に応じて変動するサービス支出に転換できます。
Groqのプラットフォームは、単一の推論APIから、より包括的な企業向けインフラサービスへと拡大しています。同社の製品ポートフォリオには、専用コンピューティングインフラ、推論ソフトウェアスタック、エンタープライズレベルのガバナンスおよび制御機能が含まれ、性能、導入方法、管理権限に関する顧客ごとの異なる要件に対応します。
ただし、クラウド推論サービスの商業的価値は、チップ速度だけに依存するものではありません。企業は、モデル対応状況、APIの安定性、サービス可用性、データセキュリティ、リクエストあたりのコストも考慮する必要があります。プラットフォームが対応するモデルや演算子の範囲が限定的である場合、特定のタスクで低レイテンシーを提供していても、すべての企業アプリケーション要件を満たせない可能性があります。
収益モデルの観点では、推論クラウドサービスは通常、モデル使用量、処理されたトークン数、または予約済みコンピューティング容量に基づいて課金できます。価格設定方法が異なれば、必要となるリソース管理も異なります。従量課金は実際のリクエスト量への依存度が高い一方、予約容量サービスでは顧客契約、リソース提供、設備稼働率に注意を払う必要があります。
したがって、GroqCloudが技術を商用化できるかどうかは、最終的にLPUの基盤的な性能優位性を、安定的で拡張可能かつコスト競争力のある推論サービスに転換できるかにかかっています。
GroqとNVIDIAの提携は業界における位置付けをどのように変えるのか?
GroqとNVIDIAの関係は、同社の現在の業界における位置付けを理解するうえで重要な背景です。
2025年12月、GroqとNVIDIAは非独占的なAI推論技術ライセンス契約を締結しました。両社の開示によると、NVIDIAはGroqの関連推論技術のライセンスを取得し、Groqの創業者Jonathan Ross、当時の社長Sunny Madra、および一部のチームメンバーがNVIDIAに加わりました。GroqはCEOのSimon Edwardsの下で独立企業として運営を継続し、GroqCloud事業も継続して稼働していました。
この取引は、Groqの技術価値が推論サービスの独立販売だけでなく、技術ライセンスを通じてより広範なAIコンピューティングエコシステムへ参入することにも反映されていることを意味します。
2026年3月、NVIDIAはさらにGroq 3 LPX推論アクセラレーションアーキテクチャを導入し、Vera Rubinプラットフォームと組み合わせました。関連ソリューションは、AI推論の異なる段階におけるコンピューティング特性に基づいて、GPUとLPUにワークロードを割り当て、低レイテンシー推論の効率を向上させることを目指しています。この動きは、AIチップ市場における競争が複雑化していることを示しています。以前は、専用推論チップはGPUの代替候補と見なされることが多くありました。しかし、ヘテロジニアスコンピューティングアーキテクチャでは、異なる種類のプロセッサが補完的なタスクを実行することもできます。
例えば、GPUは大規模な並列コンピューティングや、そのアーキテクチャに適した一部のアテンション計算を処理できる一方、LPUは実行時間やデータ転送レイテンシーにより敏感なコンピューティングタスクを処理できます。システムレベルのスケジューリングを通じて、2種類のプロセッサは同じ推論ワークロードで連携できる可能性があります。
ただし、ヘテロジニアスアーキテクチャは追加のエンジニアリング上の複雑性ももたらします。システムは、異なるデバイス間でのデータ転送、タスク割り当て、メモリ管理を調整する必要があります。デバイス間通信のオーバーヘッドが高すぎる場合、理論上のハードウェア優位性が実用的な性能に十分に反映されない可能性があります。
2026年8月、GroqはNVIDIA Cloud Partnerプログラムへの参加も発表し、AIクラウドインフラ事業者としての位置付けをさらに強化しました。したがって、GroqをNVIDIAエコシステムから完全に独立し、GPUへの挑戦のみに注力するチップ企業として単純に説明することはできなくなっています。現在の同社事業には、独立した推論クラウドサービス、専用チップ技術、NVIDIAとのインフラ協力が含まれています。
GroqのビジネスモデルはAI推論市場の成長にどのように適応しているのか?
AI推論市場における商業需要は、主に企業アプリケーション、開発者向けサービス、継続的に稼働するAI製品から生じます。一般的にプロジェクトベースで段階的に行われるモデル学習とは異なり、推論サービスはユーザートラフィックの変化に応じて継続的にコンピューティング能力を提供する必要があります。そのため、リソース使用率、単位コスト、サービスの安定性がより重視されます。
Groqのビジネスモデルは、3つのレベルで理解できます。
-
推論インフラの構築。 Groqは、チップ、サーバー、ネットワーク、データセンターを通じて、利用可能なコンピューティング能力を構築する必要があります。これらの資産は、設備の導入、モデル適応、サービス開始が完了した後に初めて顧客リクエストをサポートし、収益を生み出すことができます。
-
クラウド推論サービス。 GroqCloudは、顧客が基盤となるチップを直接管理することなく開発者が呼び出せるAPIへとコンピューティング能力を転換します。サービス提供者にとって、収益成長は顧客数、リクエスト量、サービス価格、顧客維持率に左右されます。
-
企業向けインフラサービス。 一部の企業では、専用コンピューティングリソース、特定の導入方法、より厳格なガバナンス要件が必要になる場合があります。こうしたニーズは、より安定した長期的な顧客関係を生み出す可能性がありますが、エンジニアリング、運用、顧客サポートへのより大きな投資も必要です。
2026年6月、GroqはグローバルAI推論クラウド事業を拡大するため、6億5,000万ドルの成長資金を確保したと発表しました。同社は2027年までに約200 MWのインフラ容量に到達することを目標としていました。当時、同社は複数地域で13のデータセンターを運営し、500万人を超える開発者にサービスを提供し、毎週数十兆件のAIトークンを処理していると開示しました。
これらの数値は事業拡大のペースを観察するために使用できますが、収益性を直接示すものではありません。開発者数、トークン量、データセンター数は、それぞれユーザー到達範囲、サービス活動、インフラ規模を反映しています。これらは実際の売上高、利益、フリーキャッシュフローと同義ではありません。
例えば、推論プラットフォームが毎月処理するトークン数が100%増加しても、市場競争によりトークンあたりの価格が40%下落したとします。この場合、売上高の成長率は利用量の成長率を下回る可能性があります。同期間にインフラ構築費用と運営コストも増加した場合、利益率はさらに影響を受ける可能性があります。
したがって、Groqの商用化の可能性を分析するには、推論需要の成長、サービス価格、設備稼働率、設備投資を同時に考慮する必要があります。モデル実行速度だけで市場価値を評価することはできません。
Groqが直面する技術的およびスケーリング上の課題
専用推論チップは特定のワークロード向けに最適化できる一方で、Groqはモデルの変化、ハードウェアのスケーリング、市場競争から生じる課題にも直面しています。
モデル適応。 AIモデルのアーキテクチャは急速に進化し続けています。モデルごとに、異なるアテンション機構、パラメータ規模、演算精度、推論戦略を使用する場合があります。専用プロセッサがより多くのモデルをサポートするには、コンパイラ、ランタイム環境、関連するソフトウェアツールを継続的に更新する必要があります。
これはまた、特定のモデルにおいて1世代のチップが達成した性能優位性が、すべての新しいモデルに直接引き継がれるとは限らないことを意味します。長文コンテキスト推論、Mixture of Expertsモデル、マルチモーダルコンピューティングが発展するにつれて、基盤となるコンピューティングシステムは新しいワークロードに継続的に適応する必要があります。
マルチチップスケーリング。 GroqのLPUはオンチップSRAMと決定論的実行を重視していますが、大規模モデルでは単一チップの能力を超えるストレージおよびコンピューティングリソースが必要になることがよくあります。モデルを複数のチップに分散する場合、システムはデバイス間のデータ転送と計算順序を調整する必要があります。
マルチチップ通信の効率が低い場合、単一チップの低レイテンシー優位性が低下する可能性があります。したがって、チップ間接続、システム帯域幅、コンパイラスケジューリング能力は、専用推論アーキテクチャが拡張可能かどうかを判断する重要な要因です。
インフラ構築コスト。 チップが高いコンピューティング効率を提供したとしても、AIデータセンターの構築には電力接続、施設スペース、冷却システム、ネットワークインフラが依然として必要です。推論サービスの拡大に伴い、Groqは対応する資本コストと運用コストも負担する必要があります。
市場競争。 NVIDIA GPU、AMD GPU、Google TPU、その他の専用AIアクセラレータはいずれも推論コンピューティング需要を巡って競争しています。異なるプラットフォームは、モデル互換性、スループット、レイテンシー、コスト、ソフトウェアエコシステムにおいて、それぞれ優位性を持つ可能性があります。
企業顧客にとって、最終的な選択は一般に単一の性能指標によって決まるものではありません。総サービスコスト、アプリケーション互換性、長期的な運用信頼性に左右されます。したがって、Groqの技術アプローチが持続的な競争力を確立できるかどうかは、LPUアーキテクチャそのものだけでなく、ソフトウェアサポートの継続的な拡大、コンピューティングリソース利用率の向上、インフラ拡張コストの管理を実現できるかどうかにも左右されます。
GroqはAIチップおよびコンピューティング業界にとって何を意味するのか?
Groqに代表される技術アプローチは、AIコンピューティング業界が汎用アクセラレータ中心のアーキテクチャから、異なるワークロード向けに最適化されたヘテロジニアスコンピューティングシステムへと徐々に移行していることを示しています。生成AI開発の初期段階では、学習能力が業界進展の重要な推進力でした。より多くのモデルが実用アプリケーションに導入されるにつれて、推論サービスは継続的なコンピューティング需要を生み出し始め、低レイテンシー、コスト効率、サービス安定性に対する企業の要求を高めています。
これにより、専用推論チップが発展する余地が生まれます。特定のコンピューティングプロセス向けにハードウェアとソフトウェアを最適化することで、専用アーキテクチャは特定のタスクで性能またはコスト面の優位性を達成する可能性があります。
ただし、これはGPUが専用推論チップに完全に置き換えられることを意味するものではありません。GPUは幅広いソフトウェアエコシステム、豊富なモデルサポート、汎用コンピューティング能力を備えており、多様な学習および推論ワークロードに適応できます。専用アクセラレータは、特定のモデル、コンピューティング段階、低レイテンシーシナリオで役割を果たす可能性があります。
NVIDIAとGroqの技術協力は、将来のAIデータセンターが異なる種類のコンピューティングデバイスを同時に導入し、ソフトウェアスケジューリングシステムを通じてそれらを連携させる可能性をさらに示しています。このアプローチはコンピューティングリソースの利用率を向上させる可能性がありますが、システム設計と管理の複雑性も増大させます。
AIインフラ業界において、競争の焦点は個々のチップの理論性能から、完全なコンピューティングシステムを提供する能力へと徐々に広がる可能性があります。チップ性能、メモリ帯域幅、デバイス間接続、コンパイラ、エネルギー効率、クラウドサービス運用はいずれも、最終的な商業的収益に影響を及ぼす可能性があります。
Groqの発展は、AI推論インフラが単なるチップ製造の問題ではないことも示しています。これは、ハードウェアアーキテクチャ、ソフトウェア最適化、データセンター構築、商用サービス提供を包含する統合的な産業です。
結論
Groqは、AI推論コンピューティングに特化した技術企業です。そのLPUアーキテクチャは、オンチップSRAM、決定論的実行、コンパイラスケジューリングなどの設計要素を使用し、特定のAIワークロードにおける実行効率を向上させます。GroqCloudは基盤となるコンピューティング能力をクラウド推論サービスへ転換し、開発者や企業がAPIを通じて関連インフラを利用できるようにします。
AIアプリケーションがモデル学習からリアルタイムインタラクション、AIエージェント、継続稼働する企業向けサービスへと拡大する中、推論レイテンシー、スループット、コストはますます重要な技術指標になっています。Groqに代表される専用推論アーキテクチャは、AIコンピューティング業界に汎用GPUとは異なるアプローチを提供しています。
同時に、GroqのNVIDIAとの技術ライセンスおよびインフラ協力は、専用推論チップとGPUが必ずしも純粋に競合する必要がないことを示しています。将来のAIデータセンターでは、異なるプロセッサがそれぞれの特性に適したタスクを処理するヘテロジニアスコンピューティングアーキテクチャの採用が進む可能性があります。
ただし、専用チップにおける技術的優位性が自動的に商業的成功につながるわけではありません。Groqは引き続き、モデル適応、マルチチップスケーリング、インフラコスト、クラウドサービスの収益性に対応する必要があります。同社の長期的な発展は、推論性能の優位性を、安定的な顧客需要、持続可能な収益、妥当な資本収益へと転換できるかどうかにかかっています。
FAQ
Groqはどのような企業ですか?
GroqはAI推論コンピューティングに特化した技術企業です。主な事業分野には、LPU専用プロセッサ、推論コンピューティングシステム、GroqCloudクラウド推論サービスが含まれます。
GroqとGrokは同じ製品ですか?
いいえ。GroqはAI推論インフラに関連する技術企業である一方、GrokはxAIが開発した人工知能モデルおよびアシスタント製品です。
Groq LPUとは何ですか?
LPUは、Groqが設計した専用AI推論プロセッサです。オンチップSRAM、決定論的実行、コンパイラスケジューリング、低レイテンシーコンピューティングを重視しています。
Groq LPUはNVIDIA GPUとどのように異なりますか?
LPUは特定の推論タスクにおけるコンピューティングとデータ転送の最適化により重点を置く一方、GPUはより幅広い並列コンピューティング能力とソフトウェアエコシステムを提供します。実際の性能は、モデル、バッチサイズ、レイテンシー要件、デプロイ環境によって異なります。
GroqはNVIDIAに買収されましたか?
2026年11月時点で、Groqは独立企業として運営を継続しています。両社は2025年12月に非独占的な技術ライセンス契約を締結し、Groqの一部チームメンバーがNVIDIAに加わりました。これは、NVIDIAがGroq全体の買収を完了したことを意味するものではありません。
GroqCloudとは何ですか?
GroqCloudは、GroqのクラウドベースAI推論サービスです。開発者は基盤となるコンピューティングハードウェアを自ら購入・デプロイすることなく、APIを通じてプラットフォームが対応するモデルを呼び出せます。
GroqがAIコンピューティング市場で注目を集めている理由は何ですか?
Groqの技術アプローチは、AI推論におけるレイテンシー、データ転送、実行効率を最適化します。これは、リアルタイムAIアプリケーション、AIエージェント、企業向け推論サービスのコンピューティング効率要件と一致しています。
Groqには独自の暗号資産がありますか?
GroqはAIコンピューティングインフラ企業です。そのLPUおよびGroqCloud事業は、ネイティブ暗号資産トークンに依存していません。類似した名称を持つ第三者トークンを、Groqが発行または承認した資産として直接扱うべきではありません。
* 本情報はGateが提供または保証する金融アドバイス、その他のいかなる種類の推奨を意図したものではなく、構成するものではありません。
* 本記事はGateを参照することなく複製/送信/複写することを禁じます。違反した場合は著作権法の侵害となり法的措置の対象となります。
共有
内容


関連記事
Render、io.net、Akash:DePINハッシュレートネットワークの比較分析

AI分野におけるRenderの申請理由:分散型ハッシュレートが人工知能の発展を支える仕組み

USD.AI 収益源分析:AIインフラ借入資金による収益創出の仕組み

USD.AIトケノミクス:CHIPトークンの使用事例およびインセンティブメカニズムのデプス分析

PharosはRWAをどのようにオンチェーン化するのか、RealFiインフラのロジックを詳細にご紹介します