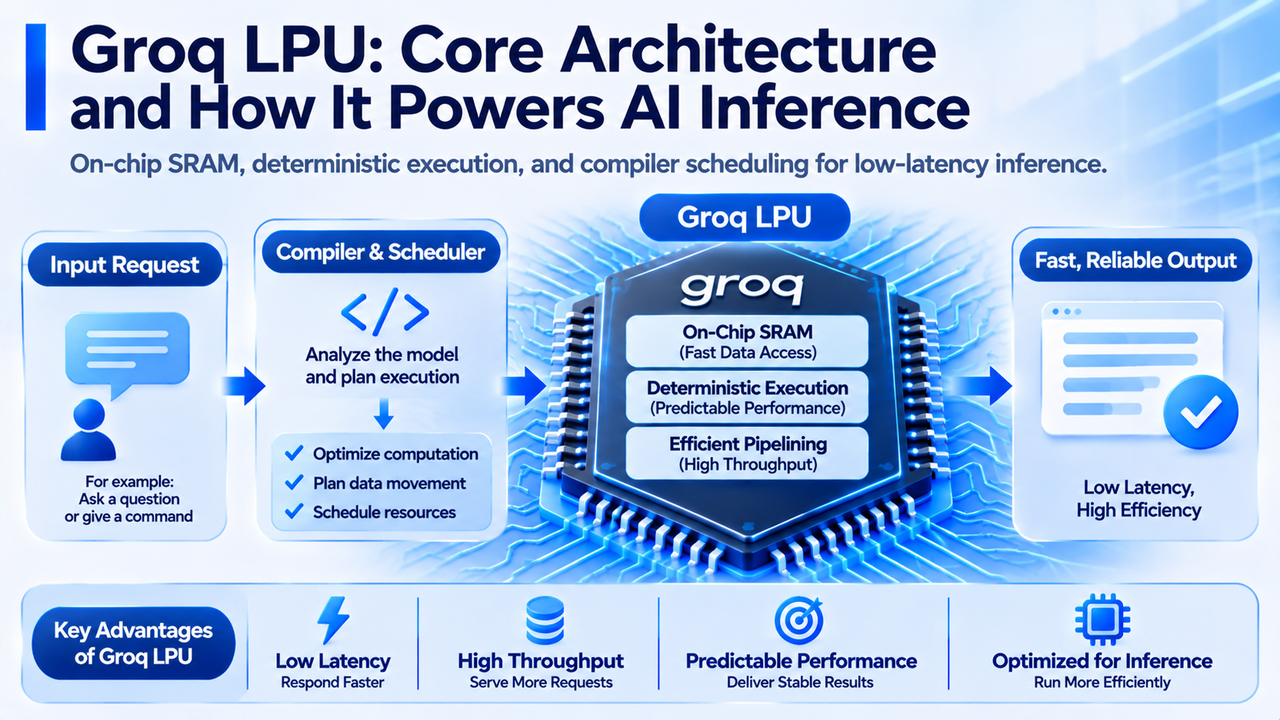
GPUが幅広い大規模並列コンピューティングタスク向けに設計されているのに対し、Groq LPUはオンチップSRAM、静的コンパイラスケジューリング、決定論的実行を重視するアーキテクチャを採用しています。このアプローチは、推論時のデータ転送とランタイムスケジューリングのオーバーヘッドを削減し、リアルタイムAIアプリケーションにより特化したコンピューティング能力を提供することを目的としています。
大規模言語モデルがインテリジェントカスタマーサービス、音声インタラクション、AIエージェント、企業自動化で広く利用されるようになるにつれ、推論に求められる要件は単なる処理速度の最大化から、応答レイテンシー、サービスの安定性、単位当たりのコンピューティングコストへと拡大しています。Groq LPUに代表される専用アクセラレータのアプローチは、従来の汎用コンピューティングアーキテクチャとは異なる技術的選択肢をAIインフラストラクチャにもたらします。本記事では、Groq LPUの仕組みを詳しく紹介し、SRAM、決定論的実行、コンパイラが推論性能に与える影響を分析するとともに、適用可能なシナリオと技術的制約について解説します。
主なポイント
-
Groq LPUは、低レイテンシー、予測可能な実行、効率的なデータ転送を重視して設計された、AI推論ワークロード向けの専用プロセッサです。
-
大規模言語モデルの推論は、一般的にPrefillとDecodeの2段階で構成されます。これらの段階では、演算能力とメモリ帯域幅に対する要件が異なります。
-
Groq LPUはオンチップSRAMを使用して特定のデータアクセス経路を短縮しますが、オンチップストレージ容量が比較的限られているため、モデルデプロイメントとマルチチップスケーリングに関する要件も生じます。
-
決定論的実行と静的コンパイラスケジューリングは、一部のランタイムスケジューリングのオーバーヘッドを削減できますが、すべてのリクエストで応答時間が完全に同一になることを意味するものではありません。
-
LPUは、リアルタイムテキスト生成や音声インタラクションなどの低レイテンシーアプリケーションで優位性を持つ可能性があります。実際の性能は、モデル、ワークロード、システム構成、サービス価格に依然として左右されます。
Groq LPUとは?従来のAIアクセラレータと何が異なるのか?
Groq LPUは、Groqが設計したAI推論専用プロセッサです。LPUはLanguage Processing Unitの略です。その設計は、あらゆる種類のタスクに対応する汎用コンピューティング能力を提供するのではなく、言語モデル推論におけるデータ移動、演算実行、レイテンシー制御を最適化することを目的としています。
LPUの技術的な位置付けを理解するには、まずAIアクセラレータで採用されている異なる設計アプローチを認識する必要があります。GPUはもともと、主にグラフィックス処理向けに設計されました。その後、大規模並列コンピューティング能力と成熟したソフトウェアエコシステムにより、ディープラーニングのトレーニングおよび推論で広く採用されるようになりました。TPUなどの専用アクセラレータは、機械学習向けの演算を最適化することで、特定のコンピューティングタスクの実行効率を向上させます。
Groq LPUは、コンパイラとハードウェア間の連携をさらに重視しています。このアーキテクチャは、モデル実行前に演算とデータ転送を計画し、チップがあらかじめ定められたスケジュールに従ってタスクを完了できるようにすることで、動的スケジューリングによって発生する一部のオーバーヘッドを削減することを目指しています。
この設計アプローチは、Groqが初期開発段階で導入したTensor Streaming Processor(TSP)の技術的方向性と密接に関連しています。コンピューティングリソース、オンチップストレージ、データ転送経路を編成することで、プロセッサはコンパイラが配置した順序に沿ってモデル演算を実行できます。
LPUは、すべての言語モデルプロセッサに共通する標準化された業界カテゴリーではない点に注意が必要です。これはGroqが使用する技術名称です。メーカーによっては、異なるチップ設計を採用したり、GPU、ASIC、その他の専用アクセラレータを通じて低レイテンシー推論を実現したりする場合があります。
したがって、Groq LPUの技術的価値を評価するには、プロセッサ名だけを考慮するだけでは不十分です。推論時にデータアクセス、演算スケジューリング、マルチチップ通信をどのように処理するかを分析する必要があります。
大規模言語モデルに低レイテンシーコンピューティングが必要な理由
大規模言語モデルの推論とは、モデルが入力を受け取り、トレーニング済みパラメータを使用して出力を生成するプロセスを指します。一般的な自己回帰型言語モデルでは、推論は通常、PrefillとDecodeの2段階で構成されます。Prefill段階では、主にユーザーのプロンプトを処理し、その後の生成に必要な計算状態を確立します。この段階では複数の入力トークンを同時に処理できるため、一般的に強い並列コンピューティング特性を備えています。
Decode段階では、出力トークンを1つずつ生成します。通常、モデルは既存の入力および以前に生成されたコンテンツに基づいて次のトークンを予測する必要があるため、複数の生成ステップ間には依存関係が存在します。その結果、これらのステップは、一部のトレーニング演算のように容易に完全並列化することはできません。
この違いは、推論性能を単一の指標で測定できないことを意味します。
**Time to First Token(TTFT)**は、リクエスト開始から最初の出力トークンが生成されるまでの時間を測定します。主に、ユーザーが応答まで待つ必要があると感じる時間に影響します。
トークン生成速度は、モデルが出力を開始した後、単位時間当たりに生成できるトークン数を測定します。継続的なテキスト生成の滑らかさに直接影響します。スループットは、一定期間内にシステムが処理できるリクエスト数またはトークン数に焦点を当て、比較的高い同時負荷の下で推論サービスが持つ全体的な処理能力を反映します。
例えば、2つの推論プラットフォームが同じ言語モデルを実行できる場合でも、プラットフォームAは単一ユーザーのリクエストに対してより高速なトークン生成を提供する一方、プラットフォームBは数百件のリクエストを同時に処理する際に、より高い全体スループットを実現する可能性があります。
つまり、低レイテンシーと高スループットは完全に同じ性能目標ではありません。単一ユーザーとのリアルタイムインタラクション向けに最適化されたシステムが、すべてのバッチ処理や高同時実行シナリオで同じ優位性を持つとは限りません。
音声アシスタント、リアルタイム翻訳、インタラクティブAIアプリケーションでは、TTFTと継続的な生成速度が特に重要です。ユーザーは一般的に、システムが迅速に応答を開始し、自然で流暢なコンテンツを継続して生成することを期待します。
オフライン文書分析やバッチデータ処理などのタスクでは、個別リクエストの即時応答時間はそれほど重要でない場合があります。企業は代わりに、全体的なスループットと単位当たりの処理コストをより重視する可能性があります。
Groq LPUの設計上の優先事項の1つは、応答時間に敏感な推論ワークロードに対する実行効率の最適化です。
Groq LPUはSRAMをどのように使用してデータアクセス効率を向上させるのか?
最新のAIプロセッサの性能は、演算ユニットが実行できる演算数だけでなく、データがそれらの演算ユニットに適時に到達できるかどうかにも左右されます。
大規模言語モデルの推論では、プロセッサはモデルの重みを繰り返し読み取り、中間結果にアクセスし、コンテキスト関連データを維持します。データを十分に高速に読み取れない場合、理論上の演算能力が高いチップであっても、データ待ちによって能力を十分に発揮できない可能性があります。
この問題は一般に、メモリボトルネックと呼ばれます。
Groq LPUの主要なアーキテクチャ上の特徴の1つは、データの保存とアクセスにオンチップSRAM(Static Random-Access Memory)を使用することを重視している点です。
SRAMは一般的にアクセスレイテンシーが低く、プロセッサチップに直接統合できます。外部メモリインターフェースを介してアクセスするデータと比較して、オンチップストレージはデータ転送経路を短縮し、一部のアクセスオーバーヘッドを削減できます。
この設計を理解するには、SRAMと高帯域幅メモリ(HBM)の基本的な特性を比較すると有用です。
| 比較項目 | SRAM | HBM |
|---|---|---|
| 一般的な配置場所 | プロセッサチップ内部 | プロセッサパッケージ内の独立したメモリスタック |
| 主な利点 | 低アクセスレイテンシーと高い統合性 | 大容量と高い総帯域幅 |
| 主な制約 | 面積コストが高く、容量が限られる | データアクセスには依然としてメモリインターフェースが必要 |
| 一般的な用途 | キャッシュおよびオンチップ作業用メモリ | モデルの重みや活性化値などの大規模データ |
| 推論における意義 | 特定のデータアクセス経路を最適化 | より大規模なモデルと計算状態をサポート |
ただし、SRAMがすべての状況でHBMより高速である、またはSRAMを使用すればメモリボトルネックが解消されると単純に考えることはできません。実際の性能は、データレイアウト、並列アクセスパターン、メモリ帯域幅、モデルアーキテクチャにも左右されます。
SRAMの主な制約は、ストレージ密度とチップ面積コストです。多数のパラメータを持つ言語モデルでは、単一プロセッサ上のSRAMだけでは、すべてのモデル重みとランタイム状態を保持するには一般的に不十分です。
そのためGroqは、より大規模なコンピューティングシステムでモデルを実行するために、マルチチップ連携とシステムレベルのデータ割り当てを使用する必要があります。つまり、LPUの優位性は個々のチップ上のSRAMだけから得られるものではありません。オンチップストレージ、演算パイプライン、チップ相互接続、コンパイラの総合的な設計によって生じます。
決定論的実行とコンパイラスケジューリングは推論性能にどのような影響を与えるのか?
決定論的実行は、Groq LPUアーキテクチャを理解する上でのもう1つの重要な概念です。その中核となる考え方は、プログラムの実行前に、演算処理の実行順序、データ転送経路、リソース割り当てを可能な限り決定し、実行中に一時的なスケジューリング判断を行う必要性を減らすことです。
従来の汎用コンピューティングアーキテクチャでは、プロセッサはさまざまな種類のプログラムやワークロードに対応する必要があります。リソース使用率を向上させるため、システムには通常、動的タスクスケジューリング、キャッシュ管理、その他のランタイムメカニズムが含まれます。これらの設計は高い柔軟性を提供する一方、追加のスケジューリングオーバーヘッドを生じさせる可能性もあります。
Groq LPUは異なる設計アプローチを採用しています。モデルを実行する前に、コンパイラがその計算グラフを分析し、演算処理とデータ移動の実行計画を作成します。プロセッサはその後、この計画に従って実行されるため、データを異なる演算ユニット間で秩序立てて移動させることができます。例えば、言語モデルでは、行列演算、活性化関数、その他の計算を継続的に実行する必要があります。コンパイラは、これらのタスクを異なるコンピューティングリソース上でいつ実行するかを事前に配置し、必要なデータ転送を調整できます。
このアプローチは、生産ラインの各工程を事前に計画し、異なる段階があらかじめ定められたリズムに従って連携できるようにすることに似ています。
AI推論において、決定論的実行には主に2つの意味があります。
-
一部のランタイムスケジューリングのオーバーヘッドを削減できます。プロセッサは各演算段階で各タスクの実行順序を再決定する必要がないため、特定のワークロードにおける実行効率の向上に役立つ可能性があります。
-
演算の実行時間をより予測可能にできます。リアルタイムAIサービスでは、一貫した応答性能は低い平均レイテンシーと同様に重要です。決定論的実行は、実際のAPIリクエストの応答時間が完全に固定されることを意味するものではありません。入力長、出力トークン数、リクエストのキューイング、ネットワーク伝送、サービス負荷は、エンドツーエンドのレイテンシーに依然として差異を生じさせる可能性があります。
-
静的スケジューリングは、一部のコンピューティングタスクの柔軟性を低下させる可能性もあります。モデルに複雑な動的制御フローがある場合や、実行経路をリアルタイムの結果に基づいて頻繁に変更する必要がある場合、コンパイラは追加の処理戦略を使用する必要があるかもしれません。
したがって、決定論的実行の価値は、すべての不確実性を排除することではありません。むしろ、適切なコンピューティングタスクにおいて、より明確な実行計画を通じてハードウェアリソースの利用効率を向上させることにあります。
Groq LPUが低レイテンシーAI推論に適している理由
Groq LPUの低レイテンシー設計は、単一の技術に依存するものではありません。オンチップSRAM、決定論的実行、コンパイラ最適化、システムレベルの相互接続が組み合わさった結果です。大規模言語モデルの生成中、モデルは継続的に計算を実行し、既存の結果に基づいて後続のトークンを生成する必要があります。プロセッサが一部のデータアクセス遅延とランタイムスケジューリングのオーバーヘッドを削減できれば、連続する生成ステップに必要な時間を短縮できる可能性があります。
これは特にDecode段階に関係します。自己回帰型モデルは一般的にトークンを1つずつ生成する必要があるため、各生成ステップのレイテンシーが蓄積し、最終的にユーザーが感じるテキスト出力速度に影響します。ただし、異なる推論タスクの性能ボトルネックは常に同じではありません。長いプロンプトの処理は大規模並列コンピューティング能力への依存度が高い場合がある一方、継続的な生成はメモリアクセスと段階的な実行レイテンシーの影響をより受ける可能性があります。
したがって、Groq LPUの実際の性能は、モデルタイプ、入力長、出力長、同時リクエスト数と組み合わせて評価する必要があります。
アプリケーションの観点からは、以下の種類のサービスは低レイテンシー推論に特に敏感です。
リアルタイム音声インタラクション。 音声アシスタントは、ユーザーの音声をテキストに変換し、言語モデルを呼び出して応答を生成した後、音声合成で結果を出力する必要があります。言語モデルの応答生成が遅い場合、会話に目立つ間が生じる可能性があります。
インタラクティブAIエージェント。 AIエージェントはタスクの実行時、次の行動を決定するために言語モデルを複数回呼び出す必要がある場合があります。各推論の遅延は全体のタスク完了時間に影響するため、個々の推論の待機時間を削減することで、ユーザー体験が向上する可能性があります。
インテリジェントカスタマーサービスとリアルタイムアプリケーション。 多数のユーザーにサービスを提供するオンラインサービスでは、迅速な応答だけでなく、安定したサービス品質を維持するために、リクエスト間のレイテンシー変動を制御することも必要です。
ただし、低レイテンシーが必ずしも単位当たりのコンピューティングコストの最低水準を意味するわけではありません。例えば、推論プラットフォームが個別リクエストを高速に処理できても、ハードウェア取得コストが高い、または低負荷時に多くのリソースがアイドル状態のままである場合、100万トークン当たりの実際のサービスコストは他のソリューションを上回る可能性があります。逆に、別のプラットフォームでは、個別リクエストのトークン生成はより遅くても、バッチ処理を通じて多数のユーザーに同時にサービスを提供し、最終的により低い平均コストを実現する場合があります。
したがって、企業が推論プラットフォームを選択する際は、トークン/秒だけに基づいて判断するのではなく、レイテンシー、スループット、コスト、モデル互換性のバランスを取る必要があります。
Groq LPUの技術的制約とは?
Groq LPUはAI推論向けに特化して最適化されていますが、専用アーキテクチャであることは、すべてのコンピューティングタスクで他のソリューションを上回ることを意味しません。主な技術的制約には、メモリ容量、マルチチップスケーリング、モデル互換性、システムコストが含まれます。
オンチップSRAM容量の制約。 SRAMはストレージ密度が比較的低いため、単一チップで利用可能なオンチップストレージの容量には限りがあります。モデルパラメータとランタイム状態が単一チップの容量を超える場合、演算とデータをマルチチップシステム全体に分散する必要があります。
例えば、大規模言語モデルでは数十GB以上のストレージが必要になる場合があります。このすべてのデータを単一チップのオンチップSRAMだけで保存することは、一般的に困難です。そのためシステムは、モデルを複数のプロセッサに分散し、チップ相互接続を使用して必要なデータ交換を実行する必要があります。
このアプローチはデプロイ可能なモデルの規模を拡大できますが、システム設計の複雑性も高まります。
マルチチップ通信のオーバーヘッド。 個々のLPUが高速に演算を実行できる場合でも、モデルがチップ間で頻繁なデータ転送を必要とする場合、全体的な推論速度は相互接続帯域幅、通信レイテンシー、データ割り当て戦略の影響を受ける可能性があります。大規模推論システムでは、性能は個々のプロセッサの演算能力だけでなく、チップクラスタ全体の協調動作にも左右されます。
モデル互換性。 Groq LPUは、コンパイラを利用してモデル演算を専用ハードウェアにマッピングするため、対応するソフトウェアサポートが必要です。新しいAIモデルが異なる演算演算子、アテンションメカニズム、動的実行方式を導入する場合、プラットフォームはコンパイラとランタイム環境を更新する必要がある可能性があります。幅広いソフトウェアエコシステムを持つ汎用GPUと比べ、専用推論プロセッサでは、急速に変化するモデル技術に適応するための継続的なソフトウェア開発が必要です。
インフラストラクチャおよび商業コスト。 LPUの性能上の利点には、完全なコンピューティングシステムが必要です。実際のデプロイメントには、チップ製造、サーバー、ネットワーク、電力、冷却設備のコストが依然として伴います。クラウド推論サービスプロバイダーにとって、設備稼働率と顧客需要も投資利益率を左右します。
したがって、Groq LPUは実際のデプロイメント条件と併せて評価する必要があります。特定のテストにおける高いトークン生成速度は、すべてのモデルおよび商業シナリオでより高いコスト効率を直接示すものではありません。
Groq LPUはAI推論インフラストラクチャの将来に何を意味するのか?
Groq LPUの開発は、AIコンピューティング市場の専門化が進んでいることを反映しています。生成AIアプリケーションが拡大するにつれ、企業は単一プロセッサの理論上のピーク性能だけに注目するのではなく、異なるワークロードに基づいてより専門化されたコンピューティングアーキテクチャを選択し始めています。
モデルのトレーニングでは、大規模並列コンピューティング、メモリ容量、複数デバイス間の通信が引き続き重要です。推論では、TTFT、継続的な生成速度、同時実行スループット、トークン当たりのコストが、より直接的な商業指標となっています。
コンピューティングタスクの違いは、専用推論チップの発展余地を生み出しています。同時に、専用プロセッサとGPUは、必ずしも純粋な代替関係にあるわけではありません。2026年3月、NVIDIAはGroq 3 LPXとVera Rubinプラットフォームを組み合わせた推論アーキテクチャを導入し、異なるタイプのコンピューティングデバイスが、それぞれの特性に適した推論タスクをどのように処理できるかを模索しました。
この方向性は、ヘテロジニアスコンピューティングの発展傾向を反映しています。将来、AIデータセンターではGPU、専用推論アクセラレータ、その他のコンピューティングデバイスが同時にデプロイされ、ソフトウェアシステムが異なるタスクの実行を調整する可能性があります。
例えば、大規模並列処理を必要とするワークロードには適切なGPUリソースを使用できる一方、レイテンシーに非常に敏感な特定の生成タスクでは、専用推論プロセッサが優位性を提供する場合があります。ただし、ヘテロジニアスコンピューティングは、チップの種類を追加するだけで効率が向上することを意味しません。システムは、デバイス間通信、タスクスケジューリング、ソフトウェア互換性、インフラストラクチャコストにも対応する必要があります。
AIチップ業界にとって、これは競争が個別のハードウェアコンポーネントの性能から、完全なコンピューティングシステムの効率へと拡大していることを意味します。プロセッサアーキテクチャ、コンパイラ、メモリシステム、相互接続技術、クラウドサービス運用は、いずれも最終的な性能と商業価値を決定する要因となる可能性があります。
Groq LPUに代表される技術的アプローチは、この変化の具体例を示しています。その長期的な価値は、特定世代のチップの推論速度だけでなく、モデルの進化に継続的に適応し、技術的性能を安定的かつ拡張可能なコンピューティングサービスに変換できるかどうかにも左右されます。
結論
Groq LPUは、AI推論向けに設計された専用プロセッサです。オンチップSRAM、決定論的実行、静的コンパイラスケジューリングなどの技術を使用し、特定の大規模言語モデルワークロードにおけるデータアクセスと演算実行を最適化します。
汎用GPUと比較して、Groq LPUは特定の推論タスクにおける低レイテンシーと実行予測可能性をより重視しています。この設計は、リアルタイムテキスト生成、音声インタラクション、AIエージェントなどのアプリケーションにおける性能最適化の検討に適していますが、LPUがすべてのモデルおよびコンピューティングシナリオでGPUを置き換えられることを意味するものではありません。
同時に、SRAM容量、マルチチップ通信、モデル適応、インフラストラクチャコストは、専用推論アーキテクチャが対処すべき重要な課題であり続けます。
AI業界がモデル開発から大規模アプリケーションへと拡大するにつれ、推論コンピューティングにおける競争は、単に演算能力を最大化することから、レイテンシー、スループット、コスト、システム全体の効率を最適化することへと移行しています。Groq LPUの開発は、専用アクセラレータが将来のAIインフラストラクチャでより重要な役割を果たす可能性を示していますが、その実際の価値は、具体的なワークロードと商業デプロイメントの結果を通じて検証される必要があります。
FAQ
Groq LPUとは?
Groq LPUは、Groqが設計したAI推論専用プロセッサです。主にオンチップSRAM、決定論的実行、コンパイラスケジューリングなどの技術を使用して、特定の言語モデル推論タスクを最適化します。
LPUとGPUの主な違いは何ですか?
LPUは特定の推論タスクにおける実行とデータ転送の最適化をより重視する一方、GPUは幅広い並列コンピューティング能力と成熟したソフトウェアエコシステムを提供します。両者の性能差は、特定のモデルとランタイム環境に左右されます。
Groq LPUがSRAMを使用する理由は何ですか?
SRAMは低レイテンシーのオンチップデータアクセスを提供し、特定の推論タスクにおけるデータ読み取りのオーバーヘッド削減に役立つ可能性があります。ただし、SRAMの容量には限りがあるため、大規模モデルのデプロイメントには一般的にマルチチップ連携が必要です。
決定論的実行とは何ですか?
決定論的実行とは、プログラムの実行前に、演算順序、データ転送、リソース割り当てを可能な限り計画することを意味します。これにより、一部のランタイムスケジューリングのオーバーヘッドを削減し、演算実行をより予測可能にできます。
Groq LPUはAIモデルのトレーニングに使用できますか?
Groq LPUは主に推論ワークロード向けに設計されており、汎用的な大規模モデルのトレーニングを主な目的としていません。実際のサポート状況は、ハードウェアアーキテクチャとソフトウェアツールチェーンに左右されます。
Groq LPUは推論において常にNVIDIA GPUより高速ですか?
必ずしもそうではありません。モデル、入力長、出力長、同時実行レベル、テスト環境の違いは、いずれも結果に影響します。単一ユーザーに対するトークン生成速度が高くても、全体的なスループットが優れている、またはトークン当たりのコストが低いことを必ずしも意味しません。
Groq LPUがAIエージェントに適している理由は何ですか?
AIエージェントは、複数の推論呼び出しを順番に実行する必要がある場合があります。各リクエストの応答レイテンシーを削減することで、タスク全体の実行時間を短縮できる可能性がありますが、最終的な結果はツール呼び出し、ネットワーク伝送、その他の処理段階にも左右されます。
品質チェック:
- 意味が原文と完全に一致し、省略や事実に基づかない内容がないことを確認してください。
- 数字、通貨、単位、日付、製品名、用語などの主要な要素を保持してください。
- 事実上の制約を維持しながら、自然で流暢な日本語にしてください。
品質チェック:
- 意味が原文と完全に一致し、省略や事実に基づかない内容がないことを確認してください。
- 数字、通貨、単位、日付、製品名、用語などの主要な要素を保持してください。
- 事実上の制約を維持しながら、自然で流暢な日本語にしてください。
* 本情報はGateが提供または保証する金融アドバイス、その他のいかなる種類の推奨を意図したものではなく、構成するものではありません。
* 本記事はGateを参照することなく複製/送信/複写することを禁じます。違反した場合は著作権法の侵害となり法的措置の対象となります。
共有
内容


関連記事
Render、io.net、Akash:DePINハッシュレートネットワークの比較分析

AI分野におけるRenderの申請理由:分散型ハッシュレートが人工知能の発展を支える仕組み

USD.AI 収益源分析:AIインフラ借入資金による収益創出の仕組み

USD.AIトケノミクス:CHIPトークンの使用事例およびインセンティブメカニズムのデプス分析
Audiera GameFiデプス分析:Dance-to-EarnがAIとリズムゲームをどのように組み合わせているか