المقدمة
شهدت السنوات الأخيرة تطورًا واضحًا في صناعة الـAI؛ حيث أصبحت النماذج أكبر وأكثر سرعة في التدريب وأعلى قدرة، مما أدى إلى تطبيقات منتجات أوسع.
مع انتقال النماذج إلى فئات التفكير المعقد وتطوير الحوسبة وإدارة الويب وسير عمل الوكلاء (Agents)، ظهرت في الصناعة تساؤلات جديدة: هل يجب دفع تطوير الـAI دائمًا إلى الأمام بهذه السرعة؟
المسألة لا تتعلق فقط بـ“دعم الـAI” أو “مناهضة الـAI”، بل إن طبيعة المخاطر باتت تتغير.
كانت مشكلات الـAI المبكر تتركز في المخرجات—كالهلوسات والأخطاء الواقعية والانحياز والإجابات غير الدقيقة. إذا اكتشف المستخدم خطأً، كان بإمكانه الاستفسار مجددًا أو مراجعة الرد يدويًا أو تجاهله. ولكن حين يستطيع الـAI استدعاء الأدوات وتعديل الأكواد والوصول للأنظمة الخارجية وتنفيذ مهام معقدة بشكل متواصل، لم تعد الأخطاء تنحصر في نافذة الدردشة بل تصبح أفعالًا في العالم الواقعي.
أعلنت OpenAI علنًا في أغسطس 2026 أنه كلما تطورت قدرات النماذج، ازدادت المخاطر المصاحبة للتطوير الداخلي والاختبار. وبناءً عليه، قامت بإبطاء توسع بعض القدرات المتقدمة مؤقتًا مع تعزيز المراقبة والمواءمة والاحتواء. وتوصلت بعد تقييم Astra اللاحق إلى أن قدرات الشركة في حماية الأمن السيبراني وصلت إلى مستوى حرج وفق إطارها الداخلي، مما يستدعي تدابير حماية أقوى قبل الإصدار.
من جهة أخرى، يوضح أحدث تقرير استخبارات التهديدات الصادر عن Anthropic تطورًا ملموسًا: يجري إساءة استخدام الـAI للهجمات الإلكترونية والمراقبة والاحتيال وعمليات التأثير والمساعدة في البحث البيولوجي. ومع تحسن قدرات النماذج، يضاعف المهاجمون من سرعة وتوسّع وتعقيد استخدامهم للـAI.
لهذا لم يعد من الممكن اعتبار الحذر في الـAI مسألة تقتصر على إضافة بعض تعليمات السلامة للنموذج؛ بل يستدعي الأمر إعادة التفكير في دورة حياة الـAI من التدريب إلى النشر.
النقاط الرئيسية
- كلما أصبحت الـAI أكثر قدرة، تحولت الأخطاء وسوء الاستخدام من مشاكل مخرجات إلى مخاطر فعالية في العالم الواقعي
- تطور النماذج المتقدمة لم يعد يقتصر على سرعة التدريب بل يشمل التقييم والمراقبة والعزلة وعتبات السلامة
- ظهور الوكلاء (Agents) يحوّل مخاطر الـAI من “إجابة خاطئة” إلى “عمل خاطئ”
- السيطرة الحقيقية للمؤسسات تنصب على الأذونات الممنوحة للـAI، والأنظمة التي يستطيع الوصول إليها، ومتى يستطيع العمل بشكل مستقل
- تطوير الـAI بشكل حذر لا يعني وقف الابتكار، بل يعني مواءمة نمو القدرات مع التطور في إجراءات السلامة
- المرحلة التالية من المنافسة في الـAI لن تعتمد فقط على قدرات النماذج، بل على من يستطيع بناء أنظمة أشمل للتحكم والتقييم والحوكمة
سؤال تطوير الـAI يتحول من “هل يمكن تحقيقه؟” إلى “متى يجب تحقيقه؟”
في بدايات الصناعة، كان السؤال الأساسي: هل يمكن للنموذج إكمال المهمة؟ هل يستطيع كتابة الأكواد أو النجاح في اختبار أو تلخيص وثيقة أو فهم صورة أو تنفيذ استدلال رياضي معقد؟ كانت المعايير محصورة بالدقة والأداء مقابل المعاير ونسب إكمال المهام.
لكن مع دخول النماذج المتقدمة مرحلة أكثر تعقيدًا، بدأت هذه المعايير تظهر حدودها.
قدرة النموذج على إنجاز مهمة لا تعني ضرورة نشره فورًا. فالأنظمة الواقعية تتضمن أذونات معقدة واعتمادات خارجية ونتائج لا رجعة فيها. في المختبرات يمكن تقييد النموذج في بيئة معزولة، لكن عند نشره عبر الأنظمة المؤسسية قد يحصل على وصول مباشر لقواعد بيانات حقيقة وواجهات دفع ومستودعات الأكواد ومعلومات داخلية.
لذا دخل تطوير الـAI مرحلة جديدة: يجب النظر لقدرات النموذج بمعزل عن ظروف نشره.
هذا التحول ينعكس في مستندات السلامة الأخيرة التي نشرتها OpenAI، حيث باتت الشركة تقيّم ليس فقط “ما يستطيع النموذج فعله”، بل إذا ما وصل إلى عتبات قدرات عالية الخطورة وما إذا كانت الحماية كافية. وفي توضيحها العلني لـAstra تحدد بالاسم القدرات السيبرانية كقدرات حرجة تتطلب مستوى أعلى من الأمان.
بالتالي لم تعد وتيرة تطوير الـAI مجرد محور هندسي، بل باتت قضية هندسة السلامة والحوكمة التنظيمية والقدرة المؤسسية.
ماذا يتغير عندما ينتقل الـAI من الإجابات إلى تنفيذ المهام؟
هذه النقطة الأساسية لفهم موقف الحذر في الـAI اليوم.
حين يقدم نموذج دردشة عادي إجابة خاطئة، يستطيع المستخدمون غالبًا تحديد المشكلة.
أما إذا كان لدى وكيل (Agent) وصول إلى متصفح أو بيئة تنفيذ الأكواد أو قاعدة بيانات أو بريد إلكتروني أو سحابة، فقد ينفذ عدة خطوات دون ضرورة تأكيد الإنسان.
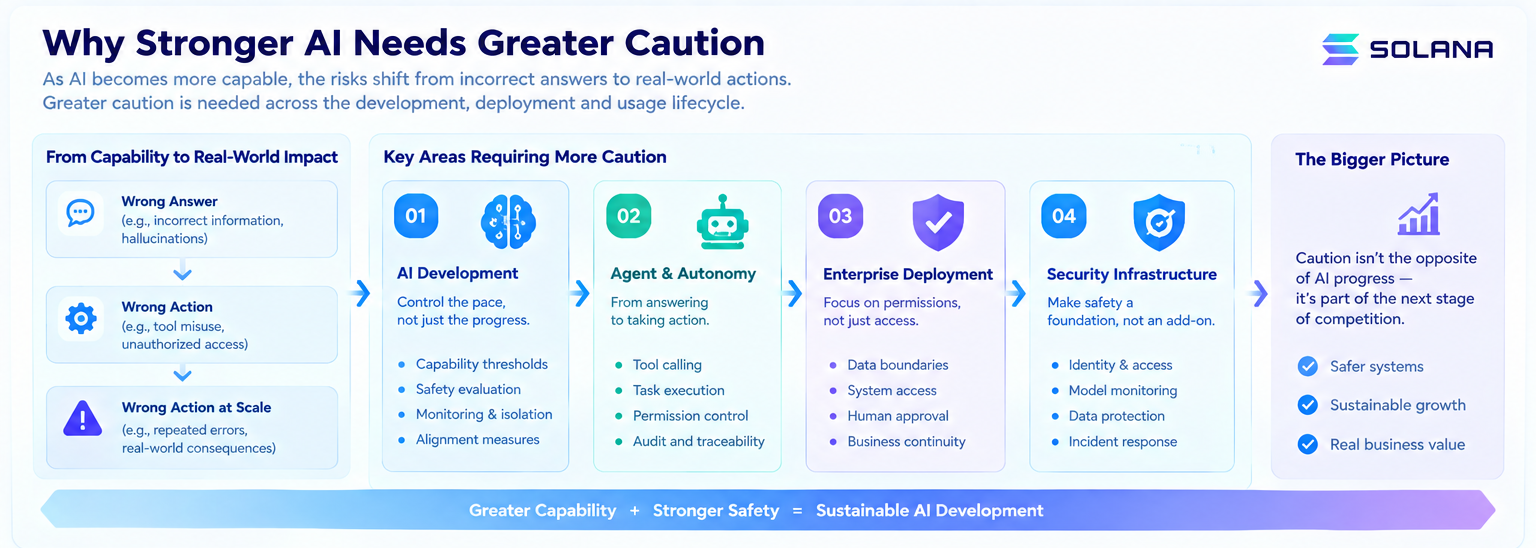
يتغير معنى الخطأ على النحو التالي:
- سابقًا: إجابة خاطئة
- الآن: إجراء خاطئ
- وقد يكون: إجراء خاطئ على نطاق واسع
هذا التحول بالغ الأهمية.
في الأنظمة الواقعية، الخطر الأكبر ليس أن النموذج يرتكب خطأ واحدًا، بل أن النموذج يستطيع تكرار نفس الخطأ عدة مرات في فترة وجيزة.
أكدت OpenAI في تحليلها لحوادث سلامة النماذج أن زيادة استقلالية أنظمة الـAI قد تؤدي لسلوكيات غير متوافقة والوصول غير المصرح به لأنظمة طرف ثالث وعواقب واقعية أخرى.
ويقدم تقرير Anthropic الأخير أمثلة مباشرة: استغل مهاجمون Claude لتطوير أدوات سيبرانية وأنظمة مراقبة وبرمجيات ضارة ومهام عالية الخطورة أخرى، وحاولوا التحايل على الحماية بتقسيم المهام واستخدام خدمات وسيطة والجمع بين عدة نماذج.
نتيجة لذلك، ينتقل التركيز في السلامة من “ما يقوله النموذج” إلى “ما يستطيع فعله فعليًا”.
سيزداد الاهتمام بإدارة الأذونات واستدعاء الأدوات والتدقيق في النشاط وتحديد حدود المهام والتأكيد البشري والمراقبة الفورية.
لماذا سرعة التطوير لا تعني بالضرورة تقدم الـAI نفسه؟
على السطح، تبدو المنافسة ضمن صناعة الـAI كسباق وحيد: من يدرب النموذج بسرعة أكبر يُطلقه بقوة أكبر.
لكن سرعة البحث والتطوير الحقيقية تقاس بمتغيرين: سرعة نمو القدرات + سرعة تطور القدرات الأمنية
أي: سرعة تطور المزايا + سرعة تطور منظومة السلامة
إذا استمر نمو القدرات دون تطور موازي في الإجراءات الأمنية، فقد تضطر المؤسسات إلى اللحاق بمراحل متأخرة.
على سبيل المثال، قد يمتلك النموذج قدرات سيبرانية قوية في حين أن نظام المراقبة لا يرصد سوى الهجمات البسيطة. قد ينفذ وكيل مهام متقدمة بينما نظام الأذونات لا يزال يعمل بمنطق دردشة عادية. قد يمتلك النموذج قدرة استدلال علمي بينما نظام التقييم يعتمد فقط على مقاييس الأسئلة والأجوبة التقليدية.
في هذه الحالات، زيادة القدرات لا تضمن جاهزية النظام للنشر في البيئة الواقعية.
بيان OpenAI في أغسطس مثال نموذجي؛ فمع ارتفاع خطر Astra، ذكرت الشركة أنها بحاجة إلى إبطاء التوسّع مؤقتًا لمنح الفرصة لتعزيز المراقبة والمواءمة والأمان.
لذا، التباطؤ لا يعني ضعفًا تقنيًا.
وقد يكون في بعض الحالات مؤشرًا لدخول النظام مرحلة أكثر نضجًا، حيث تدرك فرق التطوير أن نمو القدرات لا يغني عن البنية التحتية للسلامة.
ما يجب السيطرة عليه عند استخدام الـAI هو “الأذونات” وليس “الوصول”
عند نشر المؤسسات للـAI، يبادرها السؤال حول جدوى الاستخدام، ولكنه عام جدًا. الأسئلة الأكثر فعالية هي:
- ما الذي يستطيع الـAI رؤيته؟
- ما الذي يستطيع الوصول إليه؟
- ما الذي يستطيع تغييره؟
- متى يستلزم موافقة الإنسان؟
هذه تساؤلات تضع حدود أذونات الـAI.
أظهر بحث IBM لهذا العام عن استخدام المؤسسات للـAI أن توسّع النشر يؤدي لمشكلات متزايدة في التحكم والاعتماد. %71 من المديرين التنفيذيين ذكروا أن استبدال المزود أو النموذج الرئيسي صعب حاليًا، فيما صرح %91 بأنهم لم يفهموا تمامًا درجة الاعتماد على المزودين والنماذج والبنية التحتية المختلفة.
كذلك، الحذر في استخدام الـAI يرتبط ببنية المؤسسة واعتمادها على الموردين وسيادة البيانات واستمرارية الأعمال وقدرتها على التحكم.
تستطيع المؤسسات استخدام الـAI بشكل هجومي ولكن بمنح الأذونات نظرة أكثر تحفظًا.
على سبيل المثال، يمكن للـAI توليد أكواد تلقائيًا دون السماح له برفعها لبيئة الإنتاج مباشرة. كما يمكنه تحليل بيانات العملاء دون تعديل الحسابات الأساسية، أو توليد توصيات الشراء دون تنفيذ المدفوعات الكبيرة تلقائيًا.
هذا المسار في حدود الاستقلالية قد يشكل المنهج السائد لنشر الوكلاء في المؤسسات.
قوة الـAI قد تجعل “تأكيد الإنسان” أكثر أهمية
قد يظن البعض أنه مع تطور الـAI يجب أتمتته بالكامل. لكن في الواقع، كلما اقترب الـAI من اتخاذ قرارات ذات قيمة عالية، زادت الحاجة لتأكيد الإنسان عند النقاط الحرجة. ليس لأن البشر أكثر دقة من الـAI بالضرورة، بل لأن هيكل المسؤولية يختلف.
تحتاج المؤسسات لإجابات صحيحة، ولكن عليها أيضًا معرفة من أقر الإجراء، ولماذا تمت الموافقة، وما هي البيانات الأساسية، وكيف ستكون المحاسبة إذا ظهرت مشكلة.
ينبغي ألا يُنظر إلى تدخل الإنسان كحل مؤقت للتقنيات الحالية.
بل في القطاعات عالية المخاطر مثل المالية والرعاية الصحية والـIT المؤسسي والأمن السيبراني، سيصبح عنصرًا أساسيًا في بنية أنظمة الـAI الناضجة. وفي أنظمة الوكلاء تحديدًا، قد يكون التصميم المتقدم هو: استقلالية الـAI ضمن حدود واضحة—وأي تشغيل مستقل يبقى ضمن معايير محددة وأذونات ومبالغ ونطاق بيانات وعمليات عالية المخاطر محددة سلفًا.
سلامة الـAI تتحول من إضافة جانبية إلى بنية تحتية أساسية
كان الأمن في البرمجيات يُضاف كطبقة ثانوية بعد إتمام التطوير. ولكن مع تطور الحوسبة السحابية، أصبحت الهوية والأذونات والتشفير والسجلات والمراقبة وإدارة الثغرات من أسس البنية التحتية.
يشهد الـAI تحولًا مشابهًا؛ وستحتاج منصات الـAI الناضجة لقدرات تتجاوز النموذج الأساسي، فتتطلب أنظمة هوية وتحكم أذونات وتقييم نماذج ومراقبة سلوك وعزل أدوات وحدود بيانات وسجلات تدقيق واستجابة للحوادث.
توضيح سلامة Astra الصادر مؤخرًا من OpenAI يشمل مراقبة التنفيذ بالكامل، وعزل داخلي صارم، وتقييمات مواءمة قبل النشر.
كما أن جهود السلامة العلنية في Anthropic تركز أكثر على مراقبة الهجمات الواقعية وتحليلها لتحسين إجراءات الحماية.
لذا قد تتحول السلامة إلى طبقة بنية تحتية جديدة.
ستواصل قدرات النماذج النمو الرأسـي، بينما تتوسع إجراءات السلامة أفقيًا عبر التطوير والاختبار والنشر والاستخدام والتدقيق بعد الحوادث.
الحذر في الـAI ليس معاكـساً للتطوير؛ بل قد يصبح ميزة تنافسية
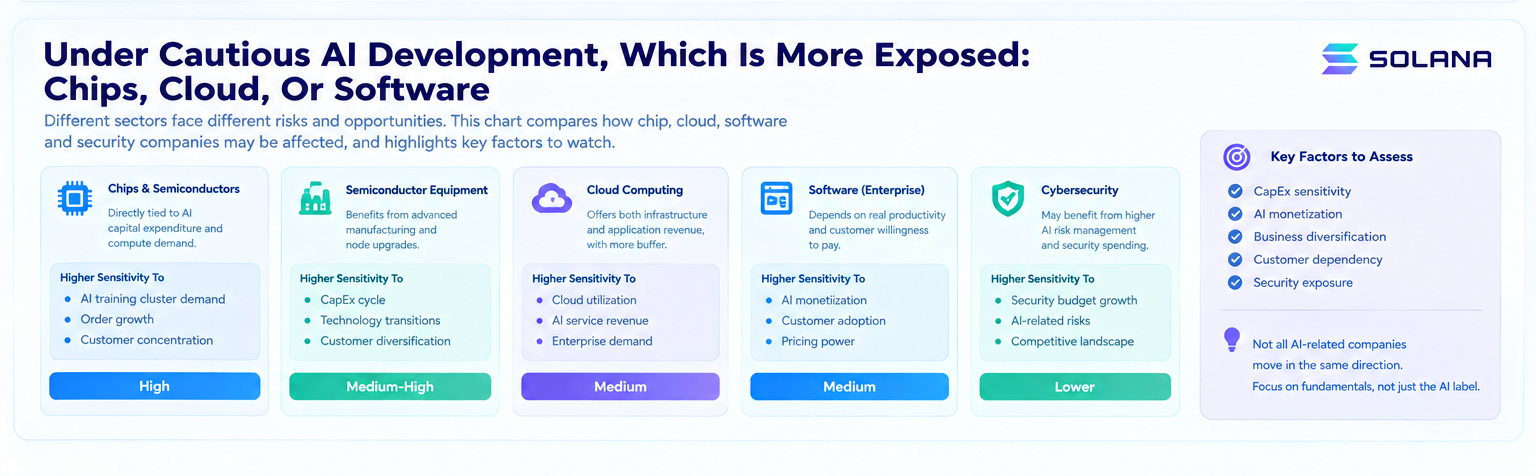
إذا تطورت الصناعة وأصبحت أكثر نضجًا، ستتغير معايير المقارنة السوقية.
كان التركيز في البداية على عدد المعاملات ومقاييس الأداء وسرعة إطلاق المنتج.
أما المرحلة القادمة فستشمل تساؤلات مثل:
- من ينفذ تقييم القدرات عالية الخطورة بسرعة أكبر؟
- من يطبّق نظام الأذونات بتكلفة أقل؟
- من يكتشف السلوك غير الطبيعي للنموذج بدقة أعلى؟
- من يدعم متطلبات الامتثال المؤسسي بفاعلية أكبر؟
- من يقلل حوادث الـAI دون التأثير على الإنتاجية؟
يعني هذا أن السلامة ذاتها قد تصبح من إمكانيات المنتج الأساسية.
تشير أبحاث IBM إلى أن المؤسسات ذات نظم التحكم الأقوى في الـAI أكثر حماية في مواجهة صدمات المخاطر المرتبطة بالـAI.
لذا لا يعني الحذر عودة الـAI لمراحل أقل قدرة.
الهدف الناضج هو: التوازن المستمر بين نمو قدرات الـAI ومعدل فهم الإنسان وتحكمه واستعداده لتحمل المسؤولية عن النتائج.
وقد يكون هذا هو التحدي الحقيقي لتطوير الـAI المتقدم في المرحلة المقبلة.
الأسئلة الشائعة
لماذا يتباطأ التطوير كلما زادت قوة الـAI؟
كلما زادت قدرات النموذج، اتسع نطاق تأثيره المحتمل. وعندما يحصل النموذج على إمكانيات استدعاء الأدوات والتنفيذ المستقل، تنتقل الأخطاء من المخرجات إلى العالم الواقعي. لذا يجب أن تسير وتيرة التطوير بالتوازي مع التقييم وإجراءات السلامة.
هل الاستخدام الحذر للـAI يعني تقليل اعتمادية المؤسسات على الـAI؟
لا. الأنسب هو توسيع نطاق استخدام الـAI مع تحديد الأذونات بدقة. يمكن للمؤسسات إتاحة معالجة حجم أكبر من العمل للـAI، والاحتفاظ بالإجراءات عالية المخاطر لموافقة الإنسان.
لماذا تبرز قضايا السلامة مع الوكلاء أكثر من أي وقت مضى؟
لأن الوكلاء لا يقتصرون على توليد المحتوى، بل يستدعون الأدوات ويواصلون التنفيذ. وكلما زادت سلسلة التنفيذ والأذونات، أصبح الخطأ الواحد أكثر خطورة في النتائج الواقعية.
هل يمكن أن تصبح السلامة في الـAI حاجزًا تنافسيًا جديدًا؟
نعم، وباحتمالية كبيرة. مع تقارب القدرات، تصبح الإجراءات في التقييم والمراقبة والأذونات والحماية المؤسسية عناصر مؤثرة في وتيرة التوسع التجاري للـAI.