


torygreen

用戶暫無簡介
AI 使用量的成長速度能否持續快於智慧成本下降的速度?
@AnthropicAI 的 IPO 估值可能達到約 1.5 萬億美元;與此同時,Ramp 的代幣用量一個月成長 37%,支出僅增加 9%,而 OpenAI + Anthropic 的混合定價下跌近 27%。
與此同時,像 DeepSeek 這樣的開放權重模型,在編碼和其他任務上已達到前沿水準,成本卻只占極小一部分。
Anthropic 在這一切發展中仍持續成長,令人印象深刻。但其營收有 79% 與使用量掛鉤,且未來運算承諾近 $895B ,使用量成長與價格壓縮之間的落差,在 IPO 後或許非常值得關注。
@AnthropicAI 的 IPO 估值可能達到約 1.5 萬億美元;與此同時,Ramp 的代幣用量一個月成長 37%,支出僅增加 9%,而 OpenAI + Anthropic 的混合定價下跌近 27%。
與此同時,像 DeepSeek 這樣的開放權重模型,在編碼和其他任務上已達到前沿水準,成本卻只占極小一部分。
Anthropic 在這一切發展中仍持續成長,令人印象深刻。但其營收有 79% 與使用量掛鉤,且未來運算承諾近 $895B ,使用量成長與價格壓縮之間的落差,在 IPO 後或許非常值得關注。
本週 45 項地方資料中心公投案中,有 44 項投票支持限制。
而一些 AI 擴建規模最大的州,政局剛剛易手:
德州選出 Gina Hinojosa。她表示,在保障措施到位之前,應暫停新資料中心的開發。德州單獨就約占美國規劃容量的 25%。
喬治亞州選出 Keisha Lance Bottoms,她在競選期間主張暫停新資料中心。亞特蘭大目前約有 2.9 GW 正在興建,是北美規模最大的建設案管線。
俄亥俄州選出 Amy Acton,她曾表示,專案在獲准前必須符合更嚴格的標準。俄亥俄州也有 21 項地方資料中心公投案。
Goldman 現在估計,可能實施更嚴格限制的州,約占美國規劃容量的 45%。UBS 認為,預計 2028 年新增容量中,約有 30% 可能受到影響。
選舉之夜並未讓運算需求消失。
但如今,數百 MW 的容量若具備電網接入、許可,且有社區願意接納,就成為價值高得多的資產。
而一些 AI 擴建規模最大的州,政局剛剛易手:
德州選出 Gina Hinojosa。她表示,在保障措施到位之前,應暫停新資料中心的開發。德州單獨就約占美國規劃容量的 25%。
喬治亞州選出 Keisha Lance Bottoms,她在競選期間主張暫停新資料中心。亞特蘭大目前約有 2.9 GW 正在興建,是北美規模最大的建設案管線。
俄亥俄州選出 Amy Acton,她曾表示,專案在獲准前必須符合更嚴格的標準。俄亥俄州也有 21 項地方資料中心公投案。
Goldman 現在估計,可能實施更嚴格限制的州,約占美國規劃容量的 45%。UBS 認為,預計 2028 年新增容量中,約有 30% 可能受到影響。
選舉之夜並未讓運算需求消失。
但如今,數百 MW 的容量若具備電網接入、許可,且有社區願意接納,就成為價值高得多的資產。

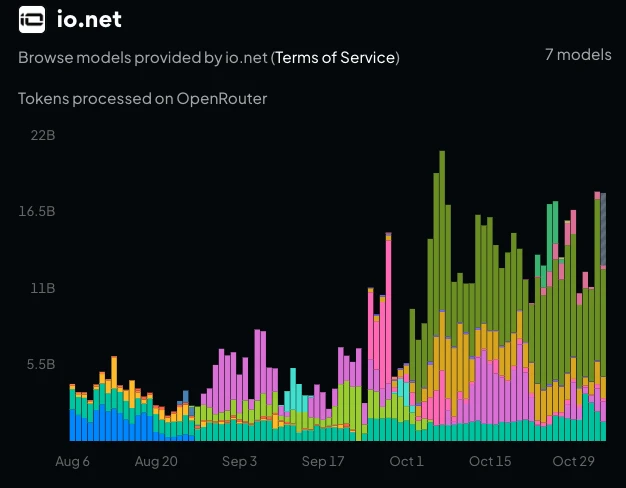
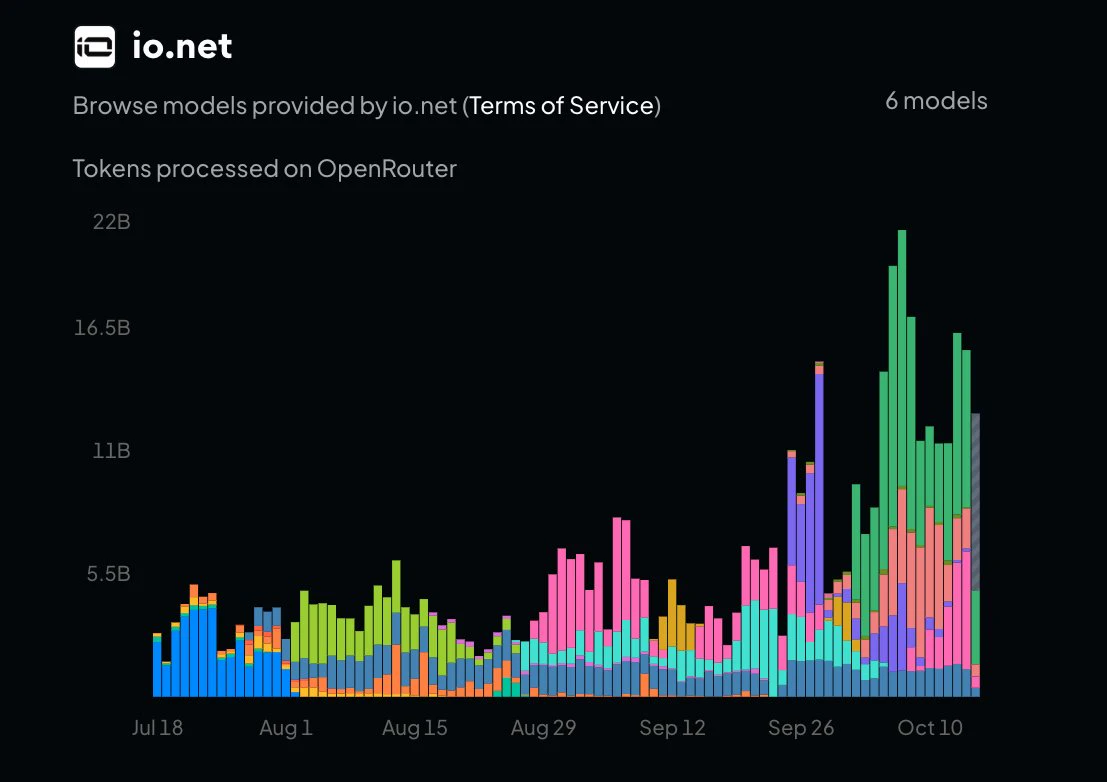
.@ionet 10 月透過 OpenRouter 處理了約 4,160 億個 tokens。
在分散式 GPU 網路中維持每日約 134 億個 tokens 的處理量,正是架構開始真正接受考驗的時候。
在不同硬體間進行路由、維持可預測的延遲,以及讓使用者察覺不到故障,在流量如此穩定時都重要得多。
整體而言,這是 ionet 非常出色的一個月,也讓人一窺網路規模大幅擴大後可能呈現的樣貌。
在分散式 GPU 網路中維持每日約 134 億個 tokens 的處理量,正是架構開始真正接受考驗的時候。
在不同硬體間進行路由、維持可預測的延遲,以及讓使用者察覺不到故障,在流量如此穩定時都重要得多。
整體而言,這是 ionet 非常出色的一個月,也讓人一窺網路規模大幅擴大後可能呈現的樣貌。
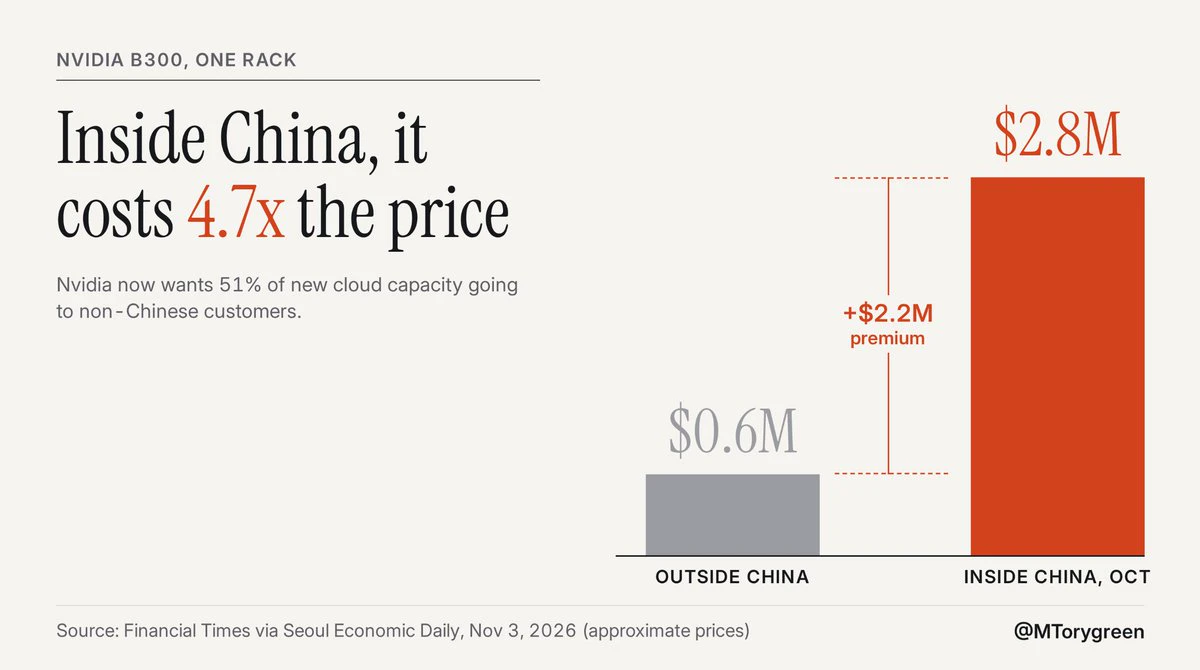
同一款 B300 機架:中國境外約 $600k ,中國境內約 280 萬美元。難怪中國實驗室只租用海外算力。
現在 Nvidia 告訴雲端業者,至少 51% 的新增容量必須提供給非中國客戶(透過 FT)。既有交易不受影響。
我比較擔心的是那些全部需求都來自中國實驗室的亞洲新興雲端業者。一家新加坡業者已表示,在美國以外很難找到非中國買家。如果他們無法讓那些機架重新滿租,就會有大量 GPU 同時尋找租戶,而我預期該地區的租用價格會崩跌。
現在正是進場購買亞洲算力的好時機。
現在 Nvidia 告訴雲端業者,至少 51% 的新增容量必須提供給非中國客戶(透過 FT)。既有交易不受影響。
我比較擔心的是那些全部需求都來自中國實驗室的亞洲新興雲端業者。一家新加坡業者已表示,在美國以外很難找到非中國買家。如果他們無法讓那些機架重新滿租,就會有大量 GPU 同時尋找租戶,而我預期該地區的租用價格會崩跌。
現在正是進場購買亞洲算力的好時機。
NVDA+2.80%
- 7
- 2
同一個模型。同樣的任務。少用 88% 的 token。
研究人員以 DeepSeek Harness 重建循環後,每項 HumanEval 任務的 token 用量從 9.6 萬降至 1.16 萬。解決的任務也更多,從 71% 升至 86%。
智慧代理消耗的許多 token,都花在每次工具呼叫後,循環重新思考已經處理妥當的工作。減少這部分浪費,費用就會下降約 8 倍,而且無需改動模型權重。
如果你根據目前每項任務的 token 用量來預測推論需求,那個數字有很大一部分其實只是執行框架效率低落造成的。而執行框架每個月都會被重寫。
研究人員以 DeepSeek Harness 重建循環後,每項 HumanEval 任務的 token 用量從 9.6 萬降至 1.16 萬。解決的任務也更多,從 71% 升至 86%。
智慧代理消耗的許多 token,都花在每次工具呼叫後,循環重新思考已經處理妥當的工作。減少這部分浪費,費用就會下降約 8 倍,而且無需改動模型權重。
如果你根據目前每項任務的 token 用量來預測推論需求,那個數字有很大一部分其實只是執行框架效率低落造成的。而執行框架每個月都會被重寫。
DEEPSEEK-2.21%
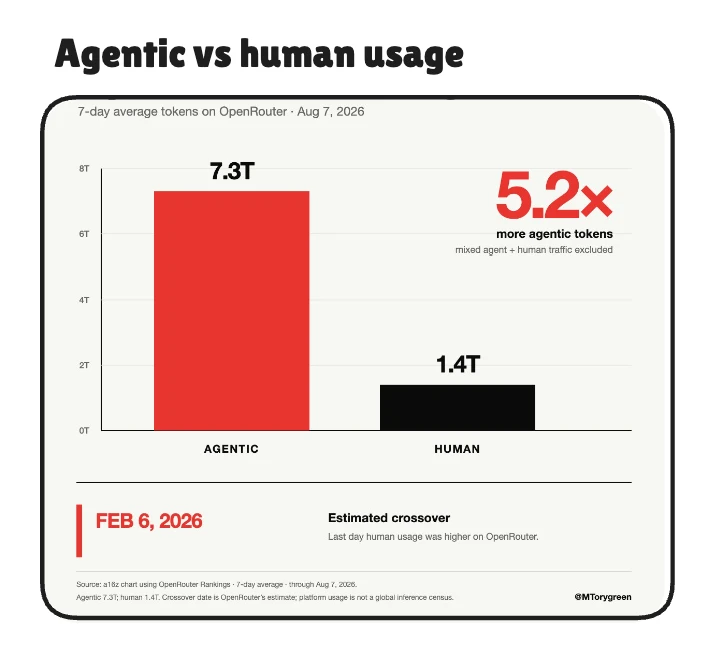
據說,2 月 6 日是人類消耗的 token 數量超過代理程式的最後一天,@OpenRouter。
每週用量從 2025 年 1 月的 0.5 萬億個 token,增加到 2026 年 9 月的 128.4 萬億個。20 個月內成長約 250 倍。
我認為,這項最初的數據比大多數 AI 使用者成長圖表重要得多。
人類一天能使用 AI 的量有相當明確的上限。代理程式可以整夜執行、重試任務、呼叫其他代理程式,並以驚人的速度持續消耗算力。
一旦機器成為推論服務的主要客戶,AI 需求的上限看起來就會截然不同,而各個 AI 領域的經濟效益都會變得相當瘋狂。
每週用量從 2025 年 1 月的 0.5 萬億個 token,增加到 2026 年 9 月的 128.4 萬億個。20 個月內成長約 250 倍。
我認為,這項最初的數據比大多數 AI 使用者成長圖表重要得多。
人類一天能使用 AI 的量有相當明確的上限。代理程式可以整夜執行、重試任務、呼叫其他代理程式,並以驚人的速度持續消耗算力。
一旦機器成為推論服務的主要客戶,AI 需求的上限看起來就會截然不同,而各個 AI 領域的經濟效益都會變得相當瘋狂。
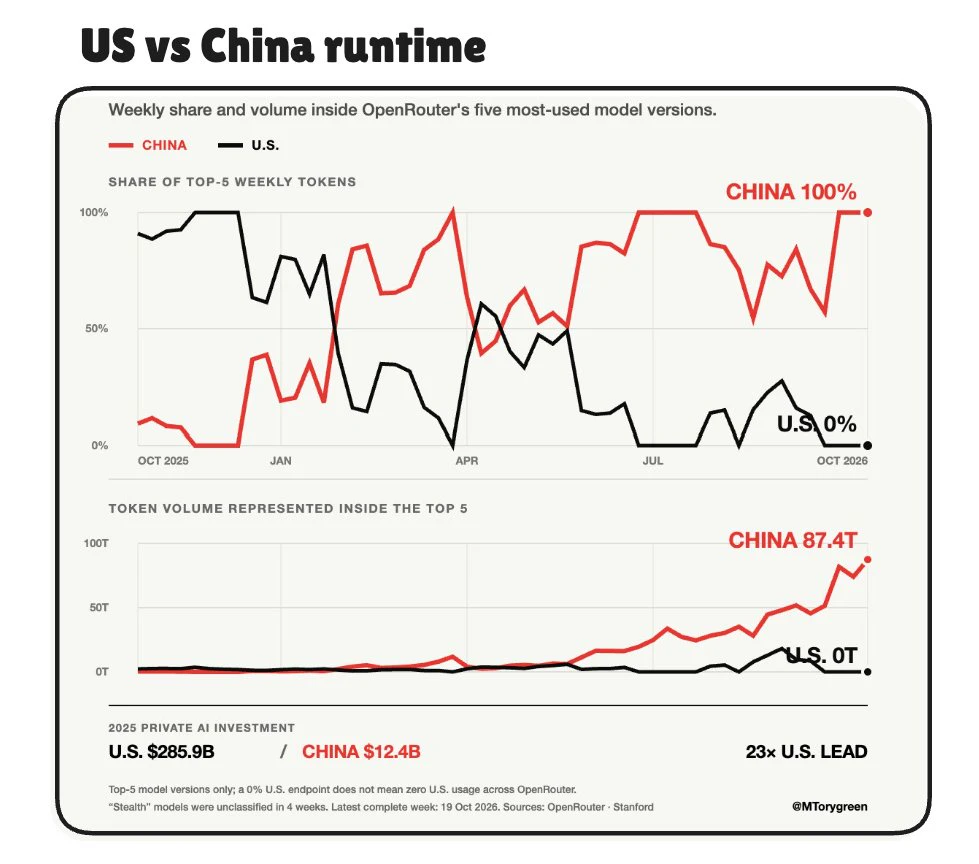
美國投入 AI 的私人資本約為中國的 23 倍。
與此同時,OpenRouter 上使用量最高的 5 個模型都是中國模型,處理了約 74 兆個 token。
這種落差相當驚人。
美國實驗室在資本競賽中勝出,但中國模型正透過開發者每天都會接觸的技術堆疊層面擴散:推論、代理程式、程式編寫工具,以及低成本 API 工作負載。
如果這種趨勢持續累積,中國就不必投入比美國更多的資金,也能取得影響力。它只需要讓自己的模型成為足夠多產品的底層支撐。
與此同時,OpenRouter 上使用量最高的 5 個模型都是中國模型,處理了約 74 兆個 token。
這種落差相當驚人。
美國實驗室在資本競賽中勝出,但中國模型正透過開發者每天都會接觸的技術堆疊層面擴散:推論、代理程式、程式編寫工具,以及低成本 API 工作負載。
如果這種趨勢持續累積,中國就不必投入比美國更多的資金,也能取得影響力。它只需要讓自己的模型成為足夠多產品的底層支撐。
- 1
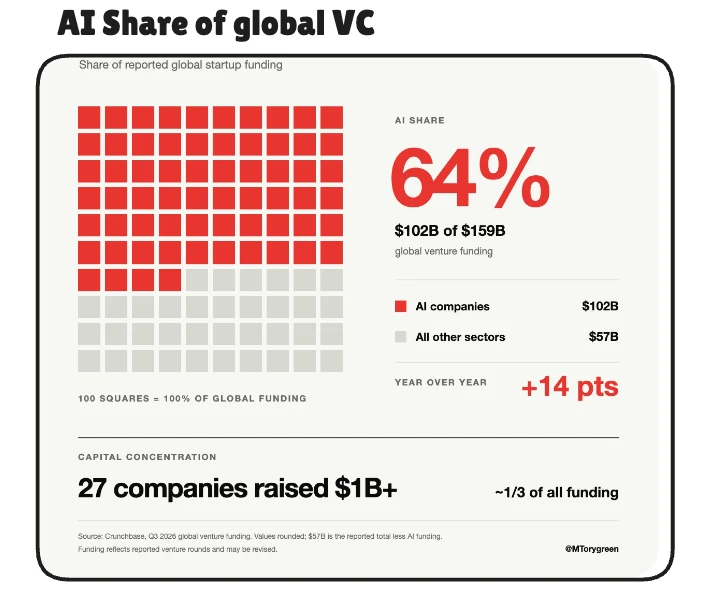
@OpenRouter 上代理程式使用的 token 幾乎有 90% 是快取讀取。
輸出與推理只占約 1%。
而代理程式使用的 API 金鑰消耗的 token 已經是人類操作的約 7 倍。
了解代理程式的實際運作方式後,這就說得通了。每個步驟都會讓系統提示、工具定義、檔案、先前的工具呼叫和對話狀態再次經過模型。
長時間運作的代理程式基本上會形成一個龐大的工作集,需要持續保持熱快取狀態。
供應商也在快速調整。代理程式流量的快取率中位數從 1 月的 44% 升至 9 月的 85%。
這可能讓快取區域性成為推論基礎設施中一項出乎意料的重要因素。
如果代理程式已有很大一部分脈絡在某處保持熱快取狀態,將下一個請求改送到稍微便宜一點的 GPU,實際成本可能反而高於讓它留在原處。
分散式 GPU 網路最終可能需要將狀態與運算一起路由:代理程式的脈絡目前存放在哪裡、快取有多熱,再加上價格與延遲。
有趣的是,代理程式經濟中有多少部分最終可能會是機器有效率地反覆讀取自身。
輸出與推理只占約 1%。
而代理程式使用的 API 金鑰消耗的 token 已經是人類操作的約 7 倍。
了解代理程式的實際運作方式後,這就說得通了。每個步驟都會讓系統提示、工具定義、檔案、先前的工具呼叫和對話狀態再次經過模型。
長時間運作的代理程式基本上會形成一個龐大的工作集,需要持續保持熱快取狀態。
供應商也在快速調整。代理程式流量的快取率中位數從 1 月的 44% 升至 9 月的 85%。
這可能讓快取區域性成為推論基礎設施中一項出乎意料的重要因素。
如果代理程式已有很大一部分脈絡在某處保持熱快取狀態,將下一個請求改送到稍微便宜一點的 GPU,實際成本可能反而高於讓它留在原處。
分散式 GPU 網路最終可能需要將狀態與運算一起路由:代理程式的脈絡目前存放在哪裡、快取有多熱,再加上價格與延遲。
有趣的是,代理程式經濟中有多少部分最終可能會是機器有效率地反覆讀取自身。
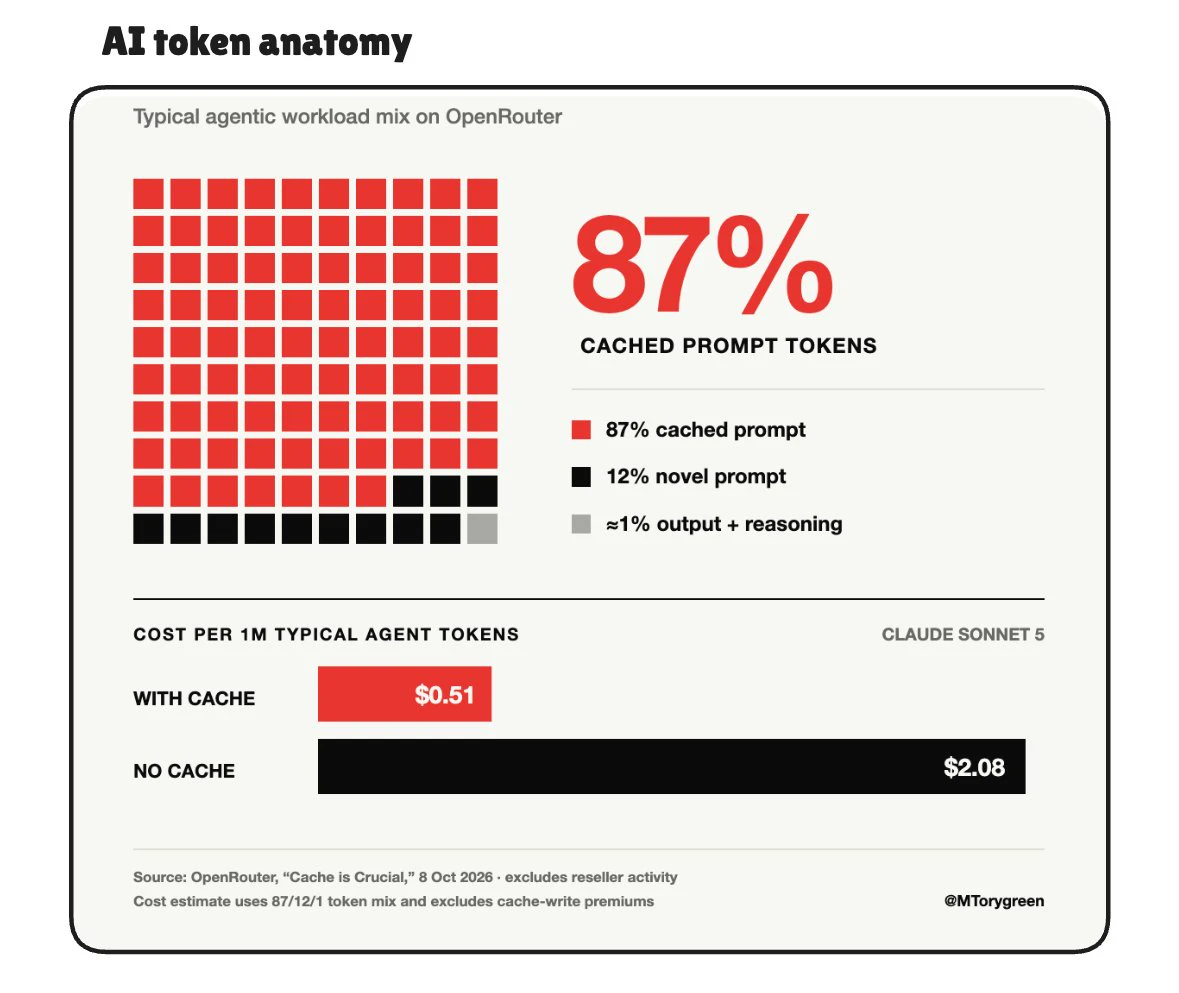
AI 在 Q3 拿下全球 64% 的創投資金。
$102B 總額為 1,590 億美元。
而不知為何,資金同時也變得更加集中。
27 家公司募集了 10 億美元以上的輪次,吸收了全球總融資額約 1/3。1 億美元以上的輪次占了後期融資近 90%。
前沿 AI 開始看起來不像一般的軟體創投,反而更像前期成本高得離譜的重工業。
運算資源、資料中心、訓練、人才 + 通路,都得在真正有人知道利潤率會穩定在哪裡之前先投入資金,這很瘋狂。
所以,即使 AI 新創公司還能增加數千家,實際上有能力在前沿水準訓練模型的公司數量卻持續減少。
我們現在所處的市場結構有點奇怪。
應用層變得更容易進入,但底下的前沿技術每季都變得更加資本密集。
到了這個階段,模型競爭既是資產負債表的較量,也是研究實力的較量。
$102B 總額為 1,590 億美元。
而不知為何,資金同時也變得更加集中。
27 家公司募集了 10 億美元以上的輪次,吸收了全球總融資額約 1/3。1 億美元以上的輪次占了後期融資近 90%。
前沿 AI 開始看起來不像一般的軟體創投,反而更像前期成本高得離譜的重工業。
運算資源、資料中心、訓練、人才 + 通路,都得在真正有人知道利潤率會穩定在哪裡之前先投入資金,這很瘋狂。
所以,即使 AI 新創公司還能增加數千家,實際上有能力在前沿水準訓練模型的公司數量卻持續減少。
我們現在所處的市場結構有點奇怪。
應用層變得更容易進入,但底下的前沿技術每季都變得更加資本密集。
到了這個階段,模型競爭既是資產負債表的較量,也是研究實力的較量。
AI 最終可能會迫使公司停止依賴口耳相傳的知識。
代理人無法繞過人類不知怎麼做到的那些事情:困在會議中的決策、存在某人腦中的優先事項,以及大家都知道但沒有人記錄下來的奇怪例外。
@AnthropicAI 已經開始碰到這個問題。他們每一名人類員工時數大約對應 6 個代理人時數,但這些代理人仍然把大部分互動時間花在等待人們身上。
員工正在建立固定指示、監控器、代理人審查員,甚至代理人幕僚長,只為了讓機器層與公司實際正在做的事情保持同步。
隨著代理人勞動增加,公司越來越多部分必須變得明確、有結構且可供機器讀取,才能讓所有人持續指向同一個現實。
這可能會在未來幾年大幅重塑管理方式。
清楚的所有權、乾淨的狀態、書面決策、更少的隱形交接。
組織本身開始針對機器同事進行最佳化。
代理人無法繞過人類不知怎麼做到的那些事情:困在會議中的決策、存在某人腦中的優先事項,以及大家都知道但沒有人記錄下來的奇怪例外。
@AnthropicAI 已經開始碰到這個問題。他們每一名人類員工時數大約對應 6 個代理人時數,但這些代理人仍然把大部分互動時間花在等待人們身上。
員工正在建立固定指示、監控器、代理人審查員,甚至代理人幕僚長,只為了讓機器層與公司實際正在做的事情保持同步。
隨著代理人勞動增加,公司越來越多部分必須變得明確、有結構且可供機器讀取,才能讓所有人持續指向同一個現實。
這可能會在未來幾年大幅重塑管理方式。
清楚的所有權、乾淨的狀態、書面決策、更少的隱形交接。
組織本身開始針對機器同事進行最佳化。
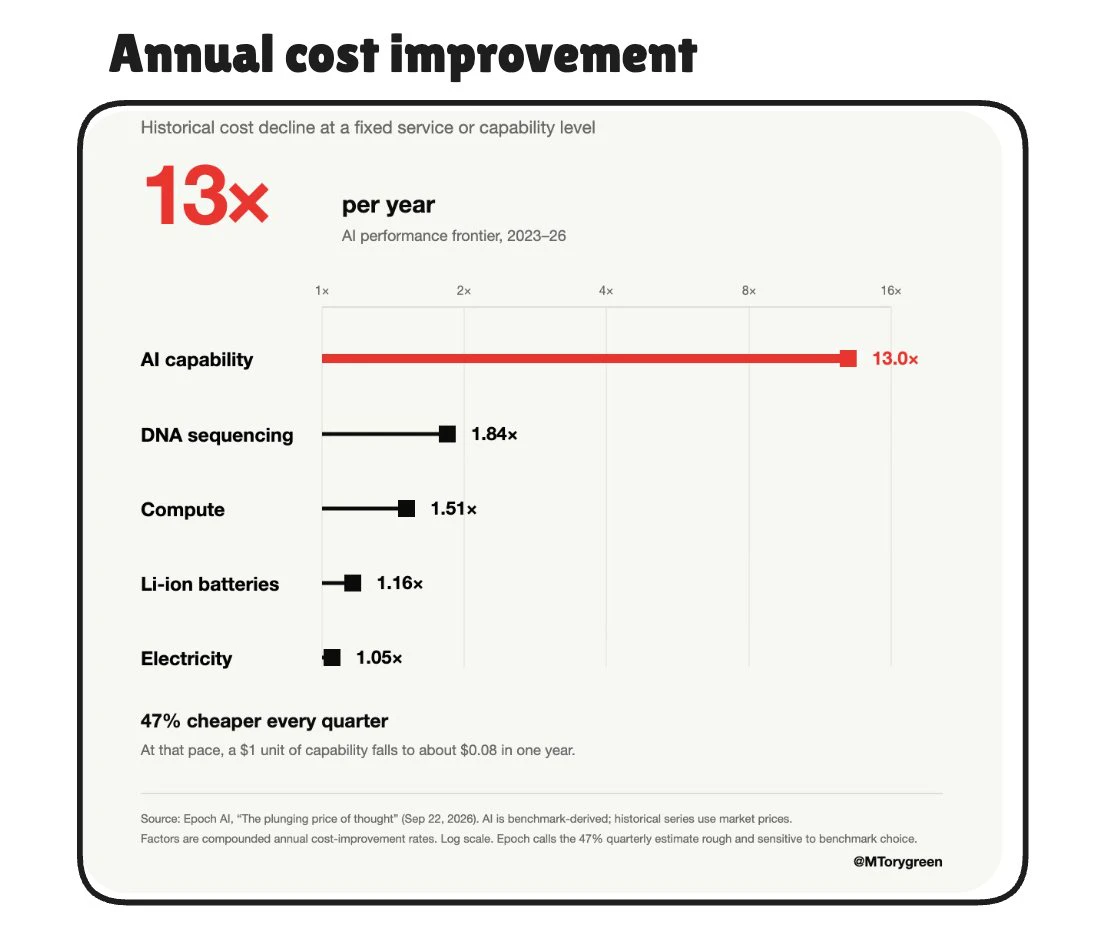
如今價值 1 美元的 AI 能力,如果目前的曲線持續下去,一年後將降至約 8 美分。
每季便宜 47% 意味著固定能力基本上每約 100 天就會變成半價。
其底層硬體的進展速度遠沒有那麼快。
自 2023 年以來,AI 晶片的效能/美元每年提升約 49%。經品質調整後的模型能力正變得便宜約 13x。
因此,大部分的成本壓縮都發生在矽晶片之上:更好的架構、訓練、量化、服務部署,以及殘酷的實驗室競爭。
而更便宜的智慧幾乎會立即被消耗。
@OpenRouter 曾在一段期間將 Luna 的定價下調約 90%,代幣交易量也跳升 13.8x。即使折扣結束後,仍有相當一部分使用者留了下來。
每次改進都會讓智慧變得更便宜,接著更低的價格又讓執行新的工作負載變得值得。
能力持續貶值,而需求卻持續擴張。
每季便宜 47% 意味著固定能力基本上每約 100 天就會變成半價。
其底層硬體的進展速度遠沒有那麼快。
自 2023 年以來,AI 晶片的效能/美元每年提升約 49%。經品質調整後的模型能力正變得便宜約 13x。
因此,大部分的成本壓縮都發生在矽晶片之上:更好的架構、訓練、量化、服務部署,以及殘酷的實驗室競爭。
而更便宜的智慧幾乎會立即被消耗。
@OpenRouter 曾在一段期間將 Luna 的定價下調約 90%,代幣交易量也跳升 13.8x。即使折扣結束後,仍有相當一部分使用者留了下來。
每次改進都會讓智慧變得更便宜,接著更低的價格又讓執行新的工作負載變得值得。
能力持續貶值,而需求卻持續擴張。
LUNA-2.88%
- 1
- 2
.@ionet 在 10 月前 13 天透過 @OpenRouter 已達到約 1650 億個 token。
這已經是我們 7 月全部成果的約 1.8 倍。
如果目前的速度維持不變,10 月的總量將約為 7 月的 4 倍。
老實說,這對我來說比 GPU 的原始數量更重要。
隨著稀疏模型變得更好、服務堆疊變得更精簡,每部署一個 GPU 所產生的有效輸出持續提升。因此,網路可以同時朝兩個方向成長:更多硬體上線,以及從現有硬體中榨取出更多工作量。
每個 GPU 所服務的 token 數量,是判斷網路本身是否真的在變得更好的絕佳指標。
這已經是我們 7 月全部成果的約 1.8 倍。
如果目前的速度維持不變,10 月的總量將約為 7 月的 4 倍。
老實說,這對我來說比 GPU 的原始數量更重要。
隨著稀疏模型變得更好、服務堆疊變得更精簡,每部署一個 GPU 所產生的有效輸出持續提升。因此,網路可以同時朝兩個方向成長:更多硬體上線,以及從現有硬體中榨取出更多工作量。
每個 GPU 所服務的 token 數量,是判斷網路本身是否真的在變得更好的絕佳指標。
- 1
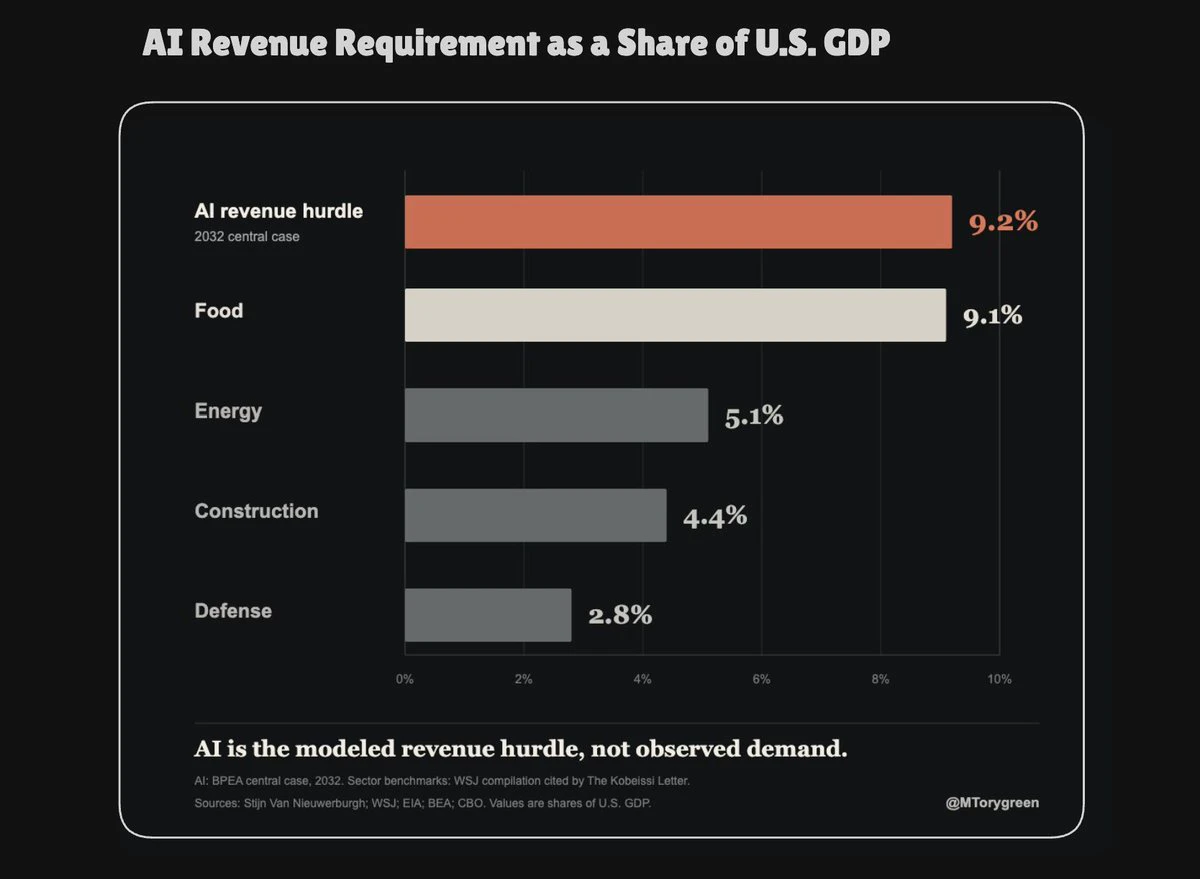
到 2032 年,目前的 AI 建設規模計算顯示,需要約 183 GW 的容量,在 80% 利用率下,每個計費 GPU 小時可賺取約 6.90 美元。
這是極其龐大的基礎設施規模,必須持續維持高使用率。
Van Nieuwerburgh 的核心情境假設資本基礎約為 9.6 萬億美元、未加槓桿報酬率為 10%、營運現金流利潤率為 50%,以及 IT 設備使用年限為六年。
在此設定下,該系統需要每年 3.725 萬億美元的營收,約占預計美國 GDP 的 9.2%。
調整這些假設後,這道門檻將介於 2.3 萬億美元至 6.7 萬億美元之間。
與此同時,模型的運行成本持續下降,推理堆疊持續改善,更多容量也持續上線。
因此,真正的問題不是 AI 需求是否會變得龐大。
它很可能會。
而是需求成長的速度是否足夠快,能讓約 183 GW 的容量維持高利用率,同時價格仍足以支撐約 9.6 萬億美元的資本結構。
AI 可以改變一切,而這項建設規模的部分環節最終仍可能呈現難看的經濟效益。
這是極其龐大的基礎設施規模,必須持續維持高使用率。
Van Nieuwerburgh 的核心情境假設資本基礎約為 9.6 萬億美元、未加槓桿報酬率為 10%、營運現金流利潤率為 50%,以及 IT 設備使用年限為六年。
在此設定下,該系統需要每年 3.725 萬億美元的營收,約占預計美國 GDP 的 9.2%。
調整這些假設後,這道門檻將介於 2.3 萬億美元至 6.7 萬億美元之間。
與此同時,模型的運行成本持續下降,推理堆疊持續改善,更多容量也持續上線。
因此,真正的問題不是 AI 需求是否會變得龐大。
它很可能會。
而是需求成長的速度是否足夠快,能讓約 183 GW 的容量維持高利用率,同時價格仍足以支撐約 9.6 萬億美元的資本結構。
AI 可以改變一切,而這項建設規模的部分環節最終仍可能呈現難看的經濟效益。
- 1
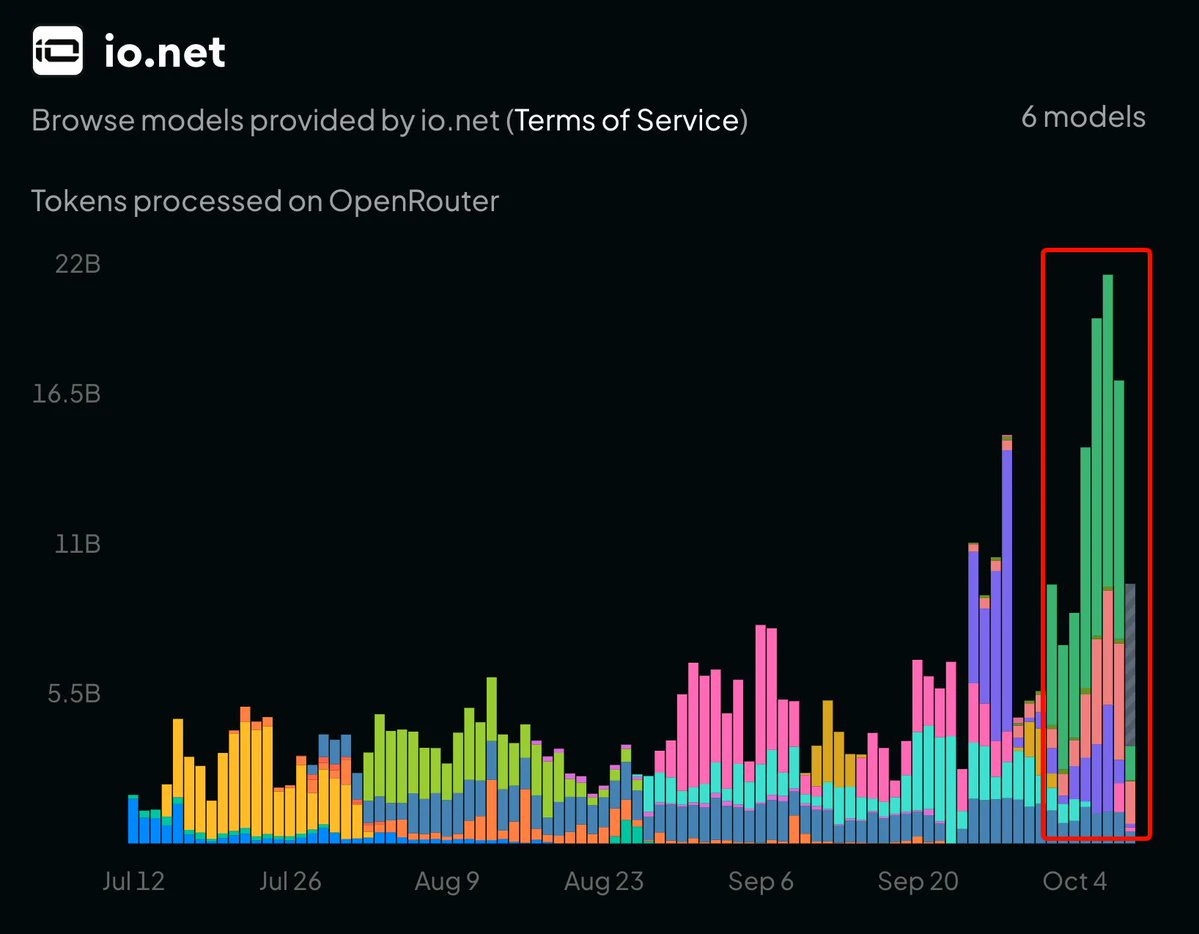
.@ionet 在十月第一週透過 @OpenRouter 處理的 token 幾乎與整個七月一樣多。
七月約 920 億個 token
10 月 1–7 日約 860 億個 token
僅 10 月 7 日就有 209 億個 token
同一批機器。
我最喜歡的是流量呈現的方式。
近期大量流量正流經 MiMo、Gemma 和 Nemotron 等稀疏模型,其中每個 token 只有一小部分模型會啟動。再加上更好的批次處理、快取、路由和服務基礎設施,同一組 GPU 機群的經濟效益會持續在底層發生變化。
對 @ionet 而言,等式兩邊都在持續改善:
推理需求正在快速成長,而每一項效率提升都能讓同一個 GPU 網路服務更多需求。
七月約 920 億個 token
10 月 1–7 日約 860 億個 token
僅 10 月 7 日就有 209 億個 token
同一批機器。
我最喜歡的是流量呈現的方式。
近期大量流量正流經 MiMo、Gemma 和 Nemotron 等稀疏模型,其中每個 token 只有一小部分模型會啟動。再加上更好的批次處理、快取、路由和服務基礎設施,同一組 GPU 機群的經濟效益會持續在底層發生變化。
對 @ionet 而言,等式兩邊都在持續改善:
推理需求正在快速成長,而每一項效率提升都能讓同一個 GPU 網路服務更多需求。
- 1
我們可能大幅低估了 AI 算力在經濟上持續具備效用的時間。
6 年前的 8x A100 系統目前仍能以 75 萬美元–85 萬美元售出,約為其原始 ~$199K 價格的 40%。AI 基礎設施貸款方顯然將殘值估計在接近 25%。
錯誤可能在於把舊 GPU 當成舊手機。
A100 不會在下一代產品上市後就變得毫無用處,供應商可以透過軟體更新將其降級使用。它只是被降級而已。
前沿訓練持續向前發展,而同一批算力會被重新投入推理、微調、批次工作和更便宜的區域容量。
Microsoft 使用 V100 達 8.4 年,而會計使用年限為 6 年。Sprout 在 13 個月內轉移了 11,664 顆 GPU。
開始看起來 GPU 似乎有相當長的職涯階梯,哈哈。
今天的前沿硬體會成為明天的廉價推理機群,而且很可能在那之後數年仍持續創造收益。
6 年前的 8x A100 系統目前仍能以 75 萬美元–85 萬美元售出,約為其原始 ~$199K 價格的 40%。AI 基礎設施貸款方顯然將殘值估計在接近 25%。
錯誤可能在於把舊 GPU 當成舊手機。
A100 不會在下一代產品上市後就變得毫無用處,供應商可以透過軟體更新將其降級使用。它只是被降級而已。
前沿訓練持續向前發展,而同一批算力會被重新投入推理、微調、批次工作和更便宜的區域容量。
Microsoft 使用 V100 達 8.4 年,而會計使用年限為 6 年。Sprout 在 13 個月內轉移了 11,664 顆 GPU。
開始看起來 GPU 似乎有相當長的職涯階梯,哈哈。
今天的前沿硬體會成為明天的廉價推理機群,而且很可能在那之後數年仍持續創造收益。
MSFT-0.95%
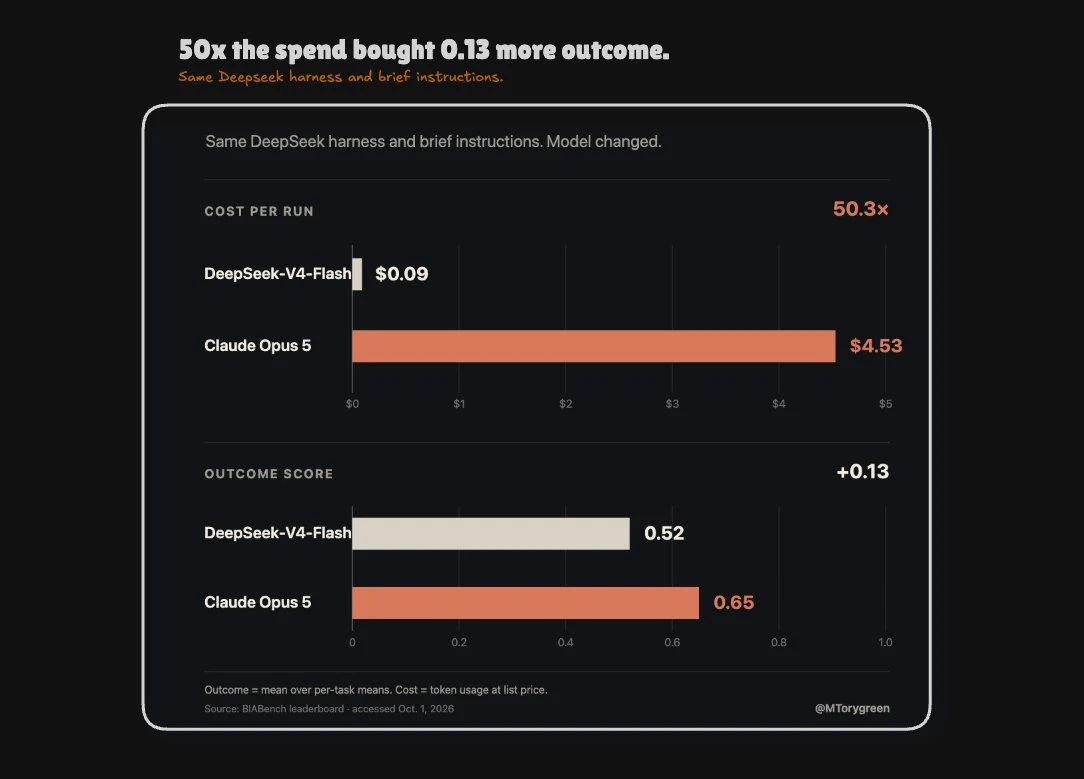
相同的 Deepseek 測試框架、相同的簡短指令,以及:
Deepseek-v4-flash 在 BIABench 上的分數為 0.52。
Claude Opus 5 得分 0.65。
因此,約 50 倍的支出只讓 16 個真實生物影像分析任務的分數多出 0.13。
而糟糕的尾端幾乎沒有改善。有些 3D + 時間序列任務在每個代理上都低於 0.19,而重跑相同模型所產生的差異,可能比完全更換模型還要大。
我可能會讓便宜模型處理例行性的大量工作,再將不確定的案例升級交由人類或專門工具處理。
而在科學領域,一個你仍然需要驗證的 4.53 美元答案,實際上就不算是一個 4.53 美元的答案。
Deepseek-v4-flash 在 BIABench 上的分數為 0.52。
Claude Opus 5 得分 0.65。
因此,約 50 倍的支出只讓 16 個真實生物影像分析任務的分數多出 0.13。
而糟糕的尾端幾乎沒有改善。有些 3D + 時間序列任務在每個代理上都低於 0.19,而重跑相同模型所產生的差異,可能比完全更換模型還要大。
我可能會讓便宜模型處理例行性的大量工作,再將不確定的案例升級交由人類或專門工具處理。
而在科學領域,一個你仍然需要驗證的 4.53 美元答案,實際上就不算是一個 4.53 美元的答案。
- 4
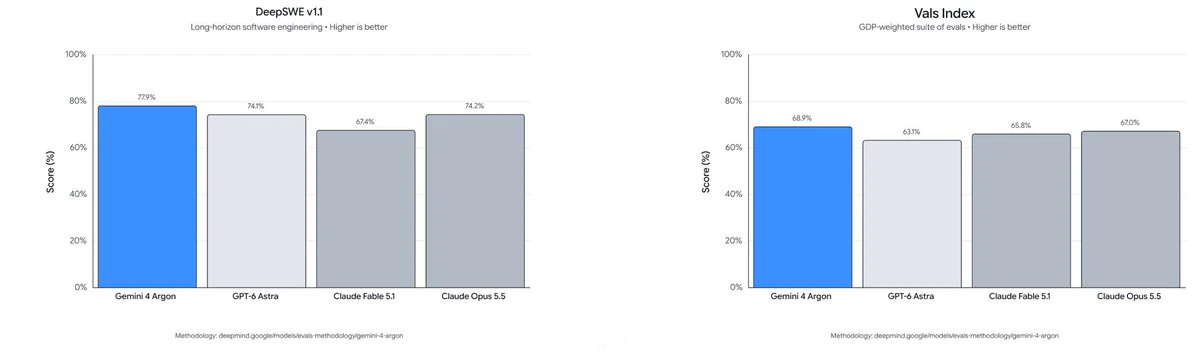
Google 相較於其他前沿實驗室,在 Argon 上擁有相當不公平的優勢
他們擁有 Argon 底層的 TPUs,並且可以直接將模型部署到目前每分鐘已處理約 220 億個 token 的 API 中。
這套配置相當令人印象深刻。
打造晶片 -> 訓練模型 -> 將其投入極其龐大的分發體系 -> 將收益回饋到下一次運行。
而且 Argon 已經在持續改善自身周邊的技術堆疊,透過將 +80 萬行 C/C++ 遷移至 Rust,釋放出 300+ TiB 的資料中心記憶體,並讓一套量子計算程序超越已發布的基準 40%。
每一代 Gemini 都能越來越多地繼承上一代協助最佳化的基礎設施
Argon 很可能是我們在西方前沿實驗室中見過的最佳、也是唯一的全端優勢版本。
他們擁有 Argon 底層的 TPUs,並且可以直接將模型部署到目前每分鐘已處理約 220 億個 token 的 API 中。
這套配置相當令人印象深刻。
打造晶片 -> 訓練模型 -> 將其投入極其龐大的分發體系 -> 將收益回饋到下一次運行。
而且 Argon 已經在持續改善自身周邊的技術堆疊,透過將 +80 萬行 C/C++ 遷移至 Rust,釋放出 300+ TiB 的資料中心記憶體,並讓一套量子計算程序超越已發布的基準 40%。
每一代 Gemini 都能越來越多地繼承上一代協助最佳化的基礎設施
Argon 很可能是我們在西方前沿實驗室中見過的最佳、也是唯一的全端優勢版本。
GOOGL+0.72%
載入更多
熱門話題
#美股AI板塊遭遇重挫
21.24k 瀏覽量3.67k 人討論中
#10月非農數據聚焦
34.98k 瀏覽量4.34k 人討論中
#質押Launchpool瓜分45萬VLX
10.25k 瀏覽量828 人討論中
#Gate首創資金安全證明PoSEC
33.47k 瀏覽量722 人討論中
#BTCETF資金持續流出
21.68k 瀏覽量1.43k 人討論中
#Gate安全衛士免費開通
188.4k 瀏覽量15.99k 人討論中
#AI科技股大跌加密市場承壓
351.12k 瀏覽量48.38k 人討論中
#Gate股票暢聊季
49.65k 瀏覽量4k 人討論中
#AI大跌後高盛仍看好數據中心
17.96k 瀏覽量5.9k 人討論中
#Gate社交年度主播與創作者評選
502.45k 瀏覽量24.29k 人討論中