


Stephan_

幣齡 3.6年
最高等級 0
用戶暫無簡介
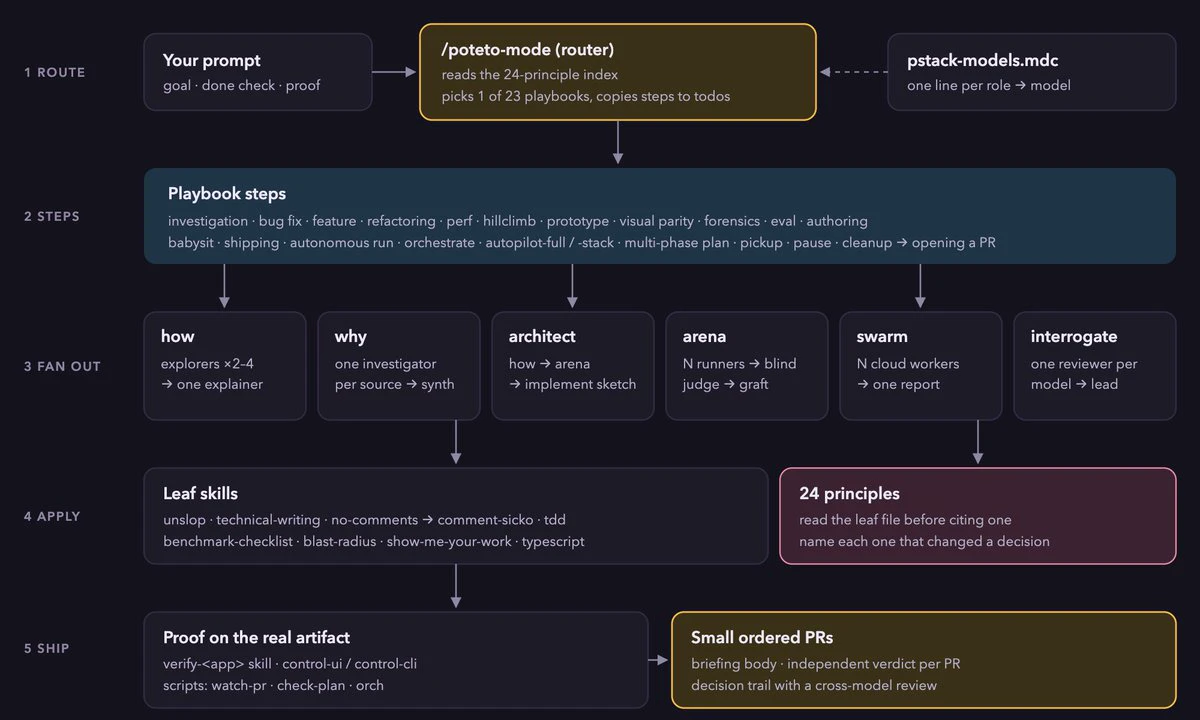
最近在系統學習 @poteto 的 pstack,確實超厲害!感覺豁然開朗了!
接下來我會邊學邊分享出來:
接下來我會邊學邊分享出來:
現在最划算的訂閱不是opencode-go
也不是 commandcode-goat
是 ChatGPT-plus 😂
也不是 commandcode-goat
是 ChatGPT-plus 😂
最近一直在思考一個問題:面向前沿模型編寫 skill,確定性和靈活性的平衡如何把握?
確定性指的是用更多硬約束或程式碼來編寫 skill
靈活性指的是更少的細節和約束,只從 high-level 和 prompt-driven 的角度來編寫 skill
這兩者之間需要一個動態平衡,不是唯一答案
起因是在比較 matt 寫的 /spec-implement 和我寫的 /pi-matt-implement-flow
我的流程和框架限定很多,好處是確定性強,agent 不容易跑偏。壞處也是確定性強,agent 自我發揮的空間不足😂
以前的模型還不夠聰明,所以我會更偏確定性強的方向
現在 Opus-5.5/GPT-6.1-sol 這個級別的模型就不一樣了,確定性太強似乎反而會限制他的發揮
你怎麼看?
- 1
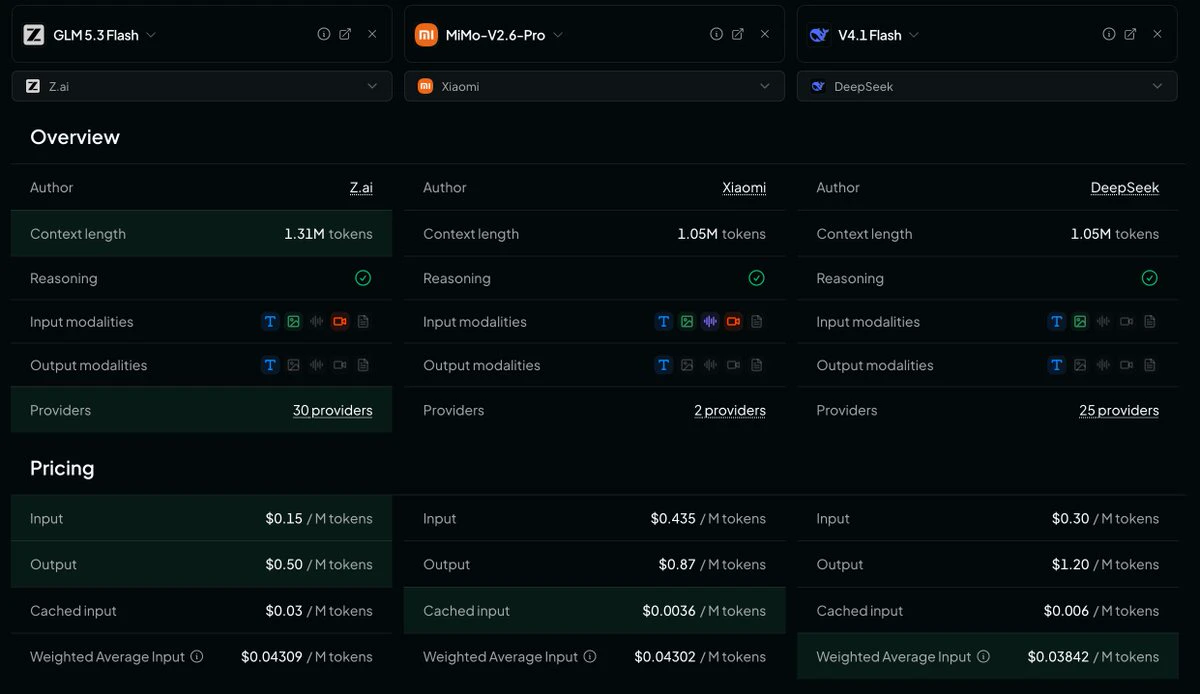
按照 OpenRouter 的實際 Weighted Average Input 來看,這三個模型的成本非常接近。所以如果從這三個中選一個作為主力模型的話,你會選哪個?
npm 官方倉庫掛了,就在我準備註冊 npm 官方倉庫並發包的時候 😤
- 3
最近的思考🤔:
研發更多的時間應該放在制定 eval 評估資料集和評估準確性及完備性上,然後透過建構 eval loop 驅動業務迭代
而不是直接 vibe coding 業務程式碼
理想情況下,透過合理的 goal + eval loop,業務程式碼應該可以自我迭代才對
正在嘗試做這方面的轉變,歡迎交流。
研發更多的時間應該放在制定 eval 評估資料集和評估準確性及完備性上,然後透過建構 eval loop 驅動業務迭代
而不是直接 vibe coding 業務程式碼
理想情況下,透過合理的 goal + eval loop,業務程式碼應該可以自我迭代才對
正在嘗試做這方面的轉變,歡迎交流。
為什麼很多AI測評跑分和自己的體感不太一樣?
我覺得關鍵是大部分測評都是發令槍一響,看誰跑得遠
至於跑到哪裡去不管,跑到天上去都行,整個測評過程不需要收斂
真實場景下,最磨人的是收斂和對齊的過程,跑得遠的不一定就好,能在跑道裡一直跑的才好。
我覺得關鍵是大部分測評都是發令槍一響,看誰跑得遠
至於跑到哪裡去不管,跑到天上去都行,整個測評過程不需要收斂
真實場景下,最磨人的是收斂和對齊的過程,跑得遠的不一定就好,能在跑道裡一直跑的才好。
- 2
用 grok 做了個自動化任務,統計 commandcode GOAT 中主流模型的額度和每月估算可呼叫次數(按呼叫次數排序),分享一下:

- 3
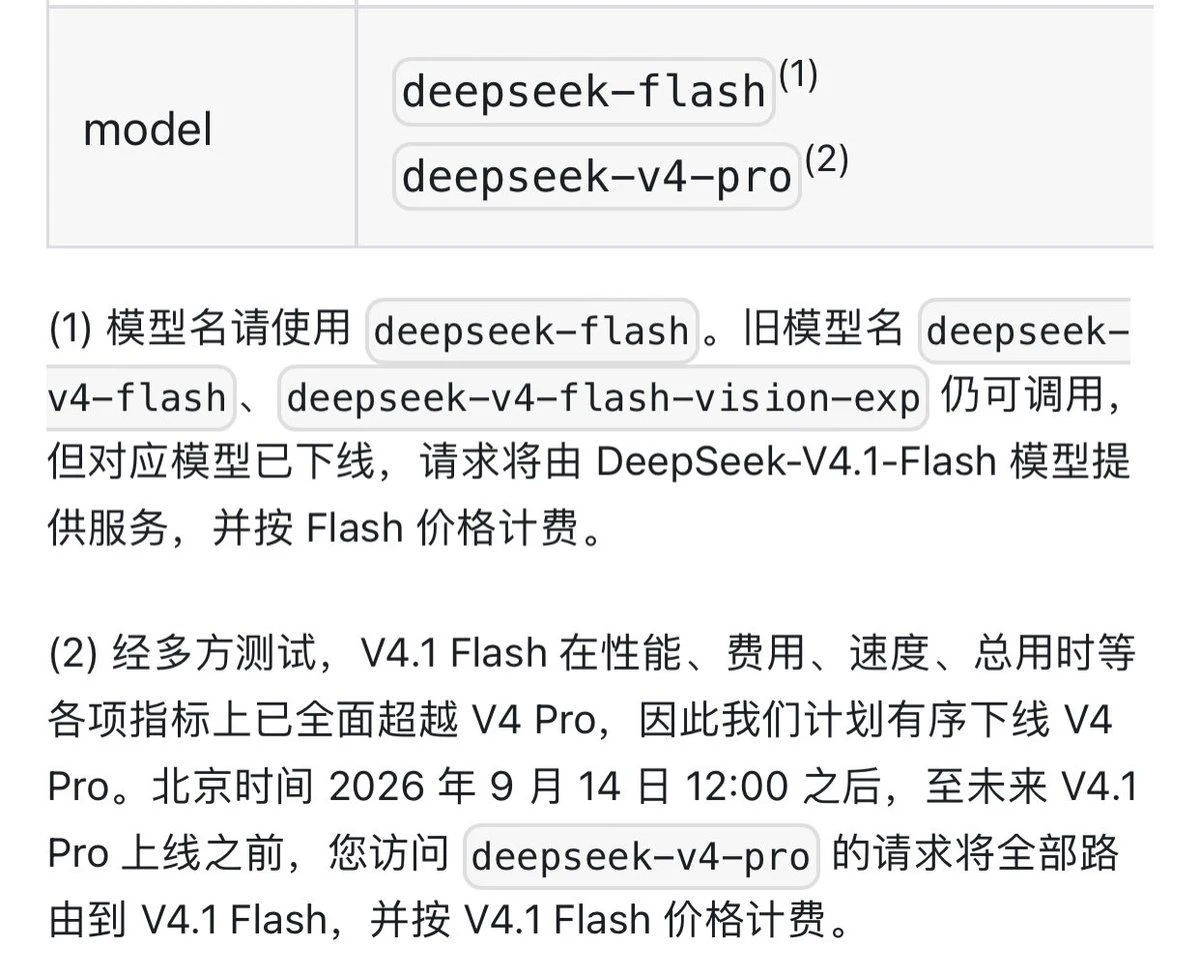
ds這是大一統了呀,全站只有一個模型😂
- 1
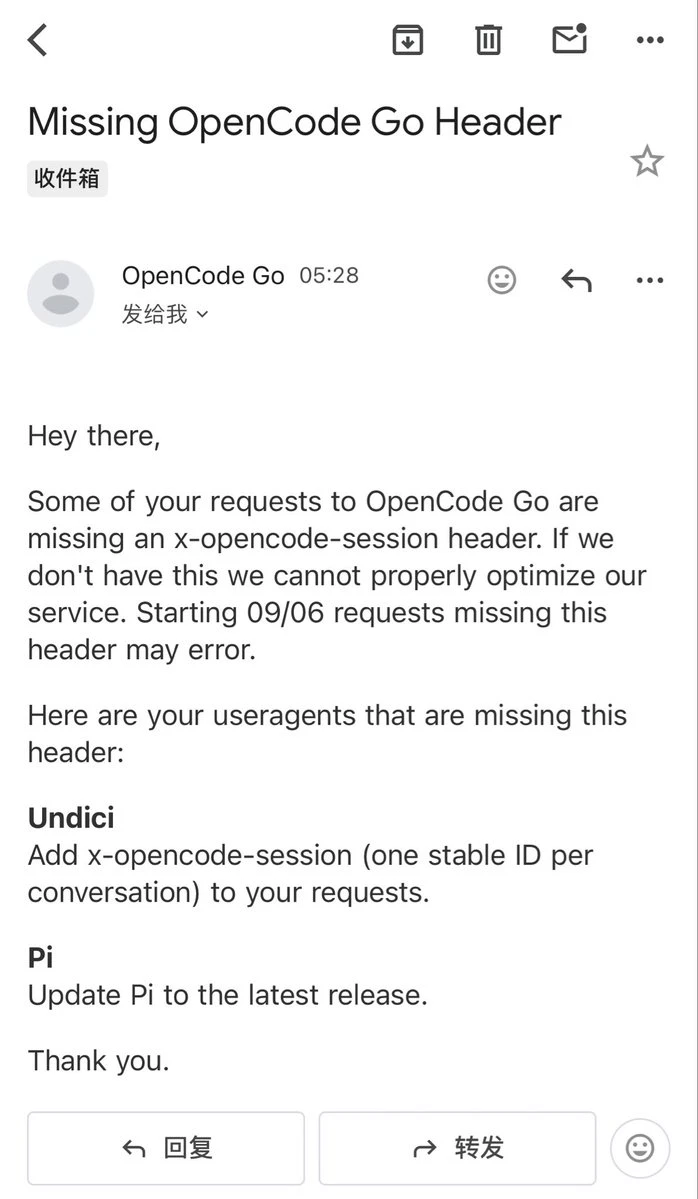
用 pi + opencode-go 訂閱有一段時間了,剛剛收到以下這封郵件
總感覺這事有點奇怪,一個 provider 給一個 harness 的客戶發郵件,要求盡快升級否則你就用不了我們啦😂
另外,這個 ua 為什麼不是 pi-agent 呢,Undici 是 pi 底層通訊用的 sdk 嗎?
總感覺這事有點奇怪,一個 provider 給一個 harness 的客戶發郵件,要求盡快升級否則你就用不了我們啦😂
另外,這個 ua 為什麼不是 pi-agent 呢,Undici 是 pi 底層通訊用的 sdk 嗎?
思考一個問題:有沒有一套框架,能把一個完整的 SaaS 服務範本 + AI harness + 自訂 skill 做成一個可插拔框架?
DeepSeek Harness 可能成為這樣的基礎設施嗎?有沒有其他已成形的專案?
DeepSeek Harness 可能成為這樣的基礎設施嗎?有沒有其他已成形的專案?
DEEPSEEK+7.30%
Matt Pocock 提到的 smart zone 是上下文長度約 12 萬,我用 grok-4.6 的體感也差不多,接近 20 萬左右時會出現明顯變笨的情況。不知道大家的體感如何?其他模型是否也有明顯的 smart zone?
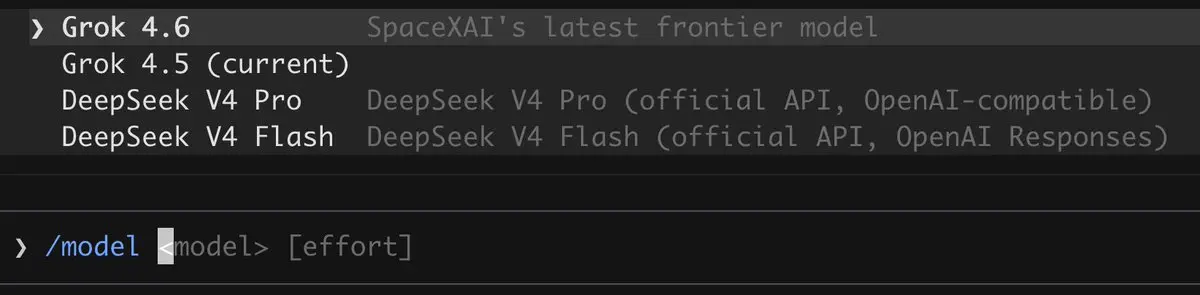
grok build 是我用過體驗最好的 TUI,現在搭配 grok-4.6 可以說是性價比之王了。主要是 grok 的速度比很多一線模型都快,品質能站到第一梯隊的話競爭力就太強了(而且隨便儲值也不封號)!
grok-4.6 & deepseek-v4-pro 一起發布了!
看完了老羅採訪周鴻禕的三個半小時的播客,能聽出來老周是確實有很多切實的行業經驗的,可惜老羅問的問題不夠深入和專業,有點遺憾
比如老羅說到海外頂尖模型是這個觀點,我覺得是有些偏頗了。因爲不同領域有不同的最佳模型,比如在編程領域目前claude-4和gpt-5-codex可能都優於;又比如老周不止一次提到的LLM幻覺問題,在360是如何優化的?並沒有追問下去
聽完整體感覺最有價值的點就是老周說到的垂直+訂閱的收費模式,老周還提到收費模式上應該是token按量計費+membership會員費的方式,這種方式確實是一種長期看更可行的收費模式。單純賣token的模式壁壘太低,用戶付費的動機應該是在LLM之上,產品提供的垂直Agent的能力
比如老羅說到海外頂尖模型是這個觀點,我覺得是有些偏頗了。因爲不同領域有不同的最佳模型,比如在編程領域目前claude-4和gpt-5-codex可能都優於;又比如老周不止一次提到的LLM幻覺問題,在360是如何優化的?並沒有追問下去
聽完整體感覺最有價值的點就是老周說到的垂直+訂閱的收費模式,老周還提到收費模式上應該是token按量計費+membership會員費的方式,這種方式確實是一種長期看更可行的收費模式。單純賣token的模式壁壘太低,用戶付費的動機應該是在LLM之上,產品提供的垂直Agent的能力
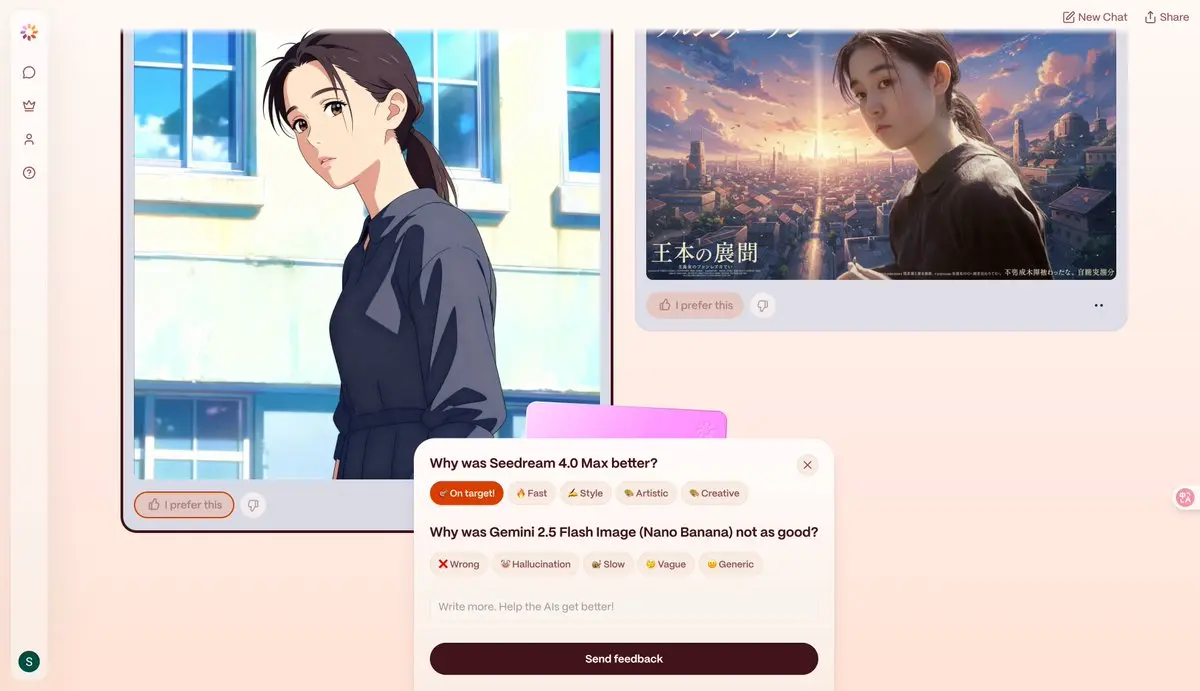
yupp 這個網站有點意思,它能免費使用和對比最領先的AI模型
在 yupp 上的每次對話都有至少兩個AI大模型同時給你回答,你可以從其中選擇你認爲更好的回答,並分享你的使用反饋給yupp
用戶反饋可以獲得積分,更優質的反饋可以獲取更多積分,更多積分意味着你可以使用更多高級模型,甚至將積分提現
這個網站之所以能免費使用大模型,與它建立的用戶反饋機制直接相關。這些反饋數據會提供給模型廠商用來優化模型
這個商業模式之所以可行,我認爲是因爲大模型的token價格會越來越低,而用戶真實反饋會更有價值,尤其是跨廠商的比較。對於模型廠商來說用token換用戶反饋是很劃算的買賣
另一方面對於用戶來說,現在模型太多,在不同領域、不同場景下,哪個模型表現最好?哪個模型最適合自己的應用場景? yupp 可以幫我們進行免費的比較
目前 yupp 主要支持文本聊天、圖像生成、圖像理解等場景,看起來編程領域還不是它的主要應用場景
OpenAI 发布了一篇 "GPT-5 编码指南", 给出了6条使用GPT-5进行AI编程的最佳实践:
# 1. 指令应精确,避免信息冲突
新款GPT-5模型在遵循指令方面的能力有了显著提升,但这也带来一个副作用:当面对模糊或相互冲突的指令时,它可能会难以处理。这种情况在你的 .cursor/rules 或 配置文件中尤其需要注意
# 2. 设定合适的推理级别
GPT-5 在解决问题时总会进行一定程度的推理。若想获得最佳效果,处理复杂任务时应使用 "high reasoning effort" 。如果你发现模型对简单问题有“想太多”的倾向,可以给出更具体的指令,或选择 medium 或 low 的推理级别
# 3. 使用类似XML的语法来帮助结构化指令
我们与Cursor合作发现,使用类似XML的语法可以为模型提供更多上下文,从而使GPT-5更好地工作。例如,你可以给模型以下编码指南:
- 每个组件都应该是模块化和可重用的
- 样式:TailwindCSS
# 4. 避免使用
XPRT+15.82%
熱門話題
#Gate發布9月透明度報告
289.49k 瀏覽量2.65k 人討論中
#質押LaunchPool瓜分280萬$DNA
36.84k 瀏覽量692 人討論中
#比特幣短線站上8.2萬美元
41.27k 瀏覽量2.22k 人討論中
#拉脫維亞通過加密貨幣稅法
34.45k 瀏覽量261 人討論中
#韓國KOSPI開盤暴跌3.17%
47.89k 瀏覽量2.14k 人討論中
#Gate廣場新人季
46.49k 瀏覽量6.52k 人討論中
#特斯拉Roadster帶火Meme幣
102.36k 瀏覽量7.68k 人討論中
#山寨幣反彈勢頭消退
75.9k 瀏覽量4.68k 人討論中
#GateWCTCS9全球交易賽
38.14k 瀏覽量6.9k 人討論中
#SpaceX第三季度財報
142.56k 瀏覽量3.08k 人討論中