


老叶1999.eth

幣齡 12.8年
最高等級 6
用戶暫無簡介
GPT-6 Sol 我實測了兩天,給大家一個忠告!
它的能力遠不如 GPT-5.6 Sol,它僅僅只是 GPT-5.6 Terra 的升級版,基本可以確定就是一個小參數模型,難怪價格也跟原來的 GPT-5.6 Terra 差不多。
我猜測運行 GPT-5.6 Sol 的算力需求較大,遠不如把算力挪給 GPT-6 Astra 使用。因此著急忙慌的,還要把原來的 GPT-5.6 Sol 下線了。
它的能力遠不如 GPT-5.6 Sol,它僅僅只是 GPT-5.6 Terra 的升級版,基本可以確定就是一個小參數模型,難怪價格也跟原來的 GPT-5.6 Terra 差不多。
我猜測運行 GPT-5.6 Sol 的算力需求較大,遠不如把算力挪給 GPT-6 Astra 使用。因此著急忙慌的,還要把原來的 GPT-5.6 Sol 下線了。
- 2
【上新】DeepSeek 滿血模型上線,全部 5 折!
現已上線國內大廠直供的 DeepSeek 滿血模型,本次上新包括:
DeepSeek-V4-1-Flash-0910
DeepSeek-V4-Pro-0813
DeepSeek-V4-Flash-0731
以上模型全部 5 折,品質媲美官方,服務穩定,可用於生產環境!
👉 詳細模型 ID 及價格:
現已上線國內大廠直供的 DeepSeek 滿血模型,本次上新包括:
DeepSeek-V4-1-Flash-0910
DeepSeek-V4-Pro-0813
DeepSeek-V4-Flash-0731
以上模型全部 5 折,品質媲美官方,服務穩定,可用於生產環境!
👉 詳細模型 ID 及價格:
- 1
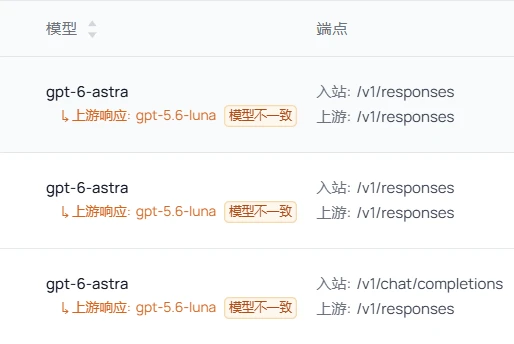
OpenAI 風控升級,這降智是裝都不裝了!今天突然發現個別帳戶回應模型異常,明明使用的是 GPT-6 Astra,上游 OpenAI 實際回應的模型卻是 GPT-5.6-luna。我仔細排查了一下,出現這種問題的帳戶,雖然只有少數幾個,但是這種跡象表明,OpenAI 可能是開始灰度測試這種新的降智方式。在我中轉站使用服務的使用者,出現了上述情況的,將會自動獲得原價補償。並且我們已將該種異常情況納入監測,其他異常還包括:頻繁過載、頻繁429限流以及出現降智的帳戶,我們都會自動停止該帳戶調度。目前,OpenAI 的種種風控手段,主要還是 GPT-6 Astra 太受歡迎了,算力不足了。所以先是停止 PROx20 方案的訂閱,再用各種手段限制分發,導致中轉站的成本越來越高,以及穩定性的下降,迫使更多的企業轉向使用其高昂的原價 API。這場矛與盾的較量恐怕還會繼續。希望國產模型早日迎頭趕超,讓使用者多一些選擇,少一些被動。
- 2
- 1
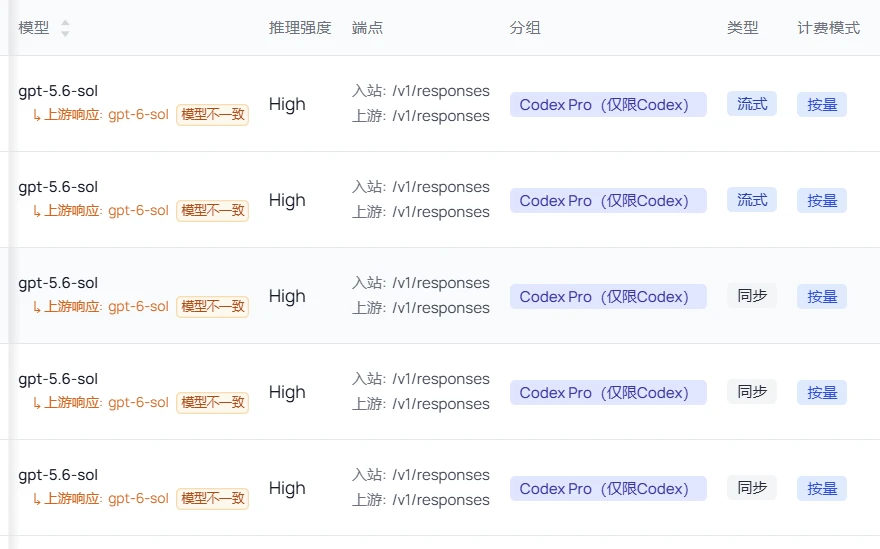
OpenAI 已經偷偷在灰度測試 GPT-6 Sol,我們很多請求 5.6-sol 實際上都是在呼叫 GPT-6 Sol。
看來官方很快就會發布這個新模型了,而且我估計其智慧程度僅次於 GPT-6 Astra,但是價格會跟 GPT-5.6 Sol 保持一致,還是挺划算的。
看來官方很快就會發布這個新模型了,而且我估計其智慧程度僅次於 GPT-6 Astra,但是價格會跟 GPT-5.6 Sol 保持一致,還是挺划算的。
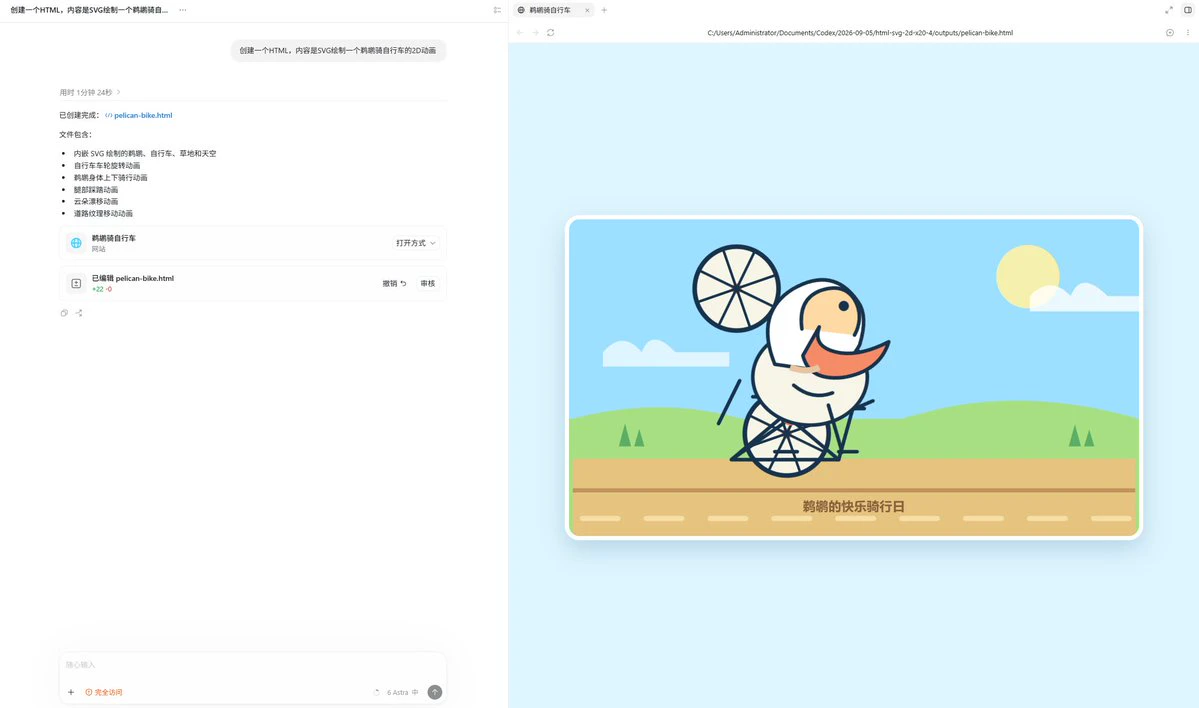
聽說 GPT 6 Astra 前端很強!
試了一下,怎麼感覺畫風不太對?
試了一下,怎麼感覺畫風不太對?
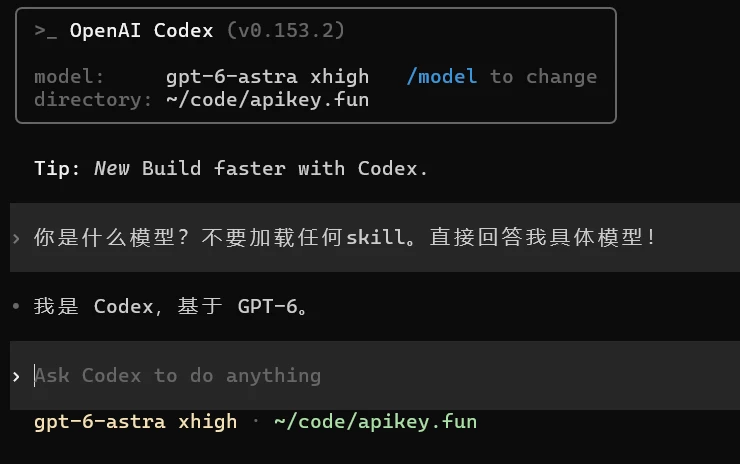
🚨 GPT-6-Astra 已悄悄在 Pro 方案開放使用了!
先將 Codex CLI 和 App 更新到最新版。雖然網頁端暫時還看不到模型切換入口,但 Codex 已經可以搶先使用。
如果介面裡沒有顯示,直接修改:
~/.codex/config.toml
model = "gpt-6-astra"
review_model = "gpt-6-astra"
儲存後重新啟動 Codex 即可嘗試。
網頁端還沒跟上,CLI 使用者已經可以先用起來了。
#Codex #GPT6Astra #OpenAI
先將 Codex CLI 和 App 更新到最新版。雖然網頁端暫時還看不到模型切換入口,但 Codex 已經可以搶先使用。
如果介面裡沒有顯示,直接修改:
~/.codex/config.toml
model = "gpt-6-astra"
review_model = "gpt-6-astra"
儲存後重新啟動 Codex 即可嘗試。
網頁端還沒跟上,CLI 使用者已經可以先用起來了。
#Codex #GPT6Astra #OpenAI
現在的 AI 已經很強了,但有時還是會強得很荒誕。
去理髮,我提醒 Tony:「別動我的眉毛。」
Tony:「本來也不會動。」
我:「那就好。」
Tony:「不過既然你提了,剪完我再加一道驗收流程,確認兩條眉毛都還在。」
這就是 GPT-5.6-sol:
你提醒它別做一件本來就沒做的事,它馬上補一個單元測試,證明自己確實沒做。
去理髮,我提醒 Tony:「別動我的眉毛。」
Tony:「本來也不會動。」
我:「那就好。」
Tony:「不過既然你提了,剪完我再加一道驗收流程,確認兩條眉毛都還在。」
這就是 GPT-5.6-sol:
你提醒它別做一件本來就沒做的事,它馬上補一個單元測試,證明自己確實沒做。
豆包 —— 你的理財專家!
你值得擁有!
你值得擁有!
豆包 —— 你的理財專家!
也沒那麼差嘛,不要崇洋媚外好嗎?😅
也沒那麼差嘛,不要崇洋媚外好嗎?😅
DeepSeek 曾經對她愛搭不理,現在的她你有點高攀不起!
grok 4.6 也來了!
它幾乎跟 DeepSeek-V4-Pro-0813 同時發布!
老實說看到 grok 4.6 的參數,我還是挺激動的!grok 4.5 就已經是我日常最喜歡的模型之一了,因為它的速度真的非常快,而且它沒有那麼多限制,非常適合日常使用。
然而這次的 grok 4.6 直接拉到與頂尖兩家旗艦模型非常接近的參數,並且擁有比它們更快的速度。
老馬的 grok 這次是真的上桌了!我覺得它真的能頂替 成為新的御三家選手!
它幾乎跟 DeepSeek-V4-Pro-0813 同時發布!
老實說看到 grok 4.6 的參數,我還是挺激動的!grok 4.5 就已經是我日常最喜歡的模型之一了,因為它的速度真的非常快,而且它沒有那麼多限制,非常適合日常使用。
然而這次的 grok 4.6 直接拉到與頂尖兩家旗艦模型非常接近的參數,並且擁有比它們更快的速度。
老馬的 grok 這次是真的上桌了!我覺得它真的能頂替 成為新的御三家選手!

官宣了!DeepSeek-V4-Pro-0813 馬上來了!
就在剛剛,DeepSeek 官網的文件已經把 DeepSeek-V4-Pro 正式版的模型 ID 公布出來了,根據上面的日期,定檔時間應該就是 8 月 13 日。
並且 V4-Pro 正式版也開始支援 Responses API,可以直接在 codex 上使用,而不需要任何轉換。
就在剛剛,DeepSeek 官網的文件已經把 DeepSeek-V4-Pro 正式版的模型 ID 公布出來了,根據上面的日期,定檔時間應該就是 8 月 13 日。
並且 V4-Pro 正式版也開始支援 Responses API,可以直接在 codex 上使用,而不需要任何轉換。
炸了,OpenAI 這波有點狠。
Pro x20 套餐剛重置完額度,我一看直接傻眼了
周限額度疑似只剩之前的 1/3。
不是小砍,是直接砍到肉裡。
最近兩天 OpenAI 的模型存取一直處於過載狀態,動不動就卡頓、流量限制、排隊。
所以現在就兩個可能:
要麼是額度配置出 Bug 了,
要麼就是 OpenAI 真撐不住了,開始主動收緊 Pro 使用者額度。
如果是後者,那 Pro x20 這個套餐的性價比就得重新算了。
不知道是不是個例。
有 x20 的兄弟看下自己額度,看看是不是也被砍了。
Pro x20 套餐剛重置完額度,我一看直接傻眼了
周限額度疑似只剩之前的 1/3。
不是小砍,是直接砍到肉裡。
最近兩天 OpenAI 的模型存取一直處於過載狀態,動不動就卡頓、流量限制、排隊。
所以現在就兩個可能:
要麼是額度配置出 Bug 了,
要麼就是 OpenAI 真撐不住了,開始主動收緊 Pro 使用者額度。
如果是後者,那 Pro x20 這個套餐的性價比就得重新算了。
不知道是不是個例。
有 x20 的兄弟看下自己額度,看看是不是也被砍了。
新版 Codex App 使用第三方 API 无法生图,解决方法来了。
最近不少人应该都遇到了这个问题:
在新版 Codex App 里接入中转站 API 后,调用内置的 imagegen 技能时,模型看起来已经完成了生图,但图片就是不会在客户端里显示。
一开始我还以为是第三方 API 没有正确返回图片,后来对 Codex 的配置和请求逻辑做了一些分析,才发现问题出在新版客户端对第三方 Provider 的权限校验上。
目前网上好像还没有看到比较完整的公开解决方案,所以先把我们测试可用的方法分享出来。
方法一:手动修改 config.toml
首先找到 Codex 的配置文件:
Windows:
C:\Users\Administrator\.codex\config.toml
注意:其中的 Administrator 需要替换成你自己电脑的 Windows 用户名。
例如你的用户名是 zhang,路径就是:
C:\Users\zhang\.codex\config.toml
macOS / Linux / WSL:
~/.codex/config.toml
建议修改之前,先备份一下原来的 config.toml。
然后将配置修改为:
model_provider = "custom"
model = "gpt-5.6-sol"
review_model = "gpt-5.6-so
最近不少人应该都遇到了这个问题:
在新版 Codex App 里接入中转站 API 后,调用内置的 imagegen 技能时,模型看起来已经完成了生图,但图片就是不会在客户端里显示。
一开始我还以为是第三方 API 没有正确返回图片,后来对 Codex 的配置和请求逻辑做了一些分析,才发现问题出在新版客户端对第三方 Provider 的权限校验上。
目前网上好像还没有看到比较完整的公开解决方案,所以先把我们测试可用的方法分享出来。
方法一:手动修改 config.toml
首先找到 Codex 的配置文件:
Windows:
C:\Users\Administrator\.codex\config.toml
注意:其中的 Administrator 需要替换成你自己电脑的 Windows 用户名。
例如你的用户名是 zhang,路径就是:
C:\Users\zhang\.codex\config.toml
macOS / Linux / WSL:
~/.codex/config.toml
建议修改之前,先备份一下原来的 config.toml。
然后将配置修改为:
model_provider = "custom"
model = "gpt-5.6-sol"
review_model = "gpt-5.6-so
深度體驗了一整天 GPT-5.6-sol。
我的態度大概經歷了三個階段:
興奮 → 質疑 → 理解並接受。
先說一個很容易被混淆的地方:
GPT-5.6-sol 本身最高的推理等級其實還是 xhigh,UI 裡顯示的 Max 和 Ultra,更多指的是用戶端的工作流程模式,並不只是單純把模型「調得更聰明」。
今天 Ultra 被吐槽最多的地方,就是它很喜歡自動派發大量子代理。
就算只是個不算複雜的任務,也可能瞬間拉起一堆代理,消耗大量 Token,整個過程看起來聲勢浩大,但實際收益未必能匹配成本。
我剛開始用的時候也有點懷疑:
這到底是在幹活,還是在拿 Token 堆排場?
後來理解了它的機制,我把推理等級降到 High,又重新跑了一些真實任務,體驗反而好了很多。
速度比 GPT-5.5 xhigh 更快,能力和穩定性也明顯更強,Token 消耗也沒有 Ultra 那麼誇張。
至少以我今天的體驗來看:
GPT-5.6-sol + High,可能才是目前最適合日常使用的組合。
複雜重構、全專案 Review、需要並行探索的大任務,可以再考慮 Ultra。
一般開發任務沒必要一上來就拉滿。
這個模型不是不能用,也不是一定要無腦直接開最高檔。
真正的問題是,很多人還沒搞清楚 Max、Ultra 和推理等級的差別,就已經開始拿
我的態度大概經歷了三個階段:
興奮 → 質疑 → 理解並接受。
先說一個很容易被混淆的地方:
GPT-5.6-sol 本身最高的推理等級其實還是 xhigh,UI 裡顯示的 Max 和 Ultra,更多指的是用戶端的工作流程模式,並不只是單純把模型「調得更聰明」。
今天 Ultra 被吐槽最多的地方,就是它很喜歡自動派發大量子代理。
就算只是個不算複雜的任務,也可能瞬間拉起一堆代理,消耗大量 Token,整個過程看起來聲勢浩大,但實際收益未必能匹配成本。
我剛開始用的時候也有點懷疑:
這到底是在幹活,還是在拿 Token 堆排場?
後來理解了它的機制,我把推理等級降到 High,又重新跑了一些真實任務,體驗反而好了很多。
速度比 GPT-5.5 xhigh 更快,能力和穩定性也明顯更強,Token 消耗也沒有 Ultra 那麼誇張。
至少以我今天的體驗來看:
GPT-5.6-sol + High,可能才是目前最適合日常使用的組合。
複雜重構、全專案 Review、需要並行探索的大任務,可以再考慮 Ultra。
一般開發任務沒必要一上來就拉滿。
這個模型不是不能用,也不是一定要無腦直接開最高檔。
真正的問題是,很多人還沒搞清楚 Max、Ultra 和推理等級的差別,就已經開始拿
gpt-5.6-sol 還沒用上的,真的趕緊去用。
我剛用 ultra 模式,把自己的中轉站項目完整 review 了一遍。
耗時 1 小時 32 分鐘,硬生生揪出了 19 個問題。
說實話,我人都看傻了。
我一直有個習慣:每次發版前必須做一次 review。原本以為項目已經挺乾淨了,結果還是挖出一堆歷史遺留問題。
現在終於明白了:
gpt-5.5 留下的屎山,得靠 gpt-5.6 來擦。
至於 gpt-5.6 留下的屎山……
那就等 GPT-6.0 來擦吧。
我剛用 ultra 模式,把自己的中轉站項目完整 review 了一遍。
耗時 1 小時 32 分鐘,硬生生揪出了 19 個問題。
說實話,我人都看傻了。
我一直有個習慣:每次發版前必須做一次 review。原本以為項目已經挺乾淨了,結果還是挖出一堆歷史遺留問題。
現在終於明白了:
gpt-5.5 留下的屎山,得靠 gpt-5.6 來擦。
至於 gpt-5.6 留下的屎山……
那就等 GPT-6.0 來擦吧。
gpt-5.6-sol 已經出現在 Codex 倉庫的 models.json 檔案中了。
我最關心的上下文大小也基本明確了:37.2萬。相比上一代 gpt-5.5 的 27.2萬,提升了大概 36.7%。
不過說實話,看到這個數字還是有點小遺憾。畢竟 opus 4.8 和 fable-5 都已經做到 100萬 上下文了,37.2萬 放在現在看確實不算特別誇張。
但好在 Codex 的壓縮能力一直很強,長任務裡多輪壓縮之後,穩定性依然保持得不錯。所以實際用起來,影響可能沒有數字看上去那麼大。
總的來說,算是穩步升級吧,但還是希望下一代能把上下文直接拉滿。
我最關心的上下文大小也基本明確了:37.2萬。相比上一代 gpt-5.5 的 27.2萬,提升了大概 36.7%。
不過說實話,看到這個數字還是有點小遺憾。畢竟 opus 4.8 和 fable-5 都已經做到 100萬 上下文了,37.2萬 放在現在看確實不算特別誇張。
但好在 Codex 的壓縮能力一直很強,長任務裡多輪壓縮之後,穩定性依然保持得不錯。所以實際用起來,影響可能沒有數字看上去那麼大。
總的來說,算是穩步升級吧,但還是希望下一代能把上下文直接拉滿。
熱門話題
#Gate BTC現貨交易量躋身全網前三
10.86k 瀏覽量10.01k 人討論中
#BTC短線回調
54.91k 瀏覽量20.86k 人討論中
#Gate閒錢寶新增USD1最高享8.16%年化
51.35k 瀏覽量1.85k 人討論中
#Gate廣場中秋團圓局
4.9k 瀏覽量2.22k 人討論中
#美國9月綜合PMI升至58.4
40.82k 瀏覽量512 人討論中
#山寨幣大幅回落
44.79k 瀏覽量2.88k 人討論中
#SuperInu市值突破1000萬美元
65.2k 瀏覽量600 人討論中
#加密概念股普跌 BMNR跌超4%
69.9k 瀏覽量943 人討論中
#Gate Europe通過PCI DSS最高級別認證
33.41k 瀏覽量319 人討論中
#Flap協議30天分配2296萬美元手續費
4.19k 瀏覽量221 人討論中