對於正在了解 AI 能力邊界的初學者來說,世界模型要回答的是系統能否預測行動後果,而不是它能否流暢地撰寫回答。以下內容涵蓋定義、預測迴圈、三種技術路線、世界模型與 LLM的任務選擇、與影片生成的差異、使用案例與評估邊界;相關概念可參閱 Gate Learn 對超級人工智慧(ASI)與私有 AI的說明文章。
重點摘要
- 核心能力是行動條件式預測:給定一個狀態與一項行動,輸出下一個狀態(或下一個表徵),以支援規劃與控制。
- 三種常見路線:基於模型的強化學習(MBRL)/想像訓練、生成式互動模擬,以及 JEPA 風格的預測表徵。
- 大型語言模型擅長下一個詞元預測,影片生成器則擅長維持畫面連續性;兩者都不會自動成為可用於規劃的世界模型。
- 評估時應留意虛假物理、長期漂移、分布外失效、嚴格指標,以及與手寫模擬器之間的界線。
什麼是世界模型?它解決什麼問題?
世界模型處理一個實際問題:在代理採取行動之前,它能否可靠地估計接下來會發生什麼事?缺乏這項能力時,學習會依賴真實環境中的嘗試與錯誤——通常成本高、速度慢或不安全——而離線規劃也會變得困難。
在機器人、自動駕駛、遊戲代理與模擬訓練中,尤其是虛擬或實體環境中的具身代理,取得回饋往往成本高或風險高;例如,不良的駕駛策略可能在學會之前就造成真實事故。世界模型會將「嘗試行動」轉移至已學習的動態模型中:在潛在空間或觀測空間中向前推演,再將更強的策略帶回真實世界。這個目標不同於主要重述知識的對話系統;它更接近互動環境中的因果預見能力。
NVIDIA 詞彙表中對世界模型的說明將其描述為協助 AI 理解並預測物理世界如何演變的內部表徵;Yann LeCun 的A Path Towards Autonomous Machine Intelligence將預測式世界模型視為邁向更自主智慧的途徑;David Ha 在 2018 年發表的「World Models」研究則協助界定了現代以學習為基礎的方法。代理通常只能看到部分觀測,因此無法直接取得完整狀態。從這些觀點來看,預測的目的都是支援決策。
世界模型如何運作?狀態、行動與預測迴圈
判斷系統是否以世界模型為導向,最穩定的測試方法是檢視行動條件式預測:輸入是否明確包含代理的行動(或控制訊號),以及輸出是否為以該行動為條件的下一個狀態或下一個表徵。
此迴圈通常可濃縮為三個步驟:將觀測編碼為狀態;以候選行動作為條件;預測下一個狀態。環境在該行動後發生變化並回傳新的觀測,系統也可選擇將該預測向前推演,作為新的起點。策略或規劃器會依據報酬、風險或限制條件比較想像中的軌跡,然後執行行動;新的觀測會重新啟動編碼流程。
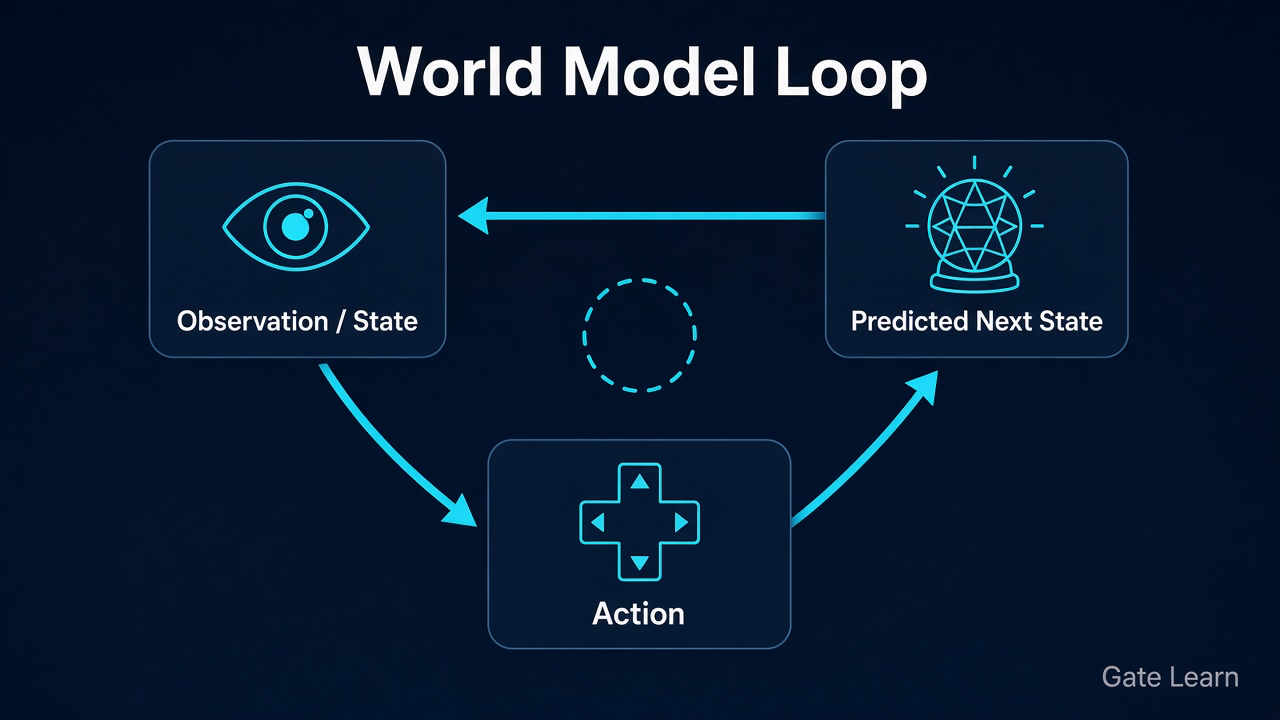
圖 1。世界模型迴圈:觀測/狀態加上行動,會產生預測的下一個狀態,並進入下一個週期。
許多實務系統會避免在原始像素上進行長期預測,轉而學習潛在動態:將高維度視覺資料壓縮為精簡狀態,再於該空間中向前推演。潛在推演可減少視覺雜訊並降低想像訓練的成本;至於潛在狀態是否仍忠實反映真實物理,仍需透過下游任務與分布外檢查來驗證,尤其是實體環境只能被部分觀測,必須透過回饋加以推斷。
世界模型的主要技術路線有哪些?
「世界模型」是涵蓋多個技術家族的廣泛標籤,而非單一演算法名稱。選擇應從工作需求開始:可控制的策略、互動式像素模擬,或可遷移的抽象表徵。
| 路線 | 核心概念 | 最適合的情境 | 主要成本 |
|---|---|---|---|
| MBRL/想像訓練 | 學習動態,再透過模型推演訓練策略(Dreamer) | 控制、遊戲、具樣本效率的強化學習 | 模型誤差會影響策略;產生漂移 |
| 生成式互動模擬 | 學習可產生下一影格/觀測的互動環境 | 資料增強、互動式影片世界 | 外觀不等於物理;評估成本高 |
| JEPA 預測表徵 | 在表徵空間中預測未來/遮罩嵌入向量(I-JEPA) | 表徵學習、用於規劃的抽象預測 | 不產生像素;需要控制堆疊 |
其中一種路線可能以預測未來影格的影片模型為核心,另一種則著重於可直接用於規劃的潛在動態,而非完整重建視覺畫面。
這三種路線可以並存:Dreamer 風格的方法強調在想像中訓練策略;生成式影片世界模型強調互動式外觀模擬;Meta AI 的 I-JEPA則展示了在聯合嵌入空間中進行預測,而非重建每一個像素。不同系統也會依據其學習來源是輸入輸出配對、控制推演或預測嵌入向量,而選擇不同的訓練方法。應先對齊任務,再討論名稱。
世界模型與 LLM、影片生成有何不同?
三者都會「預測」,但在生成式 AI 中,它們預測的對象不同,行動條件式能力也不同:LLM 預測下一個詞元,影片生成器預測下一影格的外觀,而以世界模型為導向的系統預測狀態在行動後如何演變。
| 維度 | 世界模型 | 大型語言模型(LLM) | 影片生成 |
|---|---|---|---|
| 核心預測目標 | 下一個狀態/潛在動態(通常以行動為條件) | 下一個詞元/文字結構 | 下一影格或片段的外觀 |
| 與行動的關係 | 行動條件式預測是決策核心 | 通常沒有實體控制迴圈 | 可能以文字/第一影格為條件,但無法執行 |
| 典型用途 | 規劃、控制、具身 AI | 語言、寫作、工具協調 | 內容生成、預覽、互動模擬 |
| 常見混淆 | 對話能力 = 世界模型 | 能描述物理 = 具備物理能力 | 寫實影格 = 正確動態 |
因此,類似 Sora 的影片生成器可以呈現視覺保真度高且連貫的影格,甚至展現表面上的空間一致性——也可能被稱為「影片世界模型」——但僅憑這些特徵無法證明其理解物理。若缺乏穩定的行動介面、可驗證的狀態轉換與規劃迴圈,較準確的分類仍是生成式影片。更強大的系統還能評估行動序列,以支援規劃與決策,而不只是被動地渲染可能的畫面。LLM 可以敘述「如果您輕推杯子會怎樣」,但這不會建立可推演、可評估的環境動態。
世界模型通常用於哪些情境?
具身 AI 是高頻使用情境:機械手臂與移動式機器人需要空間智慧——推理實體世界中的配置、移動與變化——也需要在接觸物體前預測碰撞與位移,因為許多互動一旦開始移動便難以逆轉。行動條件式預測讓系統能在付出真實碰撞成本之前,於模擬環境或潛在空間中淘汰失敗軌跡;示範資料可以初始化行為,但不能取代基於互動的學習。
遊戲與基於模型的強化學習是另一個核心領域。Dreamer 風格的方法會在想像軌跡上改善策略,因此能以較少的真實互動建立可用的控制能力。相同概念也可遷移至工業控制日誌;若手寫模擬器並不完整,但觀測歷史資料充足,模型便可嘗試從歷史資料中擷取系統動態。
自動駕駛、倉儲排程與多代理模擬也會嵌入世界模型元件——不是用來完整取代規劃堆疊,而是作為短期後果推演層。虛擬測試與經篩選的影片資料通常用於訓練及評估這些元件,並在實際部署前驗證其跨情境表現。任何必須「先思考再行動」的控制系統,都可能包含世界模型模組。
評估世界模型時,哪些優勢、風險與限制值得注意?
其優勢在於提高樣本效率及讓嘗試與錯誤更安全:在模型中進行想像可減少危險探索,行動條件式預測則可讓規劃建立在可檢視的動態之上。限制與風險通常會在模型看起來正確但不可信時出現,因為精緻的內部表徵不等同於能夠承受實際部署考驗的行為。
| 機制 | 可觀察到的現象 | 為何容易被忽略 | 檢查問題 |
|---|---|---|---|
| 虛假物理 | 軌跡流暢但違反守恆或接觸規則 | 視覺流暢性容易讓人信服 | 關鍵物理量是否守恆?物體能否穿透彼此? |
| 長期漂移 | 短期推演正常;長期推演崩潰 | 示範通常偏重短片段 | 誤差如何隨步數增加?是否會重新規劃? |
| 分布外失效 | 面對新物體、光照或行動範圍時失效 | 分布內分數看起來很強 | 是否有 OOD 協議?失效模式是否公開? |
| 嚴格評估 | 沒有共用的「世界理解」分數 | 任務成功率掩蓋了指標 | 除了任務分數外,是否有報告預測誤差? |
| 與手寫模擬器的界線 | 將學習模型視為已驗證的引擎 | 行銷內容混合模擬器與世界模型 | 哪些限制條件是硬編碼?哪些只是擬合結果? |
由於模擬至真實環境之間存在落差,遷移到現實世界非常困難。良好的測試應檢驗模型是否能在行動下預測可控制的結果,而不只是產生合理的視覺效果。
可將此表作為主張檢查清單:先確認存在行動條件式介面,接著要求長期與 OOD 證據,最後區分「看起來好」與「動態可用於規劃」。若缺乏這些證據,較安全的說法是「包含世界模型元件或研究目標」,而不是「具備完整世界模型」。由於代理的能力有限,評估應聚焦於與目標相關的狀態,而非完整重現整個場景。
總結
世界模型推動 AI 從「能對話/能繪圖」走向「能預測行動後果」,例如預測機器人若選擇錯誤路徑,便會撞倒杯子。其運作核心是由狀態、行動與預測組成的閉環,而行動條件式預測是最清楚的決策判準。
三種路線——MBRL/想像訓練、生成式互動模擬與 JEPA 預測表徵——服務於不同目標,無法互相替代。與 LLM 和影片生成器相比時,應比較預測目標與行動介面;評估時,則應優先關注虛假物理、漂移、OOD 失效、嚴格指標與模擬器邊界。
常見問題
什麼是世界模型?
世界模型是一種學習而得的內部動態模型,用於表徵環境在目前狀態(或觀測)與行動條件下可能如何變化。任何時刻的世界都比代理可直接觀測到的資訊更豐富,因此模型會摘要對規劃重要的變數——例如機器人左轉後會到達的位置。它的目的在於支援想像中的規劃與嘗試錯誤,而不只是生成文字或影片外觀。
世界模型與大型語言模型有何不同?
大型語言模型主要預測下一個詞元,擅長語言與知識協調;世界模型則主要預測狀態如何在行動後演變,以支援控制與規劃。LLM 可以討論物理,但無法因此提供可推演、可評估的環境動態。
世界模型如何運作?
典型迴圈會將觀測編碼為狀態,以候選行動作為條件,預測該行動後的下一個狀態,並可在潛在空間中繼續向前推演。規劃器會比較想像中的推演結果、執行行動,然後根據新的觀測更新狀態。
Sora 或影片生成算是世界模型嗎?
不一定。如果系統主要產生外觀連貫的影片,卻沒有穩定的行動條件式介面、可驗證的狀態轉換與規劃用途,較適合描述為影片生成器。只有在已展示行動條件式預測與可規劃迴圈時,它才更接近世界模型。
世界模型與傳統模擬器有何不同?
傳統模擬器通常會編寫物理規則與限制條件,而資料驅動的世界模型通常透過神經網路學習。學習模型可更具彈性,也更接近感測器雜訊,但更容易出現虛假物理與長期漂移,因此不應假定其等同於經過驗證的物理引擎。
* 投資有風險,入市須謹慎。本文不作為 Gate 提供的投資理財建議或其他任何類型的建議。
* 在未提及 Gate 的情況下,複製、傳播或抄襲本文將違反《版權法》,Gate 有權追究其法律責任。


相關文章
USD.AI 效益來源解析:AI 基礎設施貸款如何創造收益
USD.AI 代幣經濟學:深入解析 CHIP 代幣的應用場景與激勵機制
Arweave:用AO電腦捕捉市場機會
即將到來的AO代幣:可能是鏈上AI代理的終極解決方案
Theta Network 的節點體系是什麼?Validator、Guardian 與 Edge Node 全解析