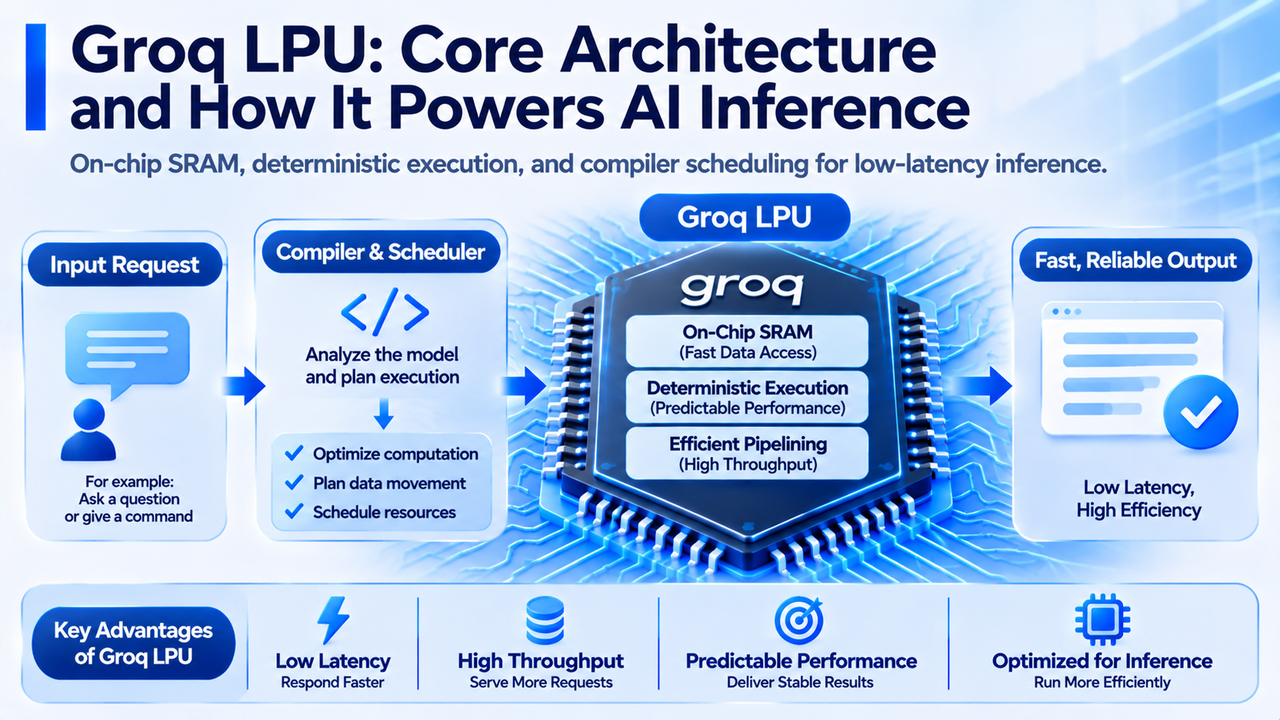
與面向廣泛平行運算任務的 GPU 不同,Groq LPU 採用強調片上 SRAM、編譯器靜態排程和確定性執行的架構,試圖減少推理過程中的資料傳輸和執行階段排程開銷,為即時 AI 應用提供更具針對性的運算能力。
隨著大型語言模型逐漸應用於智慧客服、語音互動、AI Agent 和企業自動化服務,推理運算的需求正從單純追求處理速度,擴展至回應延遲、服務穩定性和單位運算成本等多個面向。Groq LPU 所代表的專用加速器路線,為 AI 基礎設施提供了不同於傳統通用運算架構的技術選擇。本文將深入介紹 Groq LPU 的運作機制,分析 SRAM、確定性執行和編譯器如何影響推理效能,並討論其適用場景與技術限制。
核心要點
-
Groq LPU 是針對 AI 推理工作負載設計的專用處理器,強調低延遲、可預測執行和高效資料傳輸。
-
大型語言模型推理通常包括 Prefill 和 Decode 兩個階段,不同階段對運算能力與記憶體頻寬的要求有所不同。
-
Groq LPU 使用片上 SRAM 縮短部分資料存取路徑,但較小的片上儲存容量也帶來了模型部署和多晶片擴展方面的要求。
-
確定性執行和編譯器靜態排程能夠減少部分執行階段排程開銷,但不代表所有請求的回應時間完全相同。
-
LPU 在即時文字生成、語音互動等低延遲應用中具有潛在優勢,但實際表現仍取決於模型、負載、系統設定和服務定價。
Groq LPU 是什麼?與傳統 AI 加速器有何不同?
Groq LPU 是由 Groq 設計的專用 AI 推理處理器。LPU 的全稱為 Language Processing Unit,其設計目標是針對語言模型推理中的資料移動、運算執行和延遲控制進行最佳化,而不是提供涵蓋所有運算任務的通用處理能力。
要理解 LPU 的技術定位,需要先認識 AI 加速器的不同設計思路。GPU 最初主要用於圖形處理,隨後憑藉大規模平行運算能力和成熟的軟體生態系,廣泛應用於深度學習訓練與推理。TPU 等專用加速器則透過針對機器學習運算進行最佳化,提高特定運算任務的執行效率。
Groq LPU 進一步強調編譯器與硬體之間的協同關係。其架構希望在模型執行前規劃運算和資料傳輸流程,使晶片能夠按照預定安排完成任務,從而減少部分動態排程產生的開銷。
這種設計思路與 Groq 早期提出的 Tensor Streaming Processor(TSP)技術路線密切相關。處理器透過組織運算資源、片上儲存和資料傳輸路徑,使模型運算能夠按照編譯器安排的順序執行。
需要注意的是,LPU 並不是所有語言模型處理器的統一產業分類,而是 Groq 使用的技術名稱。不同廠商可能採用不同的晶片設計方式,也可能透過 GPU、ASIC 或其他專用加速器實現低延遲推理。
因此,判斷 Groq LPU 的技術價值,不能僅憑處理器名稱,而需要分析它如何處理推理任務中的資料存取、運算排程和多晶片通訊問題。
為什麼大型語言模型推理需要低延遲運算?
大型語言模型推理是指模型接收輸入後,利用已訓練完成的參數生成輸出的過程。對於常見的自回歸語言模型,推理通常包括 Prefill 和 Decode 兩個階段。Prefill 階段主要負責處理使用者輸入的提示詞,並建立後續生成所需的運算狀態。由於此階段能夠同時處理多個輸入 Token,通常具有較強的平行運算特性。
Decode 階段則負責逐步生成輸出 Token。模型通常需要根據既有輸入和已生成的內容預測下一個 Token,因此多個生成步驟之間存在依賴關係,難以像某些訓練運算那樣完全平行執行。
這項差異使推理效能不能只用單一指標衡量。
首 Token 延遲(Time to First Token,TTFT)衡量從請求開始到生成第一個輸出 Token 所需的時間,主要影響使用者等待回應時的感受。
Token 生成速度衡量模型開始輸出後,單位時間內能夠生成多少 Token,直接影響文字持續生成的流暢程度。吞吐量(Throughput)則關注系統在一定時間內能夠處理多少請求或 Token,反映推理服務在較高並行負載下的整體處理能力。
例如,兩個推理平台都能夠執行同一個語言模型,但平台 A 可能在單一使用者請求下具有更快的 Token 生成速度,平台 B 則可能在同時處理數百個請求時具有更高的整體吞吐量。
這表示低延遲與高吞吐量並不是完全相同的效能目標。針對單一使用者即時互動最佳化的系統,不一定在所有批次處理或高並行場景中都具備相同優勢。
對於語音助理、即時翻譯和互動式 AI 應用而言,首 Token 延遲和連續生成速度尤其重要。使用者通常希望系統能夠迅速開始回應,並持續輸出自然流暢的內容。
對於離線文件分析、批次資料處理等任務,單一請求的即時回應可能沒那麼重要,企業反而更關注整體吞吐量和單位處理成本。
Groq LPU 的設計重點之一,就是針對對回應時間敏感的推理工作負載最佳化執行效率。
Groq LPU 如何利用 SRAM 提高資料存取效率?
現代 AI 處理器的效能不僅取決於運算單元能夠執行多少運算,也取決於資料能否及時抵達運算單元。
在大型語言模型推理過程中,處理器需要反覆讀取模型權重、存取中間運算結果,並維護與上下文相關的資料。如果資料讀取速度不足,即使晶片具備較高的理論運算能力,也可能因等待資料而無法充分發揮效能。
這個問題通常稱為記憶體瓶頸。
Groq LPU 的重要架構特點之一,是強調使用片上 SRAM(Static Random-Access Memory,靜態隨機存取記憶體)進行資料儲存和存取。
SRAM 通常具有較低的存取延遲,能夠直接整合在處理器晶片內部。與需要透過外部記憶體介面存取的資料相比,片上儲存有機會縮短資料傳輸路徑,並減少部分存取開銷。
為了理解這項設計,可以比較 SRAM 與高頻寬記憶體(HBM)的基本特點。
| 比較面向 | SRAM | HBM |
|---|---|---|
| 常見位置 | 處理器晶片內部 | 處理器封裝內的獨立記憶體堆疊 |
| 主要優勢 | 低存取延遲、便於緊密整合 | 容量較大、總頻寬較高 |
| 主要限制 | 面積成本高、容量有限 | 資料存取仍需經過記憶體介面 |
| 典型用途 | 快取、片上工作儲存 | 模型權重、啟動值等大規模資料 |
| 對推理的意義 | 最佳化部分資料存取路徑 | 支援更大型的模型和運算狀態 |
但不能簡單地認為 SRAM 在所有情況下都比 HBM 更快,或使用 SRAM 就能消除記憶體瓶頸。實際效能還取決於資料配置、平行存取方式、記憶體頻寬和模型結構。
SRAM 的主要限制在於儲存密度和晶片面積成本。對於參數規模較大的語言模型,單顆處理器上的 SRAM 通常不足以容納完整模型權重及執行狀態。
因此,Groq 需要透過多晶片協同和系統層級的資料分配,使模型能夠在更大的運算系統上執行。這表示 LPU 的優勢並不完全來自單顆晶片的 SRAM,而是來自片上儲存、運算流水線、晶片互連和編譯器之間的整體設計。
確定性執行與編譯器排程如何影響推理效能?
確定性執行(Deterministic Execution)是理解 Groq LPU 架構的另一個關鍵概念。其核心思想是盡可能在程式執行之前確定運算操作的執行順序、資料傳輸路徑和資源分配方式,減少執行過程中臨時作出排程決策的需求。
在傳統的通用運算架構中,處理器需要適應不同類型的程式和工作負載。為了提高資源利用率,系統通常包含動態任務排程、快取管理和其他執行階段機制。這些設計能夠提供較高的彈性,但也可能引入額外的排程開銷。
Groq LPU 採用不同的設計思路。編譯器在模型執行前分析運算圖,並為運算操作和資料移動安排相應的執行計畫。處理器隨後按照這項計畫執行,使資料能夠在不同運算單元之間有序傳遞。例如,一個語言模型需要連續執行矩陣運算、啟動函數和其他運算操作。編譯器可以提前安排這些任務在不同運算資源上的執行時機,並協調所需的資料傳輸。
這種方式類似於提前規劃生產線上的每一道工序,使不同環節能夠按照預定節奏協同運作。
對 AI 推理而言,確定性執行主要具有兩方面意義。
-
它能夠降低部分執行階段排程開銷。處理器不必在每個運算階段重新決定所有任務的執行順序,有助於提高特定工作負載的執行效率。
-
它有利於提高運算執行時間的可預測性。對於即時 AI 服務而言,穩定的回應表現與較低的平均延遲同樣重要。確定性執行不代表實際 API 請求的回應時間完全固定。使用者輸入長度、輸出 Token 數量、請求排隊、網路傳輸和服務負載仍可能造成端到端延遲差異。
-
靜態排程也可能降低部分運算任務的彈性。如果模型存在複雜的動態控制流程,或運算過程需要根據即時結果頻繁改變執行路徑,編譯器可能需要採取額外的處理策略。
因此,確定性執行的價值並不是消除所有不確定性,而是在適合的運算任務中,以更明確的執行安排提高硬體資源的使用效率。
Groq LPU 為什麼適合低延遲 AI 推理?
Groq LPU 的低延遲設計並非依賴某一項單獨技術,而是片上 SRAM、確定性執行、編譯器最佳化和系統層級互連共同作用的結果。在大型語言模型生成過程中,模型需要連續執行運算操作,並根據既有結果生成後續 Token。如果處理器能夠減少部分資料讀取等待和執行階段排程開銷,就有機會縮短連續生成步驟所需的時間。
這對 Decode 階段尤其具有意義。由於自回歸模型通常需要逐步生成 Token,單一生成步驟的延遲會不斷累積,最終影響使用者感受到的文字輸出速度。不過,不同推理任務的效能瓶頸並不完全相同。長提示詞處理可能更依賴大規模平行運算能力,而連續生成過程則可能更容易受到記憶體存取和逐步執行延遲的影響。
因此,Groq LPU 的實際表現需要結合模型類型、輸入長度、輸出長度和並行請求數量進行評估。
從應用場景來看,以下幾類服務尤其重視低延遲推理。
即時語音互動。語音助理需要將使用者語音轉換為文字、呼叫語言模型生成回答,再透過語音合成輸出結果。如果語言模型生成速度較慢,整個對話就可能出現明顯停頓。
互動式 AI Agent。AI Agent 在執行任務時,可能需要多次呼叫語言模型來決定下一步操作。每次推理延遲都會影響整體任務完成時間,因此降低單次推理等待時間可能改善使用者體驗。
智慧客服與即時應用。面向大量使用者的線上服務不僅需要快速回應,還需要控制請求之間的延遲波動,以維持穩定的服務品質。
不過,低延遲不一定代表單位運算成本最低。例如,某個推理平台能夠以較高速度處理單一請求,但如果硬體採購成本較高,或在低負載時存在大量閒置資源,其每 100 萬 Token 的實際服務成本仍可能高於其他方案。相反地,另一種平台雖然單一請求的生成速度較慢,但能夠透過批次處理同時服務大量使用者,最終實現較低的平均成本。
因此,企業選擇推理平台時,需要在延遲、吞吐量、成本和模型相容性之間進行權衡,而不能僅根據每秒 Token 數作出判斷。
Groq LPU 有哪些技術限制?
雖然 Groq LPU 針對 AI 推理進行了專門最佳化,但專用架構並不代表能夠在所有運算任務中取得優勢。其技術限制主要涉及記憶體容量、多晶片擴展、模型相容性和系統成本。
片上 SRAM 的容量限制。由於 SRAM 的儲存密度相對較低,單顆晶片能夠提供的片上儲存容量有限。當模型參數和執行狀態超出單晶片容量時,就需要透過多晶片系統分配運算和資料。
例如,一個大型語言模型可能需要數十 GB 甚至更多的儲存空間,僅依靠單顆晶片的片上 SRAM 通常難以容納全部資料。此時,系統必須將模型分割至多個處理器,並透過晶片互連完成必要的資料交換。
這種方式能夠擴大可部署模型的規模,但也增加了系統設計的複雜度。
多晶片通訊開銷。即使單顆 LPU 能夠快速執行運算,如果模型執行過程中需要頻繁跨晶片傳輸資料,整體推理速度仍可能受到互連頻寬、通訊延遲和資料分配策略的影響。對於大規模推理系統而言,效能不再只是單顆處理器的運算能力,而是整個晶片叢集協同執行的結果。
模型相容性問題。Groq LPU 依賴編譯器將模型運算映射至專用硬體,因此需要相應的軟體支援。當新的 AI 模型引入不同的運算算子、注意力機制或動態執行方式時,平台可能需要更新編譯器和執行環境。與擁有廣泛軟體生態系的通用 GPU 相比,專用推理處理器需要持續投入軟體研發,才能適應快速變化的模型技術。
基礎設施與商業成本。LPU 的效能優勢需要透過完整的運算系統才能實現。實際部署仍涉及晶片製造、伺服器、網路、電力和冷卻設施等成本。對於雲端推理服務商而言,設備利用率和客戶需求同樣會影響投資回報。
因此,評估 Groq LPU 時,需要將晶片架構與實際部署條件結合起來。某項測試中的高 Token 生成速度,不能直接證明其在所有模型和商業場景中都具備更高的成本效率。
Groq LPU 對未來 AI 推理基礎設施有何意義?
Groq LPU 的發展反映出 AI 運算市場正在進一步細分。隨著生成式 AI 應用規模擴大,企業開始根據不同工作負載選擇更專業化的運算架構,而不再只關注單一處理器的理論峰值效能。
在模型訓練領域,大規模平行運算、記憶體容量和多設備通訊仍然具有重要意義。而在推理領域,首 Token 延遲、連續生成速度、並行吞吐量和單位 Token 成本,則成為更直接的商業指標。
不同運算任務的需求差異,為專用推理晶片提供了發展空間。與此同時,專用處理器與 GPU 之間也不一定是完全取代的關係。2026 年 3 月,NVIDIA 介紹了將 Groq 3 LPX 與 Vera Rubin 平台結合的推理架構,探索由不同類型的運算設備承擔適合自身特點的推理任務。
這項方向體現了異質運算(Heterogeneous Computing)的發展趨勢。未來 AI 資料中心可能同時部署 GPU、專用推理加速器和其他運算設備,再透過軟體系統協調不同任務的執行。
例如,對於需要大規模平行處理的工作負載,可以使用適合的 GPU 資源;對於某些對延遲高度敏感的生成任務,則可以探索專用推理處理器的優勢。但異質運算並不代表只要增加晶片類型就能提高效率。系統還需要解決跨設備通訊、任務排程、軟體相容性和基礎設施成本等問題。
對 AI 晶片產業而言,這表示競爭正從單一硬體效能延伸至完整運算系統的效率。處理器架構、編譯器、記憶體系統、互連技術和雲端服務營運能力,都可能成為決定最終效能和商業價值的因素。
Groq LPU 所代表的技術路線,為這項變化提供了具體案例。其長期價值不只取決於某一代晶片的推理速度,也取決於能否持續適應模型演進,並將技術效能轉化為穩定、可擴展的運算服務。
總結
Groq LPU 是針對 AI 推理設計的專用處理器,透過片上 SRAM、確定性執行和編譯器靜態排程等技術,最佳化部分大型語言模型工作負載中的資料存取和運算執行流程。
與通用 GPU 相比,Groq LPU 更加重視特定推理任務中的低延遲和執行可預測性。這種設計適合探索即時文字生成、語音互動和 AI Agent 等應用的效能最佳化,但不代表它能夠在所有模型和運算場景中取代 GPU。
與此同時,SRAM 容量、多晶片通訊、模型適配和基礎設施成本,仍然是專用推理架構需要解決的重要問題。
隨著 AI 產業從模型研發擴展至規模化應用,推理運算的競爭重點正從單純追求算力規模,轉向延遲、吞吐量、成本和系統效率的綜合最佳化。Groq LPU 的發展說明,專用加速器可能在未來 AI 基礎設施中發揮更重要的作用,但其實際價值仍需要透過具體工作負載和商業部署結果進行驗證。
FAQ
Groq LPU 是什麼?
Groq LPU 是由 Groq 設計的專用 AI 推理處理器,主要透過片上 SRAM、確定性執行和編譯器排程等技術,最佳化特定語言模型推理任務。
LPU 與 GPU 的主要區別是什麼?
LPU 更強調針對特定推理任務最佳化執行和資料傳輸,而 GPU 具備較廣泛的平行運算能力和軟體生態系。兩者的效能差異取決於具體模型和執行環境。
為什麼 Groq LPU 使用 SRAM?
SRAM 能夠提供較低延遲的片上資料存取,有助於減少部分推理任務中的資料讀取開銷。但 SRAM 容量有限,部署大型模型通常需要多晶片協同。
什麼是確定性執行?
確定性執行是指盡可能在程式執行前規劃運算順序、資料傳輸和資源分配,減少部分執行階段排程開銷,提高運算執行的可預測性。
Groq LPU 可以用於 AI 模型訓練嗎?
Groq LPU 主要針對推理工作負載設計,並非以通用的大規模模型訓練為主要目標。實際支援能力取決於硬體架構和軟體工具鏈。
Groq LPU 的推理速度一定比 NVIDIA GPU 快嗎?
不一定。不同模型、輸入長度、輸出長度、並行規模和測試環境都會影響結果。單一使用者的 Token 生成速度較高,也不代表整體吞吐量或單位 Token 成本必然更優。
Groq LPU 為什麼適合 AI Agent?
AI Agent 可能需要連續執行多次模型推理。降低單次請求的回應延遲,有機會縮短整個任務的執行時間,但最終效果還取決於工具呼叫、網路傳輸和其他處理環節。
* 投資有風險,入市須謹慎。本文不作為 Gate 提供的投資理財建議或其他任何類型的建議。
* 在未提及 Gate 的情況下,複製、傳播或抄襲本文將違反《版權法》,Gate 有權追究其法律責任。
分享
目錄


相關文章
USD.AI 效益來源解析:AI 基礎設施貸款如何創造收益
USD.AI 代幣經濟學:深入解析 CHIP 代幣的應用場景與激勵機制
Arweave:用AO電腦捕捉市場機會
即將到來的AO代幣:可能是鏈上AI代理的終極解決方案
Theta Network 的節點體系是什麼?Validator、Guardian 與 Edge Node 全解析