Для початківців, які визначають межі можливостей ШІ, модель світу відповідає на питання, чи може система передбачати наслідки дій, а не чи вміє вона формулювати зв’язні відповіді. У розділах нижче розглянуто визначення, цикл прогнозування, три технічні підходи, вибір завдань «Модель світу та LLM», відмінності від генерації відео, приклади використання та межі оцінювання; суміжні поняття висвітлено в матеріалах Gate Learn про суперінтелект (ASI) і приватний ШІ.
Основні висновки
- Основна можливість — прогнозування з урахуванням дії: за заданого стану та дії система визначає наступний стан (або наступне представлення) для планування й керування.
- Три поширені підходи: навчання з підкріпленням на основі моделі (MBRL) / навчання в уявному середовищі, генеративне інтерактивне моделювання та прогнозні представлення у стилі JEPA.
- Великі мовні моделі добре прогнозують наступні токени, а генератори відео — візуальну безперервність; жодне з них автоматично не є моделлю світу, придатною для планування.
- Під час оцінювання слід враховувати несправжню фізику, дрейф на довгому горизонті, збої поза розподілом даних, суворі метрики та межу між моделями світу й симуляторами з прописаними вручну правилами.
Що таке модель світу та яку проблему вона розв’язує?
Модель світу розглядає практичне питання: чи може агент до виконання дії надійно оцінити, що станеться далі? Без цієї здатності навчання залежить від реальних спроб і помилок, які часто є дорогими, повільними або небезпечними, а автономне планування ускладнюється.
У робототехніці, автономному керуванні автомобілями, ігрових агентах і навчанні в симуляції — особливо для втілених агентів у віртуальних або фізичних середовищах — зворотний зв’язок коштовний або ризикований. Наприклад, невдала стратегія керування автомобілем може спричинити реальну аварію ще до того, як система навчиться. Модель світу переносить «випробування дій» у вивчену динаміку: вона розгортає прогноз у латентному просторі або просторі спостережень, а потім переносить ефективнішу стратегію назад у реальний світ. Ця мета відрізняється від розмовних систем, які здебільшого відтворюють знання; вона ближча до причинного передбачення в інтерактивному середовищі.
У статті NVIDIA Glossary про моделі світу їх описано як внутрішні представлення, що допомагають ШІ розуміти та прогнозувати розвиток фізичного світу. У праці Янна Лекуна A Path Towards Autonomous Machine Intelligence прогнозні моделі світу розглядаються як крок до більш автономного інтелекту, а робота Девіда Ха «World Models» 2018 року допомогла сформувати сучасний підхід на основі машинного навчання. Агент зазвичай бачить лише часткові спостереження, тому повний стан безпосередньо недоступний. У всіх цих підходах прогнозування слугує для підтримки ухвалення рішень.
Як працює модель світу? Стан, дія та цикл прогнозування
Найнадійніший критерій системи, орієнтованої на модель світу, — прогнозування з урахуванням дії: чи містять вхідні дані явно дію агента або сигнал керування та чи є виходом наступний стан або наступне представлення, зумовлене цією дією.
Зазвичай цикл складається з трьох кроків: кодування спостережень у стан; врахування можливої дії; прогнозування наступного стану, коли середовище змінюється після цієї дії та повертає нові спостереження. За потреби прогноз можна розгорнути далі, використовуючи його як нову початкову точку. Стратегія або планувальник порівнює уявні траєкторії за винагородою, ризиком чи обмеженнями, а потім виконує дію; нове спостереження запускає кодування знову.
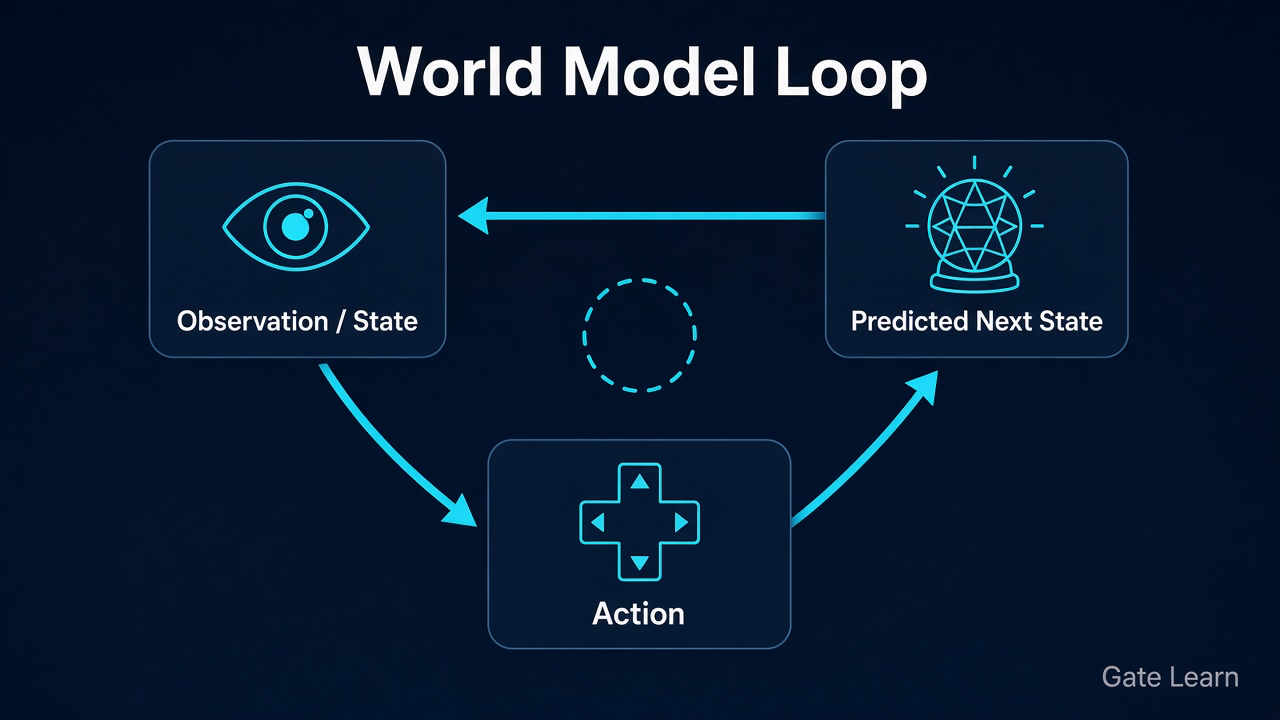
Рисунок 1. Цикл моделі світу: спостереження/стан разом із дією дають прогнозований наступний стан, який формує наступний цикл.
Багато практичних систем уникають довгострокового прогнозування в необроблених пікселях і натомість навчають латентну динаміку: стискають високовимірні візуальні дані до компактного стану, а потім розгортають прогноз у цьому просторі. Латентні розгортання зменшують візуальний шум і здешевлюють навчання в уявному середовищі. Водночас те, наскільки латентний стан відповідає реальній фізиці, все одно потрібно перевіряти через подальші завдання та перевірки поза розподілом даних, особливо тому, що фізичне середовище спостерігається лише частково й має бути виведене через зворотний зв’язок.
Які основні технічні підходи до моделей світу?
«Модель світу» — це широка назва для кількох технічних напрямів, а не назва одного алгоритму. Вибір починається із завдання: керовані стратегії, інтерактивне моделювання зображень або переносні абстрактні представлення.
| Підхід |
Основна ідея |
Найкраще застосування |
Основна вартість |
| MBRL / навчання в уявному середовищі |
Навчання динаміки, а потім стратегії на розгортаннях моделі (Dreamer) |
Керування, ігри, RL з ефективним використанням вибірки |
Помилка моделі погіршує стратегію; дрейф |
| Генеративне інтерактивне моделювання |
Навчання інтерактивного середовища, що генерує наступні кадри/спостереження |
Доповнення даних, інтерактивні відеосвіти |
Вигляд ≠ фізика; дороге оцінювання |
| Прогнозні представлення JEPA |
Прогнозування майбутніх/замаскованих вбудовувань у просторі представлень (I-JEPA) |
Навчання представлень, абстрактне прогнозування для планування |
Без пікселів; потребує стеку керування |
Один підхід може бути зосереджений на відеомоделі, що прогнозує майбутні кадри, тоді як інший націлений на готову для планування латентну динаміку замість повної візуальної реконструкції.
Три підходи можуть співіснувати: методи у стилі Dreamer акцентують навчання стратегій в уявному середовищі; генеративні відеомоделі світу — інтерактивне моделювання зовнішнього вигляду; I-JEPA від Meta AI демонструє прогнозування у просторі спільних вбудовувань замість реконструкції кожного пікселя. Різні системи також використовують різні рецепти навчання залежно від того, чи навчаються вони на парах вхідних і вихідних даних, розгортаннях керування або прогнозних вбудовуваннях. Спочатку узгодьте завдання, а вже потім обговорюйте назви.
Чим моделі світу відрізняються від LLM і генерації відео?
Усі три типи систем «прогнозують», але в межах генеративного ШІ вони прогнозують різні об’єкти та по-різному враховують дії: LLM прогнозують наступний токен, генератори відео — вигляд наступного кадру, а системи, орієнтовані на моделі світу, — те, як стан змінюється після дії.
| Вимір |
Модель світу |
Велика мовна модель (LLM) |
Генерація відео |
| Основний об’єкт прогнозування |
Наступний стан / латентна динаміка, часто з урахуванням дії |
Наступний токен / структура тексту |
Вигляд наступного кадру або кліпу |
| Зв’язок із дією |
Прогнозування з урахуванням дії є основою ухвалення рішень |
Зазвичай немає циклу фізичного керування |
Може враховувати текст/перший кадр, але не виконувану дію |
| Типове використання |
Планування, керування, втілений ШІ |
Мова, написання текстів, оркестрація інструментів |
Створення контенту, попередній перегляд, інтерактивні симуляції |
| Поширена плутанина |
Здатність до діалогу = модель світу |
Опис фізики = фізичне вміння |
Фотореалістичні кадри = правильна динаміка |
Отже, відеогенератор на зразок Sora може створювати узгоджені кадри з високою візуальною точністю та навіть видимою просторовою узгодженістю — і його можуть називати «відеомоделлю світу», — однак самі лише ці характеристики не доводять розуміння фізики. Без стабільного інтерфейсу дій, перевірюваних переходів стану та циклу планування точнішою категорією залишається генеративне відео. Потужніша система також може оцінювати послідовності дій для підтримки планування та ухвалення рішень, а не лише пасивно відтворювати ймовірні вигляди. LLM може описати сценарій «що буде, якщо злегка штовхнути чашку», але це не створює середовищну динаміку, яку можна розгорнути та оцінити.
Де найчастіше використовують моделі світу?
Втілений ШІ — поширена сфера застосування: маніпулятори та мобільні роботи потребують просторового інтелекту — міркувань про розташування, рух і зміни у фізичному світі — а також прогнозів контакту та переміщення до дотику до об’єктів, адже багато взаємодій складно скасувати після початку руху. Прогнозування з урахуванням дії дає системам змогу відкидати невдалі траєкторії в симуляції або латентному просторі до того, як виникнуть витрати через реальні зіткнення; демонстрації можуть ініціалізувати поведінку, але не замінюють навчання на основі взаємодії.
Ігри та навчання з підкріпленням на основі моделі — ще одна ключова сфера. Методи у стилі Dreamer покращують стратегії на уявних траєкторіях, завдяки чому корисне керування може з’являтися за меншої кількості реальних взаємодій. Подібні ідеї застосовуються до журналів промислового керування, де симулятор із прописаними вручну правилами є неповним, але історія спостережень значна, оскільки модель намагається відтворити динаміку системи на основі цієї історії.
Автономне керування автомобілями, планування роботи складів і симуляції з кількома агентами також містять компоненти моделей світу — не як повну заміну стеків планування, а як рівень прогнозування наслідків на короткому горизонті. Віртуальне тестування та відеодані, відібрані для конкретних завдань, часто використовують для навчання й оцінювання цих компонентів у різних сценаріях до реального розгортання. Будь-яка система керування, яка має «думати перед дією», може містити модуль моделі світу.
Які переваги, ризики та обмеження важливі під час оцінювання моделей світу?
Перевага полягає в ефективнішому використанні вибірки та безпечніших спробах і помилках: уявне моделювання може зменшити небезпечне дослідження, а прогнози з урахуванням дії можуть зробити планування заснованим на динаміці, яку можна перевірити. Обмеження та ризики часто проявляються, коли модель виглядає правильно, але не заслуговує на довіру, адже якісне внутрішнє представлення — не те саме, що поведінка, яка витримує реальне розгортання.
| Механізм |
Що ви бачите |
Чому це приховано |
Запитання для перевірки |
| Несправжня фізика |
Плавні траєкторії, що порушують закони збереження або контакту |
Візуальна плавність викликає довіру |
Чи зберігаються ключові величини? Чи можуть об’єкти проходити один крізь одного? |
| Дрейф на довгому горизонті |
Короткі розгортання працюють; довгі руйнуються |
Демонстрації переважно містять короткі кліпи |
Як зростає помилка з кількістю кроків? Чи є перепланування? |
| Збій поза розподілом даних |
Збій на нових об’єктах, освітленні або діапазонах дій |
Оцінки в межах розподілу виглядають високими |
Який протокол OOD? Чи оприлюднено режими збоїв? |
| Складне оцінювання |
Немає спільної оцінки «розуміння світу» |
Успішність завдання поглинає метрику |
Чи повідомляється помилка прогнозування окрім оцінки завдання? |
| Межа з симуляторами, створеними вручну |
Вивчені моделі розглядають як перевірені рушії |
Маркетинг змішує симулятор і модель світу |
Які обмеження закладено жорстко? Які є лише результатом апроксимації? |
Перенесення в реальність складне через розрив між симуляцією та реальним світом. Належні тести мають перевіряти, чи прогнозує модель керовані результати за дії, а не лише правдоподібні візуальні образи.
Використовуйте таблицю як контрольний список для заяв: підтвердьте наявність інтерфейсу з урахуванням дії, потім вимагайте доказів для довгих горизонтів і OOD, а насамкінець відокремте «виглядає добре» від «динаміку можна планувати». Без таких доказів безпечніше казати, що система «містить компоненти моделі світу або має дослідницькі цілі в цій сфері», а не «має повну модель світу». Оскільки агенти мають обмежену місткість, оцінювання має зосереджуватися на стані, важливому для цілей, а не на повному відтворенні сцени.
Підсумок
Моделі світу переводять ШІ від «уміє говорити / уміє малювати» до «уміє передбачати наслідки дій», наприклад прогнозувати, що робот перекине чашку, якщо вибере неправильний шлях. Робочою основою є замкнений цикл стану, дії та прогнозування, де прогнозування з урахуванням дії є найчіткішим критерієм ухвалення рішень.
Три підходи — MBRL/навчання в уявному середовищі, генеративне інтерактивне моделювання та прогнозні представлення JEPA — слугують різним цілям і не є взаємозамінними. Порівнюючи їх із LLM і генераторами відео, оцінюйте об’єкти прогнозування та інтерфейси дій; під час оцінювання приділяйте першочергову увагу несправжній фізиці, дрейфу, збоям OOD, суворим метрикам і межам симулятора.
Поширені запитання
Що таке модель світу?
Модель світу — це вивчена внутрішня модель динаміки, яка відображає, як середовище може змінюватися за поточного стану або спостереження та дії. Світ у будь-який момент є складнішим за те, що агент може безпосередньо спостерігати, тому модель узагальнює змінні, важливі для планування, — наприклад, місце, де опиниться робот після повороту ліворуч. Її призначення — підтримувати планування та спроби й помилки в уявному середовищі, а не лише генерувати текст або візуальний вигляд відео.
Чим модель світу відрізняється від великої мовної моделі?
Великі мовні моделі переважно прогнозують наступний токен і добре працюють із мовою та оркестрацією знань; моделі світу переважно прогнозують розвиток стану після дій для керування та планування. LLM може обговорювати фізику, не надаючи динаміки середовища, яку можна розгорнути та оцінити.
Як працює модель світу?
Типовий цикл кодує спостереження у стан, враховує можливу дію, прогнозує наступний стан після цієї дії та може продовжувати розгортання в латентному просторі. Планувальник порівнює уявні розгортання, виконує дію, а потім оновлює стан на основі нового спостереження.
Чи вважаються Sora або генерація відео моделлю світу?
Не автоматично. Якщо система переважно створює візуально узгоджене відео без стабільного інтерфейсу з урахуванням дії, перевірюваних переходів стану та використання для планування, її точніше описувати як генератор відео. Вона наближається до моделі світу лише тоді, коли продемонстровано прогнозування з урахуванням дії та цикл, придатний для планування.
Чим модель світу відрізняється від традиційного симулятора?
Традиційні симулятори зазвичай містять прописані вручну правила фізики та обмеження, тоді як моделі світу на основі даних часто навчаються за допомогою нейронних мереж. Вивчені моделі можуть бути гнучкішими та краще враховувати шум датчиків, але вони також більш схильні до несправжньої фізики й дрейфу на довгому горизонті, тому їх не слід вважати рівними перевіреному фізичному рушію.