Оскільки генеративний ШІ виходить за межі навчання моделей і переходить до масштабних комерційних застосувань, змінюється й фокус конкуренції на ринку обчислень для ШІ. Підприємствам потрібно не лише навчати потужніші моделі, а й безперервно обробляти запити користувачів за контрольованої вартості, запускати ШІ-агентів, генерувати голос і надавати інтерактивні послуги в реальному часі. На цьому тлі дедалі більше уваги привертає спеціалізована архітектура прискорення інференсу, представлена Groq. У цій статті розглядаються позиціонування Groq, технологія LPU, бізнес-модель GroqCloud і конкуренція в галузі, щоб проаналізувати її роль в інфраструктурі ШІ-інференсу, а також технічні й комерційні виклики спеціалізованого підходу до чипів.
Основні висновки
- Groq — компанія в галузі обчислювальних технологій, зосереджена на ШІ-інференсі. Її ключові технології включають чипи LPU, компілятори та допоміжну інфраструктуру для інференсу.
- Навчання ШІ та інференс мають різні вимоги до обчислень. Для інференсу в реальному часі особливо важливі час до першого токена, швидкість генерування та стабільність сервісу.
- LPU від Groq оптимізують певні навантаження ШІ-інференсу завдяки внутрішній SRAM-пам’яті, детермінованому виконанню та спільному проєктуванню апаратного й програмного забезпечення.
- GroqCloud перетворює базові обчислювальні можливості на хмарні API, що дає розробникам змогу викликати підтримувані моделі ШІ.
- LPU та GPU відрізняються архітектурою й відповідними сценаріями застосування. Загальну продуктивність не можна оцінювати лише за швидкістю генерування одного токена.
- Довгострокова комерційна конкурентоспроможність Groq залежить від масштабованості чипів, її програмної екосистеми, витрат на інференс, попиту клієнтів і окупності інвестицій в інфраструктуру.
Що таке Groq і яку роль вона відіграє в ланцюгу створення вартості ШІ-обчислень?
Groq — технологічна компанія, зосереджена на обчисленнях для ШІ-інференсу. Вона була заснована у 2016 році Джонатаном Россом, який раніше брав участь у проєкті Google TPU. Компанія переважно розробляє спеціалізовані чипи прискорення ШІ, компілятори та обчислювальні системи для інференсу, а також надає розробникам і підприємствам можливості інференсу моделей через такі сервіси, як GroqCloud.
Важливо зазначити, що Groq і Grok — це не один продукт. Groq — назва технології, пов’язаної з інфраструктурою обчислень для ШІ, тоді як Grok — модель штучного інтелекту та асистент, розроблені xAI. Хоча їхні назви схожі, вони належать різним компаніям і мають різне технологічне позиціонування та бізнес-моделі.
У ланцюгу створення вартості ШІ Groq переважно позиціонується на рівні обчислювальної інфраструктури. Повноцінний застосунок генеративного ШІ зазвичай охоплює розроблення моделі, обчислення для навчання, розгортання інференсу, інтерфейси застосунків і послуги для кінцевих користувачів. Основний бізнес Groq не полягає в розробленні універсальних чат-моделей для споживачів. Натомість вона прагне забезпечувати високопродуктивні середовища інференсу для різних моделей.
Наприклад, під час створення ШІ-асистента в реальному часі розробники можуть вибрати вже навчену модель і використовувати сервіс інференсу для обробки введених користувачем даних. Модель розуміє запитання та генерує контент, тоді як базова обчислювальна платформа визначає швидкість роботи моделі й обсяг обчислювальних ресурсів, який споживає кожен запит.
Оптимізація цього обчислювального процесу є основою ціннісної пропозиції Groq. Завдяки спеціально розробленим процесорам і програмним системам Groq зменшує накладні витрати виконання для певних завдань інференсу, даючи моделям змогу швидше генерувати відповіді.
Таке позиціонування означає, що ринкові можливості Groq залежать не лише від популярності конкретної моделі ШІ, а й від попиту на інференс у всій індустрії генеративного ШІ, архітектур моделей і змін у вартості обчислень.
Чому індустрія ШІ приділяє більше уваги обчисленням для інференсу?
Обчислення ШІ загалом можна поділити на два етапи: навчання та інференс. Навчання передбачає використання великих обсягів даних для налаштування параметрів моделі, щоб вона могла набути таких можливостей, як розуміння мови та розпізнавання зображень. Інференс означає, що навчена модель отримує нові вхідні дані та генерує результат на основі наявних параметрів.
Обидва етапи потребують обчислювальних ресурсів, проте їхні навантаження суттєво відрізняються. Навчання моделі зазвичай передбачає обробку великих наборів даних, обчислення градієнтів і оновлення параметрів. Воно акцентує увагу на масштабних паралельних обчисленнях, обсязі пам’яті та координації між кількома пристроями. Інференс, навпаки, має швидко генерувати результати у відповідь на запити користувачів. Це особливо важливо для чатів, голосових і автоматизованих застосунків, де час відповіді безпосередньо впливає на користувацький досвід.
Для великих мовних моделей процес інференсу зазвичай охоплює два етапи: Prefill і Decode. Prefill обробляє вхідний промпт і створює відповідний обчислювальний стан, тоді як Decode послідовно генерує наступні токени. Оскільки авторегресійним мовним моделям зазвичай потрібно передбачати наступний токен на основі вже згенерованого контенту, безперервний процес генерування висуває значні вимоги до ефективності доступу до пам’яті та планування обчислень.
Користувачі звичайних чат-застосунків можуть прийнятно сприймати коротке очікування. Проте в голосових асистентах реального часу, автоматизованій службі підтримки та інтерактивних сценаріях ШІ затримка відповіді безпосередньо впливає на природність розмови. Якщо моделі потрібно надто багато часу для генерування першої частини відповіді або її швидкість виведення недостатня для спілкування в реальному часі, вона може не відповідати практичним бізнес-вимогам, навіть якщо сама модель має високі можливості.
Розвиток ШІ-агентів додатково підвищив попит на інференс. На відміну від одноразової взаємодії у форматі запитання-відповідь, ШІ-агенту може знадобитися викликати кілька моделей, аналізувати зовнішні дані, виконувати операції з інструментами та перевіряти результати. Одне завдання користувача може спричинити кілька раундів внутрішнього міркування та кілька API-запитів, збільшуючи загальне споживання обчислювальних ресурсів.
У результаті конкуренція в інфраструктурі ШІ виходить за межі простого прагнення до більших можливостей навчання моделей. Тепер вона також зосереджується на наданні послуг інференсу з меншою затримкою, вищою пропускною здатністю та обґрунтованішою вартістю.
Водночас зростання попиту на інференс не означає, що обчислення для навчання стають менш важливими. Навчання нових моделей, донавчання моделей і надання послуг інференсу можуть продовжувати зростати одночасно. Відмінність полягає в тому, що вимоги до апаратного забезпечення для різних обчислювальних завдань стають дедалі спеціалізованішими.
Які ключові характеристики технологічного підходу Groq LPU?
LPU — технічний термін, який Groq використовує для опису свого спеціалізованого процесора для інференсу. Порівняно з універсальними GPU, розробленими для широкого спектра обчислювальних завдань, дизайн LPU більше зосереджений на обчисленнях, переміщенні даних і контролі затримки для певних навантажень ШІ.
Технологію Groq LPU можна розглянути через три аспекти: внутрішню пам’ять, детерміноване виконання та компілятори.
Як внутрішня SRAM-пам’ять впливає на ефективність доступу до даних?
Сучасні обчислення ШІ обмежуються не лише арифметичними можливостями чипа, а й швидкістю доступу до даних та їх передавання. Під час інференсу великої мовної моделі обчислювальні блоки мають безперервно звертатися до ваг моделі та проміжних даних. Якщо дані не надходять вчасно, процесор може не використовувати свої ресурси повною мірою, навіть за високої теоретичної обчислювальної потужності.
Однією з важливих характеристик LPU від Groq є акцент на внутрішній SRAM-пам’яті — статичній пам’яті з довільним доступом. SRAM зазвичай забезпечує меншу затримку доступу та може допомагати процесорам швидко зчитувати необхідні дані. Порівняно з конструкціями, які залежать від зовнішньої високошвидкісної пам’яті з більшою місткістю, ця архітектура намагається зменшити накладні витрати на доступ до даних для певних обчислювальних завдань.
SRAM також має обмеження щодо вартості та місткості. За однакової площі чипа SRAM зазвичай не може забезпечити такий самий обсяг зберігання, як зовнішня пам’ять великої місткості. Тому для розгортання моделей із більшою кількістю параметрів можуть знадобитися координація кількох чипів, розподіл моделі та оптимізація на рівні системи для виконання вимог до місткості.
Це означає, що внутрішня SRAM-пам’ять не є за своєю суттю кращою за будь-яку іншу архітектуру пам’яті. Її цінність залежить від конкретної моделі та навантаження, а також від того, чи може обчислювальна система ефективно координувати зберігання й передавання даних.
Чому детерміноване виконання важливе?
Ще одним ключовим елементом дизайну Groq є детерміноване виконання. За такого архітектурного підходу компілятор може заздалегідь планувати велику кількість обчислювальних операцій і передавань даних, даючи процесору змогу працювати відповідно до наперед визначеного розкладу виконання.
Традиційні GPU зазвичай мають підтримувати різноманітні обчислювальні завдання, динамічне планування та складні програмні середовища, що забезпечує їм високу універсальність. Groq, навпаки, намагається зменшити частину невизначеності, пов’язаної з плануванням під час виконання та координацією ресурсів, завдяки чіткішим планам виконання.
Для інференсу з низькою затримкою передбачуваний час виконання має практичну цінність. Надаючи послуги ШІ в реальному часі, підприємства зважають не лише на середню швидкість відповіді, а й на коливання затримки між різними запитами. Якщо сервіс час від часу відчуває значні затримки відповіді, це може погіршити користувацький досвід, навіть якщо середня продуктивність висока.
Детерміноване виконання не означає, що кожен запит матиме абсолютно однаковий час відповіді. На фактичну затримку можуть і далі впливати такі чинники, як довжина вводу, довжина виводу, стратегії пакетної обробки, навантаження системи та стан мережі.
Як компілятор сприяє оптимізації продуктивності LPU?
Технологічний підхід Groq не покладається лише на апаратне забезпечення для підвищення продуктивності. Він акцентує увагу на спільному проєктуванні апаратного й програмного забезпечення. Компілятор має аналізувати обчислювальний граф моделі та зіставляти відповідні операції з обчислювальними ресурсами й ресурсами зберігання чипа.
У цьому процесі компілятор відповідає не лише за перетворення моделі на виконувані інструкції, а й за організацію передавання даних, послідовностей обчислень і використання ресурсів, щоб різні обчислювальні блоки могли працювати разом відповідно до наперед визначеного плану.
Такий дизайн дає змогу здійснювати глибоку оптимізацію для підтримуваних моделей, проте також висуває значні вимоги до програмного інструментарію. Коли змінюються структури моделей, типи операторів або вимоги до інференсу, платформі потрібно безперервно вдосконалювати свій компілятор і середовище виконання.
Отже, технологічна конкурентоспроможність Groq походить не лише від самого чипа LPU, а й від її компілятора, можливостей адаптації моделей і скоординованої ефективності всієї системи інференсу.
Як GroqCloud перетворює обчислення LPU на комерційний сервіс?
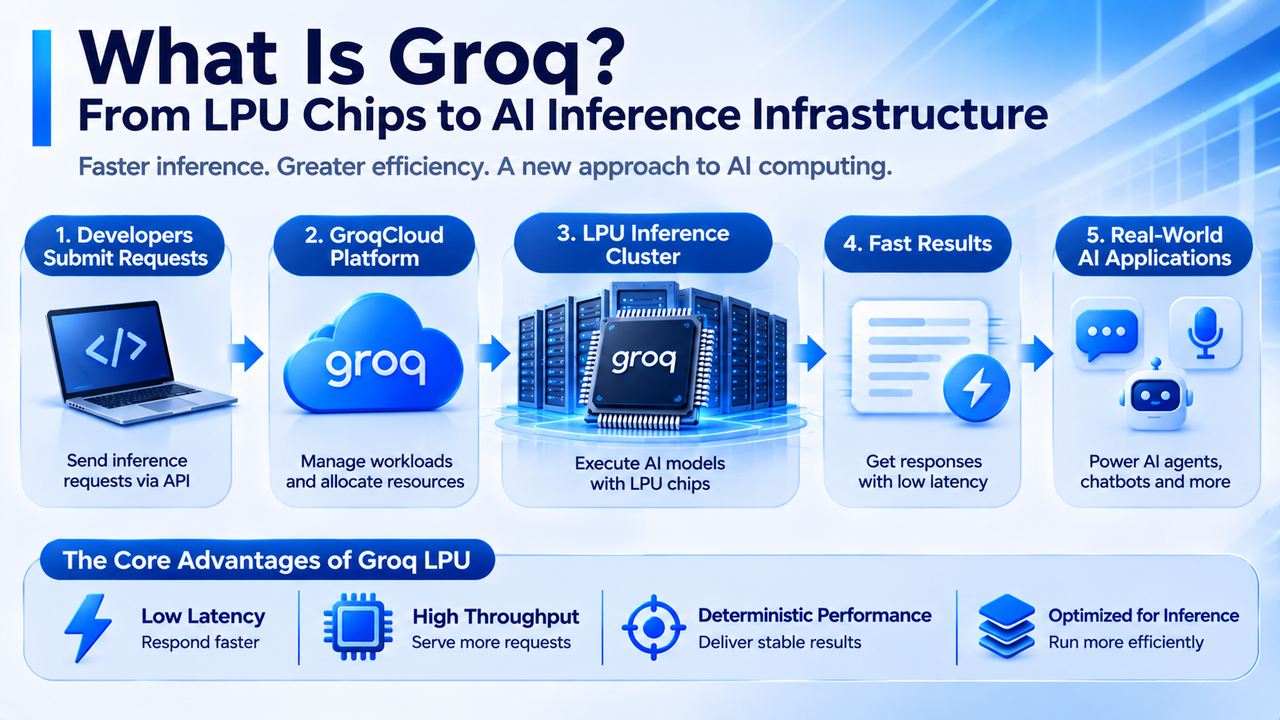
GroqCloud — це хмарний сервіс ШІ-інференсу Groq для розробників і підприємств. Він об’єднує базові чипи, обчислювальні кластери та середовища виконання моделей у сервіси, доступні через API. Це дає клієнтам змогу використовувати інфраструктуру інференсу Groq без самостійного придбання й розгортання спеціалізованих чипів.
У типовому застосуванні розробники спочатку вибирають модель, яку підтримує платформа, а потім надсилають текстові або інші типи введених даних через API. GroqCloud отримує запит, призначає відповідне обчислювальне завдання базовій системі інференсу та повертає згенерований результат до застосунку. Цей процес охоплює планування запитів, виконання моделі, керування ресурсами та передавання результатів.
Для корпоративних клієнтів основною перевагою використання хмарного сервісу інференсу є нижчий бар’єр для розгортання інфраструктури. Самостійне створення кластера обчислень ШІ зазвичай потребує придбання обладнання, налаштування мереж, розгортання моделей і підтримки середовища виконання. Використання сервісу інференсу через API перетворює частину фіксованих інвестицій в інфраструктуру на витрати на послуги, що змінюються залежно від використання бізнесом.
Платформа Groq також розширюється від єдиного API інференсу до комплексніших послуг інфраструктури для підприємств. Її портфель продуктів включає спеціалізовану обчислювальну інфраструктуру, програмний стек інференсу та можливості корпоративного рівня для управління й контролю, щоб задовольняти різні вимоги клієнтів до продуктивності, способів розгортання та прав адміністрування.
Водночас комерційна цінність хмарного сервісу інференсу не залежить повністю від швидкості чипа. Підприємства також мають враховувати підтримку моделей, стабільність API, доступність сервісу, безпеку даних і вартість кожного запиту. Якщо платформа підтримує лише обмежений набір моделей або операторів, вона може не відповідати всім вимогам корпоративних застосунків, навіть якщо забезпечує низьку затримку для окремих завдань.
Щодо моделей доходу, хмарні сервіси інференсу зазвичай можуть стягувати плату на основі використання моделі, кількості оброблених токенів або зарезервованої обчислювальної потужності. Різні методи ціноутворення створюють різні вимоги до управління ресурсами. Виставлення рахунків за використання більше залежить від фактичного обсягу запитів, тоді як сервіси із зарезервованою потужністю потребують уваги до контрактів із клієнтами, надання ресурсів і завантаженості обладнання.
Отже, здатність GroqCloud комерціалізувати свою технологію зрештою залежить від того, чи зможе вона перетворити базові переваги продуктивності LPU на стабільні, масштабовані та конкурентоспроможні за вартістю сервіси інференсу.
Як партнерство Groq із NVIDIA змінює її позиціонування в галузі?
Відносини Groq із NVIDIA є важливим контекстом для розуміння її поточного позиціонування в галузі.
У грудні 2025 року Groq і NVIDIA уклали невиключну угоду про ліцензування технологій ШІ-інференсу. Згідно з розкритою обома сторонами інформацією, NVIDIA отримала ліцензію на відповідну технологію інференсу Groq, а засновник Groq Джонатан Росс, тодішній президент Санні Мадра та деякі члени команди приєдналися до NVIDIA. Groq продовжила працювати як незалежна компанія під керівництвом генерального директора Саймона Едвардса, а її бізнес GroqCloud залишився активним.
Ця угода означає, що технологічна цінність Groq відображається не лише в незалежному продажу послуг інференсу, а й у входженні до ширшої екосистеми обчислень ШІ через ліцензування технологій.
У березні 2026 року NVIDIA додатково представила архітектуру прискорення інференсу Groq 3 LPX і поєднала її з платформою Vera Rubin. Відповідне рішення намагається розподіляти навантаження між GPU та LPU залежно від обчислювальних характеристик різних етапів ШІ-інференсу, щоб підвищити ефективність інференсу з низькою затримкою. Такий розвиток відображає дедалі більшу складність конкуренції на ринку ШІ-чипів. У минулому спеціалізовані чипи для інференсу часто розглядалися як потенційна заміна GPU. Однак у гетерогенних обчислювальних архітектурах різні типи процесорів також можуть виконувати взаємодоповнювальні завдання.
Наприклад, GPU можуть обробляти масштабні паралельні обчислення та певні обчислення механізму уваги, які відповідають їхній архітектурі, тоді як LPU можуть обробляти завдання, чутливіші до часу виконання та затримки передавання даних. Завдяки плануванню на рівні системи два типи процесорів можуть працювати разом над одним навантаженням інференсу.
Водночас гетерогенні архітектури також створюють додаткову інженерну складність. Системам потрібно координувати передавання даних, розподіл завдань і управління пам’яттю між різними пристроями. Якщо накладні витрати на міжпристроєвий зв’язок надто високі, теоретичні переваги апаратного забезпечення можуть не повністю перетворитися на практичну продуктивність.
У серпні 2026 року Groq також оголосила про приєднання до програми NVIDIA Cloud Partner, ще більше зміцнивши своє позиціонування як оператора хмарної інфраструктури ШІ. Тому Groq більше не можна просто описувати як компанію з виробництва чипів, повністю незалежну від екосистеми NVIDIA та зосереджену лише на конкуренції з GPU. Її поточний бізнес включає незалежні хмарні сервіси інференсу, технології спеціалізованих чипів та інфраструктурну співпрацю з NVIDIA.
Як бізнес-модель Groq адаптується до зростання ринку ШІ-інференсу?
Комерційний попит на ринку ШІ-інференсу переважно формується корпоративними застосунками, сервісами для розробників і продуктами ШІ, що працюють безперервно. На відміну від навчання моделей, яке зазвичай має проєктний характер і відбувається поетапно, послуги інференсу мають безперервно надавати обчислювальні потужності зі зміною користувацького трафіку. Тому вони більше акцентують увагу на використанні ресурсів, питомих витратах і стабільності сервісу.
Бізнес-модель Groq можна розуміти на трьох рівнях.
-
Створення інфраструктури інференсу. Groq має створювати придатні до використання обчислювальні потужності за допомогою чипів, серверів, мереж і центрів обробки даних. Ці активи можуть підтримувати запити клієнтів і генерувати дохід лише після завершення розгортання обладнання, адаптації моделей і запуску сервісу.
-
Хмарні послуги інференсу. GroqCloud перетворює обчислювальну потужність на API, які можуть викликати розробники, без необхідності для клієнтів безпосередньо керувати базовими чипами. Для постачальника послуг зростання доходу залежить від кількості клієнтів, обсягу запитів, ціноутворення на послуги та утримання клієнтів.
-
Послуги інфраструктури для підприємств. Деяким підприємствам можуть знадобитися виділені обчислювальні ресурси, конкретні методи розгортання або суворіші вимоги до управління. Такі потреби можуть створювати стабільніші довгострокові відносини з клієнтами, але також потребують більших інвестицій в інженерію, операційну діяльність і підтримку клієнтів.
У червні 2026 року Groq оголосила, що залучила $650 млн фінансування для зростання, щоб розширити свій глобальний бізнес хмарного ШІ-інференсу, поставивши за мету досягти приблизно 200 МВт потужності інфраструктури до 2027 року. Тоді компанія повідомила, що керувала 13 центрами обробки даних у кількох регіонах, обслуговувала понад 5 млн розробників і щотижня обробляла десятки трильйонів токенів ШІ.
Ці показники можна використовувати для оцінки темпів розширення бізнесу, але вони не демонструють прибутковість безпосередньо. Кількість розробників, обсяг токенів і кількість центрів обробки даних відображають відповідно охоплення користувачів, активність сервісу та масштаб інфраструктури. Вони не дорівнюють фактичному доходу, прибутку чи вільному грошовому потоку.
Наприклад, припустімо, що кількість токенів, оброблених платформою інференсу щомісяця, зростає на 100%, але ціна за токен знижується на 40% через ринкову конкуренцію. Тоді зростання її доходу може бути нижчим за зростання використання. Якщо в той самий період також зростають витрати на створення та експлуатацію інфраструктури, маржа прибутку може зазнати ще більшого впливу.
Тому аналіз комерційного потенціалу Groq потребує одночасного врахування зростання попиту на інференс, ціноутворення на послуги, завантаженості обладнання та капітальних витрат. Ринкову вартість не можна оцінювати лише на основі швидкості виконання моделі.
З якими технічними викликами та викликами масштабування стикається Groq?
Хоча спеціалізовані чипи для інференсу можуть бути оптимізовані для конкретних навантажень, Groq усе ще стикається з викликами, що виникають через зміни моделей, масштабування апаратного забезпечення та ринкову конкуренцію.
Адаптація моделей. Архітектури моделей ШІ продовжують швидко розвиватися. Різні моделі можуть використовувати різні механізми уваги, масштаби параметрів, обчислювальну точність і стратегії інференсу. Якщо спеціалізований процесор має підтримувати більше моделей, його компілятор, середовище виконання та пов’язані програмні інструменти потрібно безперервно оновлювати.
Це також означає, що перевага продуктивності, досягнута одним поколінням чипів на конкретній моделі, може не переноситися безпосередньо на кожну нову модель. У міру розвитку інференсу з довгим контекстом, моделей суміші експертів і мультимодальних обчислень базові обчислювальні системи мають постійно адаптуватися до нових навантажень.
Масштабування на кілька чипів. LPU від Groq акцентують увагу на внутрішній SRAM-пам’яті та детермінованому виконанні, але великі моделі часто потребують ресурсів зберігання й обчислень, що перевищують можливості одного чипа. Коли модель розподілена між кількома чипами, система має координувати передавання даних і послідовності обчислень між пристроями.
Якщо зв’язок між кількома чипами є неефективним, перевага низької затримки одного чипа може зменшитися. Тому з’єднання між чипами, пропускна здатність системи та можливості планування компілятора є важливими чинниками, які визначають, чи може спеціалізована архітектура інференсу масштабуватися.
Витрати на створення інфраструктури. Навіть якщо чипи забезпечують високу обчислювальну ефективність, створення центру обробки даних для ШІ все одно потребує підключення до електромережі, приміщень, систем охолодження та мережевої інфраструктури. У міру розширення послуг інференсу Groq також доведеться нести відповідні капітальні та операційні витрати.
Ринкова конкуренція. GPU NVIDIA, GPU AMD, TPU Google та інші спеціалізовані прискорювачі ШІ конкурують за попит на обчислення для інференсу. Кожна з різних платформ може мати переваги щодо сумісності моделей, пропускної здатності, затримки, вартості та програмних екосистем.
Для корпоративних клієнтів остаточний вибір зазвичай не визначається одним показником продуктивності. Він залежить від сукупної вартості послуг, сумісності застосунків і довгострокової операційної надійності. Тому те, чи зможе технологічний підхід Groq забезпечити стійку конкурентоспроможність, залежить не лише від архітектури LPU, а й від того, чи зможе компанія надалі розширювати підтримку програмного забезпечення, підвищувати використання обчислювальних ресурсів і контролювати витрати на розширення інфраструктури.
Що Groq означає для ШІ-чипів та обчислювальної індустрії?
Технологічний підхід, представлений Groq, відображає поступовий перехід індустрії ШІ-обчислень від архітектур, орієнтованих на універсальні прискорювачі, до гетерогенних обчислювальних систем, оптимізованих для різних навантажень. На ранніх етапах розвитку генеративного ШІ можливості навчання були важливим рушієм прогресу індустрії. У міру того як дедалі більше моделей переходять до практичного застосування, послуги інференсу починають формувати постійний попит на обчислення, посилюючи вимоги підприємств до низької затримки, ефективності витрат і стабільності сервісу.
Це створює простір для розвитку спеціалізованих чипів для інференсу. Завдяки оптимізації апаратного й програмного забезпечення для конкретних обчислювальних процесів спеціалізовані архітектури можуть забезпечувати переваги в продуктивності або вартості для певних завдань.
Однак це не означає, що GPU буде повністю замінено спеціалізованими чипами для інференсу. GPU мають широкі програмні екосистеми, значну підтримку моделей і універсальні обчислювальні можливості, що дає їм змогу адаптуватися до різних навантажень навчання та інференсу. Натомість спеціалізовані прискорювачі можуть відігравати роль для конкретних моделей, етапів обчислень або сценаріїв із низькою затримкою.
Технологічна співпраця NVIDIA та Groq додатково свідчить, що майбутні центри обробки даних ШІ можуть одночасно розгортати різні типи обчислювальних пристроїв і координувати їх за допомогою програмних систем планування. Такий підхід може підвищити використання обчислювальних ресурсів, але також збільшить складність проєктування та управління системою.
Для індустрії інфраструктури ШІ фокус конкуренції може поступово зміщуватися від теоретичної продуктивності окремих чипів до здатності надавати повноцінні обчислювальні системи. Продуктивність чипів, пропускна здатність пам’яті, з’єднання між пристроями, компілятори, енергоефективність і експлуатація хмарних сервісів можуть впливати на кінцеву комерційну віддачу.
Розвиток Groq також показує, що інфраструктура ШІ-інференсу — це не лише питання виробництва чипів. Це інтегрована галузь, яка охоплює апаратну архітектуру, оптимізацію програмного забезпечення, створення центрів обробки даних і надання комерційних послуг.
Висновок
Groq — технологічна компанія, зосереджена на обчисленнях для ШІ-інференсу. Її архітектура LPU використовує такі елементи дизайну, як внутрішня SRAM-пам’ять, детерміноване виконання та планування компілятором, щоб підвищити ефективність виконання для певних навантажень ШІ. GroqCloud перетворює базові обчислювальні можливості на хмарні послуги інференсу, даючи змогу розробникам і підприємствам використовувати відповідну інфраструктуру через API.
У міру того як застосунки ШІ виходять за межі навчання моделей і охоплюють взаємодію в реальному часі, ШІ-агентів та корпоративні сервіси, що працюють безперервно, затримка інференсу, пропускна здатність і вартість стають дедалі важливішими технічними показниками. Спеціалізована архітектура інференсу, представлена Groq, пропонує індустрії ШІ-обчислень альтернативний підхід до універсальних GPU.
Водночас ліцензування технологій Groq та інфраструктурна співпраця з NVIDIA показують, що спеціалізовані чипи для інференсу й GPU не обов’язково мають лише конкурувати. Майбутні центри обробки даних ШІ можуть дедалі частіше застосовувати гетерогенні обчислювальні архітектури, у яких різні процесори обробляють завдання, що відповідають їхнім характеристикам.
Однак технічні переваги спеціалізованих чипів не перетворюються на комерційний успіх автоматично. Groq усе ще має розв’язати питання адаптації моделей, масштабування на кілька чипів, витрат на інфраструктуру та прибутковості хмарних послуг. Її довгостроковий розвиток залежатиме від того, чи зможе вона перетворити переваги продуктивності інференсу на стабільний попит клієнтів, сталий дохід і обґрунтовану віддачу від капіталу.
Поширені запитання
Яка компанія Groq?
Groq — технологічна компанія, зосереджена на обчисленнях для ШІ-інференсу. Її основні напрями діяльності включають спеціалізовані процесори LPU, обчислювальні системи інференсу та хмарні сервіси інференсу GroqCloud.
Groq і Grok — це один продукт?
Ні. Groq — технологічна компанія, пов’язана з інфраструктурою ШІ-інференсу, тоді як Grok — модель штучного інтелекту та асистент, розроблені xAI.
Що таке Groq LPU?
LPU — це спеціалізований процесор ШІ-інференсу, розроблений Groq. Він акцентує увагу на внутрішній SRAM-пам’яті, детермінованому виконанні, плануванні компілятором і обчисленнях із низькою затримкою.
Чим Groq LPU відрізняється від NVIDIA GPU?
LPU більше акцентують увагу на оптимізації обчислень і передавання даних для конкретних завдань інференсу, тоді як GPU забезпечують ширші можливості паралельних обчислень і програмні екосистеми. Фактична продуктивність залежить від моделі, розміру пакета, вимог до затримки та середовища розгортання.
Чи була Groq придбана NVIDIA?
Станом на листопад 2026 року Groq продовжує працювати як незалежна компанія. У грудні 2025 року сторони уклали невиключну угоду про ліцензування технологій, а деякі члени команди Groq приєдналися до NVIDIA. Це не означає, що NVIDIA завершила повне придбання Groq.
Що таке GroqCloud?
GroqCloud — хмарний сервіс ШІ-інференсу Groq. Він дає розробникам змогу викликати моделі, які підтримує платформа, через API, без самостійного придбання й розгортання базового обчислювального обладнання.
Чому Groq привернула увагу на ринку ШІ-обчислень?
Технологічний підхід Groq оптимізує затримку, передавання даних і ефективність виконання в ШІ-інференсі. Це відповідає вимогам до ефективності обчислень у застосунках ШІ реального часу, ШІ-агентах і корпоративних послугах інференсу.
Чи має Groq власну криптовалюту?
Groq — компанія в галузі інфраструктури ШІ-обчислень. Її бізнеси LPU та GroqCloud не залежать від нативного криптовалютного токена. Сторонні токени зі схожими назвами не слід безпосередньо вважати активами, випущеними або схваленими Groq.