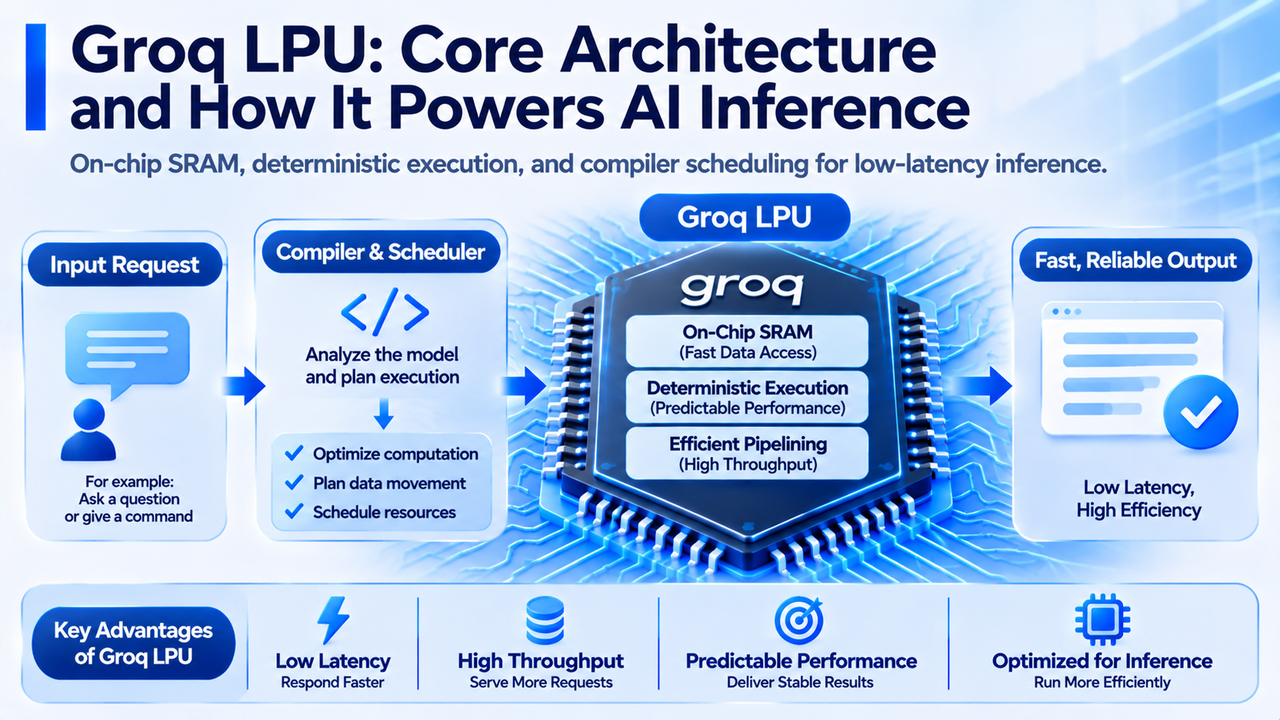
На відміну від графічних процесорів (GPU), призначених для широкого спектра завдань масивно-паралельних обчислень, LPU Groq використовують архітектуру з акцентом на внутрішньочипову SRAM, статичне планування компілятором і детерміноване виконання. Такий підхід спрямований на зменшення передавання даних і накладних витрат на планування під час виконання інференсу, забезпечуючи більш цільові обчислювальні можливості для ШІ-застосунків у реальному часі.
Оскільки великі мовні моделі дедалі частіше використовують в інтелектуальній службі підтримки, голосовій взаємодії, ШІ-агентах і корпоративній автоматизації, вимоги до інференсу виходять за межі простого максимізування швидкості обробки. Вони також охоплюють затримку відповіді, стабільність сервісу та обчислювальні витрати на одиницю. Підхід зі спеціалізованими прискорювачами, який представляють LPU Groq, пропонує інфраструктурі ШІ технічний варіант, відмінний від традиційних архітектур обчислень загального призначення. У цій статті докладно розглянуто принцип роботи LPU Groq, проаналізовано вплив SRAM, детермінованого виконання та компіляторів на продуктивність інференсу, а також обговорено сфери їх застосування й технічні обмеження.
Основні висновки
-
Groq LPU — це спеціалізований процесор для завдань ШІ-інференсу з акцентом на низьку затримку, передбачуване виконання та ефективне передавання даних.
-
Інференс великих мовних моделей зазвичай складається з двох етапів: Prefill і Decode. Ці етапи мають різні вимоги до обчислювальної потужності та пропускної здатності пам’яті.
-
LPU Groq використовують внутрішньочипову SRAM для скорочення певних шляхів доступу до даних, однак відносно обмежена ємність внутрішньочипового сховища також висуває вимоги до розгортання моделей і масштабування на кілька чипів.
-
Детерміноване виконання та статичне планування компілятором можуть зменшити частину накладних витрат на планування під час роботи, але це не означає, що кожен запит матиме абсолютно однаковий час відповіді.
-
LPU мають потенційні переваги в застосунках із низькою затримкою, таких як генерування тексту в реальному часі та голосова взаємодія. Їхня фактична продуктивність усе одно залежить від моделі, навантаження, конфігурації системи та вартості послуг.
Що таке Groq LPU і чим він відрізняється від традиційних ШІ-прискорювачів?
Groq LPU — це спеціалізований процесор для ШІ-інференсу, розроблений Groq. LPU означає Language Processing Unit, тобто пристрій обробки мови. Його конструкція призначена для оптимізації переміщення даних, виконання обчислень і контролю затримки під час інференсу мовних моделей, а не для надання можливостей обчислень загального призначення для кожного типу завдань.
Щоб зрозуміти технічне позиціонування LPU, спочатку необхідно розглянути різні підходи до проєктування ШІ-прискорювачів. Спочатку GPU переважно розробляли для обробки графіки. Пізніше їх почали широко застосовувати для навчання та інференсу моделей глибокого навчання завдяки можливостям масштабних паралельних обчислень і зрілій програмній екосистемі. Спеціалізовані прискорювачі, такі як TPU, підвищують ефективність виконання окремих обчислювальних завдань завдяки оптимізації операцій для машинного навчання.
LPU Groq додатково акцентують увагу на координації між компілятором і апаратним забезпеченням. Їхня архітектура має на меті спланувати обчислення та передавання даних до виконання моделі, щоб чип виконував завдання за заздалегідь визначеним графіком і таким чином зменшував частину накладних витрат, пов’язаних із динамічним плануванням.
Цей підхід до проєктування тісно пов’язаний із технологічним напрямом Tensor Streaming Processor (TSP), який Groq представила на ранніх етапах свого розвитку. Завдяки організації обчислювальних ресурсів, внутрішньочипового сховища та шляхів передавання даних процесор забезпечує виконання операцій моделі в послідовності, визначеній компілятором.
Важливо зазначити, що LPU не є стандартизованою галузевою категорією для всіх процесорів мовних моделей. Це технічна назва, яку використовує Groq. Різні виробники можуть застосовувати різні конструкції чипів або досягати низької затримки інференсу за допомогою GPU, ASIC чи інших спеціалізованих прискорювачів.
Тому для оцінювання технічної цінності LPU Groq недостатньо враховувати лише назву процесора. Потрібно проаналізувати, як вони обробляють доступ до даних, планування обчислень і міжчипову комунікацію під час інференсу.
Чому великим мовним моделям потрібні обчислення з низькою затримкою?
Інференс великих мовних моделей — це процес, у якому модель отримує вхідні дані та використовує навчені параметри для генерування результату. Для поширених авторегресійних мовних моделей інференс зазвичай складається з двох етапів: Prefill і Decode. На етапі Prefill переважно обробляється запит користувача та формується обчислювальний стан, необхідний для подальшого генерування. Оскільки на цьому етапі можна одночасно обробляти кілька вхідних токенів, він зазвичай має виражені характеристики паралельних обчислень.
На етапі Decode вихідні токени генеруються по одному. Моделі зазвичай потрібно передбачити наступний токен на основі наявних вхідних даних і раніше згенерованого вмісту, тому між кількома кроками генерування існують залежності. Унаслідок цього такі кроки не можна повністю розпаралелити так само легко, як деякі обчислення під час навчання.
Ця відмінність означає, що продуктивність інференсу не можна вимірювати за допомогою одного показника.
Час до першого токена (TTFT) вимірює час від початку запиту до генерування першого вихідного токена. Він переважно впливає на те, як довго користувачі відчувають очікування відповіді.
Швидкість генерування токенів вимірює, скільки токенів модель може згенерувати за одиницю часу після початку виведення результату. Вона безпосередньо впливає на плавність безперервного генерування тексту. Пропускна здатність зосереджується на кількості запитів або токенів, які система може обробити протягом певного періоду, і відображає загальну обчислювальну спроможність сервісу інференсу за відносно високого одночасного навантаження.
Наприклад, дві платформи інференсу можуть підтримувати ту саму мовну модель, але платформа A може забезпечувати швидше генерування токенів для окремого запиту користувача, тоді як платформа B може досягати вищої загальної пропускної здатності під час одночасної обробки сотень запитів.
Це означає, що низька затримка та висока пропускна здатність не є ідентичними цілями продуктивності. Система, оптимізована для взаємодії в реальному часі з одним користувачем, може не мати таких самих переваг у кожному сценарії пакетної обробки або високої одночасності.
Для голосових помічників, перекладу в реальному часі та інтерактивних ШІ-застосунків TTFT і швидкість безперервного генерування мають особливе значення. Користувачі зазвичай очікують, що система швидко почне відповідати та продовжуватиме створювати природний, зв’язний вміст.
Для таких завдань, як офлайн-аналіз документів і пакетна обробка даних, негайний час відповіді на окремий запит може бути менш важливим. Натомість підприємства можуть більше зосереджуватися на загальній пропускній здатності та витратах на обробку одиниці даних.
Одним із пріоритетів проєктування LPU Groq є оптимізація ефективності виконання для завдань інференсу, чутливих до часу відповіді.
Як LPU Groq використовують SRAM для підвищення ефективності доступу до даних?
Продуктивність сучасних ШІ-процесорів залежить не лише від кількості операцій, які можуть виконувати їхні обчислювальні блоки, а й від того, чи можуть дані вчасно надходити до цих блоків.
Під час інференсу великих мовних моделей процесори багаторазово зчитують ваги моделі, отримують доступ до проміжних результатів і підтримують дані, пов’язані з контекстом. Якщо дані не вдається зчитувати достатньо швидко, навіть чип із високою теоретичною обчислювальною потужністю може не працювати на повну потужність через очікування даних.
Цю проблему зазвичай називають вузьким місцем пам’яті.
Однією з ключових архітектурних характеристик LPU Groq є акцент на використанні внутрішньочипової SRAM (статичної оперативної пам’яті) для зберігання даних і доступу до них.
SRAM зазвичай забезпечує низьку затримку доступу та може бути безпосередньо інтегрована в чип процесора. Порівняно з даними, доступ до яких здійснюється через зовнішній інтерфейс пам’яті, внутрішньочипове сховище може скоротити шляхи передавання даних і зменшити частину накладних витрат на доступ.
Щоб зрозуміти цю конструкцію, корисно порівняти базові характеристики SRAM і пам’яті з високою пропускною здатністю (HBM).
| Параметр порівняння |
SRAM |
HBM |
| Типове розташування |
Усередині чипа процесора |
Окремий стек пам’яті в корпусі процесора |
| Основні переваги |
Низька затримка доступу та тісна інтеграція |
Більша ємність і висока сукупна пропускна здатність |
| Основні обмеження |
Висока вартість площі чипа та обмежена ємність |
Для доступу до даних усе ще потрібен інтерфейс пам’яті |
| Типове використання |
Кеш і внутрішньочипова робоча пам’ять |
Великі обсяги даних, зокрема ваги моделі й активації |
| Значення для інференсу |
Оптимізує окремі шляхи доступу до даних |
Підтримує більші моделі та обчислювальні стани |
Однак не можна просто припускати, що SRAM швидша за HBM у кожній ситуації або що використання SRAM усуває вузьке місце пам’яті. Фактична продуктивність також залежить від структури розміщення даних, шаблонів паралельного доступу, пропускної здатності пам’яті та архітектури моделі.
Основними обмеженнями SRAM є щільність зберігання та вартість площі чипа. Для мовних моделей із великою кількістю параметрів SRAM на одному процесорі зазвичай недостатньо для зберігання всіх ваг моделі та станів виконання.
Тому для запуску моделей у більших обчислювальних системах Groq потрібно використовувати координацію між кількома чипами та розподіл даних на рівні системи. Це означає, що переваги LPU не походять винятково від SRAM на окремому чипі. Натомість вони є результатом загальної конструкції внутрішньочипового сховища, обчислювальних конвеєрів, міжчипових з’єднань і компіляторів.
Як детерміноване виконання та планування компілятором впливають на продуктивність інференсу?
Детерміноване виконання — ще одне ключове поняття для розуміння архітектури Groq LPU. Його основна ідея полягає в тому, щоб якомога більшою мірою визначати порядок виконання обчислювальних операцій, шляхи передавання даних і розподіл ресурсів до запуску програми, зменшуючи потребу в ухваленні тимчасових рішень щодо планування під час виконання.
У традиційних архітектурах обчислень загального призначення процесори мають адаптуватися до різних типів програм і навантажень. Для підвищення використання ресурсів системи зазвичай містять механізми динамічного планування завдань, керування кешем та інші механізми під час виконання. Такі конструкції забезпечують значну гнучкість, але також можуть створювати додаткові накладні витрати на планування.
LPU Groq використовують інший підхід до проєктування. До виконання моделі компілятор аналізує її обчислювальний граф і створює план виконання обчислювальних операцій та переміщення даних. Потім процесор працює відповідно до цього плану, завдяки чому дані впорядковано переміщуються між різними обчислювальними блоками. Наприклад, мовній моделі може знадобитися безперервно виконувати матричні операції, функції активації та інші обчислення. Компілятор може заздалегідь визначити, коли ці завдання виконуватимуться на різних обчислювальних ресурсах, і координувати необхідне передавання даних.
Цей підхід схожий на попереднє планування кожного кроку на виробничій лінії, щоб різні етапи могли працювати узгоджено в заздалегідь визначеному ритмі.
Для ШІ-інференсу детерміноване виконання має три основні наслідки.
-
Воно може зменшити частину накладних витрат на планування під час роботи. Процесору не потрібно повторно визначати порядок виконання кожного завдання на кожному обчислювальному етапі, що може сприяти підвищенню ефективності виконання для певних навантажень.
-
Воно може зробити час виконання обчислень більш передбачуваним. Для ШІ-сервісів у реальному часі стабільність відповіді так само важлива, як і низька середня затримка. Детерміноване виконання не означає, що час відповіді фактичних API-запитів буде повністю фіксованим. Довжина введення, кількість вихідних токенів, черга запитів, передавання мережею та навантаження сервісу все одно можуть спричиняти відмінності в наскрізній затримці.
-
Статичне планування також може зменшити гнучкість деяких обчислювальних завдань. Якщо модель має складний динамічний потік керування або шлях виконання повинен часто змінюватися на основі результатів у реальному часі, компілятору може знадобитися застосовувати додаткові стратегії обробки.
Отже, цінність детермінованого виконання не полягає в усуненні всієї невизначеності. Натомість для відповідних обчислювальних завдань воно підвищує ефективність використання апаратних ресурсів завдяки чіткішому плануванню виконання.
Чому LPU Groq підходять для ШІ-інференсу з низькою затримкою?
Конструкція LPU Groq із низькою затримкою не залежить від однієї технології. Вона є результатом сукупного впливу внутрішньочипової SRAM, детермінованого виконання, оптимізації компілятором і міжсистемних з’єднань. Під час генерування великими мовними моделями потрібно безперервно виконувати обчислення та створювати наступні токени на основі наявних результатів. Якщо процесор може зменшити частину затримок доступу до даних і накладних витрат на планування під час роботи, це може скоротити час, необхідний для послідовних кроків генерування.
Це особливо важливо для етапу Decode. Оскільки авторегресійним моделям зазвичай потрібно генерувати токени по одному, затримка кожного кроку генерування накопичується та зрештою впливає на швидкість виведення тексту, яку сприймають користувачі. Водночас вузькі місця продуктивності різних завдань інференсу не завжди однакові. Обробка довгих запитів може більше залежати від можливостей масштабних паралельних обчислень, тоді як на безперервне генерування можуть сильніше впливати доступ до пам’яті та затримка покрокового виконання.
Тому фактичну продуктивність LPU Groq потрібно оцінювати з урахуванням типу моделі, довжини введення, довжини виведення та кількості одночасних запитів.
З погляду застосування такі типи сервісів особливо чутливі до інференсу з низькою затримкою.
Голосова взаємодія в реальному часі. Голосовому помічнику потрібно перетворити мовлення користувача на текст, викликати мовну модель для генерування відповіді, а потім озвучити результат за допомогою синтезу мовлення. Якщо мовна модель генерує відповіді повільно, у розмові можуть виникати помітні паузи.
Інтерактивні ШІ-агенти. Під час виконання завдань ШІ-агенту може знадобитися кілька разів викликати мовну модель для визначення наступної дії. Кожна затримка інференсу впливає на загальний час завершення завдання, тому скорочення часу очікування окремих інференсів може покращити взаємодію користувача.
Інтелектуальна служба підтримки та застосунки в реальному часі. Онлайн-сервіси, що обслуговують велику кількість користувачів, мають не лише швидко відповідати, а й контролювати коливання затримки між запитами, щоб підтримувати стабільну якість обслуговування.
Однак низька затримка не обов’язково означає найнижчі обчислювальні витрати на одиницю. Наприклад, платформа інференсу може обробляти окремий запит із високою швидкістю, але якщо вартість її обладнання висока або за низького навантаження значні ресурси простоюють, фактична вартість сервісу за мільйон токенів усе одно може перевищувати показники інших рішень. І навпаки, інша платформа може повільніше генерувати токени для окремих запитів, але обслуговувати багато користувачів одночасно через пакетну обробку та зрештою досягати нижчої середньої вартості.
Тому під час вибору платформи інференсу підприємствам потрібно збалансовувати затримку, пропускну здатність, витрати й сумісність моделей, а не ухвалювати рішення лише на основі кількості токенів за секунду.
Які технічні обмеження мають LPU Groq?
Хоча LPU Groq спеціально оптимізовані для ШІ-інференсу, спеціалізована архітектура не означає, що вони перевершуватимуть інші рішення в кожному обчислювальному завданні. Їхні основні технічні обмеження стосуються ємності пам’яті, масштабування на кілька чипів, сумісності моделей і вартості системи.
Обмеження ємності внутрішньочипової SRAM. Оскільки SRAM має відносно низьку щільність зберігання, обсяг внутрішньочипового сховища на одному чипі обмежений. Коли параметри моделі та стани виконання перевищують ємність одного чипа, обчислення й дані потрібно розподіляти в системі з кількома чипами.
Наприклад, великій мовній моделі можуть знадобитися десятки гігабайтів або більше сховища. Зазвичай складно зберегти всі ці дані, використовуючи лише внутрішньочипову SRAM одного чипа. Тому система має розподіляти модель між кількома процесорами та використовувати міжчипові з’єднання для необхідного обміну даними.
Такий підхід може збільшити розмір моделей, які можна розгортати, але також підвищує складність проєктування системи.
Накладні витрати на міжчипову комунікацію. Навіть якщо окремий LPU може швидко виконувати обчислення, на загальну швидкість інференсу все одно можуть впливати пропускна здатність з’єднань, затримка комунікації та стратегії розподілу даних, коли модель потребує частого передавання даних між чипами. У великомасштабних системах інференсу продуктивність залежить не лише від обчислювальної потужності окремого процесора, а й від скоординованої роботи всього кластера чипів.
Сумісність моделей. LPU Groq покладаються на компілятори для зіставлення обчислень моделі зі спеціалізованим апаратним забезпеченням, тому потребують відповідної програмної підтримки. Коли нові ШІ-моделі впроваджують інші обчислювальні оператори, механізми уваги або динамічні методи виконання, платформі може знадобитися оновити компілятор і середовище виконання. Порівняно з GPU загального призначення, які мають широкі програмні екосистеми, спеціалізовані процесори для інференсу потребують постійної розробки програмного забезпечення для адаптації до технологій моделей, що швидко змінюються.
Витрати на інфраструктуру та комерційну діяльність. Переваги продуктивності LPU потребують повноцінної обчислювальної системи. Фактичне розгортання все одно передбачає витрати на виробництво чипів, сервери, мережеве обладнання, електроенергію та системи охолодження. Для постачальників хмарних сервісів інференсу використання обладнання та попит клієнтів також визначають окупність інвестицій.
Тому LPU Groq слід оцінювати разом із фактичними умовами їх розгортання. Висока швидкість генерування токенів у конкретному тесті не доводить безпосередньо вищу економічну ефективність для всіх моделей і комерційних сценаріїв.
Що LPU Groq означають для майбутнього інфраструктури ШІ-інференсу?
Розвиток LPU Groq відображає дедалі більшу спеціалізацію ринку обчислень для ШІ. У міру поширення застосунків генеративного ШІ підприємства починають обирати більш спеціалізовані обчислювальні архітектури відповідно до різних навантажень, а не зосереджуватися лише на теоретичній піковій продуктивності одного процесора.
У навчанні моделей важливими залишаються масштабні паралельні обчислення, ємність пам’яті та комунікація між кількома пристроями. В інференсі TTFT, швидкість безперервного генерування, пропускна здатність за одночасних запитів і вартість одного токена стали більш прямими комерційними показниками.
Відмінності між обчислювальними завданнями створюють простір для розвитку спеціалізованих чипів інференсу. Водночас спеціалізовані процесори та GPU не обов’язково мають суто взаємозамінні відносини. У березні 2026 року NVIDIA представила архітектуру інференсу, що поєднує Groq 3 LPX із платформою Vera Rubin, досліджуючи, як різні типи обчислювальних пристроїв можуть обробляти завдання інференсу відповідно до своїх характеристик.
Цей напрям відображає тенденцію розвитку гетерогенних обчислень. У майбутньому центри обробки даних для ШІ можуть одночасно розгортати GPU, спеціалізовані прискорювачі інференсу та інші обчислювальні пристрої, а програмні системи координуватимуть виконання різних завдань.
Наприклад, відповідні ресурси GPU можна використовувати для навантажень, що потребують масштабної паралельної обробки, тоді як спеціалізовані процесори інференсу можуть мати переваги для окремих завдань генерування, дуже чутливих до затримки. Однак гетерогенні обчислення не означають, що просте додавання більшої кількості типів чипів підвищить ефективність. Системи також мають розв’язувати питання міжпристроєвої комунікації, планування завдань, сумісності програмного забезпечення та витрат на інфраструктуру.
Для індустрії ШІ-чипів це означає, що конкуренція розширюється від продуктивності окремих апаратних компонентів до ефективності повноцінних обчислювальних систем. Архітектура процесорів, компілятори, системи пам’яті, технології з’єднання та функціонування хмарних сервісів можуть стати чинниками, що визначають кінцеву продуктивність і комерційну цінність.
Технологічний підхід, представлений LPU Groq, є конкретним прикладом такого зсуву. Їхня довгострокова цінність залежатиме не лише від швидкості інференсу конкретного покоління чипів, а й від того, чи зможуть вони й надалі адаптуватися до еволюції моделей і перетворювати технічну продуктивність на стабільні, масштабовані обчислювальні сервіси.
Висновок
Groq LPU — це спеціалізований процесор, розроблений для ШІ-інференсу. Він використовує такі технології, як внутрішньочипова SRAM, детерміноване виконання та статичне планування компілятором, щоб оптимізувати доступ до даних і виконання обчислень для певних навантажень великих мовних моделей.
Порівняно з GPU загального призначення LPU Groq приділяють більше уваги низькій затримці та передбачуваності виконання для конкретних завдань інференсу. Така конструкція придатна для дослідження оптимізації продуктивності в застосунках, зокрема для генерування тексту в реальному часі, голосової взаємодії та ШІ-агентів, однак це не означає, що LPU можуть замінити GPU в кожній моделі та обчислювальному сценарії.
Водночас ємність SRAM, міжчипова комунікація, адаптація моделей і витрати на інфраструктуру залишаються важливими питаннями, які мають розв’язувати спеціалізовані архітектури інференсу.
У міру того як індустрія ШІ переходить від розробки моделей до масштабних застосувань, конкуренція в обчисленнях для інференсу зміщується від простого максимізування обчислювальної потужності до оптимізації затримки, пропускної здатності, витрат і загальної ефективності системи. Розвиток LPU Groq демонструє, що спеціалізовані прискорювачі можуть відігравати важливішу роль у майбутній ШІ-інфраструктурі, але їхню фактичну цінність ще потрібно підтвердити на конкретних навантаженнях і результатах комерційного розгортання.
Поширені запитання
Що таке Groq LPU?
Groq LPU — це спеціалізований процесор для ШІ-інференсу, розроблений Groq. Він переважно використовує такі технології, як внутрішньочипова SRAM, детерміноване виконання та планування компілятором, щоб оптимізувати конкретні завдання інференсу мовних моделей.
Які основні відмінності між LPU та GPU?
LPU більше зосереджені на оптимізації виконання та передавання даних для конкретних завдань інференсу, тоді як GPU пропонують широкі можливості паралельних обчислень і зрілу програмну екосистему. Відмінності в їхній продуктивності залежать від конкретної моделі та середовища виконання.
Чому LPU Groq використовують SRAM?
SRAM забезпечує внутрішньочиповий доступ до даних із низькою затримкою, що може допомогти зменшити накладні витрати на зчитування даних у певних завданнях інференсу. Однак ємність SRAM обмежена, тому для розгортання великих моделей зазвичай потрібна координація кількох чипів.
Що означає детерміноване виконання?
Детерміноване виконання означає планування порядку обчислень, передавання даних і розподілу ресурсів якомога більшою мірою до запуску програми. Це може зменшити частину накладних витрат на планування під час роботи та зробити виконання обчислень більш передбачуваним.
Чи можна використовувати LPU Groq для навчання ШІ-моделей?
LPU Groq переважно розроблені для навантажень інференсу та не призначені головним чином для масштабного навчання моделей загального призначення. Їхня фактична підтримка залежить від архітектури апаратного забезпечення та набору програмних інструментів.
Чи завжди LPU Groq швидші за GPU NVIDIA для інференсу?
Не обов’язково. На результати можуть впливати різні моделі, довжина введення, довжина виведення, рівні одночасності та тестові середовища. Вища швидкість генерування токенів для одного користувача не обов’язково означає кращу загальну пропускну здатність або нижчі витрати на токен.
Чому LPU Groq підходять для ШІ-агентів?
ШІ-агентам може знадобитися послідовно виконувати кілька викликів інференсу. Скорочення затримки відповіді на кожен запит може зменшити час виконання всього завдання, але кінцевий результат також залежить від викликів інструментів, передавання мережею та інших етапів обробки.