По мере того как генеративный ИИ выходит за рамки обучения моделей и переходит к масштабным коммерческим применениям, меняется и фокус конкуренции на рынке вычислений для ИИ. Компаниям нужно не только обучать более мощные модели, но и непрерывно обрабатывать запросы пользователей с контролируемыми затратами, запускать ИИ-агентов, генерировать голос и предоставлять интерактивные сервисы в реальном времени. На этом фоне всё больше внимания привлекает специализированная архитектура ускорения инференса, представленная компанией Groq. В этой статье рассматриваются позиционирование Groq, технология LPU, бизнес-модель GroqCloud и конкуренция в отрасли. Это позволяет оценить роль компании в инфраструктуре инференса ИИ, а также технические и коммерческие проблемы, с которыми сталкивается подход, основанный на специализированных чипах.
Ключевые выводы
- Groq — технологическая компания, специализирующаяся на инференсе ИИ. К её основным технологиям относятся чипы LPU, компиляторы и вспомогательная инфраструктура для инференса.
- Обучение и инференс ИИ предъявляют разные требования к вычислениям. Для инференса в реальном времени особенно важны время до генерации первого токена, скорость генерации и стабильность сервиса.
- LPU Groq оптимизирует отдельные задачи инференса ИИ с помощью встроенной SRAM, детерминированного выполнения и совместной разработки аппаратного и программного обеспечения.
- GroqCloud превращает базовые вычислительные возможности в облачные API, благодаря чему разработчики могут обращаться к поддерживаемым моделям.
- LPU и GPU различаются по архитектуре и применимым сценариям. Общую производительность нельзя оценивать только по скорости генерации отдельных токенов.
- Долгосрочная коммерческая конкурентоспособность Groq зависит от масштабируемости чипов, программной экосистемы, стоимости инференса, спроса со стороны клиентов и окупаемости инфраструктурных инвестиций.
Что такое Groq и какую роль компания играет в цепочке создания стоимости ИИ?
Groq — технологическая компания, специализирующаяся на вычислениях для инференса ИИ. Она была основана в 2016 году Джонатаном Россом, который ранее участвовал в проекте Google TPU. Компания в основном разрабатывает специализированные чипы для ускорения ИИ, компиляторы и вычислительные системы для инференса, а также предоставляет разработчикам и компаниям возможности инференса моделей через такие сервисы, как GroqCloud.
Важно отметить, что Groq и Grok — это не один и тот же продукт. Groq — название технологии, связанной с инфраструктурой вычислений для ИИ, а Grok — модель искусственного интеллекта и ассистент, разработанные компанией xAI. Несмотря на схожесть названий, это продукты разных компаний с разным техническим позиционированием и бизнес-моделями.
В цепочке создания стоимости ИИ Groq в первую очередь занимает место на уровне вычислительной инфраструктуры. Полноценное приложение на основе генеративного ИИ обычно включает разработку и обучение модели, вычислительные ресурсы для инференса, развёртывание инференса, интерфейсы приложений и пользовательские сервисы. Основной бизнес Groq заключается не в разработке универсальных чат-моделей для потребителей. Компания стремится предоставлять высокопроизводительную среду инференса для различных моделей.
Например, при создании ИИ-ассистента, работающего в реальном времени, разработчики могут выбрать уже обученную модель и использовать сервис инференса для обработки пользовательского ввода. Модель понимает вопросы и генерирует контент, а базовая вычислительная платформа определяет скорость работы модели и объём вычислительных ресурсов, потребляемых каждым запросом.
Оптимизация этого вычислительного процесса лежит в основе ценностного предложения Groq. С помощью специально разработанных процессоров и программных систем компания снижает накладные расходы на выполнение отдельных задач инференса, позволяя моделям быстрее генерировать ответы.
Такое позиционирование означает, что рыночные возможности Groq зависят не только от популярности конкретной ИИ-модели, но и от спроса на инференс во всей отрасли генеративного ИИ, архитектур моделей и изменений вычислительных затрат.
Почему отрасль ИИ уделяет всё больше внимания вычислениям для инференса?
Вычисления для ИИ обычно можно разделить на два этапа: обучение и инференс. Обучение предполагает обработку больших объёмов данных для настройки параметров модели, чтобы она могла выполнять такие задачи, как понимание языка и распознавание изображений. Инференс — это получение обученной моделью новых входных данных и генерация результата на основе уже настроенных параметров.
Оба этапа требуют вычислительных ресурсов, однако их рабочие нагрузки существенно различаются. При обучении модели обычно обрабатываются большие наборы данных, рассчитываются градиенты и обновляются параметры. Поэтому особенно важны масштабируемые параллельные вычисления, объём памяти и координация работы нескольких устройств. Инференс, напротив, должен быстро генерировать результаты в ответ на запросы пользователей. Это особенно важно для чатов, голосовых сервисов и автоматизации, где время ответа напрямую влияет на пользовательский опыт.
Для больших языковых моделей процесс инференса обычно включает два этапа: Prefill и Decode. На этапе Prefill обрабатывается входной промпт и формируется соответствующее вычислительное состояние, а на этапе Decode последующие токены генерируются по одному. Поскольку авторегрессионным языковым моделям обычно необходимо предсказывать следующий токен на основе уже сгенерированного контента, непрерывная генерация предъявляет высокие требования к эффективности доступа к памяти и планированию вычислений.
Пользователь обычного чат-приложения может подождать несколько секунд. Однако в голосовых ассистентах, работающих в реальном времени, автоматизированной поддержке клиентов и интерактивных ИИ-сценариях задержка ответа напрямую влияет на естественность диалога. Если модели требуется слишком много времени для начала ответа или скорость генерации недостаточна для общения в реальном времени, она может не соответствовать практическим требованиям бизнеса, даже обладая широкими возможностями.
Развитие ИИ-агентов ещё больше увеличило спрос на инференс. В отличие от разового взаимодействия в формате вопроса и ответа, ИИ-агент может обращаться к нескольким моделям, анализировать внешние данные, выполнять операции с инструментами и проверять результаты. Одна пользовательская задача может включать несколько циклов внутреннего рассуждения и множество API-запросов, увеличивая общее потребление вычислительных ресурсов.
В результате конкуренция в сфере инфраструктуры ИИ выходит за рамки простого стремления повысить возможности обучения моделей. Теперь всё больше внимания уделяется предоставлению сервисов инференса с меньшей задержкой, более высокой пропускной способностью и более обоснованными затратами.
Однако рост спроса на инференс не означает, что вычисления для обучения становятся менее важными. Обучение новых моделей, дообучение моделей и предоставление сервисов инференса могут одновременно продолжать расти. Разница заключается в том, что требования к оборудованию для различных вычислительных задач становятся более специализированными.
Каковы ключевые особенности технологического подхода Groq к LPU?
LPU — термин, который Groq использует для обозначения специализированного процессора для инференса. По сравнению с универсальными GPU, рассчитанными на широкий спектр вычислительных задач, архитектура LPU в большей степени ориентирована на вычисления, перемещение данных и контроль задержки в конкретных рабочих нагрузках ИИ.
Технологический подход Groq к LPU можно рассмотреть с трёх сторон: встроенная память, детерминированное выполнение и компиляторы.
Как встроенная SRAM влияет на эффективность доступа к данным?
Современные вычисления для ИИ ограничены не только арифметическими возможностями чипа, но и скоростью доступа к данным и их передачи. Во время инференса большой языковой модели вычислительные блоки должны постоянно обращаться к весам модели и промежуточным данным. Если данные не поступают вовремя, процессор может использовать свои ресурсы не полностью, даже обладая высокой теоретической вычислительной мощностью.
Одна из важных особенностей LPU Groq заключается в использовании встроенной SRAM, то есть статической оперативной памяти с произвольным доступом. SRAM обычно обеспечивает меньшую задержку доступа и помогает процессорам быстро считывать необходимые данные. По сравнению с архитектурами, которые опираются на внешнюю высокоскоростную память большей ёмкости, такой подход призван снизить накладные расходы на доступ к данным в отдельных вычислительных задачах.
У SRAM есть ограничения по стоимости и ёмкости. При одинаковой площади чипа SRAM обычно не может обеспечить такой же объём хранения, как внешняя память большой ёмкости. Поэтому развёртывание моделей с большим количеством параметров может потребовать координации нескольких чипов, распределения модели и оптимизации на уровне системы.
Это означает, что встроенная SRAM не является безусловно лучшей по сравнению с любой другой архитектурой памяти. Её ценность зависит от конкретной модели и рабочей нагрузки, а также от того, насколько эффективно вычислительная система может координировать хранение и передачу данных.
Почему важно детерминированное выполнение?
Ещё один ключевой элемент архитектуры Groq — детерминированное выполнение. При таком подходе компилятор может заранее спланировать большое количество вычислительных операций и передач данных, что позволяет процессору работать по заранее заданному расписанию.
Традиционные GPU обычно должны поддерживать разнообразные вычислительные задачи, динамическое планирование и сложные программные среды, поэтому они отличаются высокой универсальностью. Groq, напротив, стремится уменьшить неопределённость, связанную с планированием во время выполнения и координацией ресурсов, благодаря более чётким планам выполнения.
Для инференса с низкой задержкой предсказуемое время выполнения имеет практическое значение. При предоставлении ИИ-сервисов в реальном времени компаниям важна не только средняя скорость ответа, но и разброс задержки между разными запросами. Если сервис периодически отвечает с существенной задержкой, это может ухудшать пользовательский опыт даже при высокой средней производительности.
Детерминированное выполнение не означает, что каждый запрос будет иметь абсолютно одинаковое время ответа. На фактическую задержку по-прежнему могут влиять длина входных и выходных данных, стратегии пакетной обработки, нагрузка на систему и состояние сети.
Как компилятор способствует оптимизации производительности LPU?
Технологический подход Groq не ограничивается использованием аппаратных средств для повышения производительности. Компания уделяет особое внимание совместной разработке аппаратного и программного обеспечения. Компилятор должен анализировать вычислительный граф модели и распределять соответствующие операции между вычислительными ресурсами и хранилищем чипа.
В этом процессе компилятор отвечает не только за преобразование модели в исполняемые инструкции. Он также организует передачу данных, последовательность вычислений и использование ресурсов, чтобы разные вычислительные блоки могли работать согласованно по заранее заданному плану.
Такая архитектура позволяет глубоко оптимизировать поддерживаемые модели, но одновременно предъявляет высокие требования к программному инструментарию. При изменении структуры моделей, типов операторов или требований к инференсу платформе необходимо постоянно совершенствовать компилятор и среду выполнения.
Поэтому технологическая конкурентоспособность Groq определяется не только самим чипом LPU, но и компилятором, возможностями адаптации моделей и согласованной эффективностью всей системы инференса.
Как GroqCloud превращает вычислительные ресурсы LPU в коммерческий сервис?
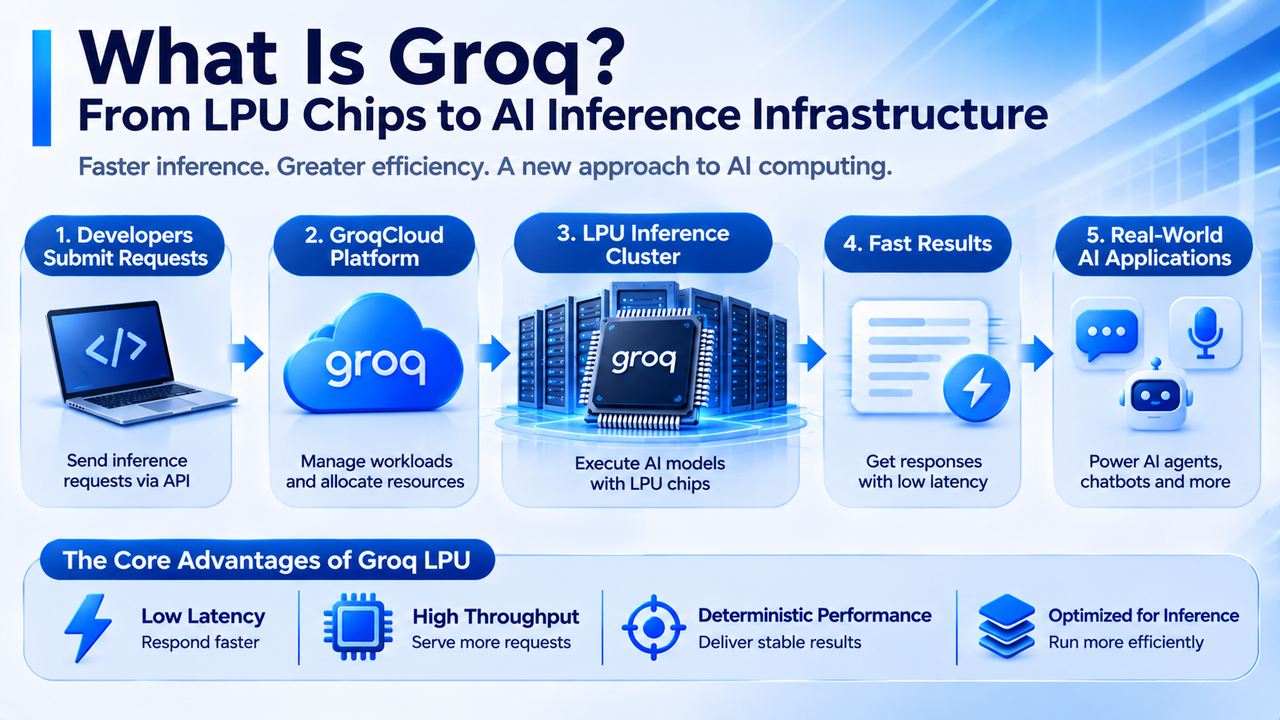
GroqCloud — облачный сервис Groq для инференса ИИ, предназначенный для разработчиков и компаний. Он объединяет базовые чипы, вычислительные кластеры и среды выполнения моделей в сервисы, доступные через API. Благодаря этому клиенты могут использовать инфраструктуру инференса Groq без самостоятельной покупки и развёртывания специализированных чипов.
В типичном приложении разработчики сначала выбирают модель, поддерживаемую платформой, а затем отправляют текст или другой тип входных данных через API. GroqCloud получает запрос, передаёт соответствующую вычислительную задачу базовой системе инференса и возвращает сгенерированный результат приложению. Этот процесс включает планирование запросов, выполнение модели, управление ресурсами и передачу результата.
Для корпоративных клиентов основная ценность облачного сервиса инференса заключается в снижении барьера для развёртывания инфраструктуры. Самостоятельное создание вычислительного кластера для ИИ обычно требует покупки оборудования, настройки сетей, развёртывания моделей и поддержки среды выполнения. Использование сервиса инференса через API переводит часть фиксированных инфраструктурных инвестиций в расходы на сервис, которые меняются в зависимости от фактического использования.
Платформа Groq также расширяется от отдельного API инференса к более комплексным инфраструктурным сервисам для компаний. В её продуктовый портфель входят специализированная вычислительная инфраструктура, программный стек инференса, а также возможности управления и контроля корпоративного уровня, отвечающие различным требованиям клиентов к производительности, способам развёртывания и правам доступа.
Однако коммерческая ценность облачного сервиса инференса зависит не только от скорости чипов. Компаниям также необходимо учитывать поддержку моделей, стабильность API, доступность сервиса, безопасность данных и стоимость каждого запроса. Если платформа поддерживает лишь ограниченный набор моделей или операторов, она может не соответствовать всем требованиям корпоративных приложений, даже если обеспечивает низкую задержку в отдельных задачах.
Что касается моделей выручки, облачные сервисы инференса обычно могут взимать плату за использование модели, количество обработанных токенов или зарезервированную вычислительную мощность. Разные методы тарификации предъявляют разные требования к управлению ресурсами. При оплате по фактическому использованию больший акцент делается на реальном объёме запросов, а при резервировании мощностей необходимо учитывать клиентские договоры, предоставление ресурсов и загрузку оборудования.
Таким образом, способность GroqCloud коммерциализировать технологию в конечном счёте зависит от того, сможет ли компания превратить преимущества LPU в стабильные, масштабируемые и конкурентоспособные по стоимости сервисы инференса.
Как партнёрство Groq с NVIDIA меняет позиционирование компании в отрасли?
Отношения Groq с NVIDIA важны для понимания текущего положения компании в отрасли.
В декабре 2025 года Groq и NVIDIA заключили неэксклюзивное лицензионное соглашение на технологию инференса ИИ. Согласно раскрытой обеими сторонами информации, NVIDIA получила лицензию на соответствующую технологию инференса Groq, а основатель Groq Джонатан Росс, тогдашний президент Санни Мадра и некоторые сотрудники присоединились к NVIDIA. Groq продолжила работать как независимая компания под руководством генерального директора Саймона Эдвардса, а её бизнес GroqCloud продолжил функционировать.
Эта сделка означает, что ценность технологий Groq выражается не только в самостоятельной продаже сервисов инференса, но и в интеграции компании в более широкую экосистему вычислений для ИИ через лицензирование технологий.
В марте 2026 года NVIDIA дополнительно представила архитектуру ускорения инференса Groq 3 LPX и объединила её с платформой Vera Rubin. Соответствующее решение стремится распределять рабочие нагрузки между GPU и LPU с учётом вычислительных характеристик разных этапов инференса ИИ, чтобы повысить эффективность инференса с низкой задержкой. Это развитие отражает растущую сложность конкуренции на рынке чипов для ИИ. Ранее специализированные чипы для инференса часто рассматривались как потенциальная замена GPU. Однако в гетерогенных вычислительных архитектурах процессоры разных типов также могут выполнять взаимодополняющие задачи.
Например, GPU могут обрабатывать масштабные параллельные вычисления и отдельные операции внимания, соответствующие их архитектуре, а LPU — вычислительные задачи, более чувствительные к времени выполнения и задержке передачи данных. Благодаря планированию на уровне системы два типа процессоров могут совместно выполнять одну рабочую нагрузку инференса.
Однако гетерогенные архитектуры также повышают инженерную сложность. Системам необходимо координировать передачу данных, распределение задач и управление памятью между разными устройствами. Если накладные расходы на обмен данными между устройствами окажутся слишком высокими, теоретические преимущества оборудования могут не полностью преобразоваться в практическую производительность.
В августе 2026 года Groq также объявила о присоединении к программе NVIDIA Cloud Partner, дополнительно укрепив своё позиционирование как оператора облачной инфраструктуры для ИИ. Поэтому Groq уже нельзя описывать просто как независимую от экосистемы NVIDIA компанию по производству чипов, которая сосредоточена исключительно на конкуренции с GPU. Текущий бизнес Groq включает независимые облачные сервисы инференса, технологии специализированных чипов и инфраструктурное сотрудничество с NVIDIA.
Как бизнес-модель Groq адаптируется к росту рынка инференса ИИ?
Коммерческий спрос на рынке инференса ИИ в основном формируется корпоративными приложениями, сервисами для разработчиков и ИИ-продуктами, работающими непрерывно. В отличие от обучения моделей, которое обычно проходит поэтапно в рамках отдельных проектов, сервисы инференса должны постоянно предоставлять вычислительные мощности с учётом изменений пользовательского трафика. Поэтому для них особенно важны загрузка ресурсов, удельные затраты и стабильность сервиса.
Бизнес-модель Groq можно рассмотреть на трёх уровнях.
-
Создание инфраструктуры инференса. Groq необходимо формировать пригодные для использования вычислительные мощности с помощью чипов, серверов, сетей и дата-центров. Эти активы могут поддерживать клиентские запросы и приносить выручку только после установки оборудования, адаптации моделей и запуска сервиса.
-
Облачные сервисы инференса. GroqCloud превращает вычислительные мощности в API, которыми могут пользоваться разработчики, не управляя базовыми чипами напрямую. Для поставщика услуг рост выручки зависит от количества клиентов, объёма запросов, тарифов и удержания клиентов.
-
Инфраструктурные сервисы для компаний. Некоторым компаниям могут требоваться выделенные вычислительные ресурсы, определённые способы развёртывания или более строгие требования к управлению. Такие потребности могут формировать более стабильные долгосрочные отношения с клиентами, но одновременно требуют больших инвестиций в разработку, эксплуатацию и поддержку клиентов.
В июне 2026 года Groq объявила о привлечении $650 млн в рамках раунда финансирования для расширения глобального облачного бизнеса в сфере инференса ИИ. Компания поставила цель достичь примерно 200 МВт инфраструктурных мощностей к 2027 году. На тот момент Groq сообщила, что управляет 13 дата-центрами в нескольких регионах, обслуживает более 5 млн разработчиков и обрабатывает десятки триллионов токенов ИИ в неделю.
Эти показатели позволяют оценивать темпы расширения бизнеса, но сами по себе не подтверждают прибыльность. Число разработчиков, объём токенов и количество дата-центров отражают охват пользователей, активность сервиса и масштаб инфраструктуры соответственно. Они не равны фактической выручке, прибыли или свободному денежному потоку.
Например, предположим, что количество токенов, обрабатываемых платформой инференса ежемесячно, увеличивается на 100%, но цена за токен из-за конкуренции на рынке снижается на 40%. Тогда рост выручки может оказаться ниже роста объёма использования. Если за тот же период также увеличатся расходы на создание и эксплуатацию инфраструктуры, маржа прибыли может снизиться ещё сильнее.
Поэтому для анализа потенциала коммерциализации Groq необходимо одновременно учитывать рост спроса на инференс, тарифы на сервисы, загрузку оборудования и капитальные расходы. Рыночную стоимость нельзя оценивать только по скорости выполнения моделей.
С какими техническими и масштабными проблемами сталкивается Groq?
Хотя специализированные чипы для инференса можно оптимизировать под конкретные рабочие нагрузки, Groq по-прежнему сталкивается с проблемами, связанными с изменениями моделей, масштабированием оборудования и конкуренцией на рынке.
Адаптация моделей. Архитектуры ИИ продолжают быстро развиваться. Разные модели могут использовать различные механизмы внимания, масштабы параметров, вычислительные точности и стратегии инференса. Чтобы специализированный процессор поддерживал больше моделей, его компилятор, среду выполнения и связанные программные инструменты необходимо постоянно обновлять.
Это также означает, что преимущество в производительности, достигнутое одним поколением чипов на конкретной модели, может напрямую не переноситься на каждую новую модель. По мере развития инференса с длинным контекстом, моделей со смесью экспертов и мультимодальных вычислений базовым вычислительным системам необходимо постоянно адаптироваться к новым рабочим нагрузкам.
Масштабирование на несколько чипов. LPU Groq делают акцент на встроенной SRAM и детерминированном выполнении, но для больших моделей часто требуются объёмы памяти и вычислительные ресурсы, превышающие возможности одного чипа. При распределении модели между несколькими чипами системе необходимо координировать передачу данных и последовательность вычислений между устройствами.
Если обмен данными между несколькими чипами недостаточно эффективен, преимущество одного чипа в низкой задержке может сократиться. Поэтому межчиповые соединения, пропускная способность системы и возможности планирования компилятора имеют большое значение для масштабирования специализированной архитектуры инференса.
Затраты на создание инфраструктуры. Даже если чипы обеспечивают высокую вычислительную эффективность, для создания дата-центра ИИ всё равно необходимы подключения к электросетям, помещения, системы охлаждения и сетевая инфраструктура. По мере расширения сервисов инференса Groq также должна нести соответствующие капитальные и операционные расходы.
Конкуренция на рынке. GPU NVIDIA, GPU AMD, Google TPU и другие специализированные ускорители ИИ конкурируют за спрос на вычисления для инференса. У разных платформ могут быть преимущества в совместимости с моделями, пропускной способности, задержке, стоимости и программных экосистемах.
Для корпоративных клиентов окончательный выбор обычно не определяется одним показателем производительности. Он зависит от совокупной стоимости сервиса, совместимости с приложениями и долгосрочной надёжности эксплуатации. Поэтому способность технологического подхода Groq обеспечить устойчивую конкурентоспособность зависит не только от самой архитектуры LPU, но и от того, сможет ли компания расширять поддержку программного обеспечения, повышать загрузку вычислительных ресурсов и контролировать стоимость расширения инфраструктуры.
Что Groq означает для чипов ИИ и вычислительной отрасли?
Технологический подход, представленный Groq, отражает постепенный переход отрасли вычислений для ИИ от архитектур, сосредоточенных на универсальных ускорителях, к гетерогенным вычислительным системам, оптимизированным под разные рабочие нагрузки. На ранних этапах развития генеративного ИИ важным фактором прогресса были возможности обучения. По мере перехода большего числа моделей к практическому применению сервисы инференса начинают формировать постоянный спрос на вычисления, повышая требования компаний к низкой задержке, эффективности затрат и стабильности сервисов.
Это создаёт возможности для развития специализированных чипов инференса. Оптимизируя аппаратное и программное обеспечение под конкретные вычислительные процессы, специализированные архитектуры могут обеспечивать преимущества по производительности или стоимости в отдельных задачах.
Однако это не означает, что GPU будут полностью вытеснены специализированными чипами инференса. GPU обладают широкими программными экосистемами, обширной поддержкой моделей и универсальными вычислительными возможностями, что позволяет им адаптироваться к различным рабочим нагрузкам обучения и инференса. Специализированные ускорители, напротив, могут играть важную роль в отдельных моделях, вычислительных этапах или сценариях, требующих низкой задержки.
Технологическое сотрудничество NVIDIA и Groq дополнительно указывает на то, что будущие дата-центры ИИ могут одновременно использовать вычислительные устройства разных типов и координировать их работу с помощью программных систем планирования. Такой подход способен повысить загрузку вычислительных ресурсов, но одновременно увеличивает сложность проектирования и управления системами.
Для отрасли инфраструктуры ИИ фокус конкуренции может постепенно сместиться от теоретической производительности отдельных чипов к способности предоставлять полноценные вычислительные системы. На итоговую коммерческую отдачу могут влиять производительность чипов, пропускная способность памяти, соединения между устройствами, компиляторы, энергоэффективность и эксплуатация облачных сервисов.
Развитие Groq также показывает, что инфраструктура инференса ИИ — это не только вопрос производства чипов. Это комплексная отрасль, включающая архитектуру оборудования, оптимизацию программного обеспечения, строительство дата-центров и предоставление коммерческих сервисов.
Заключение
Groq — технологическая компания, специализирующаяся на вычислениях для инференса ИИ. В архитектуре LPU используются такие элементы, как встроенная SRAM, детерминированное выполнение и планирование компилятором, чтобы повысить эффективность выполнения отдельных рабочих нагрузок ИИ. GroqCloud превращает базовые вычислительные возможности в облачные сервисы инференса, позволяя разработчикам и компаниям использовать соответствующую инфраструктуру через API.
По мере того как ИИ-приложения выходят за рамки обучения моделей и переходят к интерактивному взаимодействию в реальном времени, ИИ-агентам и постоянно работающим корпоративным сервисам, задержка инференса, пропускная способность и стоимость становятся всё более важными техническими показателями. Специализированная архитектура инференса, представленная Groq, предлагает отрасли вычислений для ИИ альтернативный подход к универсальным GPU.
Одновременно лицензирование технологий и инфраструктурное сотрудничество Groq с NVIDIA показывают, что специализированные чипы инференса и GPU не обязательно должны только конкурировать друг с другом. В будущем дата-центры ИИ могут всё чаще использовать гетерогенные вычислительные архитектуры, в которых разные процессоры выполняют задачи, соответствующие их особенностям.
Однако технические преимущества специализированных чипов не гарантируют коммерческого успеха. Groq по-прежнему необходимо решать вопросы адаптации моделей, масштабирования на несколько чипов, инфраструктурных затрат и прибыльности облачных сервисов. Долгосрочное развитие компании будет зависеть от того, сможет ли она превратить преимущества инференса в стабильный клиентский спрос, устойчивую выручку и обоснованную отдачу на вложенный капитал.
Часто задаваемые вопросы
Что это за компания Groq?
Groq — технологическая компания, специализирующаяся на вычислениях для инференса ИИ. К её основным направлениям относятся специализированные процессоры LPU, вычислительные системы для инференса и облачные сервисы инференса GroqCloud.
Groq и Grok — это один и тот же продукт?
Нет. Groq — технологическая компания, связанная с инфраструктурой инференса ИИ, а Grok — модель искусственного интеллекта и ассистент, разработанные компанией xAI.
Что такое LPU Groq?
LPU — специализированный процессор для инференса ИИ, разработанный Groq. Он ориентирован на использование встроенной SRAM, детерминированное выполнение, планирование компилятором и вычисления с низкой задержкой.
Чем LPU Groq отличается от GPU NVIDIA?
LPU в большей степени оптимизированы под вычисления и передачу данных в конкретных задачах инференса, тогда как GPU предлагают более широкие возможности параллельных вычислений и развитые программные экосистемы. Фактическая производительность зависит от модели, размера пакета, требований к задержке и среды развёртывания.
Была ли Groq приобретена NVIDIA?
По состоянию на ноябрь 2026 года Groq продолжает работать как независимая компания. В декабре 2025 года стороны заключили неэксклюзивное лицензионное соглашение на технологии, а некоторые сотрудники Groq присоединились к NVIDIA. Это не означает, что NVIDIA полностью приобрела Groq.
Что такое GroqCloud?
GroqCloud — облачный сервис Groq для инференса ИИ. Он позволяет разработчикам обращаться через API к моделям, поддерживаемым платформой, без самостоятельной покупки и развёртывания базового вычислительного оборудования.
Почему Groq привлекает внимание на рынке вычислений для ИИ?
Технологический подход Groq оптимизирует задержку, передачу данных и эффективность выполнения при инференсе ИИ. Это соответствует требованиям к вычислительной эффективности в ИИ-приложениях реального времени, ИИ-агентах и корпоративных сервисах инференса.
Есть ли у Groq собственная криптовалюта?
Groq — компания, занимающаяся инфраструктурой вычислений для ИИ. Её бизнес в сфере LPU и GroqCloud не связан с собственной криптовалютой или нативным токеном. Сторонние токены с похожими названиями не следует автоматически считать активами, выпущенными или одобренными Groq.