


Stephan_

期間 3.6年
ピーク時のランク 0
現在、コンテンツはありません
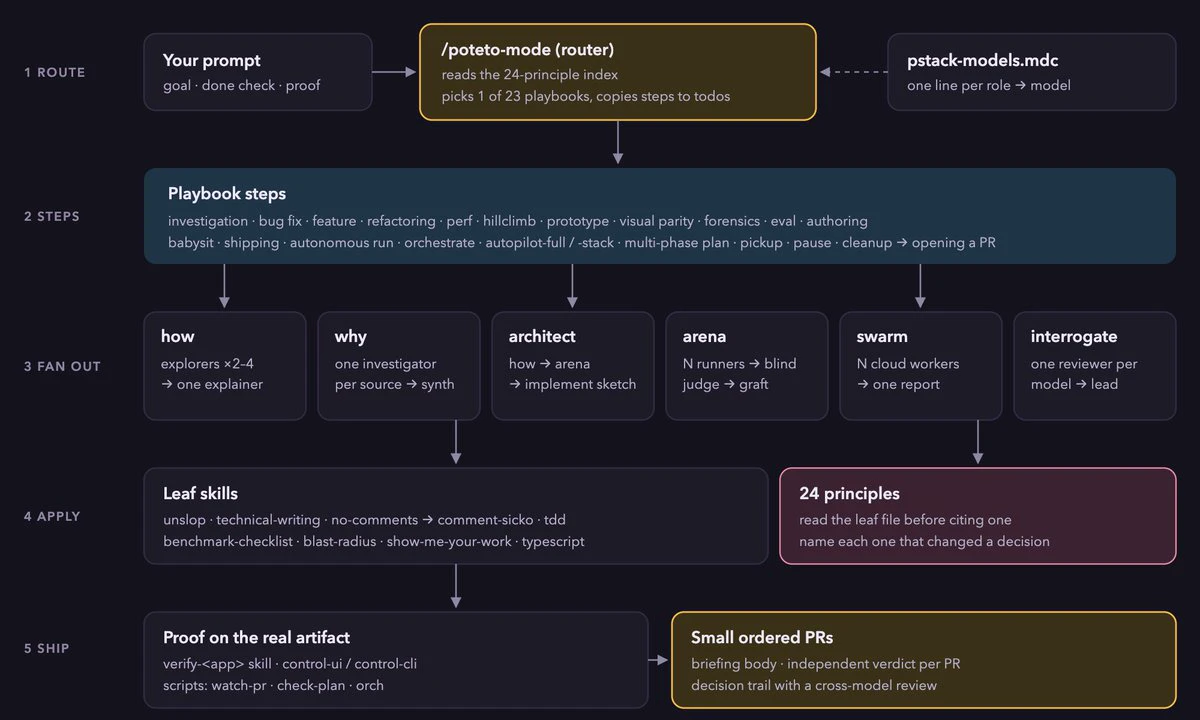
最近、@poteto の pstack を体系的に学んでいて、本当にすごいです! 目からうろこが落ちるような感じです!
これから学びながら共有していきます:
これから学びながら共有していきます:
今最もお得なサブスクリプションはopencode-goではない
commandcode-goatでもない
ChatGPT-plusだ 😂
commandcode-goatでもない
ChatGPT-plusだ 😂
最近ずっと、ある問題について考えています。最先端モデル向けにskillを書く際、決定性と柔軟性のバランスをどのように取るべきでしょうか?
決定性とは、より多くのハード制約やコードを使ってskillを書くことです。
柔軟性とは、細部や制約を減らし、high-levelかつprompt-drivenな観点だけでskillを書くことです。
この2つの間には動的なバランスが必要で、唯一の正解があるわけではありません。
きっかけは、mattが書いた /spec-implement と、私が書いた /pi-matt-implement-flow を比較したことです。
私のフローとフレームワークは制約が多く、決定性が強いので、agentが道を外れにくいというメリットがあります。デメリットも決定性が強いことで、agentが自ら工夫する余地が不足します😂
以前のモデルはまだ十分に賢くなかったので、私はより決定性の強い方向を好んでいました。
しかし今のOpus-5.5/GPT-6.1-solクラスのモデルは違います。決定性が強すぎると、かえってその能力の発揮を制限してしまうように思えます。
あなたはどう思いますか?
- 1
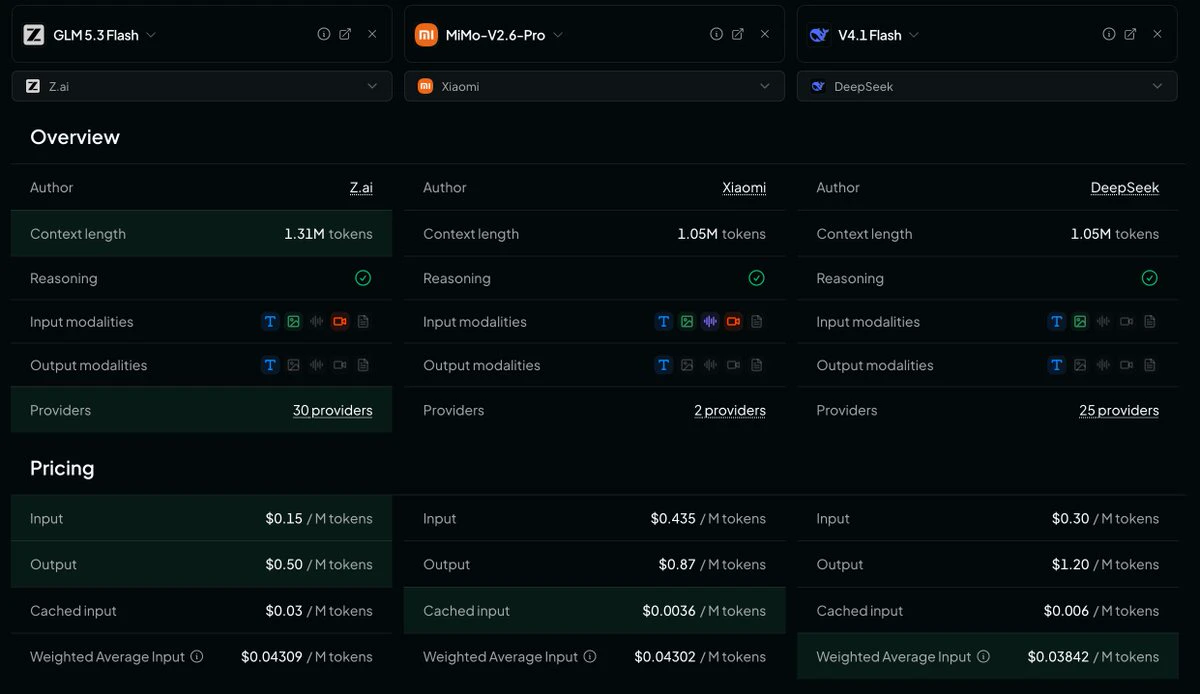
OpenRouterの実際のWeighted Average Inputで見ると、この3つのモデルのコストは非常に近くなっています。では、この3つの中から1つをメインモデルとして選ぶなら、どれを選びますか?
npm公式リポジトリが落ちていて、npm公式リポジトリに登録してパッケージを公開しようとした矢先に 😤
- 3
最近の考え🤔:
研究開発により多くの時間を費やすべきなのは、eval評価データセットの策定と、評価の正確性および完全性の検証であり、その後、evalループの構築を通じて業務の反復改善を推進することです
業務コードを直接バイブコーディングするのではありません
理想的には、適切なgoal + evalループによって、業務コード自体が自己反復できるはずです
現在、この方向への転換を試みています。ぜひ交流しましょう
研究開発により多くの時間を費やすべきなのは、eval評価データセットの策定と、評価の正確性および完全性の検証であり、その後、evalループの構築を通じて業務の反復改善を推進することです
業務コードを直接バイブコーディングするのではありません
理想的には、適切なgoal + evalループによって、業務コード自体が自己反復できるはずです
現在、この方向への転換を試みています。ぜひ交流しましょう
なぜ多くのAI評価のスコアは、実際に使ったときの体感とあまり一致しないのでしょうか?
私が思うに、肝心なのは、ほとんどの評価が号砲が鳴ったら誰が遠くまで走れるかを見るものだということです。
どこへ走るかは気にせず、空の彼方まで走っていっても構わない。評価のプロセス全体で収束する必要がありません。
実際の場面で最も苦労するのは、収束とアラインメントの過程です。遠くまで走れるからといって必ずしも優れているとは限らず、コース内を走り続けられるものこそ優れているのです。
私が思うに、肝心なのは、ほとんどの評価が号砲が鳴ったら誰が遠くまで走れるかを見るものだということです。
どこへ走るかは気にせず、空の彼方まで走っていっても構わない。評価のプロセス全体で収束する必要がありません。
実際の場面で最も苦労するのは、収束とアラインメントの過程です。遠くまで走れるからといって必ずしも優れているとは限らず、コース内を走り続けられるものこそ優れているのです。
- 2
Grokを使って自動化タスクを作成し、commandcode GOATにおける主要モデルの利用枠と月間推定呼び出し回数を集計しました(呼び出し回数順)。共有します:

- 3
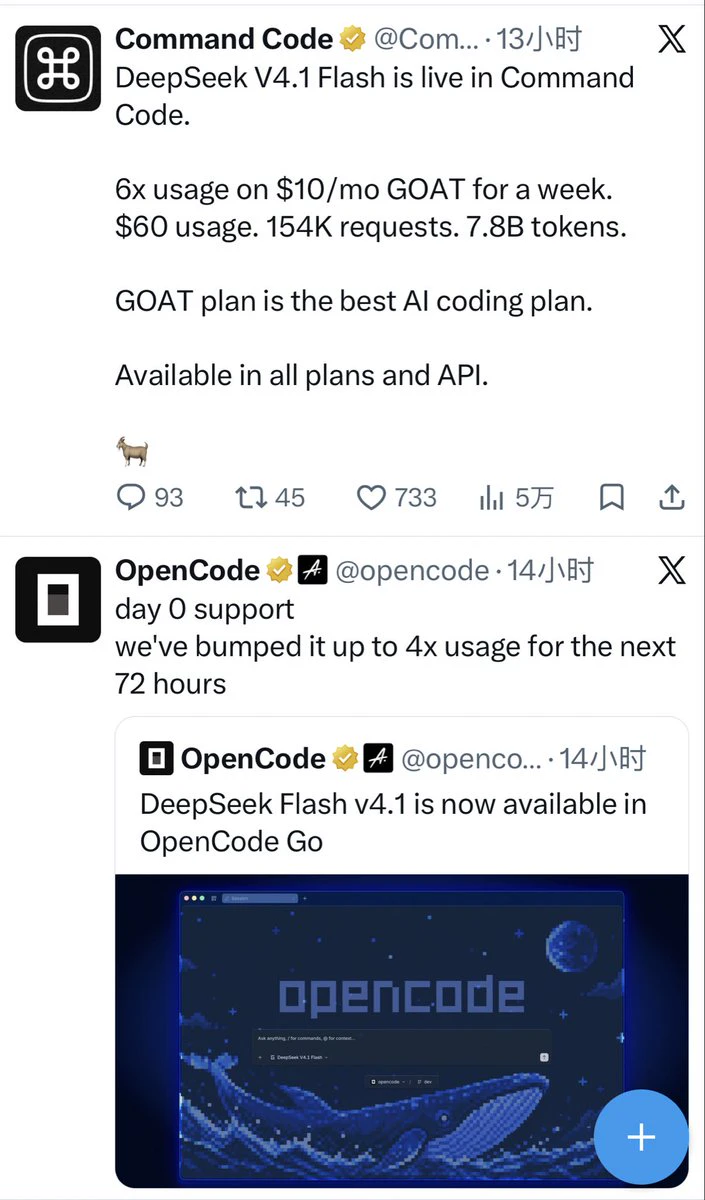
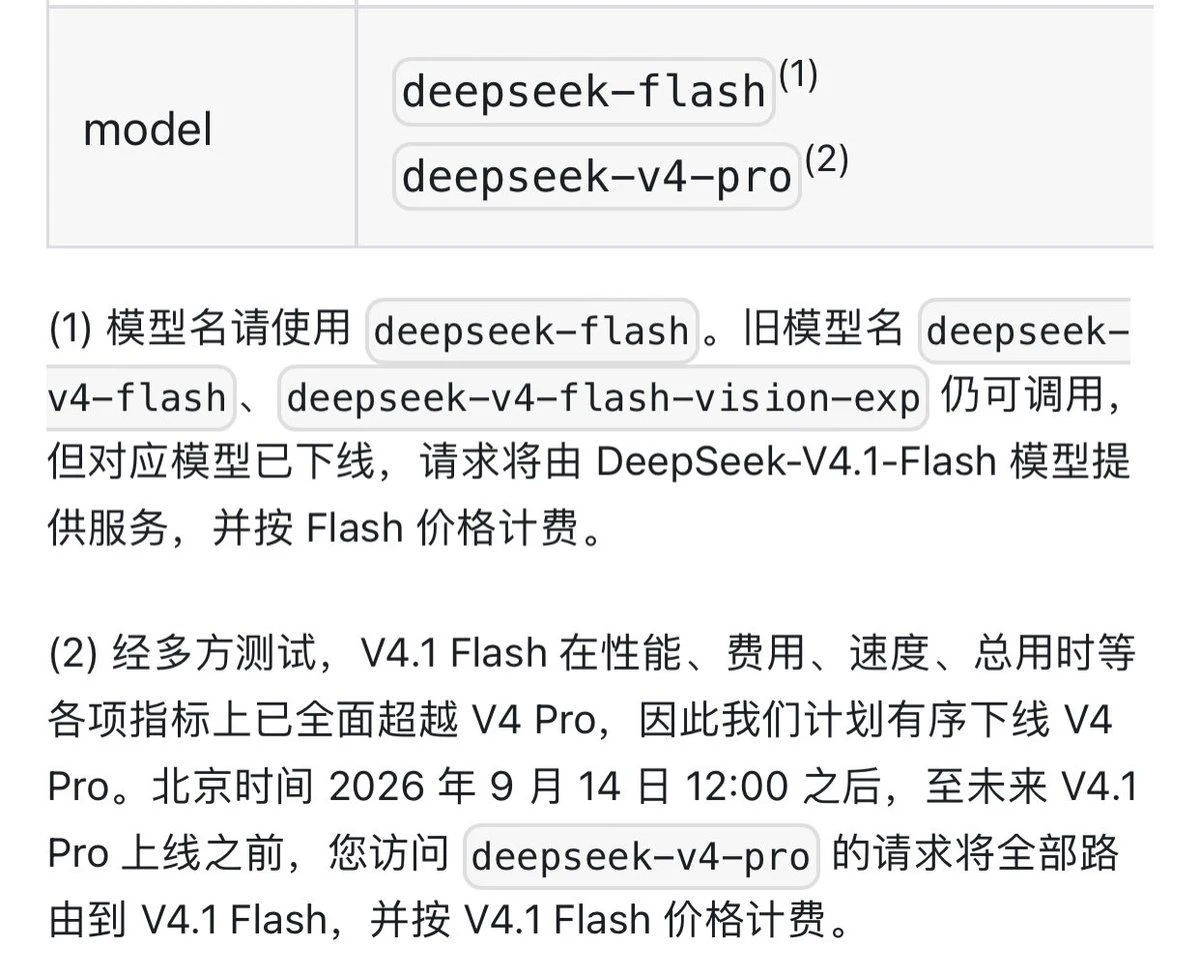
dsこれは完全に統一されていますね。サイト全体でモデルは1つだけです😂
- 1
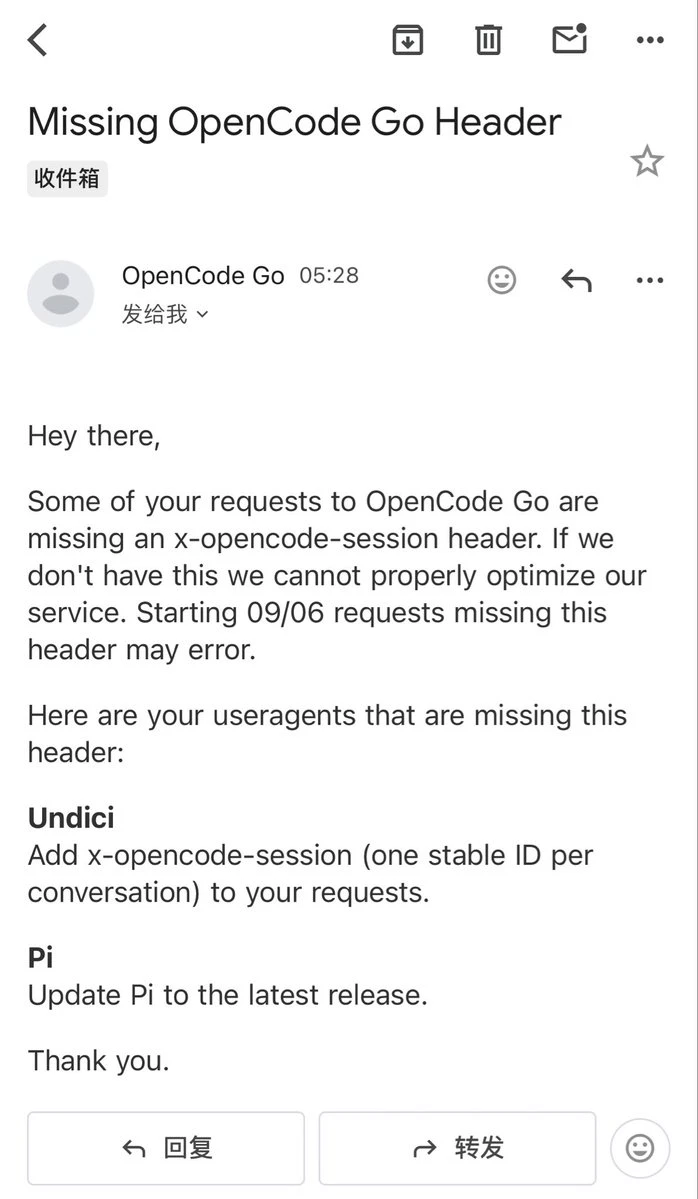
pi + opencode-go を購読してしばらくになりますが、先ほど以下のメールを受け取りました
どうもこの件は少し奇妙に感じます。ある provider がある harness の顧客にメールを送り、早急にアップグレードしないと、もう私たちのサービスを使えなくなりますよ、と要求しているのです😂
それと、この ua はなぜ pi-agent ではないのでしょうか。Undici は pi が通信の基盤として使っている sdk なのでしょうか?
どうもこの件は少し奇妙に感じます。ある provider がある harness の顧客にメールを送り、早急にアップグレードしないと、もう私たちのサービスを使えなくなりますよ、と要求しているのです😂
それと、この ua はなぜ pi-agent ではないのでしょうか。Undici は pi が通信の基盤として使っている sdk なのでしょうか?
ある問題を考えている:完全な SaaS サービスのテンプレート+AI ハーネス+カスタムスキルを、プラグイン可能なフレームワークにできる仕組みはあるだろうか?
DeepSeek ハーネスは、このようなインフラになる可能性があるだろうか?ほかに、すでに完成しているプロジェクトはあるだろうか?
DeepSeek ハーネスは、このようなインフラになる可能性があるだろうか?ほかに、すでに完成しているプロジェクトはあるだろうか?
DEEPSEEK+7.30%
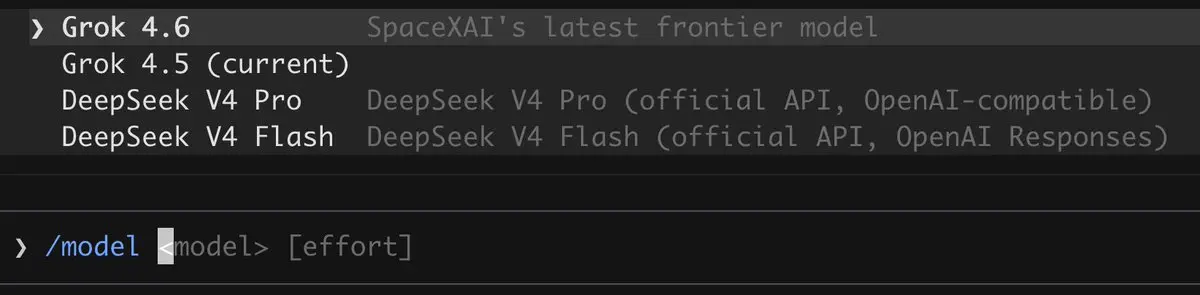
Matt Pocockが言及していたsmart zoneはコンテキスト長が約120Kという話ですが、私がgrok-4.6を使った体感でもほぼ同じで、200K近くになると明らかに性能が落ちる感じがします。皆さんの体感はいかがでしょうか?他のモデルにも明確なsmart zoneはありますか?
grok buildは私が使った中で最も体験の良いTUIで、現在はgrok-4.6と組み合わせると、コストパフォーマンスの王者と言えます。主にgrokの速度は多くの一線級モデルより速く、品質もトップクラスに入るなら、競争力が非常に強くなります(しかも、気軽にチャージしてもアカウントが凍結されません)!
grok-4.6とdeepseek-v4-proが同時にリリースされました!
ロ老の周鸿祎へのインタビューの3時間半のポッドキャストを聞き終えましたが、老周が実際に多くの実務経験を持っていることは分かりました。しかし、老ロの質問は十分に深く専門的ではなく、少し残念です。
例えば、老ロが海外のトップモデルについてこの見解を述べたとき、私は少し偏った意見だと感じました。なぜなら、異なる分野には異なる最良のモデルがあるからです。例えば、プログラミング分野では現在claude-4とgpt-5-codexが優れているかもしれません。また、老周が何度も言及したLLMの幻覚問題について、360がどのように最適化したのかについては追求されていませんでした。
全体を通して最も価値のある点は、老周が言及した垂直+サブスクリプションの料金モデルです。老周は料金モデルについて、トークンの使用量に応じた課金とメンバーシップ料金の組み合わせがあるべきだと述べました。この方法は、長期的に見てより実行可能な料金モデルです。単にトークンを販売するモデルは障壁が低すぎて、ユーザーが支払う動機はLLMの上にあるべきであり、製品が提供する垂直エージェントの能力です。
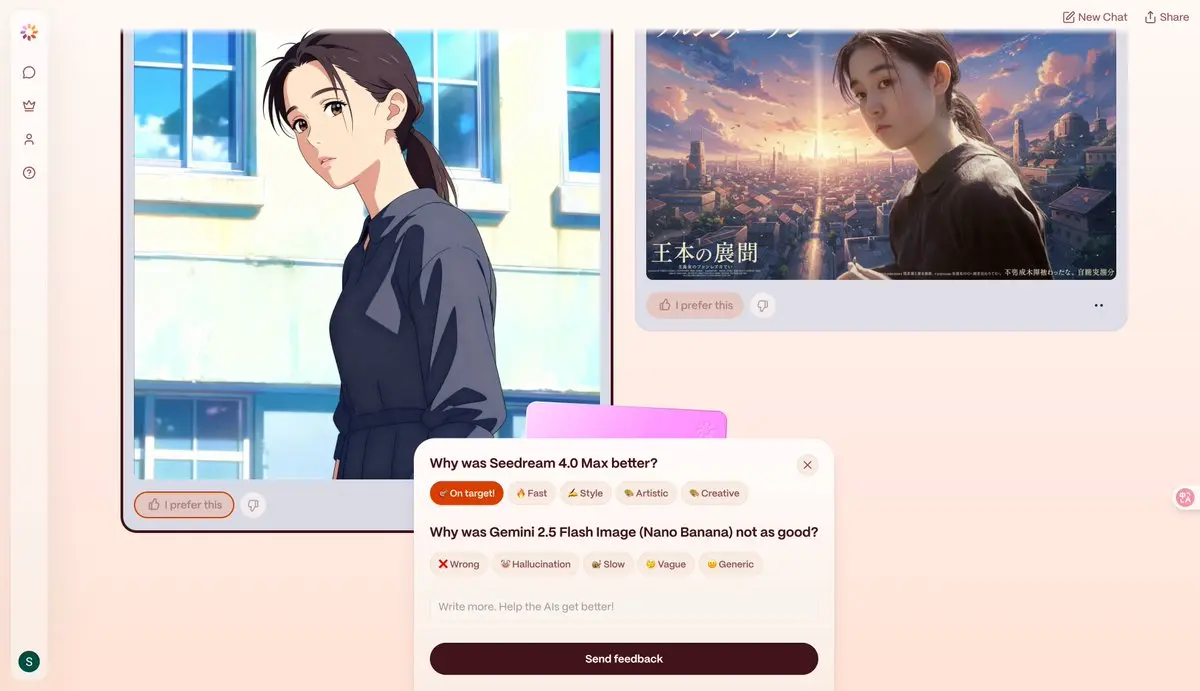
はい、このウェブサイトは面白いです。最先端のAIモデルを無料で使用し、比較することができます。
yuppでの各対話には、少なくとも2つのAI大モデルが同時に回答します。その中から、より良いと思う回答を選択し、yuppに使用フィードバックを共有できます。
ユーザーのフィードバックはポイントを獲得でき、より質の高いフィードバックはより多くのポイントを獲得できます。より多くのポイントは、より多くの高級モデルを使用できることを意味し、さらにはポイントを引き出すことも可能です。
このウェブサイトが大規模モデルを無料で使用できる理由は、ユーザーフィードバックメカニズムの構築に直接関連しています。これらのフィードバックデータは、モデルの最適化のためにモデルメーカーに提供されます。
このビジネスモデルが成立する理由は、大規模モデルのトークン価格がますます低下し、ユーザーの真のフィードバックがより価値を持つようになるからだと思います。特に、異なるメーカー間の比較においては。モデルメーカーにとっては、トークンをユーザーフィードバックと交換するのは非常にお得な取引です。
一方で、ユーザーにとっては、現在モデルが多すぎて、異なる分野や異なるシーンで、どのモデルが最もパフォーマンスが良いのか?どのモデルが自分のアプリケーションシーンに最適なのか?yuppが私たちのために無料で比較を手伝ってくれます。
現在、
OpenAIは「GPT-5コーディングガイド」を発表し、GPT-5を使用したAIプログラミングのための6つのベストプラクティスを示しました:
# 1. 指示は正確であるべきで、情報の衝突を避ける
新しいGPT-5モデルは指示に従う能力が大幅に向上しましたが、これには副作用があります:曖昧または相互に矛盾する指示に直面した場合、それを処理するのが難しいことがあります。この状況はあなたの.cursor/rulesまたは設定ファイルで特に注意が必要です。
# 2. 適切な推論レベルを設定する
GPT-5は問題を解決する際に常に一定の推論を行います。最良の結果を得るためには、複雑なタスクを処理する際に "high reasoning effort" を使用するべきです。モデルが簡単な問題に対して「考えすぎる」傾向がある場合は、より具体的な指示を与えるか、mediumまたはlowの推論レベルを選択してください。
# 3. XMLに似た構文を使用して命令を構造化するのに役立てる
私たちはCursorとの協力で、XMLに似た文法を使用することでモデルにより多くのコンテキストを提供でき、GPT-5がより良く機能することを発見しました。例えば、モデルに次のようなコーディングガイドラインを与えることができます:
XPRT+12.08%
人気の話題
#GateSeptemberTransparencyReport
289.37k 閲覧数2.63k件の議論
#StakeLaunchPoolToShare2.8M$DNA
36.77k 閲覧数680件の議論
#BitcoinTops$82K
41.25k 閲覧数39.8k件の議論
#LatviaPassesCryptoTaxLaw
34.37k 閲覧数249件の議論
#SKHynixDropsOver2%
47.72k 閲覧数2.13k件の議論
#GateSquareNewCreatorProgram
46.48k 閲覧数6.52k件の議論
#TeslaRoadsterSparksMemeCoinSurge
102.34k 閲覧数7.66k件の議論
#AltcoinReboundLosesMomentum
75.88k 閲覧数4.68k件の議論
#GateWCTCS9GlobalTradingCompetition
38.11k 閲覧数6.9k件の議論
#SpaceXQ3Earnings
142.45k 閲覧数3.07k件の議論