タスクに応じて選択する際に重要なのは、「どちらが優れているか」ではありません。流暢だが無意味な出力と、ダイナミクスの乖離のどちらがより大きな損害につながるかを見極めることです。以下では、予測対象、データと評価、適したタスク、組み合わせのルール、よくある誤解の観点から、世界モデルとLLMを比較します。能力の上限については人工超知能(ASI)、導入上の境界についてはプライベートAIもあわせてご覧ください。
主なポイント
- 世界モデルは、行動条件付きの次状態予測や潜在ダイナミクスを最適化します。LLMは、次トークン予測とテキスト構造を最適化します。
- 身体性を伴う計画・制御には世界モデルが適しており、文章作成、検索拡張型Q&A、ツール呼び出しにはLLMが適しています。
- 言語インターフェースと実行可能な環境ダイナミクスの両方が必要なタスクでは、両者を代替手段として扱うのではなく、組み合わせるべきです。
- 失敗の形態は異なります。LLMでは言語ハルシネーションが多く、世界モデルではダイナミクスの乖離や不自然な物理挙動が多く見られます。
世界モデルとは?
世界モデルとは、学習されたダイナミクスシステムです。現在の状態(または観測)と候補となる行動を入力として、環境がどのように変化するかを予測します。これにより、エージェントは計画を立てる前に、想像上で行動を試すことができます。最も明確な判断軸は、チャットの流暢さではなく、行動条件付き予測です。
テキストや見た目だけを出力するシステムとは異なり、世界モデル指向のスタックでは、予測が計画、制御、または想像を用いた学習ループに接続されます。一般的なアプローチには、モデルベース強化学習(例:Dreamer)、生成的インタラクティブシミュレーション、JEPA形式の表現予測があります。目的はそれぞれ異なるため、ブランド名を同じものとして扱うことはできません。
大規模言語モデルとは?
大規模言語モデル(LLM)とは、次トークン予測を中核的な目的として、大規模なテキストコーパスで学習された生成モデルです。LLMは、言語理解、要約、翻訳、コーディング支援、プロンプトやツールインターフェースを通じた複数ステップのテキスト処理に優れています。
LLMは物理世界を説明したり、「カップを押すと何が起こるか」の手順を書いたりできます。しかし、説明は実行可能かつ評価可能な環境ダイナミクスではありません。行動と状態のインターフェース、および閉ループの検証がなければ、LLMをコントローラーや物理エンジンとして扱うことは、モデルの規模が小さすぎる問題ではなく、選定上の誤りです。
予測対象はどのように異なりますか?
中核的な違いは予測対象です。世界モデルは行動後の次状態または潜在ダイナミクスを予測し、LLMは次トークンとテキスト構造を予測します。どちらも「予測」を行いますが、成功の基準は共通ではありません。
| 機能 | 世界モデル | LLM |
|---|---|---|
| 予測対象 | 次状態/潜在ダイナミクス(多くの場合、行動条件付き) | 次トークン/テキストおよび指示追従 |
| 行動との関係 | 行動条件付き予測が判断軸 | 通常、物理的な制御ループはモデル化しない |
| 出力形式 | 状態、表現、軌跡、またはインタラクティブな観測 | テキスト、コード、ツール呼び出しの引数 |
| 成功基準 | 検証可能な結果、計画可能性、追跡可能な誤差 | 意味的な正確性、利用可能な形式、検証可能な出典 |
| 典型的な失敗 | ダイナミクスの乖離、不自然な物理挙動 | 言語ハルシネーション、捏造された出典 |
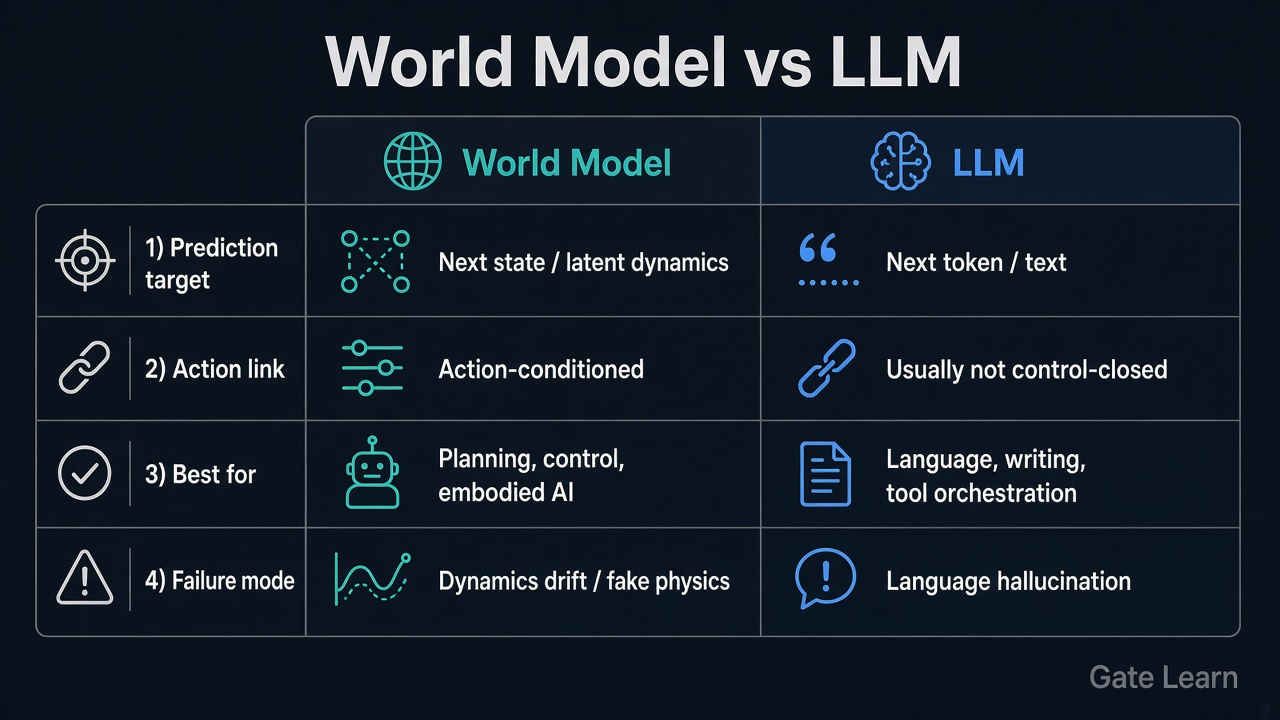
図1. 世界モデルとLLMの4つの対比:予測対象、行動との関係、最適なタスク、失敗形態。
JEPAとLLMは混同されがちです。JEPA(例:Meta AIのI-JEPA)は、共同埋め込み空間における抽象的な将来の表現を予測するため、世界モデル指向のアプローチです。一方、LLMは言語モデリングシステムです。名称が似ていても、相互に代替可能であることを意味しません。NVIDIA Glossary: World ModelsおよびLeCunによる方向性の議論(A Path Towards Autonomous Machine Intelligence)もご覧ください。
データ、出力、評価はどのように異なりますか?
データと評価は予測対象に応じて決まります。世界モデルは、インタラクティブな軌跡、状態遷移、制御信号、場合によっては動画を主に利用します。LLMは、コーパス、指示データ、任意でツールログを主に利用します。誤差指標は、下流でどのように利用されるかによって決まります。
| 次元 | 世界モデル | 大規模言語モデル |
|---|---|---|
| 典型的なデータ | 観測・行動・次観測/報酬の軌跡(動画を含む場合あり) | テキスト、対話、コード、ツール実行履歴 |
| 主な出力 | 次状態、潜在ダイナミクス、想像上の軌跡 | テキスト、構造化された回答、関数呼び出し |
| 評価の焦点 | 複数ステップの誤差、タスク成功率、OOD堅牢性 | 正確性、忠実性、形式、安全性 |
| 検出が難しい問題 | 自然に見えるが不正確な物理挙動、長期予測での誤差増大 | 流暢なハルシネーション、検証に失敗する出典 |
「正しい物理学の段落を書けること」を世界モデルの認定基準にしたり、「動画が見栄えよく見えること」をLLMの制御ループの認定基準にしたりすると、評価軸を取り違えることになります。まず検証可能な出力を定め、その後にモデルファミリーを選択してください。
どのタスクが世界モデルに適していますか?どのタスクがLLMに適していますか?
失敗コストが物理・制御に生じるのか、意味・コミュニケーションに生じるのかを起点にしてください。前者には世界モデル、後者にはLLMを優先します。両方が必要な場合は、どちらか一方を無理に選ぶのではなく、「組み合わせが必須」と判断します。
| タスク条件 | 世界モデルを優先 | LLMを優先 | 組み合わせが必要な場合 |
|---|---|---|---|
| 明示的な行動→次状態の予測が必要 | はい | いいえ | — |
| 自然言語インターフェース、ドキュメント/コード生成が必要 | いいえ | はい | — |
| 自動運転のように、接触前に失敗する軌跡を除外する身体性を伴う計画 | はい | いいえ(LLMは説明のみ可能) | 指示にはLLM、実行可能なダイナミクスには世界モデル |
| 検索拡張型Q&A、文章作成、ツールオーケストレーション | いいえ | はい | — |
| 想像上でポリシーを学習する(MBRL) | はい | いいえ | LLMはタスク文を作成できるが、ダイナミクスには依然として世界モデルが必要 |
| 目標に関する対話と実行可能な制御ループ | 単独では不十分 | 単独では不十分 | 組み合わせが必須:LLMが目標を解析→世界モデル/プランナーが実行 |
「組み合わせが必須」は一般的な構成に対応しています。LLMは意図とインターフェースを担い、世界モデル(またはシミュレーターと学習済みダイナミクス)は結果予測と軌跡のフィルタリングを担います。どちらかを省くと、もう一方の失敗形態に陥ることがよくあります。
両方を組み合わせるべきなのはどのような場合ですか?
タスクに言語レイヤーの目標と環境レイヤーの結果の両方が含まれる場合は、代替可能かどうかを議論するのではなく、両者を組み合わせてください。一般的な流れは次のとおりです。LLMが目標をサブゴールまたは制約に変換し、世界モデルが候補となる行動を展開します。プランナーがコストと安全性に基づいて軌跡を選択し、実行によって新たな観測が返され、状態が更新されます。
組み合わせとは、「2つのプロンプトを連結する」ことではありません。LLMが出力する構造化された目標、世界モデルが受け取る行動、複数ステップの誤差がいつ再計画や保守的なフォールバックを引き起こすかを、明確に定義する必要があります。この契約がなければ、システムは「流暢に話すが動作が壊れている」または「軌跡は見栄えがよいが指示と一致しない」状態になりかねません。
また、純粋なドキュメントQ&Aで世界モデルがほとんど必要ない場合や、低レベルのサーボ制御ですでに信頼できるダイナミクスが利用でき、汎用LLMが不要な場合には、無理に積み重ねる構成も適しません。組み合わせの価値は、モデル数ではなく役割分担から生まれます。
選択時にどのような誤判断やリスクがありますか?
最も一般的な誤解は、「物理について話せる」ことを「物理を実行できる」ことと見なすこと、そして「見栄えのよいフレームや軌跡」を「計画可能なダイナミクス」と見なすことです。各モデルファミリーの失敗の仕方は異なります。受け入れ判定を混同すると、導入リスクが高まります。
| 失敗形態 | より一般的な対象 | 現れ方 | 選定上のリスク | 検出方法 |
|---|---|---|---|---|
| 言語ハルシネーション | LLM | 流暢だが誤った事実や出典 | 唯一の知識源または制御の「手引き」として利用 | 出典の提示とツール検証を必須にし、裏付けのない主張を拒否する |
| ダイナミクスの乖離 | 世界モデル | 短いステップでは問題ないが、長期展開で歪む | 長い時間範囲でのオープンループ信頼 | 予測範囲に対する誤差を可視化し、再計画を確認する |
| 不自然な物理挙動 | 世界モデル | 接触や保存則に違反する滑らかな軌跡 | 視覚的なデモを物理的な合格基準にする | 貫通、エネルギー、接触制約を確認する |
| LLMをシミュレーターとして扱う | 選定の不一致 | テキスト説明が状態遷移の代わりになる | 行動条件付きループのない身体性を伴うタスク | 行動インターフェースと実行可能な状態を確認する |
| 世界モデルをチャットエンジンとして扱う | 選定の不一致 | 状態予測をサポートQ&Aに無理に適用する | 高コストで言語UXが弱い | テキスト品質が主な目的かを確認する |
リスクチェックはトリガーと結び付ける必要があります。タスクの中心が意味的な正確性である場合は、まずハルシネーションを管理します。中心が制御による結果である場合は、まず乖離と不自然な物理挙動を管理します。能力に関する説明は、受け入れ判定の代わりにはなりません。
まとめ
世界モデルと大規模言語モデルは、異なる予測問題を解決します。前者は行動の結果と計画可能なダイナミクスを対象とし、後者は言語とツールオーケストレーションを対象とします。選定時には、どちら側が失敗コストを負うかを明確にし、その後、単独利用または組み合わせのために条件表を使用してください。
JEPA形式の表現予測は世界モデル指向であり、LLMではありません。受け入れ時には、言語ハルシネーションとダイナミクスの乖離/不自然な物理挙動を別々に確認し、1つのデモが別の失敗形態を隠さないようにしてください。
FAQ
世界モデルと大規模言語モデルの違いは何ですか?
世界モデルは主に、計画や制御のために、行動後の次状態または潜在ダイナミクスを予測します。LLMは主に、言語理解、生成、ツールオーケストレーションのために次トークンを予測します。どちらも「生成」できますが、成功とは、前者では検証可能な結果、後者では利用可能な意味と形式を指します。
世界モデルは大規模言語モデルの代わりになりますか?
通常はなりません。世界モデルは、強力な言語インターフェースや大規模なテキストオーケストレーションを自然に提供するものではありません。LLMは、実行可能な行動条件付きダイナミクスを自然に提供するものではありません。言語タスクにはLLMを優先し、タスクで環境上の結果が必要な場合に世界モデルのコンポーネントを追加してください。
どのような場合に世界モデルを使用すべきですか?
タスクで状態と行動から次状態を予測し、その後に計画、制御、または想像上での行動試行を行う必要がある場合は、世界モデル指向のシステムを使用してください。代表的な例には、身体性を伴う計画、モデルベース強化学習、短期的な結果予測が含まれます。純粋な文章作成やドキュメントQ&Aは、通常、主な適用対象ではありません。
JEPAとLLMはどのような関係にありますか?
JEPA(Joint Embedding Predictive Architecture)は、埋め込み空間で将来またはマスクされた表現を予測し、世界モデルに関連する表現学習に属します。LLMは次トークン予測を中心とします。両者はエージェントスタック内に組み込むことができますが、目的と評価指標は異なります。JEPAは「別のLLM」ではありません。
両方を一緒に使用できますか?
はい。特に自然言語の指示と環境内での実行を組み合わせるタスクでは、両者の組み合わせが必要になることがよくあります。LLMが目標と制約を解析し、世界モデルまたはプランナーが結果を予測して軌跡をフィルタリングします。重要なのは、両者を1つのプロンプトに連結することではなく、明確なインターフェースと再計画のトリガーを設けることです。
* 本情報はGateが提供または保証する金融アドバイス、その他のいかなる種類の推奨を意図したものではなく、構成するものではありません。
* 本記事はGateを参照することなく複製/送信/複写することを禁じます。違反した場合は著作権法の侵害となり法的措置の対象となります。


関連記事
Render、io.net、Akash:DePINハッシュレートネットワークの比較分析

AI分野におけるRenderの申請理由:分散型ハッシュレートが人工知能の発展を支える仕組み

USD.AI 収益源分析:AIインフラ借入資金による収益創出の仕組み

USD.AIトケノミクス:CHIPトークンの使用事例およびインセンティブメカニズムのデプス分析
Audiera GameFiデプス分析:Dance-to-EarnがAIとリズムゲームをどのように組み合わせているか