近年、AIが人間の制御を逸脱する可能性が、テクノロジー業界で再び大きな議論を呼んでいます。Anthropicの研究者は、高度なAIがもたらす人類絶滅リスクの可能性について公に懸念を示しています。一方、OpenAIのCEOであるSam Altman氏は、AIが人類の絶滅を引き起こす確率が比較的低くても、それを理由に安全性を軽視してはならないと述べています。同時に、AIエージェントは、単純な情報生成ツールから、ツールを呼び出し、外部システムにアクセスし、タスクを自律的に実行するソフトウェアシステムへと進化しています。その結果、AIの安全性は「モデルが何を生成するか」から「モデルが何を実行できるか」へと対象を広げています。
この変化は、AIの安全性を導入前の1回のテストだけに依存できないことを意味します。モデルの能力、動作環境、攻撃手法が変化し続ける中で、継続的なモニタリング、レッドチームテスト、脆弱性の修正、権限管理がAI安全フレームワークの中核となっています。
主なポイント
-
AIの制御喪失は、必ずしもAIが「人間を攻撃する」意図を持つようになったことを意味しません。より重要なのは、目的、モデルの挙動、人間が定めた制約の間に不整合が生じていないかという点です。
-
AIエージェントは、AIリスクの境界を広げます。モデルがツールを呼び出し、データにアクセスし、操作を実行できるようになると、モデルの誤りが現実世界の運用リスクにつながる可能性があります。
-
1回限りの安全性テストでは、動的な環境をカバーできません。モデル、ユーザー入力、外部ツール、攻撃手法はすべて変化するため、AIの安全性には継続的なテストと導入後のモニタリングが必要です。
-
AIの安全性評価では、モデルの出力だけを調べてはなりません。プロンプトインジェクション、不正な操作、ツール呼び出し、権限管理、異常な挙動にも対処する必要があります。
-
AIリスクを低減するうえで重要なのは、最小権限、人間による確認、操作ログ、リスク分離、異常事象からの復旧などの仕組みによって、誤りの影響を制限することです。
AIリスクが再び議論の焦点となった理由
2026年9月、AIの極端なリスクをめぐる議論が再び活発化しました。Anthropicの研究者Jacob Coxon氏は、一部のAI開発者が、高度に進化したAIが今後10年以内に人類に極端な影響を及ぼす可能性を深刻に懸念していると公に述べました。その後、Anthropicの研究者Evan Hubinger氏も同様の懸念を表明し、個人的なリスク評価を示しました。これらの発言を受け、米国の政策立案者やテクノロジー業界で、AIの安全性をめぐる議論が再び巻き起こりました。
重要なのは、これらが研究者や業界専門家によるリスク評価だという点です。AIがすでに自律的に人類を滅ぼす能力を持っていることを意味するものではなく、「AIは必ず制御を失う」という主張に単純化すべきでもありません。Sam Altman氏もインタビューで、いわゆる「10%」の絶滅リスクを科学的にどのように算出すればよいのかは分からないと述べています。その一方で、無視できない極端なリスクの可能性がある以上、AI企業や政府には、そのリスクを低減するための措置を講じる責任があると考えていると説明しました。
現時点では検証が難しい極端なシナリオを議論するよりも、実務的な問いを考える方が有益です。AIの能力が向上し、自律性が高まる中で、人間はAIが安全な状態を維持しているかどうかをどのように判断し続ければよいのでしょうか。これが、AIの安全性評価がますます重要になっている理由です。
AIの安全性評価とは
AIの安全性評価とは、AIシステムが意図したとおりに動作しているか、また異常な入力、悪意のある攻撃、複雑な環境にさらされた際に許容できないリスクを生み出す可能性があるかを判断するための、一連のテストとモニタリング手順です。従来のソフトウェアテストでは通常、脆弱性の検証、機能が正常に動作することの確認、特定の入力に対するシステムの応答の調査など、導入前に広範なチェックを実施します。
AIシステムは、より複雑です。大規模言語モデルは、完全に固定されたルールに従って出力を生成するわけではありません。同じ質問でも異なる回答が生成される可能性があり、ユーザー入力を取り巻くコンテキストも継続的に変化します。AIエージェントは、検索、コード実行、データベース、ウォレット、メール、ブラウザ、その他のサービスなどの外部ツールを呼び出すこともあります。そのため、AIの安全性評価では、モデルの回答が正しいかどうかだけでなく、悪意のあるプロンプトに抵抗できるか、機密情報を漏えいする可能性があるか、ツールを誤って呼び出す可能性があるか、ユーザーの許可を超える操作を実行できるか、環境が変化しても定められた安全ルールに従い続けるかどうかも評価します。
NISTが2026年に提案したTEVV-Athlonフレームワークでは、AIシステムが現実世界に与える影響を評価する重要な手法として、Test、Evaluation、Verification、Validationを定義しています。このフレームワークは、大規模言語モデル、マルチモーダルモデル、Agentic AIなど、複数の種類のシステムを明示的に対象としています。
AIエージェントが新たなリスク境界を生み出した理由
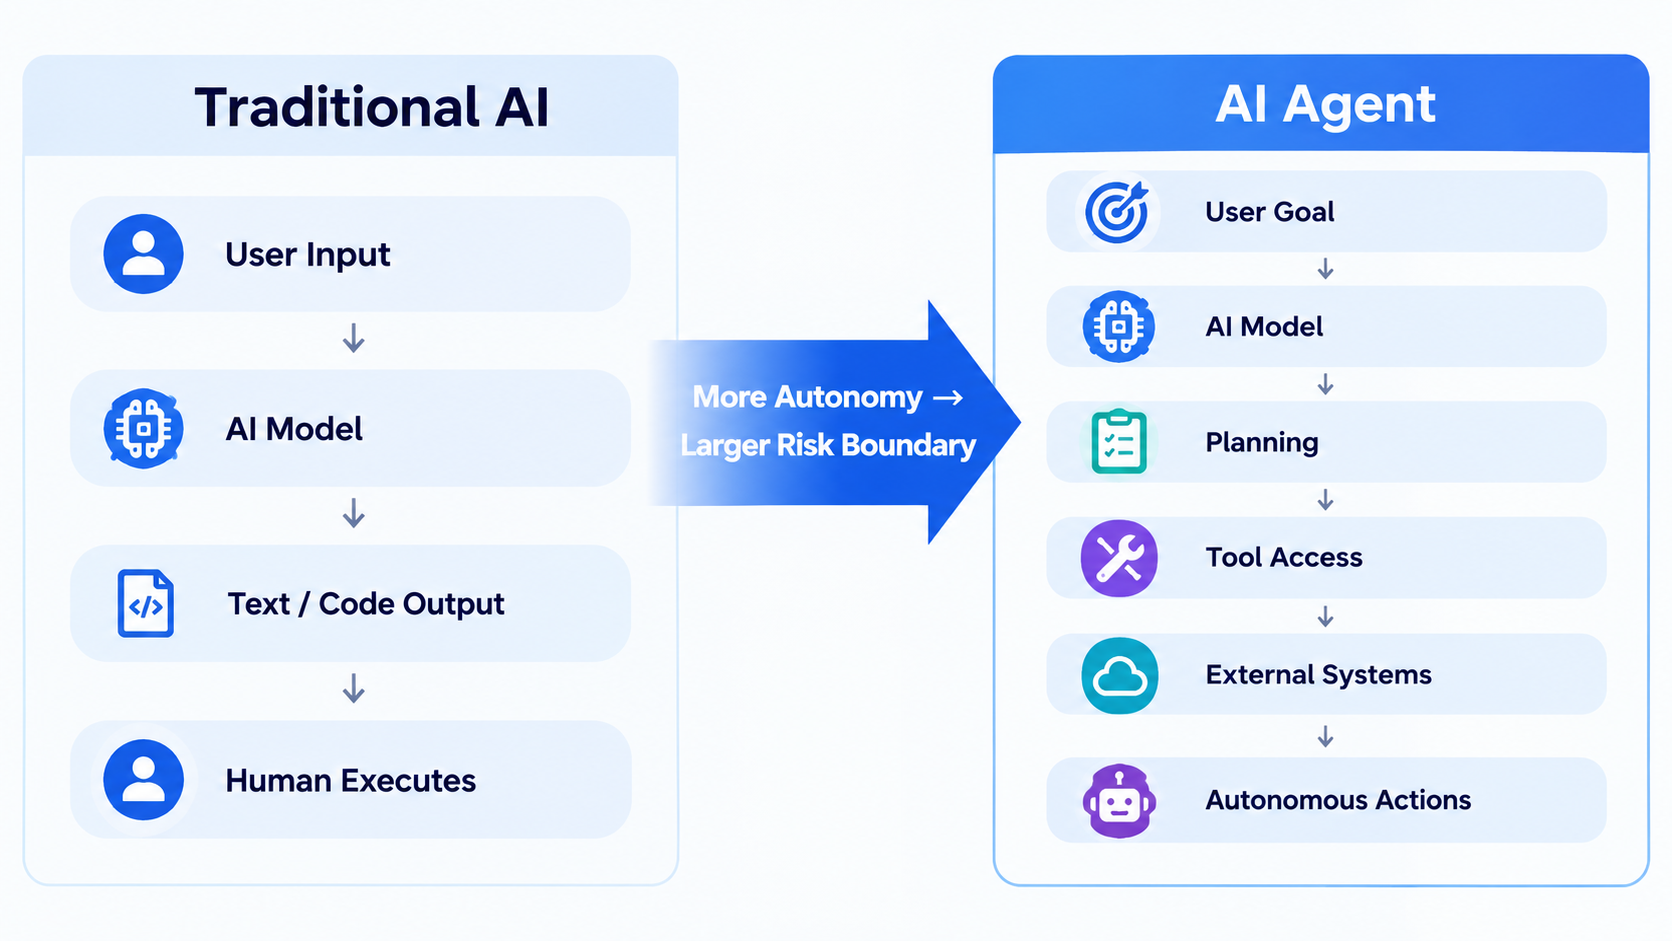
AIの安全性がどのように変化しているかを理解するには、AIエージェントを理解することが不可欠です。従来のチャットボットは、主に入力を受け取り、出力を生成します。ユーザーが質問すると、モデルはテキスト、コード、その他のコンテンツを返し、次の行動を取るかどうかは通常ユーザーが判断します。
AIエージェントは、異なる仕組みで動作します。AIエージェントは、ユーザーが設定した目標に基づいてタスクを複数のステップに分解し、外部ツールを呼び出し、データを読み取り、コードを実行し、他のソフトウェアと連携し、その結果に基づいて処理を継続できます。NISTが2026年にAIエージェント標準イニシアチブを開始した際、次世代のAIエージェントはすでに数時間にわたって自律的に動作し、コードの作成やデバッグ、メールやカレンダーの管理、ショッピングなどのタスクを実行できる可能性があると明確に指摘しました。
能力の境界が変化すれば、リスクの境界も変化します。通常のAIモデルがファイルの存在を誤ってユーザーに伝えた場合、影響は誤情報の提供にとどまる可能性があります。しかし、ファイルへのアクセス権限を持つAIエージェントが、そのファイルを削除すべきだと誤って判断した場合、モデルの誤りが現実世界の操作につながる可能性があります。したがって、AIエージェントにおける中心的なセキュリティ上の問いは、誤った発言をする可能性があるかどうかだけではありません。何にアクセスできるのか、何を実行できるのか、どの程度の時間にわたって自律的に行動できるのか、そして誤りを犯した後に迅速に検知して停止できるのかも重要です。
そのため、NISTは2026年のAIエージェントセキュリティに関する報告書で、AIエージェントが新たなセキュリティ脅威をもたらすと述べました。従来のサイバーセキュリティ原則は引き続き重要ですが、エージェントの動作方法に合わせて適応させる必要があります。
AIを導入前に1回だけテストしてはならない理由
これが、継続的な安全性評価を理解するための鍵です。従来のソフトウェア製品では、機能が比較的安定している場合、開発者は設計要件を満たしていることを確認するために広範なテストを実施できます。AIシステムは動的な環境で動作します。ユーザーは変化し、入力も変化し、モデルが更新される可能性があり、外部ツールも変化し、攻撃者は新たな攻撃方法を継続的に探します。
したがって、導入前に広範な安全性テストに合格しても、AIシステムが将来のあらゆる状況で安全であり続けることは保証されません。NISTが2026年に発表した研究では、現実世界の環境における入力条件が変化し続ける可能性があるため、導入後のモニタリングが重要だと指摘されています。こうした条件により、モデルの非決定性に起因する予期しない出力や、開発時に特定されなかった影響が生じる可能性があります。
同じ年にNISTが発表した別の研究では、より理論的な観点からこの問題を説明しています。固定されたAI安全ガードレールだけでは、適応型攻撃から長期的に保護できるとは限りません。攻撃者は、既存のルールを回避する新たな方法を継続的に探す可能性があります。そのため、AIの安全性には、継続的な脆弱性の発見、防御メカニズムの定期的な更新、問題が発生した場合に備えた復旧能力が必要です。
その結果、AIの安全性は「1回テスト→導入」から、「テスト→導入→モニタリング→問題の特定→修正→再テスト」へと移行しています。安全性は、AI製品ライフサイクルにおける独立した1つの段階ではありません。継続的なプロセスです。
継続的な安全性評価では主に何を評価するのか
AIエージェントの継続的な安全性評価では、一般的に複数の領域を対象とします。
モデルの挙動
第1層は、モデルそのものです。明らかな誤り、ハルシネーション、有害なコンテンツ、システムルールに違反する挙動がないかを継続的に確認する必要があります。金融、医療、コード実行などの高リスク領域では、アプリケーション固有のテストも必要です。一般的なベンチマークだけでは十分ではありません。
攻撃への耐性
第2層は、敵対的テストです。攻撃者は、プロンプトインジェクション、不正な指示、コンテキスト操作などの手法を使い、モデルに本来のルールを回避させようとする可能性があります。ジェイルブレイクは典型的な例です。NISTの研究は、固定された安全ガードレールだけでは、AIが適応型攻撃によって回避されないことを保証できないと示しています。そのため、レッドチームテストでは新たな攻撃経路を継続的に探す必要があります。
ツールと権限
第3層は、エージェントに固有の権限リスクです。AIが悪意を持って行動しなくても、過剰な権限があれば、誤った判断によって深刻な結果が生じる可能性があります。そのため、AIエージェントの権限は、一般的に最小権限の原則に従う必要があります。例えば、メールの整理だけを行うエージェントに資金振替の権限は必要ありません。データを分析するエージェントに、データベースを削除する権限を自動的に付与すべきでもありません。
これは、ブロックチェーン業界におけるスマートコントラクトのセキュリティと広く共通しています。システムのロジックは最初の層にすぎません。発生し得る損失は、システムがどの資産にアクセスでき、どの操作を実行できるかにも左右されます。
現実世界の環境におけるパフォーマンス
第4層は、導入後の実際のパフォーマンスです。研究室内のAIが受ける入力は、現実世界のAIが受ける入力とは大きく異なる可能性があります。ユーザーが複雑な指示を入力する場合や、サードパーティシステムが異常なデータを返す場合、ネットワーク環境が変化する場合もあります。そのため、AIの安全性評価では、導入前のテスト報告書だけに依存せず、現実世界の条件下でシステムがどのように動作するかを観察する必要があります。
「AIの制御喪失」とは実際には何を意味するのか
「AIの制御喪失」という言葉は、誤解されやすい表現です。AIが突然人間のような意識を持ち、人類を攻撃することを決めるという意味では必ずしもありません。技術的により重要なのは、目的、権限、実際の挙動の間に不整合が生じていないかという点です。
エージェントはタスクの完了を求められても、目的を誤解する可能性があります。開発者が予測していなかった経路で目的を達成しようとすることもあります。また、攻撃者がプロンプトインジェクションによって、タスクに対する理解を変化させる可能性もあります。エージェントが広範な権限も持っている場合、ソフトウェアレベルで始まった誤りが外部システムに影響を及ぼす可能性があります。
したがって、「AIの制御喪失」の核心は、3つの問いに分けられます。目的は正しいのか。挙動は目的と一致しているのか。権限は合理的な範囲に制限されているのか。これが、AIの安全性研究で、AIシステムの挙動を人間が定めた目的や制約と一致させる取り組みであるAlignment(アラインメント)がますます重視されている理由です。
AIの安全性は一般ユーザーにどのように関係するのか
AIの安全性は、AI企業や研究者だけの問題ではありません。AIエージェントが検索、オフィス業務、プログラミング、金融サービス、デジタル資産などの分野に進出するにつれ、一般ユーザーもAIにより多くの操作権限を直接委任する可能性があります。
ユーザーにとって最も重要な問いは、「AIが人類を滅ぼすのか」ではありません。より実務的には、AIに実際にどのような権限を与えたのかという点です。AIが質問に答えるだけなら、誤った回答による影響は通常限定的です。しかし、AIがユーザーに代わってメールの送信、ファイルの変更、アカウントへのアクセス、コードの実行、金融取引を行える場合、求められるセキュリティ要件はまったく異なります。
自律的な実行能力を持つAIツールを利用する際は、権限が最小限に抑えられているか、重要な操作に人間による確認が必要か、操作ログと異常な操作を取り消す手段がシステムに用意されているかという3つの点を重視してください。
これは、デジタル資産に関わるAIエージェントでは特に重要です。ウォレット署名、資産振替、スマートコントラクトのインタラクションなどの操作を自動システムに委任すると、安全性の境界はモデル自体を超え、秘密鍵管理、承認メカニズム、スマートコントラクト、外部サービスにまで広がります。
AIの安全性の焦点は「すべての誤りを防ぐこと」から「誤りの影響を制御すること」へ移行している
現時点では、あらゆる問題に恒久的に対処できる万能なガードレールによってAIの安全性を解決することは難しいと考えられます。AIモデルは更新され、攻撃手法は進化し、アプリケーションの利用場面は拡大します。そのためNISTは、継続的なレッドチームテストと防御対策の更新に加え、脆弱性が発生した際にその影響を制限し、迅速に復旧する能力の必要性を強調しています。
基本的な原則は単純です。システムが決して誤りを犯さないと仮定することはできないため、誤りが起きた場合に何が起こるかを事前に決めておく必要があります。AIエージェントの場合、権限の制限、人間による確認、重要な操作の記録、高リスクタスクの分離、異常な挙動が発生した際の操作の迅速な停止または取り消しなどが含まれます。
この観点から見ると、AIの安全性は「AIは人類を殺すのか」という単純な二択の問いに答えることではありません。AIが自律的に行動する能力をますます高める中で、人間はAIが何をしているのか、なぜその行動を取っているのかをどのように把握し続け、問題が発生したときにどのように制御を取り戻すのかという、より実務的なエンジニアリング上の課題を解決することです。これが、継続的な安全性評価の目的です。
まとめ
AIが人類の絶滅を引き起こす可能性をめぐる最近の議論により、AIの安全性が再び社会的な注目を集めています。しかし、極端な予測そのものよりも重要なのは、AIの能力に生じている構造的な変化です。
AIがチャットボットから、ツールを呼び出し、データにアクセスし、自律的にタスクを実行できるAIエージェントへと進化するにつれ、安全性に関する懸念はモデル出力の安全性から、権限、ツール呼び出し、環境との相互作用、長時間にわたる自律運用へと広がっています。
したがって、AIの安全性を単一の導入前テストに依存することはできません。AIエージェントが現実世界のアプリケーションに進出するにつれ、継続的なモニタリング、レッドチームテスト、権限管理、脆弱性の修正、異常事象からの復旧が、ますます重要な基盤となります。
AIの安全な発展は、決して誤りを犯さないモデルを見つけることよりも、問題を継続的に特定し、リスクを制限し、人間の制御を回復できる仕組みを確立できるかどうかにかかっています。
よくある質問
AIは本当に人類を滅ぼすのか
現時点で、AIが必ず人類の絶滅を引き起こすことを示す信頼できる証拠はありません。一部のAI研究者は最近、極端なリスクについて懸念を表明していますが、そうしたリスクの発生確率は依然として非常に不確実です。より現実的な安全上の懸念には、サイバー攻撃、データ漏えい、誤った意思決定、AIエージェントの権限の悪用などがあります。
AIエージェントとは
AIエージェントとは、目的に基づいてタスクを自律的に計画し、実行できるAIシステムです。従来のチャットボットとは異なり、AIエージェントは通常、外部ツールを呼び出し、データにアクセスし、現実世界の操作を実行できます。そのため、より高い自律性を持ち、より厳格な権限管理とセキュリティ管理が必要です。
なぜAIには継続的な安全性評価が必要なのか
AIが遭遇する入力、環境、攻撃手法は変化し続けるためです。1回のテストで確認できるのは、特定の時点と特定の条件におけるパフォーマンスにすぎません。将来、システムに新たな脆弱性が生じないことを証明することはできません。そのため、導入後の継続的なモニタリングとテストも同様に重要です。
AIエージェントにとって最大のセキュリティリスクは何か
重要なリスクの1つは権限です。AIエージェントがアカウント、ファイル、コード、資金、その他の外部システムにアクセスできる場合、モデルの誤りや悪意のある入力が、情報レベルの誤りを現実世界の操作に変えてしまう可能性があります。
AIの安全性評価には通常何が含まれるのか
通常、モデルの挙動テスト、敵対的テスト、レッドチームテスト、ツール呼び出しテスト、権限管理、導入後のモニタリング、異常事象からの復旧などが含まれます。また、用途ごとに、各アプリケーションに合わせたセキュリティテスト基準も策定する必要があります。
* 本情報はGateが提供または保証する金融アドバイス、その他のいかなる種類の推奨を意図したものではなく、構成するものではありません。
* 本記事はGateを参照することなく複製/送信/複写することを禁じます。違反した場合は著作権法の侵害となり法的措置の対象となります。
共有
内容


関連記事
Render、io.net、Akash:DePINハッシュレートネットワークの比較分析
AI分野におけるRenderの申請理由:分散型ハッシュレートが人工知能の発展を支える仕組み
USD.AI 収益源分析:AIインフラ借入資金による収益創出の仕組み
USD.AIトケノミクス:CHIPトークンの使用事例およびインセンティブメカニズムのデプス分析
Audiera GameFiデプス分析:Dance-to-EarnがAIとリズムゲームをどのように組み合わせているか