


2026年11月3日、AMDは第3四半期の決算を発表し、四半期売上高は前年同期比45%増の133億7,700万ドルに達しました。データセンター売上高は前年同期比97%増の85億4,600万ドルとなりました。同社は第4四半期の売上高が約170億ドルになると見込んでおり、Instinct GPU、EPYC CPU、Heliosラックスケールシステムが連携してデータセンター事業の成長を後押しすると強調しました。これらの動きにより、NVIDIAが主導するAIコンピューティング市場でAMDがより大きなシェアを獲得できるかどうかに、投資家の注目が集まっています。
ただし、AIチップの競争は、単に2社の製品性能を比較するだけではありません。GPUメモリ容量、推論スループット、ソフトウェア互換性、ネットワーク、消費電力、総保有コストはいずれも、大手クラウドサービスプロバイダーの調達判断に影響を及ぼす可能性があります。本記事では、AI推論の技術的特性を通じてAMDとNVIDIAの競争動向を分析するとともに、こうした変化がAIチップ業界および関連する米国株投資家にとって何を意味するのかを解説します。
要点
-
AIチップの競争は、トレーニング向けコンピューティングから推論効率へと拡大しています。大規模言語モデルのアプリケーションが拡大するにつれ、推論時のコンピューティングコスト、応答速度、消費電力がデータセンター調達における重要な要素となっています。
-
AMDはデータセンター向けAI事業を拡大しています。2026年第3四半期のAMDのデータセンター売上高は約85億5,000万ドルに達し、前年同期比97%増となって、同社の総売上高を過去最高に押し上げました。
-
NVIDIAの競争優位性はGPUハードウェアにとどまりません。CUDAソフトウェアエコシステム、ネットワーク、開発者ツール、統合型ラックシステムにより、大規模AIインフラ展開に向けた強力なシステム統合能力を提供しています。
-
AMDはInstinct GPU、Helios、ROCmを通じて包括的な代替手段の構築を目指しています。その競争上の焦点は、個別チップの性能からシステムレベルのコンピューティング能力および総保有コストへと徐々に移行しています。
-
AI推論需要の拡大は、AMDまたはNVIDIAの株価上昇を必ずしも意味しません。投資家は、チップの供給能力、利益率、顧客の設備投資、市場バリュエーションも注視する必要があります。
AI推論とは何か?AIモデルのトレーニングとはどう異なるのか?
AI推論とは、トレーニング済みの人工知能モデルがユーザー入力に基づいて予測、テキスト、画像、その他の出力を生成する計算プロセスを指します。たとえば、ユーザーがAIアシスタントに質問し、モデルが入力に基づいて段階的に回答を生成するプロセスが推論です。モデルのパラメータを継続的に調整するトレーニングとは異なり、標準的な推論では主に既存のモデルパラメータを使用して計算を実行します。ただし、一部の推論システムには、検索、ツール呼び出し、追加の計算ステップが組み込まれる場合もあります。
AIのトレーニングと推論では、コンピューティングリソースに対する要件が大きく異なります。大規模モデルのトレーニングでは通常、多数のGPUを長期間にわたって連携させる必要があり、コンピューティング性能、メモリ容量、高速インターコネクトに対する要求が高くなります。一方、推論では、リクエストへの応答時間、単位時間当たりに処理できるタスク数、各リクエストに必要なコンピューティングコストがより重視されます。リアルタイムチャットや音声アシスタントなどのアプリケーションでは、ユーザーは応答遅延に非常に敏感です。バッチでのテキスト処理やデータ分析タスクでは、全体的なスループットとコストがより重要になる場合があります。
| 比較項目 | AIトレーニング | AI推論 |
|---|---|---|
| 主な目的 | モデルパラメータの学習と最適化 | モデルを使用して結果を生成 |
| コンピューティング特性 | 大規模かつ長時間のコンピューティング | 高頻度かつ継続的なリクエスト処理 |
| 主要指標 | トレーニング速度、スケーリング効率 | レイテンシー、スループット、単位当たりコスト |
| メモリ要件 | パラメータ、勾配、トレーニング状態 | モデルの重み、KV Cacheなど |
| ビジネスユースケース | 基盤モデルの開発 | AIアシスタント、検索、エージェント、エンタープライズアプリケーション |
AIアプリケーションの規模拡大に伴い、推論リクエストは継続的に増加する可能性があります。たとえば、モデルのトレーニングに必要な大規模な実行回数は限られていても、導入後には長期間にわたり数百万人のユーザーにサービスを提供する可能性があります。このため、累積的な推論支出がAIインフラコストの主要な要因となる可能性があります。ただし、トレーニング支出と推論支出の比率はモデルやアプリケーションによって大きく異なるため、推論コストが常にトレーニングコストを上回るとは限りません。
なぜAI推論はAMDとNVIDIAの競争の焦点になっているのか?
AI推論市場が注目を集めている主な理由は、AIビジネスモデルがモデル能力の競争から、実際の利用コストの競争へと拡大しているためです。クラウドサービスプロバイダーやAIアプリケーション開発者にとって、モデルがタスクを完了できることは基本的な要件にすぎません。合理的なコストで多数のユーザーに継続的にサービスを提供できるかどうかも、製品を商用化できるかどうかを左右します。ユーザー数と呼び出し頻度が増加するにつれ、推論1回当たりのコストをわずかに削減するだけでも、全体の運用費に大きな影響を与える可能性があります。
推論ワークロードは一様ではありません。リアルタイムの会話には低レイテンシーが求められ、複雑な推論モデルでは長い推論プロセスを生成する必要があり、AIエージェントは単一のタスク内でモデルの呼び出し、データ検索、ツール実行を複数回行う場合があります。ワークロードごとに、演算精度、メモリ容量、メモリ帯域幅、システムインターコネクトに対する要件が異なります。このため、異なるハードウェアアーキテクチャ間で競争の余地が生まれ、単一の性能指標だけでどのチップが優位かを判断することは困難です。
AMDにとって、推論市場の重要性はAI GPU市場シェアを拡大できる可能性にあります。大手クラウドサービスプロバイダーは通常、ハードウェア調達コストを抑えながら、単一サプライヤーへの過度な依存を避けようとします。AMDが性能、価格、ソフトウェア互換性、供給能力の面で条件に合う代替手段を提供できれば、より多くのデータセンター調達計画に参加できる可能性があります。ただし、NVIDIAも推論製品とソフトウェアプラットフォームを継続的に最適化しているため、推論需要の拡大がNVIDIAの競争上の地位の低下を必ずしも意味するわけではありません。
AMDのデータセンター事業は最近どのような実績を示しているのか?
2026年11月に発表されたAMDの第3四半期決算は、データセンターが同社にとって最も重要な事業成長源の1つとなったことを示しています。総売上高は前年同期比45%増の133億7,700万ドルに達し、データセンター売上高は前年同期比97%増の85億4,600万ドルとなりました。同期間の非GAAPベースの1株当たり利益は前年同期比74%増の2.09ドルに達し、データセンター事業の拡大が全体の収益性に寄与していることを示しています。
注目すべき点は、AMDのデータセンター事業にはInstinct AI GPUだけでなく、EPYCサーバーCPUも含まれていることです。そのため、データセンター売上高のすべてをAI推論チップの売上高として直接扱うべきではありません。同社の事業成長は、AIアクセラレーターに対する需要と、汎用サーバーコンピューティングに対する需要の両方によって支えられています。投資家にとって、AMDが実際にAI GPU市場シェアを拡大しているかを判断するには、製品出荷、顧客による導入、具体的な事業構成をさらに観察する必要があります。
AMDは2026年第4四半期の総売上高についても約170億ドルを見込んでおり、第3四半期からの成長が継続する見通しです。同社はHeliosラックスケールシステムの導入を進めるとともに、大手クラウドサービスプロバイダーやAI企業との協力を拡大しています。こうした動きは、AMDがチップサプライヤーからより包括的なAIインフラプロバイダーへと進化しようとしていることを示しています。ただし、将来の売上高が継続して成長できるかどうかは、依然として顧客の調達、サプライチェーン、製品競争力に左右されます。
AI推論におけるAMD InstinctとNVIDIA GPUの違いは何か?
AMDとNVIDIAのAI GPUはいずれもモデルのトレーニングと推論タスクをサポートできますが、両社は製品ロードマップ、ソフトウェアエコシステム、システム統合へのアプローチにおいて異なります。AMDのInstinctシリーズは主にデータセンターにおける高性能コンピューティングとAIアクセラレーションを対象としている一方、NVIDIAはデータセンターGPU、CUDAソフトウェアプラットフォーム、関連ネットワーク技術を通じて、より包括的なAIコンピューティングの枠組みを構築しています。
推論タスクにおいて、GPUの理論上のコンピューティング性能は評価基準の1つにすぎません。モデルは重みや中間データに頻繁にアクセスする必要があるため、メモリ容量、メモリ帯域幅、キャッシュ管理も同様に重要です。大容量メモリは、モデルパラメータや、より多くの同時リクエストによって生成されるKV Cacheを収容するのに役立ちます。また、より高いメモリ帯域幅は、特定の推論タスクにおけるデータアクセスのボトルネックを軽減できる可能性があります。ただし、具体的な利点はモデルの規模、量子化精度、バッチ処理戦略、ソフトウェア最適化の水準に依存します。
NVIDIAの優位性は、ハードウェアとソフトウェアを連携させる能力にあります。NVIDIAはGPUに加えて、CUDA、TensorRT-LLM、推論サービングフレームワーク、高速インターコネクト技術を提供しており、開発者は比較的成熟したツールチェーンを中心にAIワークロードを展開できます。一方、AMDはROCm、Instinct GPU、Heliosシステムを通じて互換性とシステム性能を向上させ、代替ハードウェアを採用する顧客の移行コストを抑えようとしています。
| 比較項目 | AMD | NVIDIA |
|---|---|---|
| AIアクセラレーター | Instinctシリーズ | データセンターGPUシリーズ |
| ソフトウェアエコシステム | ROCm | CUDA |
| システムレベルのソリューション | Helios | NVLなどのラックスケールプラットフォーム |
| 主な競争上の焦点 | オープンエコシステム、コスト、性能 | ソフトウェアの成熟度、システム統合 |
| 推論最適化の焦点 | メモリ容量、スループット、ソフトウェア適応 | レイテンシー、スループット、ハードウェアとソフトウェアの連携 |
| 主な課題 | エコシステムの互換性と導入の成熟度 | システムコストと顧客のサプライヤー集中 |
重要なのは、上記の比較が普遍的な性能ランキングではなく、製品とエコシステムの位置付けを反映していることです。異なるGPUは、モデル、精度レベル、導入条件によって性能が大きく異なる場合があります。実際の推論効率を、メモリ容量または理論上のコンピューティング性能だけで判断することはできません。
CUDAとROCmはなぜAIチップの競争環境に影響を与えるのか?
CUDAはNVIDIAが長年開発してきた並列コンピューティングプラットフォームであり、ROCmはAMDのGPUコンピューティングおよびAIワークロード向けソフトウェアプラットフォームです。どちらも開発ツール、コンピューティングライブラリ、ランタイム環境を提供し、開発者がGPUを複雑なコンピューティングタスクに利用できるようにします。大手AI企業にとって、GPUの選定はハードウェアの調達にとどまりません。既存のモデルコード、トレーニングフレームワーク、推論エンジン、運用システムが安定して稼働できるかどうかも重要です。
CUDAの競争優位性は、長年にわたり構築されてきたソフトウェアエコシステムに由来します。多くのAIモデルや開発ツールはすでにNVIDIA GPU向けに適応・最適化されているため、NVIDIAハードウェアを使用する企業は、移行やデバッグに関する作業の一部を削減できる場合があります。特に大規模クラスタ環境では、ソフトウェアの安定性、性能分析ツール、技術サポートがコンピューティングリソースの利用効率に直接影響を与える可能性があります。
AMDはROCmを通じて、開発者体験と主流AIフレームワークへの対応を改善しています。2026年第3四半期にAMDはROCm 10をリリースし、関連する開発ツール、コンパイラ、コンピューティングライブラリ、モデルサポートをさらに強化しました。これらの改善はAMD GPUの適用範囲の拡大に役立ちますが、新バージョンのリリースは、すべてのCUDAアプリケーションが修正なしでROCmに移行できることを意味するものではありません。
商業的な観点から見ると、ソフトウェア互換性はGPUの実際の総保有コストに影響します。企業が低価格のアクセラレーターを購入しても、モデルを再最適化するために多大なエンジニアリングリソースを投じる必要がある場合、ハードウェアコストの節約分が最終的に開発コストによって相殺される可能性があります。そのため、AMDとNVIDIAの競争はチップレベルだけでなく、開発者エコシステム、推論フレームワーク、システム導入効率にも及んでいます。
AMD HeliosはNVIDIAとのシステムレベルの競争をどのように変えるのか?
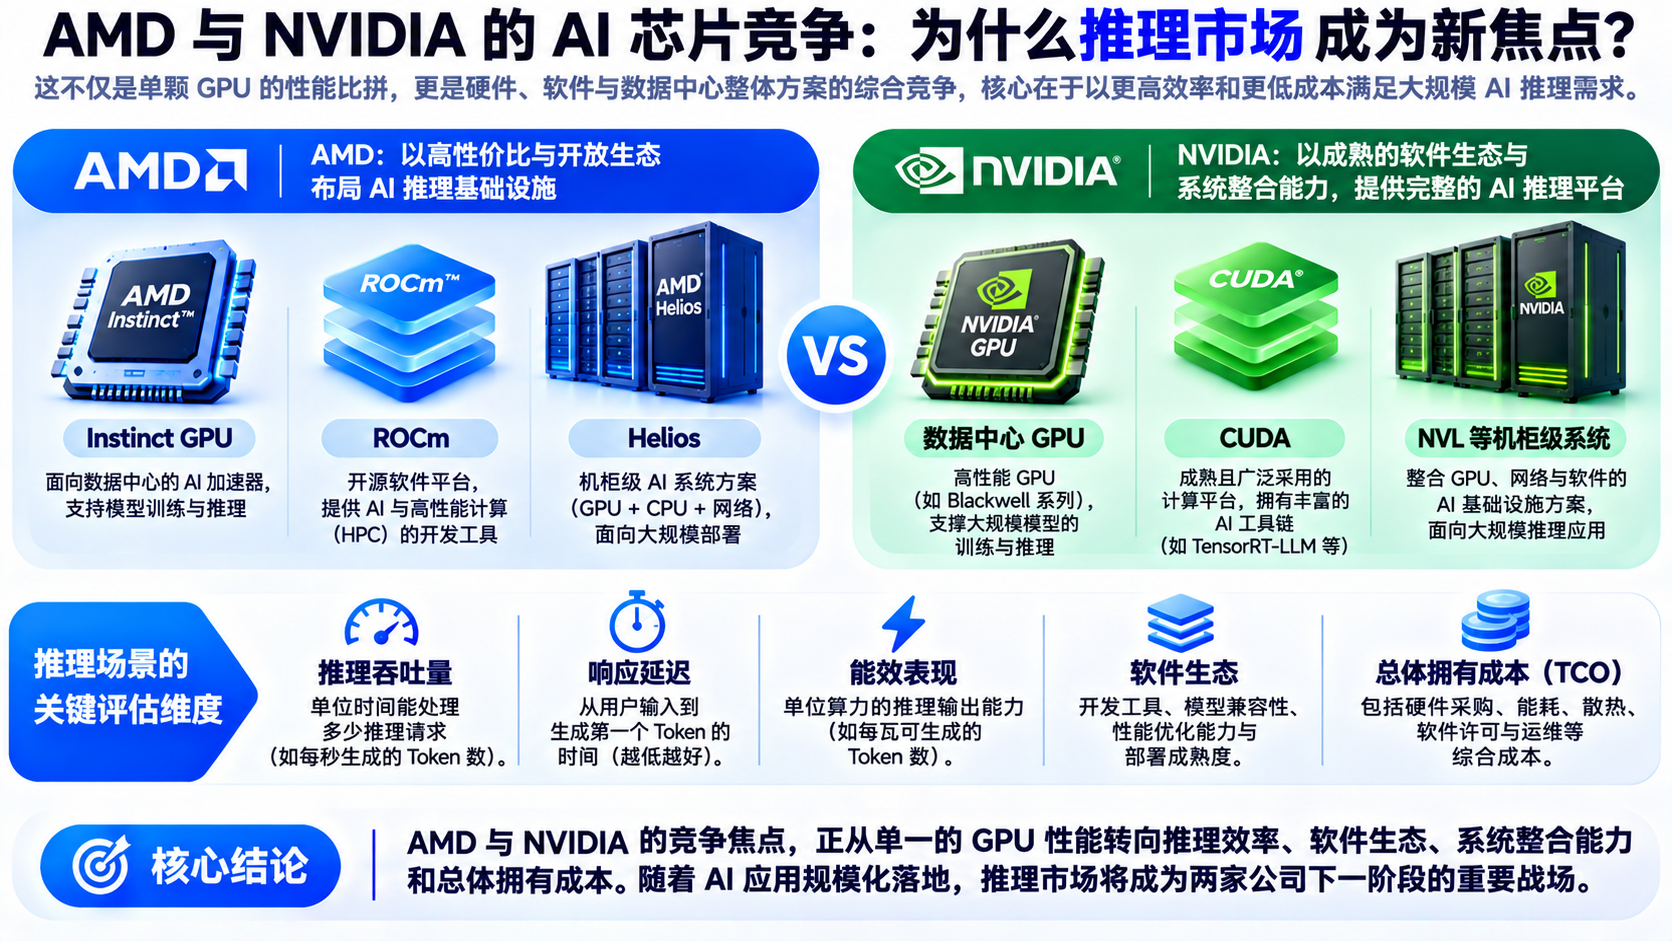
Heliosは、大規模AIデータセンター向けのAMDのラックスケールコンピューティングプラットフォームです。Instinct GPU、EPYC CPU、ネットワークインターコネクト、関連ソフトウェアコンポーネントを組み合わせ、より完全なAIコンピューティングシステムを顧客に提供します。GPUを個別に購入してからシステムを統合する場合と比べ、ラックスケールソリューションでは、統一されたアーキテクチャ内でコンピューティング、通信、導入設計を最適化できます。
この変化は、AIインフラの競争が個別チップから完全なコンピューティングシステムへと拡大していることを反映しています。大規模モデルのトレーニングと推論では通常、複数のGPUを連携させる必要があります。GPU間のデータ転送速度、サーバー内のインターコネクト、ネットワークトポロジー、冷却能力はいずれも全体の効率に影響を与える可能性があります。個別チップのコンピューティング性能が高くても、システム通信がボトルネックになれば、実際のクラスタスループットは制約を受ける可能性があります。
NVIDIAはすでにラックスケールAIシステムを通じて比較的包括的な製品ラインアップを確立している一方、AMDはHeliosを通じて別の選択肢を提供しようとしています。AMDは最新の決算発表で、Anthropic、Meta、Microsoft、OpenAI、Oracle Cloud Infrastructureを含む顧客が、初期のHeliosソリューションに基づくモデルまたはワークロードを実行していると述べました。これらの導入は、AMDがシステムレベル製品の展開を進めていることを示していますが、各顧客の導入規模、調達額、商用化の段階については、引き続き個別に評価する必要があります。
大手クラウドサービスプロバイダーにとって、競争力のあるAIシステムサプライヤーを複数確保することは、調達の柔軟性を高め、サプライチェーン集中リスクを低減する可能性があります。ただし、システムレベルの競争は、チップ供給、ネットワークインターコネクト、ソフトウェアの安定性、ラック導入、長期保守など、AMDに対してより高い要件も課します。
なぜAI推論コストは個別GPUの性能より重要なのか?
AI推論の商業的価値は、最終的に許容可能なコストでサービスを継続的に提供できるかどうかに左右されます。日々大量のリクエストを処理するAIプラットフォームでは、GPUの購入価格はコストの一部にすぎません。サーバーの利用率、消費電力、冷却、ネットワーク、保守、モデルの実行効率はいずれも総支出に影響を与える可能性があります。
たとえば、2つのGPUシステムの調達コストがそれぞれ100万ドルと120万ドルであるとします。後者が同一のサービス品質でより多くのリクエストを処理できる、または推論1回当たりのエネルギー消費を大幅に削減できる場合、より高価なシステムでも長期的な推論1回当たりのコストは低くなる可能性があります。逆に、システムが高い理論性能を持っていても、実際のアプリケーションでハードウェアリソースを十分に活用できなければ、その経済性は期待を下回る可能性があります。
したがって、AI推論チップを評価する際には、1秒当たりに生成されるトークン数、最初のトークンが出力されるまでの時間、同時リクエスト処理能力、100万トークン当たりの実際の処理コストといった指標を考慮することが重要です。モデルやワークロードによって、これらの指標の重要度は異なります。たとえば、リアルタイム音声対話ではレイテンシーが優先される一方、バッチでの文書分析ではスループットと単位コストがより重視される場合があります。
この変化は、AMDが市場機会を獲得するために、すべての性能指標でNVIDIAを上回る必要が必ずしもないことを意味します。特定のワークロードに対して競争力のあるコストと性能を提供し、安定性とソフトウェアサポートに関する顧客要件を満たすことができれば、実行可能な代替手段となる可能性があります。同様に、NVIDIAも、理論上より高いチップ性能だけに依存するのではなく、ソフトウェア最適化とシステム効率を通じて競争力を維持できます。
AI推論市場の競争はAMDとNVIDIAの株式バリュエーションにどのような影響を与えるのか?
AMDとNVIDIAはいずれも米国半導体業界における重要な上場企業ですが、投資家は両社に全く同じバリュエーションロジックを適用しているわけではありません。NVIDIAはすでに大規模なAIコンピューティング事業と比較的成熟したハードウェア・ソフトウェアエコシステムを構築しており、市場は一般に、同社が売上規模、利益率、技術的優位性を維持できるかに注目しています。一方、AMDにはAI市場シェアを拡大する機会があるため、投資家は新製品の導入、顧客注文、売上成長が持続的な収益性につながるかどうかをより重視しています。
AI推論市場の拡大は複数のチップサプライヤーに同時に恩恵をもたらす可能性がありますが、市場需要の増加がすべての企業の利益を比例して増加させることを意味するわけではありません。競争が激化するにつれ、製品価格、顧客の交渉力、研究開発投資はいずれも変化する可能性があります。企業が市場シェアを獲得するために価格を引き下げたり、顧客導入の支援により多くのリソースを投入したりする必要がある場合、売上成長が同水準の利益成長につながらない可能性があります。
また、株価は市場がすでにどの程度の成長期待を織り込んでいるかにも左右されます。企業が堅調な決算を発表しても、投資家がより高い水準を期待していた場合、株価は圧力を受ける可能性があります。逆に、実際の出荷、利益率、見通しが予想を上回れば、市場はそのバリュエーションを再評価する可能性があります。したがって、AMDとNVIDIAの投資価値を評価するには、どちらのGPUがより高い性能を持つかを比較するだけでは不十分です。売上構成、収益性、設備投資、競争環境、バリュエーション倍率も考慮する必要があります。
投資家はどのAI推論市場指標を注視すべきか?
AIチップ関連株の動向を把握したい投資家は、3つの観点から市場の変化を観察できます。1つ目は需要であり、大手クラウドサービスプロバイダーによるAI設備投資、推論サービスの利用状況、企業顧客による実際の導入などが含まれます。これらの指標はAIコンピューティング能力に対する需要が拡大し続けているかを判断するのに役立ちますが、設備投資計画はチップメーカーにとっての確定売上高と同義ではありません。
2つ目は供給であり、GPUの出荷量、高帯域幅メモリ(HBM)の供給、先端パッケージング能力、システム導入の進捗が含まれます。市場需要が強い場合でも、重要部品の供給が不足すれば、チップメーカーは予定通りに出荷を完了できない可能性があります。AMDとNVIDIAはいずれも複雑な半導体サプライチェーンに依存しているため、供給制約は両社の成長ペースに影響を及ぼす可能性があります。
最後は、収益性とバリュエーションの指標です。投資家はデータセンター売上高、売上総利益率、営業利益率、フリーキャッシュフロー、市場期待の変化を確認し、株価収益率や予想利益倍率を用いて株価水準が妥当かどうかを評価できます。すでに達成された財務実績と経営陣の将来見通しを区別し、未履行の注文や成長予測を確実な売上高として扱わないことが特に重要です。
まとめ
AIチップにおけるAMDとNVIDIAの競争は、純粋なコンピューティング性能の比較から、推論効率、ソフトウェアエコシステム、ラックスケールシステム、総保有コストへと拡大しています。AIアプリケーションが大規模導入の段階に入るにつれ、データセンターにはより強力なコンピューティング能力だけでなく、より合理的なコストで大量のユーザーリクエストを継続的に処理する能力も求められています。
2026年第3四半期におけるAMDのデータセンター事業の急成長と、Instinct、ROCm、Heliosの継続的な開発は、同社がAIインフラ事業を拡大していることを示しています。ただし、NVIDIAはCUDA、システム統合、開発者エコシステムにおいて重要な優位性を維持しています。将来の競争の結果は、単一世代のチップにおける1つの技術指標ではなく、製品出荷、実環境での性能、顧客採用、商業的収益性に左右されます。
株式投資家にとって、AI推論市場は半導体業界を観察する新たな視点を提供しますが、技術競争力と株式投資の収益は直接的に同一ではありません。業界需要、企業収益性、市場バリュエーションを総合的に分析することで、AMDとNVIDIAの競争環境をより包括的に理解できます。
FAQ
AI推論とは何か?
AI推論とは、トレーニング済みの人工知能モデルを使用して入力を処理し、AIチャット、画像生成、音声認識、インテリジェントアシスタントが実行するタスクなどの出力を生成するプロセスです。
AI推論市場がより重要になっているのはなぜか?
AIアプリケーションのユーザー数と利用頻度が増加するにつれ、企業は多額の推論コンピューティングコストを継続的に負担しなければなりません。その結果、推論速度、スループット、消費電力、単位コストの重要性が高まっています。
AMDのAI GPUはNVIDIAに代わることができるか?
対応する特定のモデルやアプリケーションシナリオでは、AMD GPUはNVIDIAの代替手段として利用できる場合があります。ただし、実際の実現可能性は、ソフトウェア互換性、性能、導入コスト、顧客要件に依存します。あらゆるシナリオで両者が完全に同等であると考えるべきではありません。
CUDAとROCmの違いは何か?
CUDAはNVIDIAのGPU並列コンピューティングプラットフォームであり、ROCmはAMDのGPUコンピューティングソフトウェアプラットフォームです。どちらもAIコンピューティングをサポートしていますが、開発ツール、エコシステムの成熟度、具体的な互換性に違いがあります。
AMD Heliosとは何か?
Heliosは、大規模データセンターにおけるAIトレーニングおよび推論ワークロード向けに、GPU、CPU、インターコネクト、ソフトウェアコンポーネントを統合したAMDのラックスケールAIコンピューティングプラットフォームです。
AI推論需要の拡大はAMD株の上昇を必ず意味するか?
必ずしもそうではありません。株価は事業成長だけでなく、収益性、競争環境、サプライチェーン、市場期待、株式バリュエーションの影響も受けます。
* 本情報はGateが提供または保証する金融アドバイス、その他のいかなる種類の推奨を意図したものではなく、構成するものではありません。
* 本記事はGateを参照することなく複製/送信/複写することを禁じます。違反した場合は著作権法の侵害となり法的措置の対象となります。
共有
内容


関連記事

Render、io.net、Akash:DePINハッシュレートネットワークの比較分析

AI分野におけるRenderの申請理由:分散型ハッシュレートが人工知能の発展を支える仕組み

USD.AI 収益源分析:AIインフラ借入資金による収益創出の仕組み

USD.AIトケノミクス:CHIPトークンの使用事例およびインセンティブメカニズムのデプス分析

PharosはRWAをどのようにオンチェーン化するのか、RealFiインフラのロジックを詳細にご紹介します
