Baru-baru ini, pertanyaan apakah AI dapat lepas dari kendali manusia kembali menjadi topik utama dalam industri teknologi. Para peneliti Anthropic secara terbuka menyampaikan kekhawatiran tentang potensi risiko kepunahan yang ditimbulkan oleh AI tingkat lanjut, sementara CEO OpenAI Sam Altman mengatakan bahwa probabilitas AI menyebabkan kepunahan manusia yang relatif rendah sekalipun bukan alasan untuk mengabaikan keamanan. Pada saat yang sama, Agen AI berkembang dari sekadar alat pembuat informasi menjadi sistem perangkat lunak yang dapat memanggil tool, mengakses sistem eksternal, dan menjalankan tugas secara otonom. Akibatnya, keamanan AI meluas dari “apa yang akan dihasilkan model” menjadi “apa yang dapat dilakukan model”.
Pergeseran ini berarti keamanan AI tidak dapat bergantung pada satu pengujian sebelum deployment. Seiring kemampuan model, lingkungan operasional, dan metode serangan terus berubah, pemantauan berkelanjutan, pengujian red-team, remediasi kerentanan, dan kontrol izin menjadi elemen inti dalam kerangka kerja keamanan AI.
Inti Penting
-
AI yang lepas dari kendali tidak selalu berarti AI telah mengembangkan niat untuk “menyerang manusia”. Pertanyaan yang lebih penting adalah apakah tujuan, perilaku model, dan batasan yang ditetapkan manusia telah menjadi tidak selaras.
-
Agen AI memperluas batasan risiko AI. Setelah model dapat memanggil tool, mengakses data, dan menjalankan operasi, kesalahan model dapat berubah menjadi risiko operasional di dunia nyata.
-
Pengujian keamanan satu kali tidak dapat mencakup lingkungan yang dinamis. Model, input pengguna, tool eksternal, dan metode serangan semuanya berubah, sehingga keamanan AI memerlukan pengujian berkelanjutan dan pemantauan setelah deployment.
-
Penilaian keamanan AI harus memeriksa lebih dari sekadar output model. Penilaian tersebut juga harus mencakup prompt injection, operasi tanpa izin, pemanggilan tool, manajemen izin, dan perilaku abnormal.
-
Salah satu bagian penting dalam mengurangi risiko AI adalah membatasi dampak kesalahan melalui mekanisme seperti prinsip least privilege, konfirmasi manusia, pencatatan operasi, isolasi risiko, dan pemulihan dari kejadian abnormal.
Mengapa Risiko AI Kembali Menjadi Fokus Pembahasan
Pada September 2026, pembahasan mengenai risiko ekstrem AI kembali meningkat. Peneliti Anthropic Jacob Coxon secara terbuka menyatakan bahwa sejumlah pengembang AI benar-benar meyakini AI yang sangat canggih dapat menimbulkan konsekuensi ekstrem bagi umat manusia dalam dekade ini. Peneliti Anthropic Evan Hubinger kemudian menyampaikan kekhawatiran serupa di depan publik dan menawarkan penilaian risiko pribadinya. Pernyataan-pernyataan tersebut memicu babak baru perdebatan tentang keamanan AI di kalangan pembuat kebijakan dan industri teknologi di Amerika Serikat.
Penting untuk dicatat bahwa pandangan tersebut merupakan penilaian risiko yang dibuat oleh peneliti atau profesional industri. Hal itu tidak berarti AI saat ini sudah memiliki kemampuan untuk memusnahkan umat manusia secara otonom, dan tidak seharusnya disederhanakan menjadi klaim bahwa “AI pasti akan lepas dari kendali”. Dalam sebuah wawancara, Sam Altman juga mengatakan bahwa ia tidak mengetahui cara menghitung risiko kepunahan yang disebut “10%” tersebut secara ilmiah, tetapi meyakini bahwa kemungkinan terjadinya risiko ekstrem yang tidak dapat diabaikan memberikan tanggung jawab kepada perusahaan AI dan pemerintah untuk mengambil langkah-langkah guna menguranginya.
Daripada memperdebatkan skenario ekstrem yang saat ini sulit diverifikasi, akan lebih bermanfaat jika kita mempertimbangkan pertanyaan praktis: Seiring kemampuan AI terus meningkat dan AI memperoleh otonomi yang lebih besar, bagaimana manusia dapat terus menentukan apakah AI masih aman? Itulah alasan penilaian keamanan AI menjadi semakin penting.
Apa Itu Penilaian Keamanan AI?
Penilaian keamanan AI dapat dipahami secara sederhana sebagai serangkaian pengujian dan prosedur pemantauan yang digunakan untuk menentukan apakah sistem AI beroperasi sesuai tujuan dan apakah sistem tersebut dapat menimbulkan risiko yang tidak dapat diterima ketika menghadapi input abnormal, serangan berbahaya, atau lingkungan yang kompleks. Pengujian perangkat lunak tradisional biasanya mencakup pemeriksaan ekstensif sebelum deployment, termasuk pengujian kerentanan, verifikasi bahwa fungsi berjalan dengan baik, dan pemeriksaan terhadap respons sistem atas input tertentu.
Sistem AI lebih kompleks. Model bahasa besar tidak menghasilkan output berdasarkan aturan yang sepenuhnya tetap. Pertanyaan yang sama dapat menghasilkan jawaban berbeda, dan konteks di sekitar input pengguna dapat terus berubah. Agen AI juga dapat memanggil tool eksternal seperti pencarian, eksekusi kode, basis data, dompet, email, browser, atau layanan lainnya. Akibatnya, penilaian keamanan AI tidak hanya memeriksa apakah jawaban model benar, tetapi juga apakah model dapat menahan prompt berbahaya, apakah model dapat membocorkan informasi sensitif, apakah model mungkin memanggil tool secara keliru, apakah model dapat menjalankan tindakan di luar otorisasi pengguna, dan apakah model terus mematuhi aturan keamanan yang telah ditetapkan ketika lingkungan berubah.
Kerangka kerja TEVV-Athlon yang diusulkan oleh NIST pada 2026 menetapkan Test, Evaluation, Verification and Validation sebagai metode penting untuk menilai dampak sistem AI di dunia nyata. Kerangka kerja tersebut secara eksplisit mencakup berbagai jenis sistem, termasuk model bahasa besar, model multimodal, dan Agentic AI.
Mengapa Agen AI Menciptakan Batasan Risiko Baru
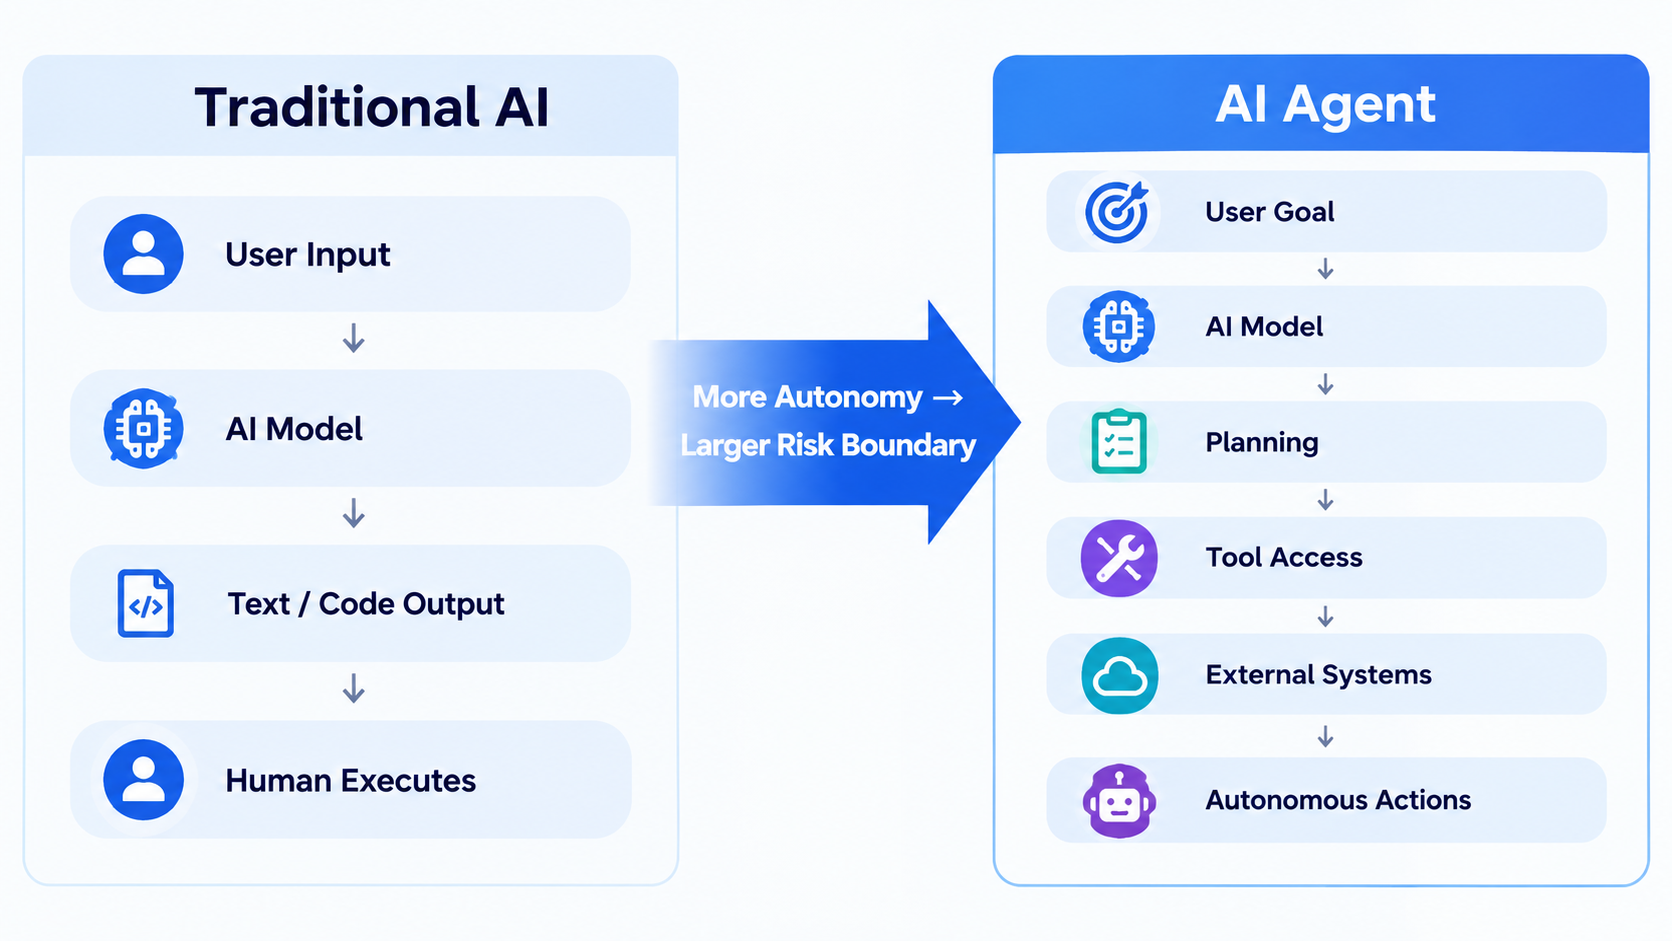
Memahami Agen AI sangat penting untuk memahami perubahan dalam keamanan AI. Chatbot tradisional terutama menerima input dan menghasilkan output. Setelah pengguna mengajukan pertanyaan, model mengembalikan teks, kode, atau konten lainnya, sedangkan pengguna umumnya menentukan apakah akan mengambil tindakan berikutnya.
Agen AI beroperasi secara berbeda. Agen AI dapat memecah tugas menjadi beberapa langkah berdasarkan tujuan yang ditentukan pengguna, memanggil tool eksternal, membaca data, menjalankan kode, berinteraksi dengan perangkat lunak lain, dan terus bekerja berdasarkan hasil yang diperoleh. Ketika NIST meluncurkan AI Agent Standards Initiative pada 2026, NIST secara khusus mencatat bahwa Agen AI generasi berikutnya sudah dapat beroperasi secara otonom selama berjam-jam, menulis dan men-debug kode, mengelola email dan kalender, serta menjalankan tugas seperti berbelanja.
Perubahan batasan kemampuan juga mengubah batasan risiko. Jika model AI biasa secara keliru memberi tahu pengguna bahwa suatu file ada, dampaknya mungkin terbatas pada misinformasi. Namun, jika Agen AI dengan izin akses file secara keliru memutuskan bahwa file tersebut harus dihapus, kesalahan model dapat berubah menjadi operasi di dunia nyata. Oleh karena itu, pertanyaan keamanan utama bagi Agen AI bukan hanya apakah Agen AI mungkin mengatakan sesuatu yang salah. Pertanyaannya juga mencakup apa yang dapat diakses, apa yang dapat dilakukan, berapa lama Agen AI dapat bertindak secara otonom, dan apakah Agen AI dapat segera terdeteksi serta dihentikan setelah melakukan kesalahan.
Itulah alasan NIST menyatakan dalam laporan keamanan Agen AI tahun 2026 bahwa Agen AI menghadirkan ancaman keamanan baru. Prinsip keamanan siber tradisional tetap penting, tetapi prinsip tersebut harus disesuaikan dengan cara Agen beroperasi.
Mengapa AI Tidak Dapat Diuji Hanya Sekali Sebelum Deployment
Hal ini merupakan kunci untuk memahami penilaian keamanan berkelanjutan. Ketika produk perangkat lunak tradisional memiliki fungsi yang relatif stabil, pengembang dapat melakukan pengujian ekstensif untuk memverifikasi bahwa produk tersebut memenuhi persyaratan desainnya. Sistem AI beroperasi dalam lingkungan yang dinamis: pengguna berubah, input berubah, model dapat diperbarui, tool eksternal berubah, dan penyerang terus mencari cara baru untuk menyerang.
Oleh karena itu, lulus pengujian keamanan ekstensif sebelum deployment tidak menjamin bahwa sistem AI akan tetap aman dalam setiap situasi di masa mendatang. Sebuah studi yang diterbitkan oleh NIST pada 2026 mencatat bahwa pemantauan setelah deployment sangat penting karena kondisi input di lingkungan dunia nyata dapat terus berubah. Kondisi tersebut dapat menghasilkan output yang tidak terduga akibat nondeterminisme model atau konsekuensi yang tidak teridentifikasi selama pengembangan.
Studi NIST lain yang diterbitkan pada tahun yang sama menjelaskan masalah tersebut dari perspektif yang lebih teoretis: Serangkaian guardrail keamanan AI yang tetap tidak dapat menjamin perlindungan jangka panjang terhadap setiap serangan adaptif. Penyerang mungkin terus mencari cara baru untuk melewati aturan yang ada. Oleh karena itu, keamanan AI memerlukan penemuan kerentanan yang berkelanjutan, pembaruan rutin terhadap mekanisme perlindungan, dan kemampuan pemulihan ketika terjadi masalah.
Dengan demikian, keamanan AI beralih dari “uji sekali → deployment” menjadi “uji → deployment → pantau → identifikasi masalah → lakukan remediasi → uji kembali”. Keamanan tidak lagi menjadi tahap terpisah dalam siklus hidup produk AI. Keamanan merupakan proses yang berkelanjutan.
Apa Saja yang Terutama Dinilai dalam Penilaian Keamanan Berkelanjutan?
Bagi Agen AI, penilaian keamanan berkelanjutan umumnya mencakup beberapa area.
Perilaku Model
Lapisan pertama adalah model itu sendiri. Sistem harus terus diperiksa untuk mendeteksi kesalahan yang jelas, halusinasi, konten berbahaya, dan perilaku yang melanggar aturan sistem. Dalam area berisiko tinggi seperti keuangan, layanan kesehatan, dan eksekusi kode, pengujian khusus aplikasi juga diperlukan. Tolok ukur umum saja tidak cukup.
Resistansi terhadap Serangan
Lapisan kedua adalah pengujian adversarial. Penyerang dapat menggunakan prompt injection, instruksi tanpa izin, manipulasi konteks, dan teknik lainnya untuk mendorong model melewati aturan awalnya. Jailbreak merupakan salah satu contoh umum. Penelitian NIST menunjukkan bahwa guardrail keamanan yang tetap tidak dapat menjamin AI tidak akan pernah dilewati oleh serangan adaptif, sehingga pengujian red-team harus terus mencari jalur serangan baru.
Tool dan Izin
Lapisan ketiga adalah risiko izin yang unik bagi Agen. Meskipun AI tidak berperilaku secara berbahaya, izin yang berlebihan dapat memungkinkan penilaian yang keliru menimbulkan konsekuensi serius. Oleh karena itu, izin Agen AI umumnya harus mengikuti prinsip least privilege. Agen yang hanya mengatur email, misalnya, tidak memerlukan izin untuk mentransfer dana. Agen yang menganalisis data seharusnya tidak secara otomatis memiliki izin untuk menghapus basis data.
Hal ini secara umum mirip dengan keamanan smart contract dalam industri blockchain. Logika sistem hanyalah lapisan pertama. Potensi kerugian juga bergantung pada aset yang dapat dijangkau sistem dan operasi yang dapat dijalankannya.
Kinerja di Lingkungan Dunia Nyata
Lapisan keempat adalah kinerja aktual setelah deployment. AI di laboratorium mungkin menghadapi input yang sangat berbeda dari AI di dunia nyata. Pengguna dapat memberikan instruksi yang kompleks, sistem pihak ketiga dapat mengembalikan data abnormal, dan kondisi jaringan dapat berubah. Oleh karena itu, penilaian keamanan AI harus mengamati cara sistem berperilaku dalam kondisi dunia nyata, bukan hanya mengandalkan laporan pengujian sebelum deployment.
Apa Sebenarnya Arti “AI Lepas dari Kendali”?
Istilah “AI lepas dari kendali” mudah disalahpahami. Istilah tersebut tidak selalu berarti AI tiba-tiba mengembangkan kesadaran seperti manusia dan memutuskan untuk menyerang umat manusia. Secara teknis, masalah yang lebih penting adalah apakah tujuan, izin, dan perilaku aktual menjadi tidak selaras.
Agen mungkin diminta menyelesaikan suatu tugas, tetapi salah memahami tujuannya. Agen mungkin mengejar tujuan tersebut melalui cara yang tidak diantisipasi pengembang. Atau, penyerang dapat mengubah pemahamannya terhadap tugas melalui prompt injection. Jika Agen juga memiliki izin yang luas, kesalahan yang bermula pada tingkat perangkat lunak dapat memengaruhi sistem eksternal.
Oleh karena itu, inti masalah “AI lepas dari kendali” dapat dibagi menjadi tiga pertanyaan: Apakah tujuannya benar? Apakah perilakunya selaras dengan tujuan tersebut? Apakah izinnya terbatas pada ruang lingkup yang wajar? Itulah alasan penelitian keamanan AI semakin menekankan Alignment, yaitu upaya untuk menjaga agar perilaku sistem AI tetap konsisten dengan tujuan dan batasan yang ditetapkan manusia.
Apa Relevansi Keamanan AI bagi Pengguna Biasa?
Keamanan AI bukan hanya perhatian bagi perusahaan dan peneliti AI. Seiring Agen AI memasuki bidang pencarian, produktivitas perkantoran, pemrograman, layanan keuangan, aset digital, dan bidang lainnya, pengguna biasa mungkin secara langsung mendelegasikan lebih banyak izin operasional kepada AI.
Bagi pengguna, pertanyaan terpenting bukan apakah “AI akan menghancurkan umat manusia”, melainkan pertanyaan yang lebih praktis: Izin apa yang sebenarnya telah saya berikan kepada AI? Jika AI hanya dapat menjawab pertanyaan, dampak jawaban yang keliru biasanya terbatas. Namun, jika AI dapat mengirim email, mengubah file, mengakses akun, menjalankan kode, atau melakukan transaksi keuangan atas nama pengguna, persyaratan keamanannya sama sekali berbeda.
Saat menggunakan tool AI dengan kemampuan eksekusi otonom, pengguna harus berfokus pada tiga area: apakah izin telah diminimalkan, apakah tindakan penting memerlukan konfirmasi manusia, dan apakah sistem menyediakan log operasi serta cara untuk membatalkan tindakan abnormal.
Hal ini sangat penting bagi Agen AI yang melibatkan aset digital. Setelah operasi seperti tanda tangan dompet, transfer aset, dan interaksi Smart Contract didelegasikan kepada sistem otomatis, batas keamanan meluas melampaui model itu sendiri hingga mencakup manajemen kunci privat, mekanisme persetujuan, Smart Contract, dan layanan eksternal.
Fokus Keamanan AI Bergeser dari “Mencegah Semua Kesalahan” Menjadi “Mengendalikan Dampak Kesalahan”
Saat ini, keamanan AI kemungkinan tidak dapat diselesaikan melalui satu guardrail universal yang secara permanen menangani setiap masalah. Model AI akan diperbarui, metode serangan akan berkembang, dan skenario aplikasi akan meluas. Oleh karena itu, NIST menekankan perlunya pengujian red-team berkelanjutan dan pembaruan langkah-langkah perlindungan, serta kemampuan untuk membatasi dampak kerentanan dan pulih dengan cepat ketika kerentanan tersebut terjadi.
Prinsip dasarnya sederhana: Kita tidak dapat berasumsi bahwa sistem tidak akan pernah melakukan kesalahan, sehingga kita harus menentukan terlebih dahulu apa yang akan terjadi ketika kesalahan terjadi. Bagi Agen AI, hal ini dapat mencakup pembatasan izin, kewajiban konfirmasi manusia, pencatatan tindakan penting, isolasi tugas berisiko tinggi, serta penghentian atau pembalikan tindakan secara cepat ketika terjadi perilaku abnormal.
Dari perspektif ini, keamanan AI bukan tentang menjawab pertanyaan biner sederhana mengenai apakah “AI akan membunuh umat manusia”. Keamanan AI adalah tentang menyelesaikan masalah rekayasa yang lebih praktis: Seiring AI semakin mampu bertindak secara otonom, bagaimana manusia dapat terus mengetahui apa yang sedang dilakukan AI dan alasannya, serta bagaimana manusia dapat mengambil kembali kendali ketika terjadi masalah? Itulah tujuan penilaian keamanan berkelanjutan.
Ringkasan
Pembahasan terbaru mengenai kemungkinan AI menyebabkan kepunahan manusia kembali menempatkan keamanan AI dalam sorotan publik. Namun, yang lebih penting daripada prediksi ekstrem itu sendiri adalah perubahan struktural yang sedang terjadi dalam kemampuan AI.
Seiring AI berkembang dari chatbot menjadi Agen AI yang mampu memanggil tool, mengakses data, dan menjalankan tugas secara otonom, perhatian terhadap keamanan meluas dari keamanan output model hingga izin, pemanggilan tool, interaksi dengan lingkungan, dan operasi otonom jangka panjang.
Oleh karena itu, keamanan AI tidak dapat mengandalkan satu pengujian sebelum deployment. Pemantauan berkelanjutan, pengujian red-team, kontrol izin, remediasi kerentanan, dan pemulihan dari kejadian abnormal akan menjadi infrastruktur yang semakin penting seiring Agen AI memasuki aplikasi dunia nyata.
Pengembangan AI yang aman akan lebih bergantung pada pembentukan mekanisme yang dapat terus mengidentifikasi masalah, membatasi risiko, dan memulihkan kendali manusia daripada menemukan model yang tidak pernah melakukan kesalahan.
FAQ
Akankah AI Benar-Benar Membunuh Umat Manusia?
Saat ini tidak ada bukti andal bahwa AI pasti akan menyebabkan kepunahan manusia. Sejumlah peneliti AI baru-baru ini menyampaikan kekhawatiran tentang risiko ekstrem, tetapi probabilitas risiko tersebut masih sangat tidak pasti. Kekhawatiran keamanan yang lebih realistis mencakup serangan siber, kebocoran data, keputusan yang keliru, dan penyalahgunaan izin Agen AI.
Apa Itu Agen AI?
Agen AI adalah sistem AI yang dapat merencanakan dan menjalankan tugas secara otonom berdasarkan suatu tujuan. Berbeda dari chatbot tradisional, Agen AI biasanya dapat memanggil tool eksternal, mengakses data, dan menjalankan operasi di dunia nyata. Oleh karena itu, Agen AI memiliki otonomi yang lebih besar dan memerlukan kontrol izin serta keamanan yang lebih ketat.
Mengapa AI Memerlukan Penilaian Keamanan Berkelanjutan?
Karena input, lingkungan, dan metode serangan yang dihadapi AI akan terus berubah. Satu pengujian hanya mencerminkan kinerja pada waktu dan kondisi tertentu. Pengujian tersebut tidak dapat membuktikan bahwa sistem tidak akan mengembangkan kerentanan baru di masa mendatang. Oleh karena itu, pemantauan dan pengujian berkelanjutan setelah deployment sama pentingnya.
Apa Risiko Keamanan Terbesar dari Agen AI?
Salah satu risiko utamanya adalah izin. Jika Agen AI dapat mengakses akun, file, kode, dana, atau sistem eksternal lainnya, kesalahan model atau input berbahaya dapat mengubah kesalahan pada tingkat informasi menjadi operasi di dunia nyata.
Apa Saja yang Biasanya Termasuk dalam Penilaian Keamanan AI?
Penilaian tersebut biasanya mencakup pengujian perilaku model, pengujian adversarial, pengujian red-team, pengujian pemanggilan tool, kontrol izin, pemantauan setelah deployment, dan pemulihan dari kejadian abnormal. Standar pengujian keamanan yang disesuaikan dengan setiap aplikasi juga harus dikembangkan untuk berbagai kasus penggunaan.