Bagi pemula yang memetakan batas kemampuan AI, model dunia menjawab apakah suatu sistem dapat mengantisipasi konsekuensi tindakan, bukan apakah sistem tersebut dapat menulis jawaban dengan lancar. Bagian di bawah ini membahas definisi, loop prediksi, tiga pendekatan teknis, pemilihan tugas Model Dunia vs LLM, perbedaan dari pembuatan video, kasus penggunaan, dan batas evaluasi; konsep terkait dijelaskan dalam artikel Gate Learn tentang Kecerdasan Super (ASI) dan AI Privat.
Poin-Poin Utama
- Kemampuan inti adalah prediksi yang dikondisikan oleh tindakan: berdasarkan suatu keadaan dan tindakan, menghasilkan keadaan berikutnya (atau representasi berikutnya) untuk perencanaan dan pengendalian.
- Tiga pendekatan umum: RL berbasis model (MBRL) / pelatihan imajinasi, simulasi interaktif generatif, dan representasi prediktif bergaya JEPA.
- Model bahasa besar unggul dalam prediksi token berikutnya, sedangkan generator video unggul dalam kesinambungan tampilan; keduanya tidak otomatis merupakan model dunia yang dapat direncanakan.
- Evaluasi perlu memperhatikan fisika palsu, penyimpangan jangka panjang, kegagalan di luar distribusi, metrik yang ketat, dan batas dengan simulator yang ditulis secara manual.
Apa Itu Model Dunia, dan Masalah Apa yang Diselesaikannya?
Model dunia menjawab pertanyaan praktis: sebelum agen bertindak, dapatkah agen tersebut memperkirakan secara andal apa yang akan terjadi selanjutnya? Tanpa kemampuan ini, pembelajaran bergantung pada coba-coba di dunia nyata—yang sering kali mahal, lambat, atau tidak aman—dan perencanaan offline menjadi sulit.
Dalam robotika, kendaraan otonom, agen gim, dan pelatihan simulasi—terutama untuk agen berwujud di lingkungan virtual atau fisik—umpan balik bersifat mahal atau berisiko; misalnya, kebijakan mengemudi yang buruk dapat menyebabkan kecelakaan nyata sebelum sistem belajar. Model dunia memindahkan “percobaan tindakan” ke dinamika yang dipelajari: menjalankan simulasi ke depan dalam ruang laten atau ruang observasi, lalu menerapkan kebijakan yang lebih kuat kembali ke dunia nyata. Tujuan ini berbeda dari sistem percakapan yang terutama menyampaikan kembali pengetahuan; model dunia lebih dekat pada kemampuan memprediksi sebab-akibat dalam lingkungan interaktif.
Entri Glosarium NVIDIA tentang model dunia menggambarkannya sebagai representasi internal yang membantu AI memahami dan memprediksi bagaimana dunia fisik berkembang; A Path Towards Autonomous Machine Intelligence karya Yann LeCun menempatkan model dunia prediktif pada jalur menuju kecerdasan yang lebih otonom; dan karya David Ha pada 2018, “World Models”, membantu mendefinisikan pendekatan modern berbasis pembelajaran. Agen biasanya hanya melihat observasi parsial, sehingga keadaan lengkap tidak tersedia secara langsung. Dalam berbagai perspektif ini, prediksi bertujuan mendukung pengambilan keputusan.
Bagaimana Cara Kerja Model Dunia? Keadaan, Tindakan, dan Loop Prediksi
Uji paling andal untuk sistem yang berorientasi pada model dunia adalah prediksi yang dikondisikan oleh tindakan: apakah masukan secara eksplisit menyertakan tindakan agen (atau sinyal kontrol), dan apakah keluarannya adalah keadaan berikutnya atau representasi berikutnya yang dikondisikan oleh tindakan tersebut.
Loop ini biasanya diringkas menjadi tiga langkah: mengodekan observasi menjadi suatu keadaan; mengondisikan pada tindakan kandidat; memprediksi keadaan berikutnya, dengan lingkungan berubah setelah tindakan tersebut dan mengembalikan observasi baru, yang secara opsional dapat menjalankan prediksi tersebut ke depan sebagai titik awal baru. Kebijakan atau perencana membandingkan lintasan yang dibayangkan berdasarkan imbalan, risiko, atau batasan, lalu mengeksekusinya; observasi baru memulai kembali proses pengodean.
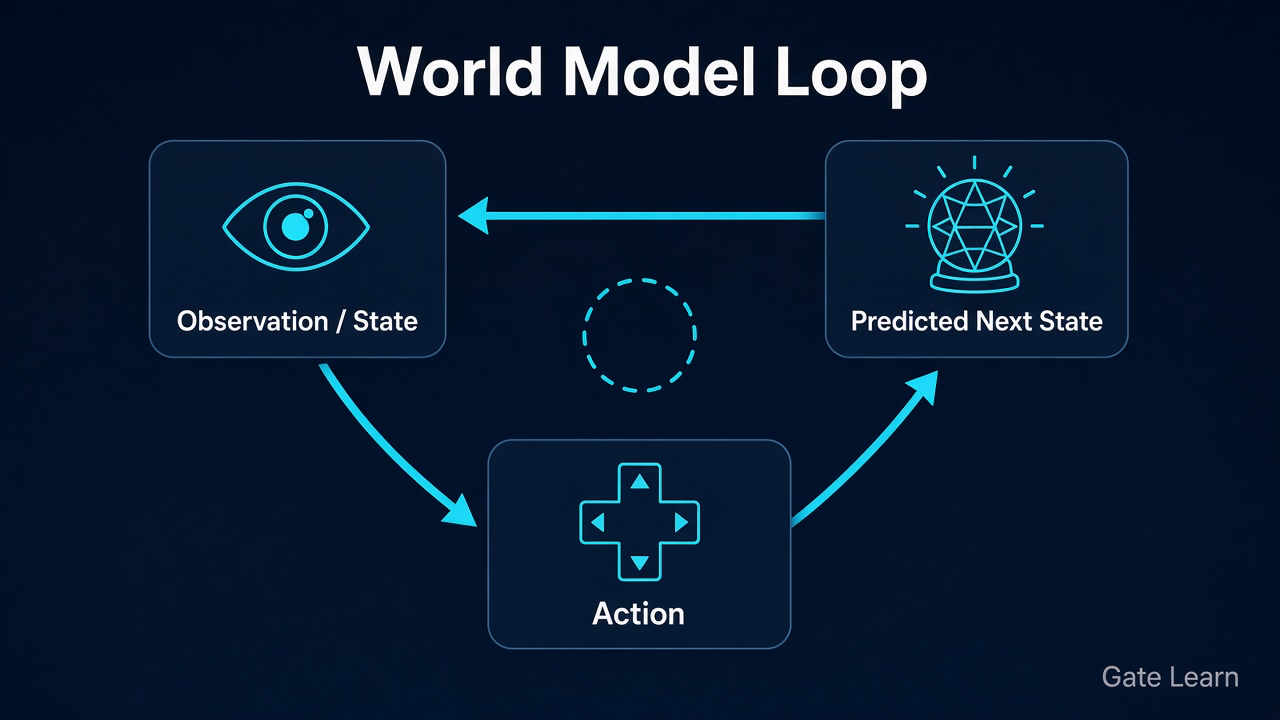
Gambar 1. Loop model dunia: observasi/keadaan ditambah tindakan menghasilkan keadaan berikutnya yang diprediksi untuk memasuki siklus berikutnya.
Banyak sistem praktis menghindari prediksi jangka panjang dalam piksel mentah dan sebagai gantinya mempelajari dinamika laten: data visual berdimensi tinggi dikompresi menjadi keadaan ringkas, lalu disimulasikan ke depan dalam ruang tersebut. Simulasi laten mengurangi derau visual dan membuat pelatihan imajinasi lebih murah; apakah keadaan laten tetap setia pada fisika nyata masih perlu diuji melalui tugas lanjutan dan pemeriksaan di luar distribusi, terutama karena lingkungan fisik hanya diamati secara parsial dan harus disimpulkan melalui umpan balik.
Apa Saja Pendekatan Teknis Utama untuk Model Dunia?
“Model dunia” adalah label luas untuk beberapa keluarga teknis, bukan nama satu algoritme. Pemilihan dimulai dari tugasnya: kebijakan yang dapat dikendalikan, simulasi piksel interaktif, atau representasi abstrak yang dapat ditransfer.
| Pendekatan |
Gagasan inti |
Paling sesuai untuk |
Biaya utama |
| MBRL / pelatihan imajinasi |
Mempelajari dinamika, lalu melatih kebijakan pada simulasi model (Dreamer) |
Pengendalian, gim, RL yang hemat sampel |
Kesalahan model merusak kebijakan; penyimpangan |
| Simulasi interaktif generatif |
Mempelajari lingkungan interaktif yang menghasilkan bingkai/observasi berikutnya |
Augmentasi data, dunia video interaktif |
Tampilan ≠ fisika; evaluasi mahal |
| Representasi prediktif JEPA |
Memprediksi embedding masa depan/yang dimask dalam ruang representasi (I-JEPA) |
Pembelajaran representasi, prediksi abstrak untuk perencanaan |
Tidak menghasilkan piksel; memerlukan tumpukan kontrol |
Satu pendekatan dapat berpusat pada model video yang memprediksi bingkai masa depan, sedangkan pendekatan lain menargetkan dinamika laten yang siap untuk perencanaan alih-alih rekonstruksi visual penuh.
Ketiga pendekatan tersebut dapat berdampingan: metode bergaya Dreamer menekankan pelatihan kebijakan dalam imajinasi; model dunia video generatif menekankan simulasi tampilan interaktif; I-JEPA dari Meta AI menunjukkan prediksi dalam ruang embedding gabungan alih-alih merekonstruksi setiap piksel. Berbagai sistem juga memilih metode pelatihan yang berbeda, bergantung pada apakah sistem belajar dari pasangan masukan-keluaran, simulasi kontrol, atau embedding prediktif. Selaraskan tugas terlebih dahulu, lalu bahas penamaannya.
Apa Perbedaan Model Dunia dengan LLM dan Pembuatan Video?
Ketiganya sama-sama “memprediksi”, tetapi dalam AI generatif mereka memprediksi objek yang berbeda dan berbeda dalam pengondisian tindakan: LLM memprediksi token berikutnya, generator video memprediksi tampilan bingkai berikutnya, dan sistem berorientasi model dunia memprediksi bagaimana keadaan berkembang setelah suatu tindakan.
| Dimensi |
Model dunia |
Model bahasa besar (LLM) |
Pembuatan video |
| Target prediksi inti |
Keadaan berikutnya / dinamika laten (sering dikondisikan oleh tindakan) |
Token berikutnya / struktur teks |
Tampilan bingkai atau klip berikutnya |
| Keterkaitan dengan tindakan |
Prediksi yang dikondisikan oleh tindakan adalah dasar pengambilan keputusan |
Biasanya tidak memiliki loop kontrol fisik |
Dapat dikondisikan oleh teks/bingkai pertama, tetapi tidak dapat dieksekusi |
| Penggunaan umum |
Perencanaan, pengendalian, AI berwujud |
Bahasa, penulisan, orkestrasi alat |
Pembuatan konten, pratinjau, simulasi interaktif |
| Kekeliruan umum |
Kemampuan percakapan = model dunia |
Menulis tentang fisika = kemampuan fisika |
Bingkai fotorealistis = dinamika yang benar |
Jadi, generator video mirip Sora dapat menampilkan bingkai yang koheren dengan fidelitas visual tinggi, bahkan konsistensi spasial yang tampak nyata—dan dapat disebut sebagai “model dunia video”—tetapi karakteristik tersebut saja tidak membuktikan pemahaman fisik. Tanpa antarmuka tindakan yang stabil, transisi keadaan yang dapat diverifikasi, dan loop perencanaan, kategorinya tetap lebih tepat sebagai video generatif. Sistem yang lebih kuat juga dapat mengevaluasi rangkaian tindakan untuk mendukung perencanaan dan pengambilan keputusan, bukan hanya merender tampilan yang mungkin secara pasif. LLM dapat menjelaskan “bagaimana jika Anda mendorong cangkir tersebut”, tetapi hal itu tidak menciptakan dinamika lingkungan yang dapat disimulasikan dan dievaluasi.
Di Mana Model Dunia Umumnya Digunakan?
AI berwujud merupakan konteks yang sering digunakan: lengan robot dan robot bergerak memerlukan kecerdasan spasial—penalaran tentang tata letak, pergerakan, dan perubahan di dunia fisik—serta prediksi kontak dan perpindahan sebelum menyentuh objek, karena banyak interaksi sulit dibatalkan setelah gerakan dimulai. Prediksi yang dikondisikan oleh tindakan memungkinkan sistem membuang lintasan yang gagal dalam simulasi atau ruang laten sebelum menanggung biaya tabrakan nyata; demonstrasi dapat menginisialisasi perilaku, tetapi tidak menggantikan pembelajaran berbasis interaksi.
Gim dan reinforcement learning berbasis model adalah bidang inti lainnya. Metode bergaya Dreamer meningkatkan kebijakan pada lintasan yang dibayangkan agar kontrol yang dapat digunakan dapat muncul dengan lebih sedikit interaksi nyata. Gagasan serupa dapat diterapkan pada log kontrol industri ketika simulator yang ditulis secara manual tidak lengkap, tetapi riwayat observasi melimpah, karena model berupaya menangkap dinamika sistem dari riwayat tersebut.
Kendaraan otonom, penjadwalan gudang, dan simulasi multiagen juga menyertakan komponen model dunia—bukan sebagai pengganti penuh untuk tumpukan perencanaan, melainkan sebagai lapisan konsekuensi jangka pendek. Pengujian virtual dan data video yang dikurasi sering digunakan untuk melatih dan mengevaluasi komponen tersebut dalam berbagai skenario sebelum penerapan nyata. Setiap sistem kontrol yang harus “berpikir sebelum bertindak” dapat memiliki modul model dunia.
Keunggulan, Risiko, dan Batasan Apa yang Penting saat Mengevaluasi Model Dunia?
Keunggulannya adalah efisiensi sampel dan coba-coba yang lebih aman: membayangkan dalam suatu model dapat mengurangi eksplorasi berbahaya, dan prediksi yang dikondisikan oleh tindakan dapat mendasarkan perencanaan pada dinamika yang dapat diperiksa. Batasan dan risiko sering muncul ketika model terlihat benar tetapi tidak dapat dipercaya, karena representasi internal yang tampak baik tidak sama dengan perilaku yang tetap andal saat diterapkan.
| Mekanisme |
Yang terlihat |
Mengapa tersembunyi |
Pertanyaan pemeriksaan |
| Fisika palsu |
Lintasan mulus yang melanggar konservasi/kontak |
Visi cenderung mempercayai kelancaran |
Apakah besaran utama kekal? Apakah objek dapat menembus satu sama lain? |
| Penyimpangan jangka panjang |
Simulasi singkat baik; simulasi panjang runtuh |
Demonstrasi lebih banyak menampilkan klip pendek |
Bagaimana kesalahan bertambah seiring langkah? Apakah ada perencanaan ulang? |
| Kegagalan di luar distribusi |
Gagal pada objek, pencahayaan, atau rentang tindakan baru |
Skor dalam distribusi terlihat kuat |
Protokol OOD? Mode kegagalan dipublikasikan? |
| Evaluasi yang ketat |
Tidak ada skor bersama untuk “pemahaman dunia” |
Keberhasilan tugas menyerap metrik |
Selain skor tugas, apakah kesalahan prediksi dilaporkan? |
| Batas dengan simulator yang ditulis manual |
Model yang dipelajari diperlakukan sebagai mesin terverifikasi |
Pemasaran mencampurkan simulator / model dunia |
Batasan mana yang dikodekan secara keras? Mana yang hanya hasil pencocokan? |
Transfer ke dunia nyata sulit karena kesenjangan simulasi-ke-nyata. Pengujian yang baik harus menanyakan apakah model memprediksi hasil yang dapat dikendalikan berdasarkan tindakan, bukan sekadar visual yang masuk akal.
Gunakan tabel tersebut sebagai daftar periksa klaim: konfirmasikan antarmuka yang dikondisikan oleh tindakan, lalu minta bukti jangka panjang dan OOD, dan terakhir pisahkan antara “terlihat baik” dengan “dinamika dapat direncanakan”. Tanpa bukti tersebut, istilah yang lebih aman adalah “mencakup komponen model dunia atau tujuan riset”, bukan “memiliki model dunia yang lengkap”. Karena agen memiliki kapasitas terbatas, evaluasi harus berfokus pada keadaan yang relevan dengan tujuan, bukan reproduksi seluruh adegan.
Ringkasan
Model dunia mendorong AI dari “dapat berbicara / dapat menggambar” menuju “dapat mengantisipasi konsekuensi tindakan”, seperti memprediksi bahwa robot akan menjatuhkan cangkir jika mengambil jalur yang salah. Inti kerjanya adalah loop tertutup antara keadaan, tindakan, dan prediksi, dengan prediksi yang dikondisikan oleh tindakan sebagai dasar pengambilan keputusan yang paling jelas.
Tiga pendekatan—MBRL/pelatihan imajinasi, simulasi interaktif generatif, dan representasi prediktif JEPA—melayani tujuan yang berbeda dan tidak dapat saling dipertukarkan. Dibandingkan dengan LLM dan generator video, bandingkan target prediksi dan antarmuka tindakannya; saat mengevaluasi, prioritaskan fisika palsu, penyimpangan, kegagalan OOD, metrik yang ketat, dan batas simulator.
FAQ
Apa Itu Model Dunia?
Model dunia adalah model dinamika internal yang dipelajari dan merepresentasikan bagaimana lingkungan dapat berubah berdasarkan keadaan saat ini (atau observasi) dan suatu tindakan. Dunia pada setiap saat lebih kaya daripada apa yang dapat diamati langsung oleh agen, sehingga model ini merangkum variabel yang penting untuk perencanaan—misalnya, posisi akhir robot setelah berbelok ke kiri. Tujuannya adalah mendukung perencanaan dan coba-coba dalam imajinasi, bukan hanya menghasilkan teks atau tampilan video.
Apa Perbedaan Model Dunia dengan Model Bahasa Besar?
Model bahasa besar terutama memprediksi token berikutnya dan unggul dalam bahasa serta orkestrasi pengetahuan; model dunia terutama memprediksi bagaimana keadaan berkembang setelah tindakan untuk pengendalian dan perencanaan. LLM dapat membahas fisika tanpa menyediakan dinamika lingkungan yang dapat disimulasikan dan dievaluasi.
Bagaimana Cara Kerja Model Dunia?
Loop umum mengodekan observasi menjadi keadaan, mengondisikan pada tindakan kandidat, memprediksi keadaan berikutnya setelah tindakan tersebut, dan dapat melanjutkan simulasi ke depan dalam ruang laten. Perencana membandingkan simulasi yang dibayangkan, mengeksekusi tindakan, lalu memperbarui keadaan berdasarkan observasi baru.
Apakah Sora atau Pembuatan Video Termasuk Model Dunia?
Tidak secara otomatis. Jika suatu sistem terutama menghasilkan video yang koheren secara tampilan tanpa antarmuka stabil yang dikondisikan oleh tindakan, transisi keadaan yang dapat diverifikasi, dan penggunaan untuk perencanaan, sistem tersebut lebih tepat digambarkan sebagai generator video. Sistem tersebut baru lebih mendekati model dunia ketika prediksi yang dikondisikan oleh tindakan dan loop yang dapat direncanakan telah didemonstrasikan.
Apa Perbedaan Model Dunia dengan Simulator Tradisional?
Simulator tradisional biasanya mengodekan aturan dan batasan fisika yang ditulis secara manual, sedangkan model dunia berbasis data sering dipelajari menggunakan jaringan saraf. Model yang dipelajari dapat lebih fleksibel dan lebih dekat dengan derau sensor, tetapi juga lebih rentan terhadap fisika palsu dan penyimpangan jangka panjang serta tidak boleh dianggap setara dengan mesin fisika yang terverifikasi.