Seiring AI generatif berkembang dari pelatihan model menuju aplikasi komersial berskala besar, fokus persaingan di pasar komputasi AI juga berubah. Perusahaan tidak hanya perlu melatih model yang lebih kuat, tetapi juga memproses permintaan pengguna secara berkelanjutan dengan biaya terkendali, menjalankan AI Agent, menghasilkan suara, dan menyediakan layanan interaktif real-time. Dalam konteks ini, arsitektur akselerasi inferensi khusus yang diwakili oleh Groq semakin mendapat perhatian. Artikel ini membahas posisi perusahaan Groq, teknologi LPU, model bisnis GroqCloud, dan persaingan industri untuk menganalisis perannya dalam infrastruktur inferensi AI, serta tantangan teknis dan komersial yang dihadapi pendekatan chip khusus.
Poin Utama
- Groq adalah perusahaan teknologi yang berfokus pada inferensi AI. Teknologi intinya mencakup chip LPU, compiler, dan infrastruktur inferensi pendukung.
- Pelatihan dan inferensi AI memiliki kebutuhan komputasi yang berbeda. Inferensi real-time secara khusus mengutamakan waktu hingga token pertama, kecepatan generasi, dan stabilitas layanan.
- LPU Groq mengoptimalkan beban kerja inferensi AI tertentu melalui SRAM on-chip, eksekusi deterministik, dan desain terpadu perangkat keras-perangkat lunak.
- GroqCloud mengemas kemampuan komputasi yang mendasarinya menjadi API cloud, sehingga developer dapat memanggil model AI yang didukung.
- LPU dan GPU berbeda dalam arsitektur serta skenario penggunaannya. Performa keseluruhan tidak dapat dievaluasi hanya berdasarkan kecepatan generasi satu token.
- Daya saing komersial Groq dalam jangka panjang bergantung pada skalabilitas chip, ekosistem perangkat lunak, biaya inferensi, permintaan pelanggan, dan imbal hasil investasi infrastruktur.
Apa Itu Groq? Peran Apa yang Dimainkannya dalam Rantai Nilai Komputasi AI?
Groq adalah perusahaan teknologi yang berfokus pada komputasi inferensi AI. Perusahaan ini didirikan pada 2016 oleh Jonathan Ross, yang sebelumnya berpartisipasi dalam proyek Google TPU. Perusahaan ini terutama mengembangkan chip akselerasi AI khusus, compiler, dan sistem komputasi inferensi, serta menyediakan kemampuan inferensi model kepada developer dan perusahaan melalui layanan seperti GroqCloud.
Penting untuk dicatat bahwa Groq dan Grok bukanlah produk yang sama. Groq adalah nama teknologi yang berkaitan dengan infrastruktur komputasi AI, sedangkan Grok adalah model kecerdasan buatan dan produk asisten yang dikembangkan oleh xAI. Meskipun namanya serupa, keduanya berasal dari perusahaan yang berbeda serta memiliki posisi teknologi dan model bisnis yang berbeda.
Dalam rantai nilai AI, Groq terutama berada pada lapisan infrastruktur komputasi. Aplikasi AI generatif yang lengkap biasanya mencakup pengembangan model, komputasi pelatihan, penerapan inferensi, antarmuka aplikasi, dan layanan pengguna akhir. Bisnis utama Groq bukanlah mengembangkan model chat serbaguna untuk konsumen. Sebaliknya, Groq bertujuan menyediakan lingkungan inferensi berperforma tinggi untuk berbagai model.
Sebagai contoh, saat membangun asisten AI real-time, developer dapat memilih model yang telah dilatih dan menggunakan layanan inferensi untuk memproses masukan pengguna. Model memahami pertanyaan dan menghasilkan konten, sedangkan platform komputasi yang mendasarinya menentukan seberapa cepat model dapat berjalan dan seberapa banyak sumber daya komputasi yang dikonsumsi setiap permintaan.
Mengoptimalkan proses komputasi ini merupakan inti dari proposisi nilai Groq. Melalui prosesor dan sistem perangkat lunak yang dirancang khusus, Groq mengurangi overhead eksekusi untuk tugas inferensi tertentu, sehingga model dapat menghasilkan respons dengan lebih cepat.
Posisi ini berarti peluang pasar Groq tidak hanya bergantung pada apakah model AI tertentu menjadi populer, tetapi juga pada permintaan inferensi di seluruh industri AI generatif, arsitektur model, dan perubahan biaya komputasi.
Mengapa Industri AI Semakin Memperhatikan Komputasi Inferensi?
Komputasi AI secara umum dapat dibagi menjadi dua tahap: pelatihan dan inferensi. Pelatihan melibatkan penggunaan data dalam jumlah besar untuk menyesuaikan parameter model agar model dapat memperoleh kemampuan seperti pemahaman bahasa dan pengenalan gambar. Inferensi mengacu pada proses ketika model yang telah dilatih menerima masukan baru dan menghasilkan keluaran berdasarkan parameter yang sudah ada.
Keduanya memerlukan sumber daya komputasi, tetapi beban kerjanya sangat berbeda. Pelatihan model biasanya melibatkan pemrosesan set data besar, penghitungan gradien, dan pembaruan parameter. Proses ini menekankan komputasi paralel berskala besar, kapasitas memori, dan koordinasi di antara banyak perangkat. Sebaliknya, inferensi perlu menghasilkan hasil dengan cepat sebagai respons terhadap permintaan pengguna. Hal ini sangat penting dalam aplikasi chat, suara, dan otomatisasi, ketika waktu respons secara langsung memengaruhi pengalaman pengguna.
Untuk model bahasa besar, proses inferensi umumnya mencakup dua tahap: Prefill dan Decode. Prefill memproses prompt masukan dan membentuk status komputasi yang relevan, sedangkan Decode menghasilkan Token berikutnya satu per satu. Karena model bahasa autoregresif biasanya perlu memprediksi Token berikutnya berdasarkan konten yang telah dihasilkan, proses generasi berkelanjutan menuntut efisiensi akses memori dan penjadwalan komputasi yang tinggi.
Pengguna aplikasi chat biasa mungkin dapat menoleransi waktu tunggu singkat. Namun, dalam asisten suara real-time, layanan pelanggan otomatis, dan skenario AI interaktif, latensi respons dapat secara langsung memengaruhi seberapa alami percakapan terasa. Jika sebuah model membutuhkan waktu terlalu lama untuk menghasilkan bagian pertama dari respons, atau kecepatan keluarannya tidak memadai untuk komunikasi real-time, model tersebut mungkin sulit memenuhi kebutuhan bisnis praktis meskipun modelnya sendiri sangat mampu.
Perkembangan AI Agent semakin meningkatkan permintaan terhadap inferensi. Berbeda dari interaksi tanya jawab satu kali, AI Agent mungkin perlu memanggil beberapa model, menganalisis data eksternal, menjalankan operasi alat, dan memverifikasi hasil. Satu tugas pengguna dapat menghasilkan beberapa putaran penalaran internal dan beberapa permintaan API, sehingga meningkatkan konsumsi komputasi total.
Akibatnya, persaingan dalam infrastruktur AI berkembang melampaui sekadar upaya mengejar kemampuan pelatihan model yang lebih tinggi. Persaingan kini juga berfokus pada penyediaan layanan inferensi dengan latensi lebih rendah, throughput lebih tinggi, dan biaya yang lebih wajar.
Namun, meningkatnya permintaan inferensi tidak berarti komputasi pelatihan menjadi kurang penting. Pelatihan model baru, penyempurnaan model, dan penyediaan layanan inferensi kemungkinan semuanya akan terus tumbuh secara bersamaan. Perbedaannya adalah kebutuhan perangkat keras untuk berbagai tugas komputasi menjadi semakin terspesialisasi.
Apa Karakteristik Utama Pendekatan Teknologi LPU Groq?
LPU adalah istilah teknis yang digunakan Groq untuk menggambarkan prosesor inferensi khususnya. Dibandingkan GPU serbaguna yang dirancang untuk berbagai tugas komputasi, desain LPU lebih berfokus pada komputasi, perpindahan data, dan pengendalian latensi untuk beban kerja AI tertentu.
Teknologi LPU Groq dapat dipahami melalui tiga aspek: memori on-chip, eksekusi deterministik, dan compiler.
Bagaimana SRAM On-Chip Memengaruhi Efisiensi Akses Data?
Komputasi AI modern tidak hanya dibatasi oleh kemampuan aritmetika sebuah chip, tetapi juga oleh kecepatan akses dan transfer data. Selama inferensi model bahasa besar, unit komputasi harus terus-menerus mengakses bobot model dan data perantara. Jika data tidak dapat dikirimkan tepat waktu, prosesor mungkin tidak dapat memanfaatkan sumber dayanya secara penuh meskipun memiliki kapasitas komputasi teoretis yang tinggi.
Salah satu karakteristik penting LPU Groq adalah penekanannya pada SRAM on-chip (static random-access memory). SRAM umumnya menyediakan latensi akses yang lebih rendah dan dapat membantu prosesor membaca data yang dibutuhkan dengan cepat. Dibandingkan desain yang mengandalkan memori eksternal berbandwidth tinggi berkapasitas lebih besar, arsitektur ini berupaya mengurangi overhead akses data untuk tugas komputasi tertentu.
SRAM juga memiliki keterbatasan biaya dan kapasitas. Dengan area chip yang sama, SRAM umumnya tidak dapat menyediakan skala penyimpanan yang setara dengan memori eksternal berkapasitas besar. Oleh karena itu, penerapan model dengan jumlah parameter lebih besar mungkin memerlukan koordinasi multi-chip, pembagian model, dan optimasi tingkat sistem untuk memenuhi kebutuhan kapasitas.
Artinya, SRAM on-chip tidak secara inheren lebih unggul daripada setiap arsitektur memori lainnya. Nilainya bergantung pada model dan beban kerja spesifik, serta pada kemampuan sistem komputasi dalam mengoordinasikan penyimpanan dan transfer data secara efektif.
Mengapa Eksekusi Deterministik Penting?
Elemen penting lain dalam desain Groq adalah eksekusi deterministik. Dalam pendekatan arsitektur ini, compiler dapat merencanakan sejumlah besar operasi komputasi dan transfer data sebelumnya, sehingga prosesor dapat beroperasi sesuai dengan jadwal eksekusi yang telah ditentukan.
GPU tradisional umumnya perlu mendukung beragam tugas komputasi, penjadwalan dinamis, dan lingkungan perangkat lunak yang kompleks, sehingga memiliki fleksibilitas yang kuat. Sebaliknya, Groq berupaya mengurangi sebagian ketidakpastian yang terkait dengan penjadwalan waktu proses dan koordinasi sumber daya melalui rencana eksekusi yang lebih eksplisit.
Untuk inferensi berlatensi rendah, waktu eksekusi yang dapat diprediksi memiliki nilai praktis. Ketika perusahaan menyediakan layanan AI real-time, mereka tidak hanya memperhatikan kecepatan respons rata-rata, tetapi juga variasi latensi di antara permintaan yang berbeda. Jika suatu layanan sesekali mengalami penundaan respons yang signifikan, pengalaman pengguna dapat terdampak meskipun performa rata-ratanya tinggi.
Eksekusi deterministik tidak berarti bahwa setiap permintaan akan memiliki waktu respons yang sama persis. Latensi aktual masih dapat dipengaruhi oleh faktor seperti panjang masukan, panjang keluaran, strategi batching, beban sistem, dan kondisi jaringan.
Bagaimana Compiler Berkontribusi pada Optimasi Performa LPU?
Pendekatan teknologi Groq tidak hanya mengandalkan perangkat keras untuk meningkatkan performa. Groq menekankan desain terpadu perangkat keras-perangkat lunak. Compiler perlu menganalisis grafik komputasi model dan memetakan operasi yang relevan ke sumber daya komputasi serta penyimpanan chip.
Dalam proses ini, compiler tidak hanya bertanggung jawab untuk mengonversi model menjadi instruksi yang dapat dieksekusi, tetapi juga mengatur transfer data, urutan komputasi, dan penggunaan sumber daya agar unit komputasi yang berbeda dapat bekerja bersama sesuai rencana yang telah ditentukan.
Desain ini memungkinkan optimasi mendalam untuk model yang didukung, tetapi juga menuntut toolchain perangkat lunak yang kuat. Ketika struktur model, jenis operator, atau kebutuhan inferensi berubah, platform perlu terus meningkatkan compiler dan lingkungan runtime-nya.
Oleh karena itu, daya saing teknologi Groq tidak hanya berasal dari chip LPU itu sendiri, tetapi juga dari compiler, kemampuan adaptasi model, dan efisiensi koordinasi sistem inferensinya secara keseluruhan.
Bagaimana GroqCloud Mengubah Komputasi LPU Menjadi Layanan Komersial?
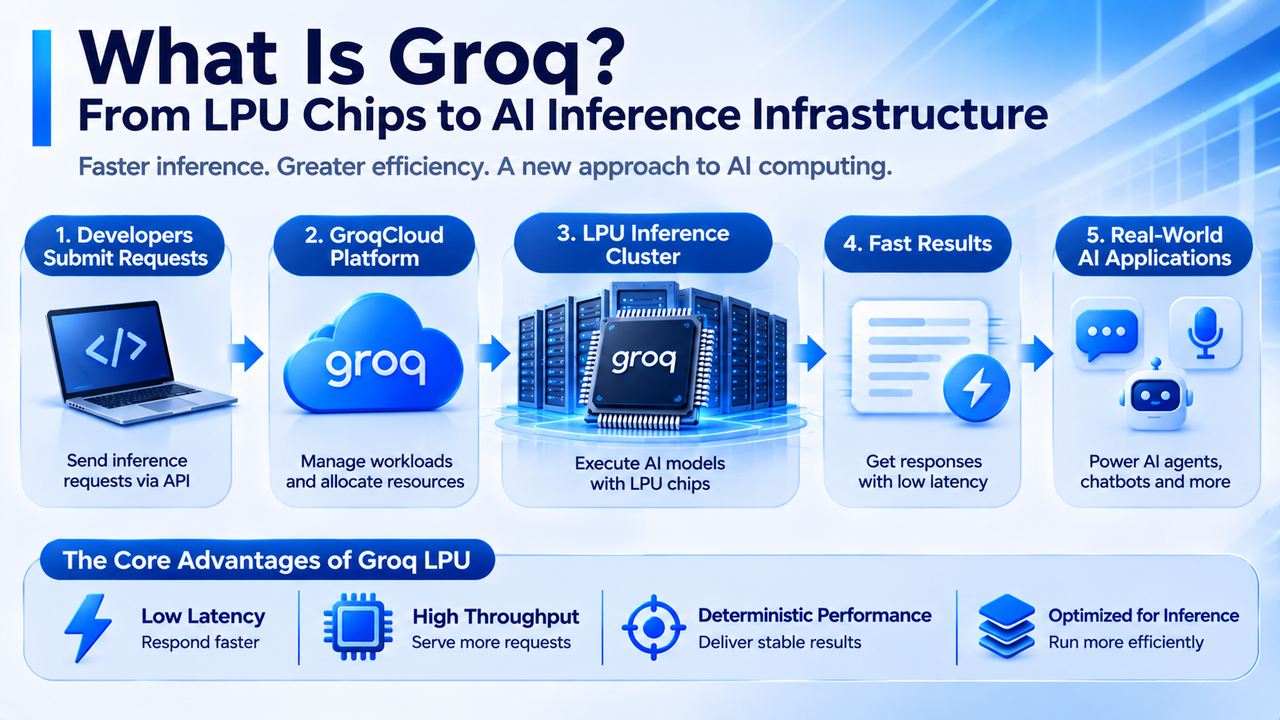
GroqCloud adalah layanan inferensi AI berbasis cloud milik Groq untuk developer dan perusahaan. Layanan ini mengintegrasikan chip yang mendasarinya, klaster komputasi, dan lingkungan runtime model ke dalam layanan yang dapat diakses melalui API. Hal ini memungkinkan pelanggan menggunakan infrastruktur inferensi Groq tanpa membeli dan menerapkan chip khusus sendiri.
Dalam aplikasi umum, developer terlebih dahulu memilih model yang didukung platform, lalu mengirimkan teks atau jenis masukan lainnya melalui API. GroqCloud menerima permintaan, menetapkan tugas komputasi yang relevan ke sistem inferensi yang mendasarinya, dan mengembalikan hasil yang dihasilkan ke aplikasi. Proses ini mencakup penjadwalan permintaan, eksekusi model, pengelolaan sumber daya, dan transmisi hasil.
Bagi pelanggan perusahaan, nilai utama penggunaan layanan inferensi cloud adalah hambatan yang lebih rendah untuk menerapkan infrastruktur. Membangun klaster komputasi AI secara mandiri biasanya memerlukan pembelian perangkat keras, konfigurasi jaringan, penerapan model, dan pemeliharaan lingkungan runtime. Penggunaan layanan inferensi melalui API mengubah sebagian investasi infrastruktur tetap menjadi pengeluaran layanan yang bervariasi sesuai penggunaan bisnis.
Platform Groq juga berkembang dari satu API inferensi menuju layanan infrastruktur perusahaan yang lebih komprehensif. Portofolio produknya mencakup infrastruktur komputasi khusus, stack perangkat lunak inferensi, serta kemampuan tata kelola dan kontrol tingkat perusahaan untuk memenuhi kebutuhan pelanggan yang berbeda terkait performa, metode penerapan, dan izin pengelolaan.
Namun, nilai komersial layanan inferensi cloud tidak sepenuhnya bergantung pada kecepatan chip. Perusahaan juga harus mempertimbangkan dukungan model, stabilitas API, ketersediaan layanan, keamanan data, dan biaya per permintaan. Jika sebuah platform hanya mendukung rentang model atau operator yang terbatas, platform tersebut mungkin tidak dapat memenuhi seluruh kebutuhan aplikasi perusahaan meskipun menyediakan latensi rendah untuk tugas tertentu.
Dari sisi model pendapatan, layanan cloud inferensi umumnya dapat mengenakan biaya berdasarkan penggunaan model, jumlah Token yang diproses, atau kapasitas komputasi yang dicadangkan. Metode penetapan harga yang berbeda menciptakan kebutuhan pengelolaan sumber daya yang berbeda pula. Penagihan berbasis penggunaan lebih bergantung pada volume permintaan aktual, sedangkan layanan kapasitas cadangan memerlukan perhatian terhadap kontrak pelanggan, penyediaan sumber daya, dan tingkat pemanfaatan peralatan.
Oleh karena itu, kemampuan GroqCloud untuk mengomersialkan teknologinya pada akhirnya bergantung pada kemampuannya mengubah keunggulan performa LPU yang mendasarinya menjadi layanan inferensi yang stabil, skalabel, dan kompetitif dari sisi biaya.
Bagaimana Kemitraan Groq dengan NVIDIA Mengubah Posisi Industrinya?
Hubungan Groq dengan NVIDIA merupakan latar belakang penting untuk memahami posisi industrinya saat ini.
Pada Desember 2025, Groq dan NVIDIA menandatangani perjanjian lisensi teknologi inferensi AI non-eksklusif. Menurut pengungkapan kedua pihak, NVIDIA memperoleh lisensi atas teknologi inferensi relevan milik Groq, sementara pendiri Groq Jonathan Ross, Presiden saat itu Sunny Madra, dan beberapa anggota tim bergabung dengan NVIDIA. Groq tetap beroperasi sebagai perusahaan independen di bawah CEO Simon Edwards, dan bisnis GroqCloud tetap beroperasi.
Transaksi ini berarti bahwa nilai teknologi Groq tidak hanya tercermin dalam penjualan independen layanan inferensi, tetapi juga dalam masuknya Groq ke ekosistem komputasi AI yang lebih luas melalui lisensi teknologi.
Pada Maret 2026, NVIDIA selanjutnya memperkenalkan arsitektur akselerasi inferensi Groq 3 LPX dan menggabungkannya dengan platform Vera Rubin. Solusi terkait berupaya membagi beban kerja antara GPU dan LPU berdasarkan karakteristik komputasi dari berbagai tahap inferensi AI, dengan tujuan meningkatkan efisiensi inferensi berlatensi rendah. Perkembangan ini mencerminkan semakin kompleksnya persaingan di pasar chip AI. Pada masa lalu, chip inferensi khusus sering dipandang sebagai pengganti potensial GPU. Namun, dalam arsitektur komputasi heterogen, berbagai jenis prosesor juga dapat menjalankan tugas yang saling melengkapi.
Sebagai contoh, GPU dapat menangani komputasi paralel berskala besar dan beberapa perhitungan attention yang sesuai dengan arsitekturnya, sedangkan LPU dapat menangani tugas komputasi yang lebih sensitif terhadap waktu eksekusi dan latensi transfer data. Melalui penjadwalan tingkat sistem, kedua jenis prosesor tersebut dapat bekerja bersama pada beban kerja inferensi yang sama.
Namun, arsitektur heterogen juga menimbulkan kompleksitas rekayasa tambahan. Sistem perlu mengoordinasikan transfer data, alokasi tugas, dan pengelolaan memori di berbagai perangkat. Jika overhead komunikasi lintas perangkat terlalu tinggi, keunggulan perangkat keras secara teoretis mungkin tidak sepenuhnya terwujud dalam performa praktis.
Pada Agustus 2026, Groq juga mengumumkan bahwa perusahaan tersebut telah bergabung dengan program NVIDIA Cloud Partner, yang semakin memperkuat posisinya sebagai operator infrastruktur cloud AI. Oleh karena itu, Groq tidak lagi dapat digambarkan secara sederhana sebagai perusahaan chip yang sepenuhnya independen dari ekosistem NVIDIA dan hanya berfokus menantang GPU. Bisnisnya saat ini mencakup layanan cloud inferensi independen, teknologi chip khusus, dan kerja sama infrastruktur dengan NVIDIA.
Bagaimana Model Bisnis Groq Beradaptasi terhadap Pertumbuhan Pasar Inferensi AI?
Permintaan komersial di pasar inferensi AI terutama berasal dari aplikasi perusahaan, layanan developer, dan produk AI yang beroperasi secara berkelanjutan. Berbeda dengan pelatihan model yang umumnya berbasis proyek dan berlangsung secara bertahap, layanan inferensi perlu menyediakan kapasitas komputasi secara berkelanjutan seiring perubahan trafik pengguna. Oleh karena itu, layanan ini lebih menekankan pemanfaatan sumber daya, biaya per unit, dan stabilitas layanan.
Model bisnis Groq dapat dipahami dalam tiga tingkatan.
-
Pembangunan infrastruktur inferensi. Groq perlu membangun kapasitas komputasi yang dapat digunakan melalui chip, server, jaringan, dan pusat data. Aset-aset ini hanya dapat mendukung permintaan pelanggan dan menghasilkan pendapatan setelah penerapan peralatan, adaptasi model, dan peluncuran layanan selesai.
-
Layanan cloud inferensi. GroqCloud mengubah kapasitas komputasi menjadi API yang dapat dipanggil developer, tanpa mengharuskan pelanggan mengelola chip yang mendasarinya secara langsung. Bagi penyedia layanan, pertumbuhan pendapatan bergantung pada jumlah pelanggan, volume permintaan, harga layanan, dan retensi pelanggan.
-
Layanan infrastruktur perusahaan. Sebagian perusahaan mungkin memerlukan sumber daya komputasi khusus, metode penerapan tertentu, atau persyaratan tata kelola yang lebih ketat. Kebutuhan ini dapat menciptakan hubungan pelanggan jangka panjang yang lebih stabil, tetapi juga memerlukan investasi lebih besar dalam rekayasa, operasional, dan dukungan pelanggan.
Pada Juni 2026, Groq mengumumkan bahwa perusahaan tersebut telah memperoleh pendanaan pertumbuhan sebesar $650 juta untuk memperluas bisnis cloud inferensi AI globalnya, dengan target mencapai kapasitas infrastruktur sekitar 200 MW pada 2027. Pada saat itu, perusahaan mengungkapkan bahwa mereka mengoperasikan 13 pusat data di berbagai wilayah, melayani lebih dari 5 juta developer, dan memproses puluhan triliun Token AI setiap minggu.
Angka-angka ini dapat digunakan untuk mengamati laju ekspansi bisnis, tetapi tidak secara langsung membuktikan profitabilitas. Jumlah developer, volume Token, dan jumlah pusat data masing-masing mencerminkan jangkauan pengguna, aktivitas layanan, dan skala infrastruktur. Angka-angka tersebut tidak sama dengan pendapatan aktual, laba, atau arus kas bebas.
Sebagai contoh, anggap jumlah Token yang diproses platform inferensi setiap bulan meningkat 100%, tetapi harga per Token turun 40% akibat persaingan pasar. Pertumbuhan pendapatannya kemudian dapat lebih rendah daripada pertumbuhan penggunaannya. Jika biaya pembangunan dan operasional infrastruktur juga meningkat dalam periode yang sama, margin laba dapat terdampak lebih lanjut.
Oleh karena itu, analisis potensi komersialisasi Groq memerlukan pertimbangan simultan atas pertumbuhan permintaan inferensi, harga layanan, pemanfaatan peralatan, dan belanja modal. Nilai pasar tidak dapat dinilai hanya berdasarkan kecepatan eksekusi model.
Tantangan Teknis dan Skalabilitas Apa yang Dihadapi Groq?
Meskipun chip inferensi khusus dapat dioptimalkan untuk beban kerja tertentu, Groq tetap menghadapi tantangan yang timbul dari perubahan model, skalabilitas perangkat keras, dan persaingan pasar.
Adaptasi model. Arsitektur model AI terus berkembang dengan cepat. Model yang berbeda dapat menggunakan mekanisme attention, skala parameter, presisi komputasi, dan strategi inferensi yang berbeda. Jika prosesor khusus ingin mendukung lebih banyak model, compiler, lingkungan runtime, dan perangkat lunak terkaitnya harus terus diperbarui.
Hal ini juga berarti bahwa keunggulan performa yang dicapai oleh satu generasi chip pada model tertentu mungkin tidak dapat langsung diterapkan pada setiap model baru. Seiring berkembangnya inferensi konteks panjang, model mixture-of-experts, dan komputasi multimodal, sistem komputasi yang mendasarinya perlu terus beradaptasi dengan beban kerja baru.
Skalabilitas multi-chip. LPU Groq menekankan SRAM on-chip dan eksekusi deterministik, tetapi model besar sering kali memerlukan sumber daya penyimpanan dan komputasi yang melampaui kapasitas satu chip. Ketika model didistribusikan di beberapa chip, sistem perlu mengoordinasikan transfer data dan urutan komputasi antarperangkat.
Jika komunikasi multi-chip tidak efisien, keunggulan latensi rendah dari satu chip dapat berkurang. Oleh karena itu, interkoneksi chip, bandwidth sistem, dan kemampuan penjadwalan compiler merupakan faktor penting dalam menentukan apakah arsitektur inferensi khusus dapat diskalakan.
Biaya pembangunan infrastruktur. Meskipun chip menawarkan efisiensi komputasi tinggi, pembangunan pusat data AI tetap memerlukan sambungan listrik, ruang fasilitas, sistem pendinginan, dan infrastruktur jaringan. Seiring layanan inferensinya berkembang, Groq juga perlu menanggung biaya modal dan operasional terkait.
Persaingan pasar. GPU NVIDIA, GPU AMD, TPU Google, dan akselerator AI khusus lainnya semuanya bersaing untuk memenuhi permintaan komputasi inferensi. Berbagai platform dapat memiliki keunggulan masing-masing dalam kompatibilitas model, throughput, latensi, biaya, dan ekosistem perangkat lunak.
Bagi pelanggan perusahaan, pilihan akhir umumnya tidak ditentukan oleh satu metrik performa. Pilihan tersebut bergantung pada total biaya layanan, kompatibilitas aplikasi, dan keandalan operasional jangka panjang. Oleh karena itu, apakah pendekatan teknologi Groq dapat membangun daya saing berkelanjutan tidak hanya bergantung pada arsitektur LPU itu sendiri, tetapi juga pada kemampuan perusahaan untuk terus memperluas dukungan perangkat lunak, meningkatkan pemanfaatan sumber daya komputasi, dan mengendalikan biaya ekspansi infrastruktur.
Apa Arti Groq bagi Chip AI dan Industri Komputasi?
Pendekatan teknologi yang diwakili Groq mencerminkan pergeseran bertahap industri komputasi AI dari arsitektur yang berpusat pada akselerator serbaguna menuju sistem komputasi heterogen yang dioptimalkan untuk berbagai beban kerja. Pada tahap awal perkembangan AI generatif, kemampuan pelatihan merupakan pendorong penting kemajuan industri. Seiring semakin banyak model diterapkan secara praktis, layanan inferensi mulai menciptakan permintaan komputasi yang berkelanjutan, sehingga meningkatkan kebutuhan perusahaan akan latensi rendah, efisiensi biaya, dan stabilitas layanan.
Hal ini menciptakan ruang bagi pengembangan chip inferensi khusus. Dengan mengoptimalkan perangkat keras dan perangkat lunak untuk proses komputasi tertentu, arsitektur khusus dapat mencapai keunggulan performa atau biaya dalam tugas tertentu.
Namun, ini tidak berarti bahwa GPU akan sepenuhnya digantikan oleh chip inferensi khusus. GPU memiliki ekosistem perangkat lunak yang luas, dukungan model yang ekstensif, dan kemampuan komputasi serbaguna, sehingga dapat beradaptasi dengan beragam beban kerja pelatihan dan inferensi. Akselerator khusus mungkin justru berperan dalam model tertentu, tahap komputasi tertentu, atau skenario berlatensi rendah.
Kerja sama teknologi antara NVIDIA dan Groq semakin menunjukkan bahwa pusat data AI pada masa depan dapat menerapkan berbagai jenis perangkat komputasi secara bersamaan dan mengoordinasikannya melalui sistem penjadwalan perangkat lunak. Pendekatan ini dapat meningkatkan pemanfaatan sumber daya komputasi, tetapi juga meningkatkan kompleksitas desain dan pengelolaan sistem.
Bagi industri infrastruktur AI, fokus persaingan dapat secara bertahap berkembang dari performa teoretis chip individual menuju kemampuan menyediakan sistem komputasi yang lengkap. Performa chip, bandwidth memori, interkoneksi perangkat, compiler, efisiensi energi, dan operasi layanan cloud dapat memengaruhi imbal hasil komersial akhir.
Perkembangan Groq juga menunjukkan bahwa infrastruktur inferensi AI bukan sekadar isu manufaktur chip. Ini adalah industri terintegrasi yang mencakup arsitektur perangkat keras, optimasi perangkat lunak, pembangunan pusat data, dan penyediaan layanan komersial.
Kesimpulan
Groq adalah perusahaan teknologi yang berfokus pada komputasi inferensi AI. Arsitektur LPU-nya menggunakan elemen desain seperti SRAM on-chip, eksekusi deterministik, dan penjadwalan compiler untuk meningkatkan efisiensi eksekusi bagi beban kerja AI tertentu. GroqCloud mengubah kemampuan komputasi yang mendasarinya menjadi layanan inferensi cloud, sehingga developer dan perusahaan dapat menggunakan infrastruktur terkait melalui API.
Seiring aplikasi AI berkembang melampaui pelatihan model menuju interaksi real-time, AI Agent, dan layanan perusahaan yang beroperasi secara berkelanjutan, latensi inferensi, throughput, dan biaya menjadi metrik teknis yang semakin penting. Arsitektur inferensi khusus yang diwakili oleh Groq menawarkan pendekatan alternatif bagi industri komputasi AI dibandingkan GPU serbaguna.
Pada saat yang sama, lisensi teknologi dan kerja sama infrastruktur Groq dengan NVIDIA menunjukkan bahwa chip inferensi khusus dan GPU tidak harus sepenuhnya bersaing. Pusat data AI pada masa depan dapat semakin mengadopsi arsitektur komputasi heterogen, dengan prosesor berbeda menangani tugas yang sesuai dengan karakteristiknya masing-masing.
Namun, keunggulan teknis chip khusus tidak secara otomatis menghasilkan kesuksesan komersial. Groq masih perlu mengatasi adaptasi model, skalabilitas multi-chip, biaya infrastruktur, dan profitabilitas layanan cloud. Perkembangan jangka panjangnya akan bergantung pada kemampuannya mengubah keunggulan performa inferensi menjadi permintaan pelanggan yang stabil, pendapatan berkelanjutan, dan imbal hasil modal yang wajar.
FAQ
Perusahaan Seperti Apa Groq?
Groq adalah perusahaan teknologi yang berfokus pada komputasi inferensi AI. Bidang bisnis utamanya mencakup prosesor khusus LPU, sistem komputasi inferensi, dan layanan inferensi cloud GroqCloud.
Apakah Groq dan Grok Merupakan Produk yang Sama?
Tidak. Groq adalah perusahaan teknologi yang berkaitan dengan infrastruktur inferensi AI, sedangkan Grok adalah model kecerdasan buatan dan produk asisten yang dikembangkan oleh xAI.
Apa Itu LPU Groq?
LPU adalah prosesor inferensi AI khusus yang dirancang oleh Groq. LPU menekankan SRAM on-chip, eksekusi deterministik, penjadwalan compiler, dan komputasi berlatensi rendah.
Apa Perbedaan LPU Groq dengan GPU NVIDIA?
LPU lebih menekankan optimasi komputasi dan transfer data untuk tugas inferensi tertentu, sedangkan GPU menawarkan kemampuan komputasi paralel dan ekosistem perangkat lunak yang lebih luas. Performa aktual bergantung pada model, ukuran batch, kebutuhan latensi, dan lingkungan penerapan.
Apakah Groq Diakuisisi oleh NVIDIA?
Per November 2026, Groq terus beroperasi sebagai perusahaan independen. Kedua pihak menandatangani perjanjian lisensi teknologi non-eksklusif pada Desember 2025, dan beberapa anggota tim Groq bergabung dengan NVIDIA. Hal ini tidak berarti NVIDIA telah menyelesaikan akuisisi Groq secara keseluruhan.
Apa Itu GroqCloud?
GroqCloud adalah layanan inferensi AI berbasis cloud milik Groq. Layanan ini memungkinkan developer memanggil model yang didukung platform melalui API tanpa perlu membeli dan menerapkan perangkat keras komputasi yang mendasarinya sendiri.
Mengapa Groq Mendapat Perhatian di Pasar Komputasi AI?
Pendekatan teknologi Groq mengoptimalkan latensi, transfer data, dan efisiensi eksekusi dalam inferensi AI. Hal ini selaras dengan kebutuhan efisiensi komputasi aplikasi AI real-time, AI Agent, dan layanan inferensi perusahaan.
Apakah Groq Memiliki Mata Uang Kripto Sendiri?
Groq adalah perusahaan infrastruktur komputasi AI. Bisnis LPU dan GroqCloud-nya tidak bergantung pada token mata uang kripto native. Token pihak ketiga dengan nama serupa tidak boleh secara langsung dianggap sebagai aset yang diterbitkan atau didukung oleh Groq.