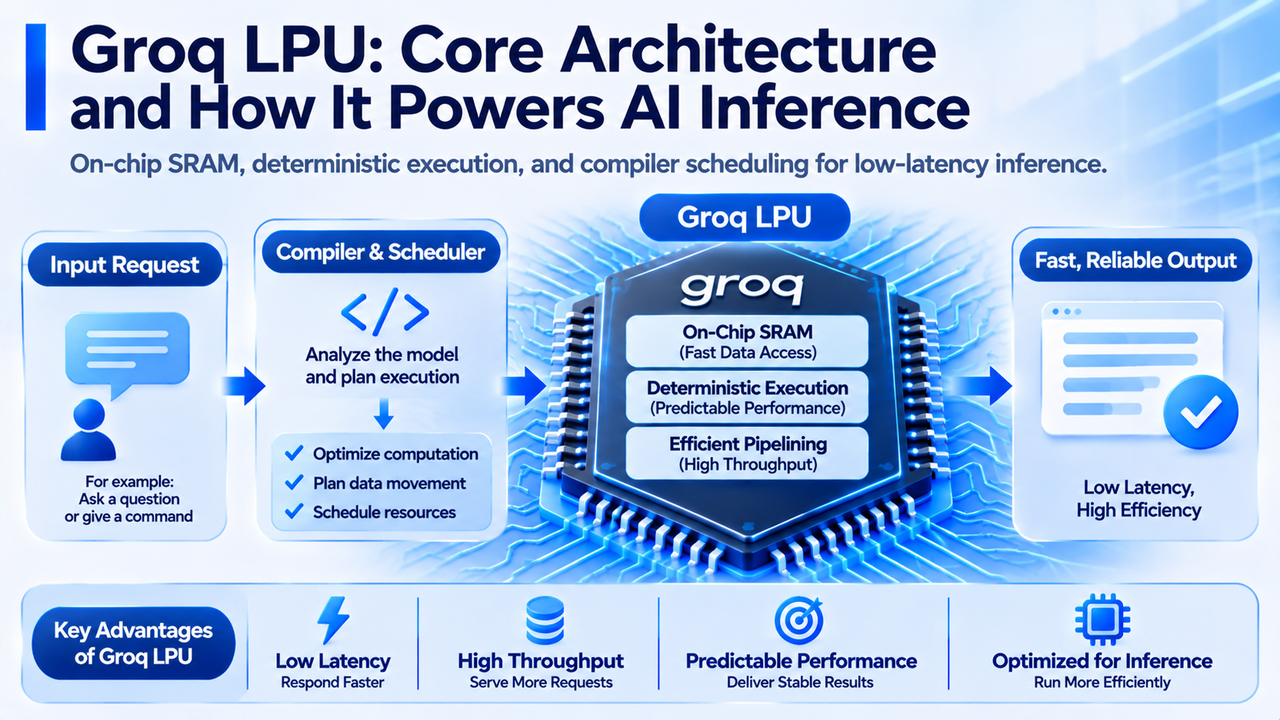
Tidak seperti GPU yang dirancang untuk berbagai tugas komputasi paralel masif, Groq LPU menggunakan arsitektur yang menekankan SRAM on-chip, penjadwalan compiler statis, dan eksekusi deterministik. Pendekatan ini bertujuan mengurangi transfer data dan overhead penjadwalan runtime selama inferensi, sehingga menyediakan kemampuan komputasi yang lebih terarah untuk aplikasi AI waktu nyata.
Seiring model bahasa besar semakin banyak digunakan dalam layanan pelanggan cerdas, interaksi suara, AI Agent, dan otomatisasi perusahaan, kebutuhan inferensi berkembang melampaui sekadar memaksimalkan kecepatan pemrosesan, mencakup latensi respons, stabilitas layanan, dan biaya komputasi per unit. Pendekatan akselerator khusus yang diwakili oleh Groq LPU menyediakan opsi teknis bagi infrastruktur AI yang berbeda dari arsitektur komputasi serbaguna tradisional. Artikel ini mengulas secara mendalam cara kerja Groq LPU, menganalisis dampak SRAM, eksekusi deterministik, dan compiler terhadap kinerja inferensi, serta membahas skenario penerapan dan keterbatasan teknisnya.
Poin Utama
-
Groq LPU adalah prosesor khusus yang dirancang untuk beban kerja inferensi AI, dengan penekanan pada latensi rendah, eksekusi yang dapat diprediksi, dan transfer data yang efisien.
-
Inferensi model bahasa besar umumnya terdiri atas dua tahap: Prefill dan Decode. Kedua tahap ini memiliki kebutuhan daya komputasi dan bandwidth memori yang berbeda.
-
Groq LPU menggunakan SRAM on-chip untuk memperpendek jalur akses data tertentu, tetapi kapasitas penyimpanan on-chip yang relatif terbatas juga menimbulkan persyaratan untuk penerapan model dan penskalaan multi-chip.
-
Eksekusi deterministik dan penjadwalan compiler statis dapat mengurangi sebagian overhead penjadwalan runtime, tetapi tidak berarti setiap permintaan akan memiliki waktu respons yang sama persis.
-
LPU memiliki potensi keunggulan dalam aplikasi berlatensi rendah seperti pembuatan teks waktu nyata dan interaksi suara. Kinerja aktualnya tetap bergantung pada model, beban kerja, konfigurasi sistem, dan harga layanan.
Apa Itu Groq LPU? Apa Perbedaannya dengan Akselerator AI Tradisional?
Groq LPU adalah prosesor inferensi AI khusus yang dirancang oleh Groq. LPU merupakan singkatan dari Language Processing Unit. Desainnya ditujukan untuk mengoptimalkan pergerakan data, eksekusi komputasi, dan pengendalian latensi dalam inferensi model bahasa, alih-alih menyediakan kemampuan komputasi serbaguna untuk setiap jenis tugas.
Untuk memahami posisi teknis LPU, pertama-tama perlu mengenali perbedaan pendekatan desain yang digunakan oleh akselerator AI. GPU pada awalnya dirancang terutama untuk pemrosesan grafis. GPU kemudian diadopsi secara luas untuk pelatihan dan inferensi deep learning karena kemampuan komputasi paralel berskala besar serta ekosistem perangkat lunaknya yang matang. Akselerator khusus seperti TPU meningkatkan efisiensi eksekusi tugas komputasi tertentu dengan mengoptimalkan operasi untuk machine learning.
Groq LPU lebih menekankan koordinasi antara compiler dan perangkat keras. Arsitekturnya bertujuan merencanakan komputasi dan transfer data sebelum model dieksekusi, sehingga chip dapat menyelesaikan tugas sesuai jadwal yang telah ditentukan dan mengurangi sebagian overhead yang dihasilkan oleh penjadwalan dinamis.
Pendekatan desain ini terkait erat dengan arah teknologi Tensor Streaming Processor (TSP) yang diperkenalkan Groq pada tahap awal pengembangannya. Dengan mengatur sumber daya komputasi, penyimpanan on-chip, dan jalur transfer data, prosesor memungkinkan operasi model dijalankan dalam urutan yang diatur oleh compiler.
Penting untuk dicatat bahwa LPU bukan kategori industri standar untuk semua prosesor model bahasa. LPU adalah nama teknis yang digunakan oleh Groq. Produsen yang berbeda dapat menggunakan desain chip yang berbeda atau mencapai inferensi berlatensi rendah melalui GPU, ASIC, atau akselerator khusus lainnya.
Oleh karena itu, menilai nilai teknis Groq LPU memerlukan lebih dari sekadar mempertimbangkan nama prosesornya. Penilaian tersebut memerlukan analisis tentang cara LPU menangani akses data, penjadwalan komputasi, dan komunikasi multi-chip selama inferensi.
Mengapa Model Bahasa Besar Membutuhkan Komputasi Berlatensi Rendah?
Inferensi model bahasa besar mengacu pada proses ketika model menerima input dan menggunakan parameter yang telah dilatih untuk menghasilkan output. Untuk model bahasa autoregresif yang umum, inferensi umumnya terdiri atas dua tahap: Prefill dan Decode. Tahap Prefill terutama memproses prompt pengguna dan membangun status komputasi yang diperlukan untuk pembuatan output berikutnya. Karena tahap ini dapat memproses beberapa Token input secara bersamaan, tahap ini umumnya memiliki karakteristik komputasi paralel yang kuat.
Tahap Decode menghasilkan Token output satu per satu. Model biasanya perlu memprediksi Token berikutnya berdasarkan input yang sudah ada dan konten yang sebelumnya dihasilkan, sehingga terdapat ketergantungan antara beberapa langkah pembuatan. Akibatnya, langkah-langkah ini tidak dapat diparalelkan sepenuhnya semudah beberapa komputasi pelatihan.
Perbedaan ini berarti bahwa kinerja inferensi tidak dapat diukur menggunakan satu metrik saja.
Time to First Token (TTFT) mengukur waktu dari awal permintaan hingga Token output pertama dihasilkan. Metrik ini terutama memengaruhi lamanya waktu tunggu respons yang dirasakan pengguna.
Kecepatan pembuatan Token mengukur jumlah Token yang dapat dihasilkan model per satuan waktu setelah mulai menghasilkan output. Metrik ini secara langsung memengaruhi kelancaran pembuatan teks berkelanjutan. Throughput berfokus pada jumlah permintaan atau Token yang dapat diproses sistem dalam periode tertentu dan mencerminkan kapasitas pemrosesan keseluruhan layanan inferensi saat menangani beban konkurensi yang relatif tinggi.
Sebagai contoh, dua platform inferensi mungkin sama-sama dapat menjalankan model bahasa yang sama, tetapi Platform A mungkin menawarkan pembuatan Token yang lebih cepat untuk satu permintaan pengguna, sedangkan Platform B mungkin mencapai throughput keseluruhan yang lebih tinggi saat memproses ratusan permintaan secara bersamaan.
Artinya, latensi rendah dan throughput tinggi bukanlah tujuan kinerja yang sepenuhnya sama. Sistem yang dioptimalkan untuk interaksi waktu nyata dengan satu pengguna mungkin tidak memiliki keunggulan yang sama dalam setiap skenario pemrosesan batch atau konkurensi tinggi.
Untuk asisten suara, penerjemahan waktu nyata, dan aplikasi AI interaktif, TTFT serta kecepatan pembuatan berkelanjutan sangat penting. Pengguna umumnya mengharapkan sistem mulai merespons dengan cepat dan terus menghasilkan konten yang alami serta lancar.
Untuk tugas seperti analisis dokumen offline dan pemrosesan data batch, waktu respons langsung untuk setiap permintaan mungkin kurang penting. Perusahaan mungkin lebih berfokus pada throughput keseluruhan dan biaya pemrosesan per unit.
Salah satu prioritas desain Groq LPU adalah mengoptimalkan efisiensi eksekusi untuk beban kerja inferensi yang sensitif terhadap waktu respons.
Bagaimana Groq LPU Menggunakan SRAM untuk Meningkatkan Efisiensi Akses Data?
Kinerja prosesor AI modern tidak hanya bergantung pada jumlah operasi yang dapat dilakukan unit komputasinya, tetapi juga pada apakah data dapat mencapai unit komputasi tersebut tepat waktu.
Selama inferensi model bahasa besar, prosesor berulang kali membaca bobot model, mengakses hasil antara, dan mempertahankan data terkait konteks. Jika data tidak dapat dibaca dengan cukup cepat, bahkan chip dengan daya komputasi teoretis tinggi mungkin tidak dapat beroperasi pada kapasitas penuh karena menunggu data.
Masalah ini umumnya dikenal sebagai bottleneck memori.
Salah satu karakteristik arsitektur utama Groq LPU adalah penekanannya pada penggunaan SRAM on-chip (Static Random-Access Memory) untuk penyimpanan dan akses data.
SRAM umumnya menawarkan latensi akses rendah dan dapat langsung diintegrasikan ke dalam chip prosesor. Dibandingkan dengan data yang diakses melalui antarmuka memori eksternal, penyimpanan on-chip dapat memperpendek jalur transfer data dan mengurangi sebagian overhead akses.
Untuk memahami desain ini, penting untuk membandingkan karakteristik dasar SRAM dan high-bandwidth memory (HBM).
| Dimensi Perbandingan |
SRAM |
HBM |
| Lokasi Umum |
Di dalam chip prosesor |
Tumpukan memori independen di dalam paket prosesor |
| Keunggulan Utama |
Latensi akses rendah dan integrasi erat |
Kapasitas lebih besar dan bandwidth agregat tinggi |
| Keterbatasan Utama |
Biaya area tinggi dan kapasitas terbatas |
Akses data masih memerlukan antarmuka memori |
| Penggunaan Umum |
Cache dan memori kerja on-chip |
Data berskala besar seperti bobot model dan aktivasi |
| Signifikansi untuk Inferensi |
Mengoptimalkan jalur akses data tertentu |
Mendukung model dan status komputasi yang lebih besar |
Namun, tidak dapat diasumsikan secara sederhana bahwa SRAM lebih cepat daripada HBM dalam setiap situasi atau bahwa penggunaan SRAM menghilangkan bottleneck memori. Kinerja aktual juga bergantung pada tata letak data, pola akses paralel, bandwidth memori, dan arsitektur model.
Keterbatasan utama SRAM adalah kepadatan penyimpanan dan biaya area chipnya. Untuk model bahasa dengan jumlah parameter besar, SRAM pada satu prosesor umumnya tidak cukup untuk menampung seluruh bobot model dan status runtime.
Karena itu, Groq perlu menggunakan koordinasi multi-chip dan alokasi data tingkat sistem untuk menjalankan model pada sistem komputasi yang lebih besar. Artinya, keunggulan LPU tidak sepenuhnya berasal dari SRAM pada masing-masing chip. Keunggulan tersebut berasal dari desain keseluruhan penyimpanan on-chip, pipeline komputasi, interkoneksi chip, dan compiler.
Bagaimana Eksekusi Deterministik dan Penjadwalan Compiler Memengaruhi Kinerja Inferensi?
Eksekusi deterministik adalah konsep penting lainnya untuk memahami arsitektur Groq LPU. Gagasan utamanya adalah menentukan urutan eksekusi operasi komputasi, jalur transfer data, dan alokasi sumber daya sebanyak mungkin sebelum program berjalan, sehingga mengurangi kebutuhan untuk mengambil keputusan penjadwalan sementara selama eksekusi.
Dalam arsitektur komputasi serbaguna tradisional, prosesor harus beradaptasi dengan berbagai jenis program dan beban kerja. Untuk meningkatkan penggunaan sumber daya, sistem biasanya mencakup penjadwalan tugas dinamis, manajemen cache, dan mekanisme runtime lainnya. Desain ini memberikan fleksibilitas yang besar, tetapi juga dapat menimbulkan overhead penjadwalan tambahan.
Groq LPU menggunakan pendekatan desain yang berbeda. Sebelum model dieksekusi, compiler menganalisis grafik komputasinya dan membuat rencana eksekusi untuk operasi komputasi serta pergerakan data. Prosesor kemudian berjalan sesuai rencana ini, sehingga data dapat bergerak secara teratur di antara unit komputasi yang berbeda. Sebagai contoh, model bahasa mungkin perlu terus-menerus melakukan operasi matriks, fungsi aktivasi, dan komputasi lainnya. Compiler dapat mengatur terlebih dahulu kapan tugas-tugas tersebut akan berjalan pada sumber daya komputasi yang berbeda serta mengoordinasikan transfer data yang diperlukan.
Pendekatan ini serupa dengan merencanakan setiap langkah pada lini produksi terlebih dahulu agar berbagai tahap dapat bekerja sama mengikuti ritme yang telah ditentukan.
Untuk inferensi AI, eksekusi deterministik memiliki dua implikasi utama.
-
Eksekusi deterministik dapat mengurangi sebagian overhead penjadwalan runtime. Prosesor tidak perlu menentukan ulang urutan eksekusi setiap tugas pada setiap tahap komputasi, yang dapat membantu meningkatkan efisiensi eksekusi untuk beban kerja tertentu.
-
Eksekusi deterministik dapat membuat waktu eksekusi komputasi lebih dapat diprediksi. Untuk layanan AI waktu nyata, kinerja respons yang konsisten sama pentingnya dengan latensi rata-rata yang rendah. Eksekusi deterministik tidak berarti waktu respons permintaan API aktual akan sepenuhnya tetap. Panjang input, jumlah Token output, antrean permintaan, transmisi jaringan, dan beban layanan tetap dapat menyebabkan perbedaan latensi end-to-end.
-
Penjadwalan statis juga dapat mengurangi fleksibilitas beberapa tugas komputasi. Jika suatu model memiliki alur kontrol dinamis yang kompleks atau jalur eksekusi harus sering berubah berdasarkan hasil waktu nyata, compiler mungkin perlu menggunakan strategi pemrosesan tambahan.
Oleh karena itu, nilai eksekusi deterministik bukanlah menghilangkan seluruh ketidakpastian. Sebaliknya, untuk tugas komputasi yang sesuai, eksekusi deterministik meningkatkan efisiensi penggunaan sumber daya perangkat keras melalui perencanaan eksekusi yang lebih eksplisit.
Mengapa Groq LPU Sesuai untuk Inferensi AI Berlatensi Rendah?
Desain latensi rendah Groq LPU tidak bergantung pada satu teknologi saja. Desain ini merupakan hasil gabungan dari SRAM on-chip, eksekusi deterministik, optimasi compiler, dan interkoneksi tingkat sistem. Selama pembuatan output model bahasa besar, model harus terus melakukan komputasi dan menghasilkan Token berikutnya berdasarkan hasil yang telah ada. Jika prosesor dapat mengurangi sebagian penundaan akses data dan overhead penjadwalan runtime, prosesor tersebut dapat mempersingkat waktu yang diperlukan untuk langkah-langkah pembuatan berurutan.
Hal ini sangat relevan untuk tahap Decode. Karena model autoregresif umumnya perlu menghasilkan Token satu per satu, latensi setiap langkah pembuatan terakumulasi dan pada akhirnya memengaruhi kecepatan output teks yang dirasakan pengguna. Namun, bottleneck kinerja dari berbagai tugas inferensi tidak selalu sama. Pemrosesan prompt panjang mungkin lebih bergantung pada kemampuan komputasi paralel berskala besar, sedangkan pembuatan berkelanjutan mungkin lebih dipengaruhi oleh akses memori dan latensi eksekusi bertahap.
Oleh karena itu, kinerja aktual Groq LPU harus dievaluasi dengan mempertimbangkan jenis model, panjang input, panjang output, dan jumlah permintaan bersamaan.
Dari perspektif aplikasi, jenis layanan berikut sangat sensitif terhadap inferensi berlatensi rendah.
Interaksi suara waktu nyata. Asisten suara perlu mengonversi ucapan pengguna menjadi teks, memanggil model bahasa untuk menghasilkan respons, lalu menghasilkan output melalui sintesis suara. Jika model bahasa menghasilkan respons secara lambat, percakapan dapat mengalami jeda yang terasa jelas.
AI Agent interaktif. Saat menjalankan tugas, AI Agent mungkin perlu memanggil model bahasa beberapa kali untuk menentukan tindakan berikutnya. Setiap penundaan inferensi memengaruhi waktu penyelesaian tugas secara keseluruhan, sehingga mengurangi waktu tunggu untuk inferensi individual dapat meningkatkan pengalaman pengguna.
Layanan pelanggan cerdas dan aplikasi waktu nyata. Layanan online yang melayani banyak pengguna tidak hanya perlu merespons dengan cepat, tetapi juga perlu mengendalikan fluktuasi latensi antarpermintaan untuk mempertahankan kualitas layanan yang stabil.
Namun, latensi rendah tidak selalu berarti biaya komputasi per unit paling rendah. Sebagai contoh, platform inferensi mungkin memproses satu permintaan dengan kecepatan tinggi, tetapi jika biaya pengadaan perangkat kerasnya tinggi atau sumber daya yang signifikan tetap menganggur saat beban rendah, biaya layanan aktualnya per juta Token masih dapat melebihi solusi lain. Sebaliknya, platform lain mungkin menghasilkan Token lebih lambat untuk setiap permintaan, tetapi melayani banyak pengguna secara bersamaan melalui pemrosesan batch sehingga pada akhirnya mencapai biaya rata-rata yang lebih rendah.
Oleh karena itu, saat memilih platform inferensi, perusahaan perlu menyeimbangkan latensi, throughput, biaya, dan kompatibilitas model, alih-alih membuat keputusan hanya berdasarkan Token per detik.
Apa Saja Keterbatasan Teknis Groq LPU?
Meskipun Groq LPU secara khusus dioptimalkan untuk inferensi AI, arsitektur khusus tidak berarti akan mengungguli solusi lain dalam setiap tugas komputasi. Keterbatasan teknis utamanya mencakup kapasitas memori, penskalaan multi-chip, kompatibilitas model, dan biaya sistem.
Keterbatasan kapasitas SRAM on-chip. Karena SRAM memiliki kepadatan penyimpanan yang relatif rendah, jumlah penyimpanan on-chip yang tersedia pada satu chip terbatas. Ketika parameter model dan status runtime melebihi kapasitas satu chip, komputasi dan data harus didistribusikan ke seluruh sistem multi-chip.
Sebagai contoh, model bahasa besar mungkin memerlukan puluhan gigabita atau lebih penyimpanan. Umumnya sulit untuk menyimpan seluruh data tersebut hanya dengan menggunakan SRAM on-chip dari satu chip. Oleh karena itu, sistem harus mendistribusikan model ke beberapa prosesor dan menggunakan interkoneksi chip untuk melakukan pertukaran data yang diperlukan.
Pendekatan ini dapat meningkatkan ukuran model yang dapat diterapkan, tetapi juga meningkatkan kompleksitas desain sistem.
Overhead komunikasi multi-chip. Meskipun satu LPU dapat menjalankan komputasi dengan cepat, kecepatan inferensi keseluruhan tetap dapat dipengaruhi oleh bandwidth interkoneksi, latensi komunikasi, dan strategi alokasi data ketika model memerlukan transfer data lintas-chip yang sering. Dalam sistem inferensi berskala besar, kinerja tidak hanya bergantung pada daya komputasi satu prosesor, tetapi juga pada operasi terkoordinasi dari seluruh klaster chip.
Kompatibilitas model. Groq LPU mengandalkan compiler untuk memetakan komputasi model ke perangkat keras khusus sehingga memerlukan dukungan perangkat lunak yang sesuai. Ketika model AI baru memperkenalkan operator komputasi, mekanisme perhatian, atau metode eksekusi dinamis yang berbeda, platform mungkin perlu memperbarui compiler dan lingkungan runtime-nya. Dibandingkan dengan GPU serbaguna yang memiliki ekosistem perangkat lunak luas, prosesor inferensi khusus memerlukan pengembangan perangkat lunak berkelanjutan agar dapat beradaptasi dengan teknologi model yang berubah dengan cepat.
Biaya infrastruktur dan komersial. Keunggulan kinerja LPU memerlukan sistem komputasi yang lengkap. Penerapan aktual tetap melibatkan biaya untuk manufaktur chip, server, jaringan, listrik, dan fasilitas pendinginan. Bagi penyedia layanan inferensi cloud, penggunaan peralatan dan permintaan pelanggan juga menentukan tingkat pengembalian investasi.
Oleh karena itu, Groq LPU harus dievaluasi bersama dengan kondisi penerapan aktualnya. Kecepatan pembuatan Token yang tinggi dalam pengujian tertentu tidak secara langsung membuktikan efisiensi biaya yang lebih tinggi di seluruh model dan skenario komersial.
Apa Arti Groq LPU bagi Masa Depan Infrastruktur Inferensi AI?
Pengembangan Groq LPU mencerminkan meningkatnya spesialisasi pasar komputasi AI. Seiring aplikasi AI generatif berkembang, perusahaan mulai memilih arsitektur komputasi yang lebih khusus berdasarkan beban kerja yang berbeda, alih-alih hanya berfokus pada kinerja puncak teoretis dari satu prosesor.
Dalam pelatihan model, komputasi paralel berskala besar, kapasitas memori, dan komunikasi antarbeberapa perangkat tetap penting. Dalam inferensi, TTFT, kecepatan pembuatan berkelanjutan, throughput bersamaan, dan biaya per Token telah menjadi metrik komersial yang lebih langsung.
Perbedaan di antara tugas komputasi menciptakan ruang bagi pengembangan chip inferensi khusus. Pada saat yang sama, prosesor khusus dan GPU tidak selalu memiliki hubungan yang sepenuhnya saling menggantikan. Pada Maret 2026, NVIDIA memperkenalkan arsitektur inferensi yang menggabungkan Groq 3 LPX dengan platform Vera Rubin, untuk mengeksplorasi cara berbagai jenis perangkat komputasi dapat menangani tugas inferensi yang sesuai dengan karakteristik masing-masing.
Arah ini mencerminkan tren perkembangan Heterogeneous Computing. Pada masa depan, pusat data AI dapat menerapkan GPU, akselerator inferensi khusus, dan perangkat komputasi lainnya secara bersamaan, dengan sistem perangkat lunak mengoordinasikan eksekusi berbagai tugas.
Sebagai contoh, sumber daya GPU yang sesuai dapat digunakan untuk beban kerja yang memerlukan pemrosesan paralel berskala besar, sedangkan prosesor inferensi khusus dapat menawarkan keunggulan untuk tugas pembuatan tertentu yang sangat sensitif terhadap latensi. Namun, komputasi heterogen tidak berarti bahwa penambahan lebih banyak jenis chip akan secara otomatis meningkatkan efisiensi. Sistem juga harus menangani komunikasi lintas-perangkat, penjadwalan tugas, kompatibilitas perangkat lunak, dan biaya infrastruktur.
Bagi industri chip AI, hal ini berarti persaingan berkembang dari kinerja komponen perangkat keras individual menjadi efisiensi sistem komputasi lengkap. Arsitektur prosesor, compiler, sistem memori, teknologi interkoneksi, dan operasi layanan cloud semuanya dapat menjadi faktor yang menentukan kinerja akhir serta nilai komersial.
Pendekatan teknologi yang diwakili oleh Groq LPU memberikan contoh spesifik dari pergeseran ini. Nilai jangka panjangnya tidak hanya akan bergantung pada kecepatan inferensi dari generasi chip tertentu, tetapi juga pada kemampuannya untuk terus beradaptasi terhadap evolusi model dan mengubah kinerja teknis menjadi layanan komputasi yang stabil serta dapat diskalakan.
Kesimpulan
Groq LPU adalah prosesor khusus yang dirancang untuk inferensi AI. LPU menggunakan teknologi seperti SRAM on-chip, eksekusi deterministik, dan penjadwalan compiler statis untuk mengoptimalkan akses data serta eksekusi komputasi bagi beban kerja model bahasa besar tertentu.
Dibandingkan dengan GPU serbaguna, Groq LPU lebih menekankan latensi rendah dan prediktabilitas eksekusi untuk tugas inferensi tertentu. Desain ini sesuai untuk mengeksplorasi optimasi kinerja dalam aplikasi seperti pembuatan teks waktu nyata, interaksi suara, dan AI Agent, tetapi tidak berarti LPU dapat menggantikan GPU dalam setiap skenario model dan komputasi.
Pada saat yang sama, kapasitas SRAM, komunikasi multi-chip, adaptasi model, dan biaya infrastruktur tetap menjadi isu penting yang harus ditangani oleh arsitektur inferensi khusus.
Seiring industri AI berkembang dari pengembangan model menuju aplikasi berskala besar, persaingan dalam komputasi inferensi bergeser dari sekadar memaksimalkan daya komputasi menjadi mengoptimalkan latensi, throughput, biaya, dan efisiensi sistem secara keseluruhan. Pengembangan Groq LPU menunjukkan bahwa akselerator khusus dapat memainkan peran yang lebih penting dalam infrastruktur AI masa depan, tetapi nilai aktualnya tetap perlu divalidasi melalui beban kerja spesifik dan hasil penerapan komersial.
FAQ
Apa Itu Groq LPU?
Groq LPU adalah prosesor inferensi AI khusus yang dirancang oleh Groq. LPU terutama menggunakan teknologi seperti SRAM on-chip, eksekusi deterministik, dan penjadwalan compiler untuk mengoptimalkan tugas inferensi model bahasa tertentu.
Apa Perbedaan Utama antara LPU dan GPU?
LPU lebih menekankan optimasi eksekusi dan transfer data untuk tugas inferensi tertentu, sedangkan GPU menawarkan kemampuan komputasi paralel yang luas serta ekosistem perangkat lunak yang matang. Perbedaan kinerjanya bergantung pada model dan lingkungan runtime tertentu.
Mengapa Groq LPU Menggunakan SRAM?
SRAM menyediakan akses data on-chip berlatensi rendah, yang dapat membantu mengurangi overhead pembacaan data pada tugas inferensi tertentu. Namun, kapasitas SRAM terbatas sehingga penerapan model besar umumnya memerlukan koordinasi multi-chip.
Apa yang Dimaksud dengan Eksekusi Deterministik?
Eksekusi deterministik berarti merencanakan urutan komputasi, transfer data, dan alokasi sumber daya sebanyak mungkin sebelum program berjalan. Hal ini dapat mengurangi sebagian overhead penjadwalan runtime dan membuat eksekusi komputasi lebih dapat diprediksi.
Apakah Groq LPU Dapat Digunakan untuk Pelatihan Model AI?
Groq LPU terutama dirancang untuk beban kerja inferensi dan tidak ditujukan khusus untuk pelatihan model berskala besar serbaguna. Dukungan aktualnya bergantung pada arsitektur perangkat keras dan toolchain perangkat lunak.
Apakah Groq LPU Selalu Lebih Cepat daripada GPU NVIDIA untuk Inferensi?
Belum tentu. Model yang berbeda, panjang input, panjang output, tingkat konkurensi, dan lingkungan pengujian semuanya dapat memengaruhi hasil. Kecepatan pembuatan Token yang lebih tinggi untuk satu pengguna tidak selalu berarti throughput keseluruhan yang lebih baik atau biaya per Token yang lebih rendah.
Mengapa Groq LPU Sesuai untuk AI Agent?
AI Agent mungkin perlu menjalankan beberapa panggilan inferensi secara berurutan. Mengurangi latensi respons setiap permintaan dapat mempersingkat waktu eksekusi tugas secara keseluruhan, tetapi hasil akhir juga bergantung pada panggilan alat, transmisi jaringan, dan tahap pemrosesan lainnya.