في 3 نوفمبر 2026، أعلنت AMD عن نتائجها المالية للربع الثالث، حيث بلغت الإيرادات الفصلية $13.377 مليار، بزيادة %45 على أساس سنوي. وبلغت إيرادات مراكز البيانات $8.546 مليار، بزيادة %97 على أساس سنوي. وتتوقع الشركة أن تبلغ إيرادات الربع الرابع نحو $17 مليار، وأكدت أن وحدات معالجة الرسومات Instinct ووحدات المعالجة المركزية EPYC وأنظمة Helios على مستوى الرفوف ستدفع مجتمعة نمو أعمالها في مراكز البيانات. وقد زادت هذه التطورات من اهتمام المستثمرين بما إذا كانت AMD قادرة على الاستحواذ على حصة أكبر من سوق الحوسبة بالذكاء الاصطناعي الذي تهيمن عليه NVIDIA.
ومع ذلك، فإن المنافسة في رقائق الذكاء الاصطناعي لا تقتصر ببساطة على مقارنة أداء منتجات شركتين. إذ يمكن لسعة ذاكرة GPU، ومعدل إنتاجية الاستدلال، وتوافق البرمجيات، والشبكات، واستهلاك الطاقة، وإجمالي تكلفة الملكية أن تؤثر جميعها في قرارات الشراء لدى كبار مزوّدي الخدمات السحابية. يحلل هذا المقال ديناميكيات المنافسة بين AMD وNVIDIA من خلال الخصائص التقنية لاستدلال الذكاء الاصطناعي، وما تعنيه هذه التغيرات لصناعة رقائق الذكاء الاصطناعي والمستثمرين المرتبطين بها في الأسهم الأمريكية.
أبرز النقاط
-
تتوسع المنافسة في رقائق الذكاء الاصطناعي من حوسبة التدريب إلى كفاءة الاستدلال. ومع توسع تطبيقات نماذج اللغة الكبيرة، أصبحت تكاليف الحوسبة وسرعة الاستجابة واستهلاك الطاقة أثناء الاستدلال عوامل مهمة في مشتريات مراكز البيانات.
-
تعمل AMD على توسيع أعمال الذكاء الاصطناعي في مراكز البيانات. ففي الربع الثالث من 2026، بلغت إيرادات مراكز البيانات لدى AMD نحو $8.55 مليار، بزيادة %97 على أساس سنوي، ما دفع إجمالي إيرادات الشركة إلى مستوى قياسي جديد.
-
تمتد الميزة التنافسية لـNVIDIA إلى ما هو أبعد من أجهزة GPU. إذ يوفر نظامها البرمجي CUDA وشبكاتها وأدوات المطورين وأنظمة الرفوف المتكاملة قدرات قوية لتكامل الأنظمة في عمليات نشر بنية الذكاء الاصطناعي التحتية واسعة النطاق.
-
تسعى AMD إلى بناء بديل شامل عبر وحدات GPU من Instinct وHelios وROCm. ويتحول تركيزها التنافسي تدريجيًا من أداء الرقائق الفردية إلى قدرات الحوسبة على مستوى النظام وإجمالي تكلفة الملكية.
-
لا يعني نمو الطلب على استدلال الذكاء الاصطناعي بالضرورة ارتفاع أسهم AMD أو NVIDIA. وينبغي للمستثمرين أيضًا مراقبة قدرات تسليم الرقائق وهوامش الربح والنفقات الرأسمالية للعملاء وتقييمات السوق.
ما هو استدلال الذكاء الاصطناعي؟ وكيف يختلف عن تدريب نماذج الذكاء الاصطناعي؟
يشير استدلال الذكاء الاصطناعي إلى العملية الحاسوبية التي يُنتج فيها نموذج ذكاء اصطناعي مدرّب تنبؤات أو نصوصًا أو صورًا أو مخرجات أخرى استنادًا إلى مدخلات المستخدم. فعلى سبيل المثال، عندما يطرح مستخدم سؤالًا على مساعد ذكاء اصطناعي ويُنشئ النموذج إجابة تدريجيًا بناءً على المدخلات، تُعد هذه العملية استدلالًا. وعلى عكس التدريب، الذي يضبط معلمات النموذج باستمرار، يستخدم الاستدلال القياسي أساسًا معلمات النموذج الحالية لإجراء العمليات الحسابية. ومع ذلك، قد تتضمن بعض أنظمة الاستدلال أيضًا الاسترجاع واستدعاءات الأدوات وخطوات حوسبة إضافية.
تختلف متطلبات التدريب والاستدلال في الذكاء الاصطناعي اختلافًا كبيرًا من حيث موارد الحوسبة. فتدريب النماذج الكبيرة يتطلب عادةً عمل عدد كبير من وحدات GPU معًا على مدى فترات طويلة، ما يفرض متطلبات عالية على أداء الحوسبة وسعة الذاكرة والربط البيني عالي السرعة. أما الاستدلال فيركز بدرجة أكبر على وقت استجابة الطلبات وعدد المهام التي يمكن معالجتها لكل وحدة زمنية وتكلفة الحوسبة المطلوبة لكل طلب. وفي تطبيقات مثل الدردشة الفورية والمساعدات الصوتية، يكون المستخدمون شديدي الحساسية لتأخر الاستجابة. أما في مهام معالجة النصوص دفعة واحدة أو تحليل البيانات، فقد تكون الإنتاجية الإجمالية والتكلفة أكثر أهمية.
| بُعد المقارنة |
تدريب الذكاء الاصطناعي |
استدلال الذكاء الاصطناعي |
| الهدف الأساسي |
تعلم معلمات النموذج وتحسينها |
استخدام النموذج لإنتاج النتائج |
| خصائص الحوسبة |
حوسبة واسعة النطاق وطويلة المدة |
معالجة مستمرة وعالية التواتر للطلبات |
| المقاييس الرئيسية |
سرعة التدريب وكفاءة التوسع |
زمن التأخير والإنتاجية والتكلفة لكل وحدة |
| متطلبات الذاكرة |
المعلمات والتدرجات وحالات التدريب |
أوزان النموذج وKV Cache وغيرها |
| حالات الاستخدام التجاري |
تطوير النماذج الأساسية |
مساعدات الذكاء الاصطناعي والبحث والوكلاء والتطبيقات المؤسسية |
مع توسع تطبيقات الذكاء الاصطناعي، قد تستمر طلبات الاستدلال في النمو. فعلى سبيل المثال، قد يحتاج النموذج إلى عدد محدود فقط من عمليات التدريب واسعة النطاق، لكنه قد يخدم ملايين المستخدمين على مدى فترة طويلة بعد نشره. وهذا يتيح إمكانية أن يصبح الإنفاق التراكمي على الاستدلال مصدرًا رئيسيًا لتكاليف البنية التحتية للذكاء الاصطناعي. ومع ذلك، تختلف نسبة الإنفاق على التدريب إلى الاستدلال بدرجة كبيرة بين النماذج والتطبيقات، لذلك لا يمكن افتراض أن تكاليف الاستدلال ستتجاوز دائمًا تكاليف التدريب.
لماذا أصبح استدلال الذكاء الاصطناعي محورًا للمنافسة بين AMD وNVIDIA؟
يحظى سوق استدلال الذكاء الاصطناعي بالاهتمام أساسًا لأن نماذج أعمال الذكاء الاصطناعي تمتد من المنافسة في قدرات النماذج إلى المنافسة في تكاليف الاستخدام الفعلية. وبالنسبة إلى مزوّدي الخدمات السحابية ومطوري تطبيقات الذكاء الاصطناعي، فإن قدرة النموذج على إتمام المهام ليست سوى متطلب أساسي. كما أن قدرته على تقديم الخدمات باستمرار لعدد كبير من المستخدمين بتكلفة معقولة تحدد أيضًا إمكانية تسويق المنتج. ومع زيادة عدد المستخدمين وتكرار الاستدعاءات، يمكن حتى لانخفاض طفيف في تكلفة كل عملية استدلال أن يؤثر بصورة ملموسة في إجمالي نفقات التشغيل.
لا تتطابق أعباء عمل الاستدلال. فالمحادثات الفورية تتطلب زمن تأخير منخفضًا، وقد تحتاج نماذج الاستدلال المعقدة إلى إنشاء عمليات استدلال طويلة، بينما قد تستدعي وكلاء الذكاء الاصطناعي النماذج وتسترجع البيانات وتنفذ الأدوات عدة مرات ضمن مهمة واحدة. وتختلف متطلبات أعباء العمل هذه من حيث دقة الحوسبة وسعة الذاكرة وعرض نطاق الذاكرة والربط البيني للنظام. وهذا يخلق مجالًا للمنافسة بين بنى الأجهزة المختلفة، ويعني صعوبة تحديد أي رقاقة تتمتع بميزة استنادًا إلى مقياس أداء واحد.
بالنسبة إلى AMD، تكمن أهمية سوق الاستدلال في قدرته على توسيع حصتها في سوق وحدات GPU للذكاء الاصطناعي. ويسعى كبار مزوّدي الخدمات السحابية عادةً إلى تجنب الاعتماد المفرط على مورّد واحد مع التحكم في تكاليف شراء الأجهزة. وإذا تمكنت AMD من تقديم بديل يتوافق من حيث الأداء والتسعير وتوافق البرمجيات وقدرات التسليم، فقد تتمكن من المشاركة في مزيد من خطط شراء مراكز البيانات. ومع ذلك، تواصل NVIDIA أيضًا تحسين منتجات الاستدلال ومنصاتها البرمجية، لذلك لا يعني نمو الطلب على الاستدلال بالضرورة تراجع المركز التنافسي لـNVIDIA.
كيف كان أداء أعمال AMD في مراكز البيانات مؤخرًا؟
تُظهر نتائج AMD للربع الثالث، التي أُعلنت في نوفمبر 2026، أن مراكز البيانات أصبحت أحد أهم مصادر نمو أعمال الشركة. فقد بلغ إجمالي الإيرادات $13.377 مليار، بزيادة %45 على أساس سنوي، فيما بلغت إيرادات مراكز البيانات $8.546 مليار، بزيادة %97 على أساس سنوي. وخلال الفترة نفسها، بلغت الأرباح المعدلة للسهم الواحد وفقًا لمعايير غير GAAP مبلغ $2.09، بزيادة %74 على أساس سنوي، ما يعكس إسهام توسع مراكز البيانات في الربحية الإجمالية.
ومن المهم الإشارة إلى أن أعمال AMD في مراكز البيانات لا تشمل وحدات GPU للذكاء الاصطناعي من Instinct فحسب، بل تشمل أيضًا وحدات المعالجة المركزية للخوادم EPYC. ولذلك، لا ينبغي اعتبار جميع إيرادات مراكز البيانات مباشرةً إيرادات من رقائق الاستدلال بالذكاء الاصطناعي. وينتج نمو أعمال الشركة عن الطلب على مسرّعات الذكاء الاصطناعي والطلب على الحوسبة العامة للخوادم معًا. وبالنسبة إلى المستثمرين، يتطلب تحديد ما إذا كانت AMD توسع بالفعل حصتها في سوق وحدات GPU للذكاء الاصطناعي متابعة إضافية لشحنات المنتجات وعمليات نشر العملاء والمزيج المحدد للأعمال.
كما تتوقع AMD إيرادات إجمالية تقارب $17 مليار في الربع الرابع من 2026، مواصلةً النمو مقارنة بالربع الثالث. وتعمل الشركة أيضًا على دفع عمليات نشر أنظمة Helios على مستوى الرفوف وتوسيع التعاون مع كبار مزوّدي الخدمات السحابية وشركات الذكاء الاصطناعي. وتشير هذه التطورات إلى أن AMD تسعى للتحول من مورّد للرقائق إلى مزوّد أكثر شمولًا للبنية التحتية للذكاء الاصطناعي. ومع ذلك، فإن قدرة الإيرادات المستقبلية على مواصلة النمو لا تزال تعتمد على مشتريات العملاء وسلاسل التوريد وقدرة المنتجات التنافسية.
ما أوجه الاختلاف بين AMD Instinct ووحدات GPU من NVIDIA في استدلال الذكاء الاصطناعي؟
يمكن لكل من وحدات GPU للذكاء الاصطناعي من AMD وNVIDIA دعم مهام تدريب النماذج والاستدلال، لكن الشركتين تختلفان في خطط المنتجات والأنظمة البرمجية وأساليب تكامل الأنظمة. تستهدف سلسلة Instinct من AMD بصورة أساسية الحوسبة عالية الأداء وتسريع الذكاء الاصطناعي في مراكز البيانات، بينما بنت NVIDIA إطارًا أكثر شمولًا للحوسبة بالذكاء الاصطناعي من خلال وحدات GPU لمراكز البيانات ومنصة CUDA البرمجية وتقنيات الشبكات الداعمة.
بالنسبة إلى مهام الاستدلال، لا يمثل الأداء الحسابي النظري لوحدة GPU سوى معيار تقييم واحد. إذ تحتاج النماذج إلى الوصول المتكرر إلى الأوزان والبيانات الوسيطة، ما يجعل سعة الذاكرة وعرض نطاقها وإدارة ذاكرة التخزين المؤقت عوامل بالغة الأهمية أيضًا. وتساعد سعة الذاكرة الأكبر على استيعاب معلمات النموذج وKV Cache الناتجة عن مزيد من الطلبات المتزامنة، بينما يمكن لعرض نطاق الذاكرة الأعلى تقليل اختناقات الوصول إلى البيانات في بعض مهام الاستدلال. لكن الفوائد المحددة تعتمد على حجم النموذج ودقة التكميم واستراتيجية التجميع ومستوى تحسين البرمجيات.
تكمن ميزة NVIDIA في قدراتها على تنسيق الأجهزة والبرمجيات. فإلى جانب وحدات GPU، تقدم NVIDIA منصة CUDA وTensorRT-LLM وأطر خدمة الاستدلال وتقنيات الربط البيني عالي السرعة، ما يتيح للمطورين نشر أعباء عمل الذكاء الاصطناعي بالاعتماد على سلسلة أدوات ناضجة نسبيًا. وفي المقابل، تعمل AMD على تحسين التوافق وأداء النظام عبر ROCm ووحدات GPU من Instinct وأنظمة Helios، بهدف تقليل تكاليف الترحيل للعملاء الذين يتبنون أجهزة بديلة.
| بُعد المقارنة |
AMD |
NVIDIA |
| مسرّعات الذكاء الاصطناعي |
سلسلة Instinct |
سلسلة GPU لمراكز البيانات |
| النظام البرمجي |
ROCm |
CUDA |
| الحلول على مستوى النظام |
Helios |
منصات على مستوى الرفوف مثل NVL |
| التركيز التنافسي الأساسي |
النظام المفتوح والتكلفة والأداء |
نضج البرمجيات وتكامل الأنظمة |
| تركيز تحسين الاستدلال |
سعة الذاكرة والإنتاجية ومواءمة البرمجيات |
زمن التأخير والإنتاجية وتنسيق الأجهزة والبرمجيات |
| التحديات الرئيسية |
توافق النظام البيئي ونضج النشر |
تكاليف النظام وتركيز مورّدي العملاء |
من المهم التأكيد على أن المقارنة أعلاه تعكس تموضع المنتجات والأنظمة البيئية، وليس تصنيفًا عالميًا للأداء. فقد تؤدي وحدات GPU المختلفة أداءً متباينًا بشكل كبير في ظل نماذج ومستويات دقة وظروف نشر مختلفة. ولا يمكن تحديد كفاءة الاستدلال الفعلية بالاعتماد فقط على سعة الذاكرة أو الأداء الحسابي النظري.
لماذا تؤثر CUDA وROCm في المشهد التنافسي لرقائق الذكاء الاصطناعي؟
CUDA هي منصة الحوسبة المتوازية التي طورتها NVIDIA على مدى طويل، بينما ROCm هي منصة AMD البرمجية لحوسبة GPU وأعباء عمل الذكاء الاصطناعي. وتوفر كلتاهما أدوات تطوير ومكتبات حوسبة وبيئات تشغيل تمكّن المطورين من استخدام وحدات GPU لمهام الحوسبة المعقدة. وبالنسبة إلى شركات الذكاء الاصطناعي الكبيرة، فإن اختيار وحدات GPU يتجاوز شراء الأجهزة، إذ يتعلق أيضًا بما إذا كان بإمكان شفرة النماذج الحالية وأطر التدريب ومحركات الاستدلال وأنظمة التشغيل العمل بصورة موثوقة.
تأتي الميزة التنافسية لـCUDA من نظامها البرمجي الراسخ منذ مدة طويلة. فقد جرى بالفعل تكييف العديد من نماذج الذكاء الاصطناعي وأدوات التطوير وتحسينها لوحدات GPU من NVIDIA، لذلك يمكن للشركات التي تستخدم أجهزة NVIDIA أن تقلل غالبًا بعض أعمال الترحيل وتصحيح الأخطاء. ولا سيما في بيئات المجموعات واسعة النطاق، يمكن لاستقرار البرمجيات وأدوات تحليل الأداء والدعم الفني أن تؤثر مباشرةً في معدل استخدام موارد الحوسبة.
تعمل AMD على تحسين تجربة المطورين ودعم أطر الذكاء الاصطناعي الرئيسية من خلال ROCm. وفي الربع الثالث من 2026، أطلقت AMD إصدار ROCm 10، معززةً أدوات التطوير والمترجمات ومكتبات الحوسبة ودعم النماذج ذات الصلة. وتساعد هذه التحسينات على توسيع نطاق تطبيقات وحدات GPU من AMD، لكن إصدار نسخة جديدة لا يعني أن جميع تطبيقات CUDA يمكن ترحيلها إلى ROCm دون تعديل.
ومن المنظور التجاري، يؤثر توافق البرمجيات في إجمالي تكلفة الملكية الفعلية لوحدات GPU. فإذا اشترت شركة مسرّعات منخفضة السعر لكنها اضطرت إلى استثمار موارد هندسية كبيرة لإعادة تحسين النماذج، فقد تُقابل وفورات تكلفة الأجهزة في النهاية بتكاليف التطوير. ولذلك، لا تجري المنافسة بين AMD وNVIDIA على مستوى الرقائق فحسب، بل تشمل أيضًا أنظمة المطورين وأطر الاستدلال وكفاءة نشر الأنظمة.
كيف يغير AMD Helios المنافسة على مستوى النظام مع NVIDIA؟
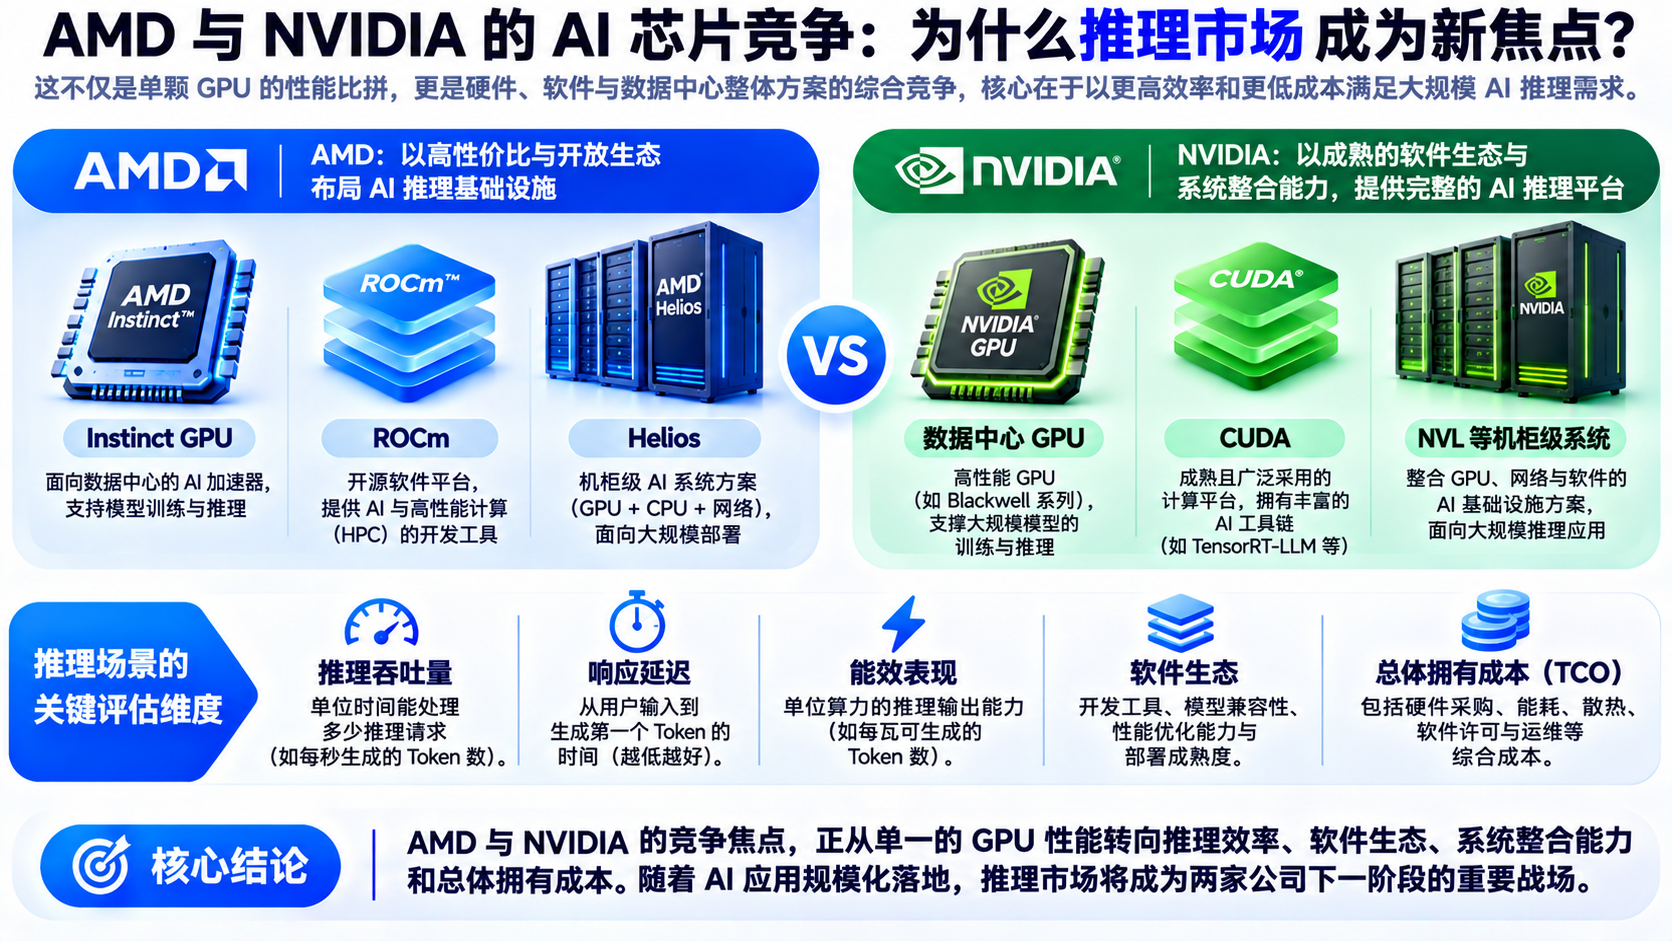
Helios هي منصة الحوسبة من AMD على مستوى الرفوف لمراكز بيانات الذكاء الاصطناعي الكبيرة. وهي تجمع بين وحدات GPU من Instinct ووحدات المعالجة المركزية EPYC وروابط الشبكات البينية ومكونات البرمجيات ذات الصلة، لتوفر للعملاء نظام حوسبة أكثر اكتمالًا للذكاء الاصطناعي. وبالمقارنة مع شراء وحدات GPU منفصلة ثم دمج الأنظمة، يمكن للحلول على مستوى الرفوف تحسين تصميم الحوسبة والاتصالات والنشر ضمن بنية موحدة.
يعكس هذا التحول كيفية امتداد المنافسة في البنية التحتية للذكاء الاصطناعي من الرقائق الفردية إلى أنظمة الحوسبة الكاملة. فتدريب النماذج الكبيرة والاستدلال يتطلبان عادةً عمل عدة وحدات GPU معًا. ويمكن لسرعات نقل البيانات بين وحدات GPU والربط البيني داخل الخوادم وطوبولوجيا الشبكة وقدرات التبريد أن تؤثر جميعها في الكفاءة الإجمالية. وحتى إذا كانت الرقاقة الفردية تتمتع بأداء حوسبة مرتفع، فقد تظل إنتاجية المجموعة الفعلية مقيدة إذا أصبحت اتصالات النظام عنق زجاجة.
أنشأت NVIDIA بالفعل تشكيلة منتجات متكاملة نسبيًا عبر أنظمة الذكاء الاصطناعي على مستوى الرفوف، بينما تهدف AMD إلى تقديم خيار آخر من خلال Helios. وفي أحدث إعلان لأرباحها، ذكرت AMD أن عملاء من بينهم Anthropic وMeta وMicrosoft وOpenAI وOracle Cloud Infrastructure يشغّلون نماذج أو أعباء عمل تستند إلى حلول Helios الأولى. وتشير عمليات النشر هذه إلى أن AMD تدفع طرح المنتجات على مستوى النظام، لكن حجم نشر كل عميل ومبلغ مشترياته ومرحلة التسويق لا تزال بحاجة إلى تقييم منفصل.
بالنسبة إلى كبار مزوّدي الخدمات السحابية، يمكن أن يؤدي وجود عدة مورّدين تنافسيين لأنظمة الذكاء الاصطناعي إلى زيادة مرونة المشتريات وتقليل مخاطر تركّز سلسلة التوريد. لكن المنافسة على مستوى النظام تفرض أيضًا متطلبات أعلى على AMD، بما في ذلك توريد الرقائق وروابط الشبكات البينية واستقرار البرمجيات ونشر الرفوف والصيانة طويلة الأجل.
لماذا تُعد تكاليف استدلال الذكاء الاصطناعي أهم من أداء وحدات GPU الفردية؟
تعتمد القيمة التجارية لاستدلال الذكاء الاصطناعي في النهاية على إمكانية تقديم الخدمات باستمرار بتكلفة مقبولة. وبالنسبة إلى منصات الذكاء الاصطناعي التي تعالج أعدادًا كبيرة من الطلبات يوميًا، فإن أسعار شراء وحدات GPU ليست سوى جزء من التكلفة. إذ يمكن لمعدل استخدام الخوادم واستهلاك الطاقة والتبريد والشبكات والصيانة وكفاءة تشغيل النموذج أن تؤثر جميعها في إجمالي الإنفاق.
على سبيل المثال، افترض أن تكاليف شراء نظامي GPU تبلغ $1 مليون و$1.2 مليون على التوالي. فإذا كان النظام الأخير قادرًا على معالجة مزيد من الطلبات عند مستوى جودة الخدمة نفسه أو خفض استهلاك الطاقة لكل عملية استدلال بشكل ملحوظ، فقد تظل تكلفة الاستدلال طويلة الأجل لكل عملية فيه أقل رغم ارتفاع سعره. وعلى العكس، إذا كان النظام يتمتع بأداء نظري مرتفع لكن التطبيقات الواقعية لا تستطيع الاستفادة الكاملة من موارده المادية، فقد لا يحقق جدواه الاقتصادية المتوقعة.
لذلك، عند تقييم رقائق استدلال الذكاء الاصطناعي، من المهم النظر في مقاييس مثل عدد الرموز التي يتم إنشاؤها في الثانية، والوقت حتى أول رمز، وقدرة الطلبات المتزامنة، وتكلفة المعالجة الفعلية لكل مليون رمز. وتولي النماذج وأعباء العمل المختلفة درجات متفاوتة من الأهمية لهذه المقاييس. فعلى سبيل المثال، تعطي التفاعلات الصوتية الفورية الأولوية لزمن التأخير، بينما قد يركز تحليل المستندات دفعة واحدة بدرجة أكبر على الإنتاجية وتكلفة الوحدة.
يعني هذا التحول أن AMD ليست بحاجة بالضرورة إلى التفوق على NVIDIA في كل مقياس أداء لاكتساب فرص سوقية. فما دامت منتجاتها قادرة على توفير تكاليف وأداء تنافسيين لأعباء عمل محددة، مع تلبية متطلبات العملاء للاستقرار والدعم البرمجي، فقد تصبح بدائل قابلة للتطبيق. وبالمثل، تستطيع NVIDIA الحفاظ على قدرتها التنافسية عبر تحسين البرمجيات وكفاءة النظام بدلًا من الاعتماد فقط على أداء نظري أعلى للرقائق.
كيف ستؤثر المنافسة في سوق استدلال الذكاء الاصطناعي في تقييمات أسهم AMD وNVIDIA؟
تُعد AMD وNVIDIA من الشركات المدرجة المهمة في صناعة أشباه الموصلات الأمريكية، لكن المستثمرين لا يطبقون منطق التقييم نفسه تمامًا على الشركتين. فقد بنت NVIDIA بالفعل أعمال حوسبة بالذكاء الاصطناعي واسعة النطاق ونظامًا بيئيًا ناضجًا نسبيًا للأجهزة والبرمجيات، ويركز السوق عمومًا على مدى قدرتها على الحفاظ على حجم الإيرادات وهوامش الربح والمزايا التقنية. وفي المقابل، تمتلك AMD فرصة لتوسيع حصتها في سوق الذكاء الاصطناعي، ولذلك يركز المستثمرون أكثر على ما إذا كان نشر المنتجات الجديدة وطلبات العملاء ونمو الإيرادات يمكن أن يتحول إلى ربحية مستدامة.
قد يفيد توسع سوق استدلال الذكاء الاصطناعي عدة مورّدي رقائق في الوقت نفسه، لكن نمو الطلب في السوق لا يعني أن أرباح كل شركة سترتفع بصورة متناسبة. ومع اشتداد المنافسة، قد تتغير أسعار المنتجات والقوة التفاوضية للعملاء والاستثمارات في البحث والتطوير. وإذا خفضت الشركات الأسعار لاكتساب حصة سوقية أو احتاجت إلى تخصيص مزيد من الموارد لدعم عمليات نشر العملاء، فقد لا يحقق نمو الإيرادات المستوى نفسه من نمو الأرباح.
إضافة إلى ذلك، تعتمد أسعار الأسهم على مقدار توقعات النمو التي سبق للسوق أن سعّرها. وحتى إذا أعلنت شركة نتائج مالية قوية، فقد يظل سعر سهمها تحت الضغط إذا كان المستثمرون يتوقعون أكثر. وعلى العكس، إذا تجاوزت التسليمات الفعلية للشركة أو هوامش ربحها أو توقعاتها المستقبلية التوقعات، فقد يعيد السوق تقييم قيمتها. لذلك، يتطلب تقييم القيمة الاستثمارية لـAMD وNVIDIA أكثر من مقارنة أي وحدة GPU تتمتع بأداء أقوى. كما يتطلب النظر في مزيج الإيرادات والربحية والنفقات الرأسمالية والبيئة التنافسية ومضاعفات التقييم.
ما مؤشرات سوق استدلال الذكاء الاصطناعي التي ينبغي للمستثمرين متابعتها؟
يمكن للمستثمرين الذين يسعون إلى فهم تحركات أسهم رقائق الذكاء الاصطناعي مراقبة تغيرات السوق من ثلاثة منظورات. الأول هو الطلب، ويشمل النفقات الرأسمالية للذكاء الاصطناعي لدى كبار مزوّدي الخدمات السحابية واستخدام خدمات الاستدلال وعمليات النشر الفعلية لدى عملاء المؤسسات. ويمكن أن تساعد هذه المؤشرات في تحديد ما إذا كان الطلب على قدرة الحوسبة بالذكاء الاصطناعي يواصل التوسع، لكن خطط النفقات الرأسمالية لا تعادل إيرادات مؤكدة لمصنّعي الرقائق.
والثاني هو العرض، ويشمل أحجام تسليم وحدات GPU وإمدادات الذاكرة عالية النطاق الترددي (HBM) وقدرة التغليف المتقدم وتقدم نشر الأنظمة. وحتى عندما يكون الطلب في السوق قويًا، قد لا يتمكن مصنّعو الرقائق من إكمال عمليات التسليم وفقًا للخطة إذا كانت إمدادات المكونات الأساسية غير كافية. وتعتمد كل من AMD وNVIDIA على سلاسل توريد معقدة لأشباه الموصلات، لذلك قد تؤثر قيود العرض في وتيرة نمو الشركتين.
أما المجال الأخير فهو مقاييس الربحية والتقييم. ويمكن للمستثمرين متابعة إيرادات مراكز البيانات والهامش الإجمالي وهامش التشغيل والتدفق النقدي الحر والتغيرات في توقعات السوق، ثم استخدام نسب السعر إلى الأرباح أو مضاعفات الأرباح المستقبلية لتقييم مدى معقولية تسعير الأسهم. ومن المهم بشكل خاص التمييز بين النتائج المالية التي تحققت بالفعل والتوجيهات المستقبلية للإدارة، وتجنب التعامل مع الطلبات غير المنفذة أو توقعات النمو بوصفها إيرادات مؤكدة.
الملخص
تتوسع المنافسة بين AMD وNVIDIA في رقائق الذكاء الاصطناعي من مقارنة محضة لأداء الحوسبة إلى كفاءة الاستدلال والأنظمة البرمجية وأنظمة الرفوف وإجمالي تكلفة الملكية. ومع دخول تطبيقات الذكاء الاصطناعي مرحلة النشر على نطاق واسع، لا تحتاج مراكز البيانات إلى قدرات حوسبة أقوى فحسب، بل إلى القدرة على معالجة كميات كبيرة من طلبات المستخدمين باستمرار بتكاليف أكثر معقولية.
يشير النمو السريع لأعمال AMD في مراكز البيانات خلال الربع الثالث من 2026، إلى جانب التطوير المستمر لـInstinct وROCm وHelios، إلى أنها توسع أعمال البنية التحتية للذكاء الاصطناعي. ومع ذلك، تحتفظ NVIDIA بمزايا مهمة في CUDA وتكامل الأنظمة ونظام المطورين البيئي. وستعتمد نتيجة المنافسة المستقبلية على تسليم المنتجات والأداء في العالم الحقيقي واعتماد العملاء والربحية التجارية، بدلًا من مقياس تقني واحد من جيل واحد من الرقائق.
بالنسبة إلى مستثمري الأسهم، يقدم سوق استدلال الذكاء الاصطناعي منظورًا جديدًا لمراقبة صناعة أشباه الموصلات، لكن القدرة التنافسية التقنية وعوائد الاستثمار في الأسهم ليسا متكافئين بصورة مباشرة. ويوفر تحليل طلب الصناعة وربحية الشركات وتقييمات السوق معًا فهمًا أكثر شمولًا للمشهد التنافسي بين AMD وNVIDIA.
الأسئلة الشائعة
ما هو استدلال الذكاء الاصطناعي؟
استدلال الذكاء الاصطناعي هو عملية استخدام نموذج ذكاء اصطناعي مدرّب لمعالجة المدخلات وإنشاء المخرجات، مثل الدردشة بالذكاء الاصطناعي وإنشاء الصور والتعرف على الكلام والمهام التي تؤديها المساعدات الذكية.
لماذا أصبح سوق استدلال الذكاء الاصطناعي أكثر أهمية؟
مع زيادة عدد مستخدمي تطبيقات الذكاء الاصطناعي وتكرار الاستخدام، يتعين على الشركات تحمل تكاليف حوسبة استدلال كبيرة باستمرار. ونتيجة لذلك، أصبحت سرعة الاستدلال والإنتاجية واستهلاك الطاقة وتكاليف الوحدة أكثر أهمية.
هل يمكن لوحدات GPU للذكاء الاصطناعي من AMD أن تحل محل NVIDIA؟
يمكن لوحدات GPU من AMD أن تكون بديلًا لـNVIDIA في بعض النماذج المدعومة وسيناريوهات التطبيقات. ومع ذلك، تعتمد الجدوى الفعلية على توافق البرمجيات والأداء وتكاليف النشر ومتطلبات العملاء. ولا ينبغي اعتبارهما متكافئتين تمامًا في كل سيناريو.
ما الفرق بين CUDA وROCm؟
CUDA هي منصة الحوسبة المتوازية لوحدات GPU من NVIDIA، بينما ROCm هي منصة AMD البرمجية لحوسبة GPU. وتدعم كلتاهما الحوسبة بالذكاء الاصطناعي، لكنهما تختلفان في أدوات التطوير ونضج النظام البيئي والتوافق المحدد.
ما هو AMD Helios؟
Helios هي منصة الحوسبة بالذكاء الاصطناعي من AMD على مستوى الرفوف، والتي تدمج وحدات GPU ووحدات المعالجة المركزية والربط البيني ومكونات البرمجيات لأعباء عمل تدريب الذكاء الاصطناعي والاستدلال في مراكز البيانات الكبيرة.
هل يعني نمو الطلب على استدلال الذكاء الاصطناعي أن أسهم AMD سترتفع بالتأكيد؟
ليس بالضرورة. فتتأثر أسعار الأسهم ليس فقط بنمو الأعمال، بل أيضًا بالربحية والمشهد التنافسي وسلاسل التوريد وتوقعات السوق وتقييمات الأسهم.