


runesleo

用戶暫無簡介
我過去一週一直在認真玩 @projectmars_rh,最後為它建立了一個中文玩家中心。
目前裡面有「從這裡開始」指南、FAQ、P&L/Rig/Ore/Plot/Epoch 工具,以及唯讀錢包輔助工具。不需要連接錢包,也不需要簽署。
我也申請了 Project Mars 創作者計畫,但目前還沒有收到回覆,也無法透過 X 私訊聯絡團隊。
我很樂意協助製作中文指南、開發工具、提供在地化回饋,以及協助社群新手入門。我們已經有一個活躍的中文玩家社群,正在遊玩並討論這款遊戲。
希望團隊能看看 🙏
目前裡面有「從這裡開始」指南、FAQ、P&L/Rig/Ore/Plot/Epoch 工具,以及唯讀錢包輔助工具。不需要連接錢包,也不需要簽署。
我也申請了 Project Mars 創作者計畫,但目前還沒有收到回覆,也無法透過 X 私訊聯絡團隊。
我很樂意協助製作中文指南、開發工具、提供在地化回饋,以及協助社群新手入門。我們已經有一個活躍的中文玩家社群,正在遊玩並討論這款遊戲。
希望團隊能看看 🙏
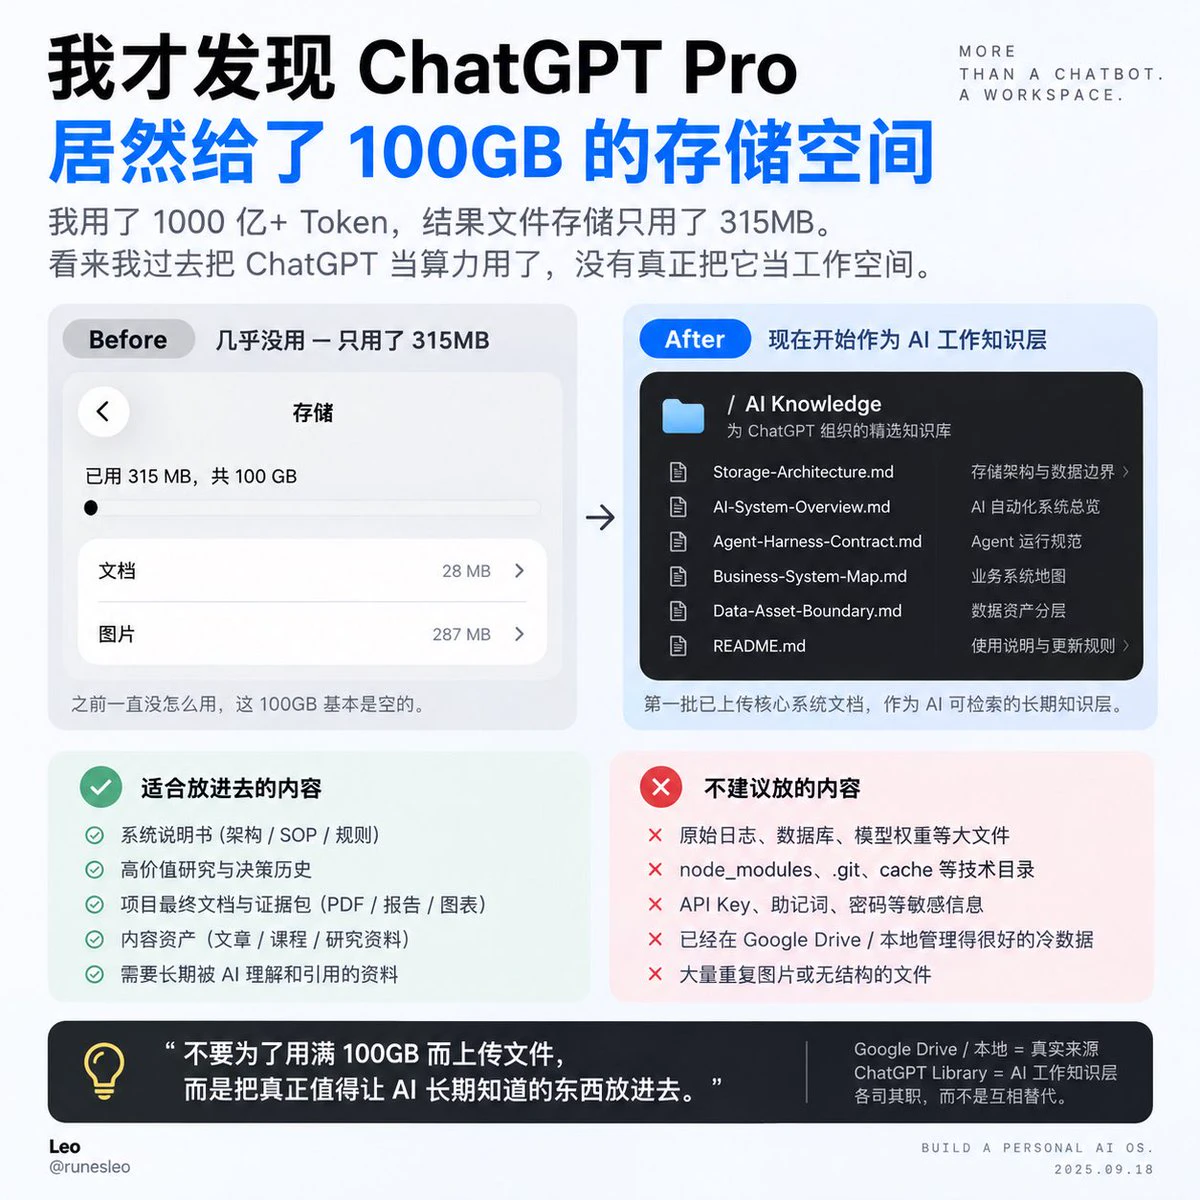
今天才發現,ChatGPT Pro 原來給了 100GB 文件空間。
我用了這麼久,居然只佔了 315MB。
這一下讓我意識到:過去我一直把 ChatGPT 當「算力」和「對話框」在用,卻沒有真正把它當成長期工作空間。
所以我重新整理了一遍自己的 AI 儲存架構:
Mac:執行
本地大盤:原始資料/冷歸檔
Google Drive:人類可編輯的正式文件
ChatGPT Library:AI 長期可讀、可檢索、可複用的知識層
重點不是把 100GB 填滿。
而是把真正值得讓 AI 長期知道的東西,放進一個它隨時能調用的位置。
今天已經開始把這層搭起來了。
越來越覺得,未來個人 AI 系統的差距,不只在模型,而在「上下文有沒有真正累積下來」。
我用了這麼久,居然只佔了 315MB。
這一下讓我意識到:過去我一直把 ChatGPT 當「算力」和「對話框」在用,卻沒有真正把它當成長期工作空間。
所以我重新整理了一遍自己的 AI 儲存架構:
Mac:執行
本地大盤:原始資料/冷歸檔
Google Drive:人類可編輯的正式文件
ChatGPT Library:AI 長期可讀、可檢索、可複用的知識層
重點不是把 100GB 填滿。
而是把真正值得讓 AI 長期知道的東西,放進一個它隨時能調用的位置。
今天已經開始把這層搭起來了。
越來越覺得,未來個人 AI 系統的差距,不只在模型,而在「上下文有沒有真正累積下來」。
- 1
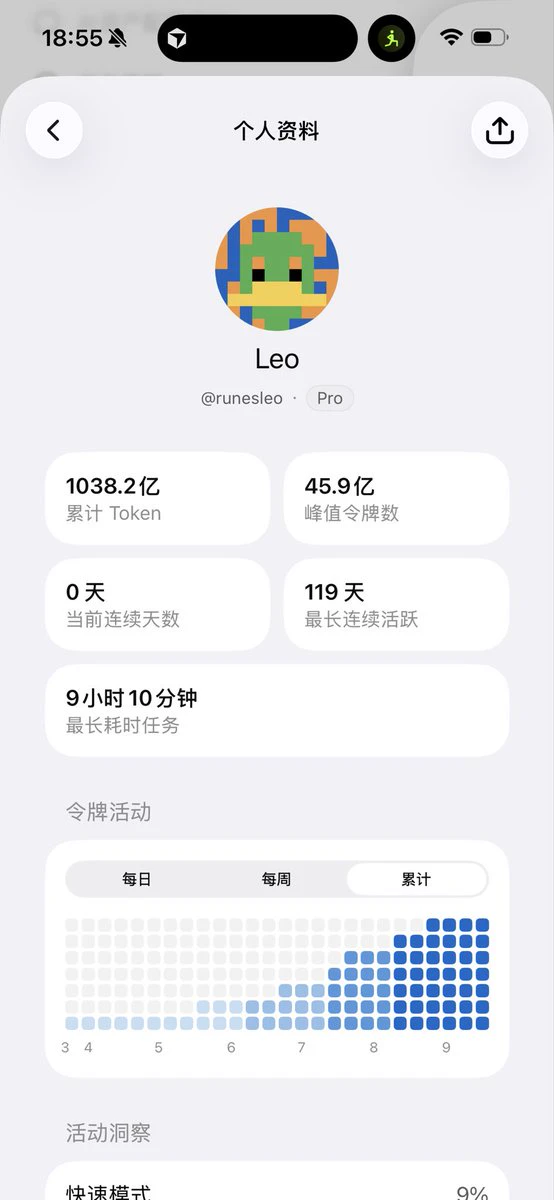
搞 AI 和 vibe coding 這麼久,今天第一次認真查看自己的 Codex 使用統計:
累計 Token:1038.2 億
單日峰值:45.9 億
最長連續使用:119 天
數字比我想像中誇張得多。
但更值得盤點的其實不是燒了多少 Token,而是這些 Token 最後到底變成了什麼。
最近準備把我現在已經跑起來的 AI 自動化系統完整盤一遍:
研究、監控、交易輔助、內容生產、多裝置遠端執行、Agent 工作流程……
也順便看看,哪些是真正的自動化,哪些只是把人工步驟包裝得更複雜了。
累計 Token:1038.2 億
單日峰值:45.9 億
最長連續使用:119 天
數字比我想像中誇張得多。
但更值得盤點的其實不是燒了多少 Token,而是這些 Token 最後到底變成了什麼。
最近準備把我現在已經跑起來的 AI 自動化系統完整盤一遍:
研究、監控、交易輔助、內容生產、多裝置遠端執行、Agent 工作流程……
也順便看看,哪些是真正的自動化,哪些只是把人工步驟包裝得更複雜了。
- 2
- 2
前幾天 Arc 主網上線前,我買了三個幣:
$ARGUS 、 $TOLLY 、 $COOL 。
當時我的邏輯很簡單:
ARGUS = Launchpad / 增長龍頭
TOLLY = 平台價值捕獲
COOL = Arc 原生文化 Meme
現在主網上線兩天,三個幣都從高點大幅回撤了。
但我重新把數據拉了一遍以後,暫時沒有改變這個判斷。
反而出現了一個挺有意思的背離:
幣價跌了,基本面數據卻比買入時更清楚了。
Arc Mainnet Day 1 的確很瘋狂。
首日大約 776 萬筆交易,Uniswap 交易量超過 4.1 億美元。
現在全鏈 24h DEX 交易量已經回到約 1.35 億美元,和第一天的極端高峰相比降了接近 70%。
但與此同時:
Arc TVL 仍有約 $340M
穩定幣仍有約 $656M
USDC 佔比接近 99%
Morpho + Aave 兩個 Lending 協議就壓著超過 $300M TVL。
所以我現在更傾向於把 Day 1 理解成一次流動性啟動,而不是 Arc 全部的故事。
真正需要驗證的是,Meme / Launchpad 把第一批使用者和資金帶進來以後,這些錢能不能慢慢遷移到 Lending、支付、FX、RWA 和 Agent Economy。
再看我持有的兩個平台幣。
$TOLLY 從約 $0.0205 的 ATH 回撤到了 $0.005–0.
$ARGUS 、 $TOLLY 、 $COOL 。
當時我的邏輯很簡單:
ARGUS = Launchpad / 增長龍頭
TOLLY = 平台價值捕獲
COOL = Arc 原生文化 Meme
現在主網上線兩天,三個幣都從高點大幅回撤了。
但我重新把數據拉了一遍以後,暫時沒有改變這個判斷。
反而出現了一個挺有意思的背離:
幣價跌了,基本面數據卻比買入時更清楚了。
Arc Mainnet Day 1 的確很瘋狂。
首日大約 776 萬筆交易,Uniswap 交易量超過 4.1 億美元。
現在全鏈 24h DEX 交易量已經回到約 1.35 億美元,和第一天的極端高峰相比降了接近 70%。
但與此同時:
Arc TVL 仍有約 $340M
穩定幣仍有約 $656M
USDC 佔比接近 99%
Morpho + Aave 兩個 Lending 協議就壓著超過 $300M TVL。
所以我現在更傾向於把 Day 1 理解成一次流動性啟動,而不是 Arc 全部的故事。
真正需要驗證的是,Meme / Launchpad 把第一批使用者和資金帶進來以後,這些錢能不能慢慢遷移到 Lending、支付、FX、RWA 和 Agent Economy。
再看我持有的兩個平台幣。
$TOLLY 從約 $0.0205 的 ATH 回撤到了 $0.005–0.
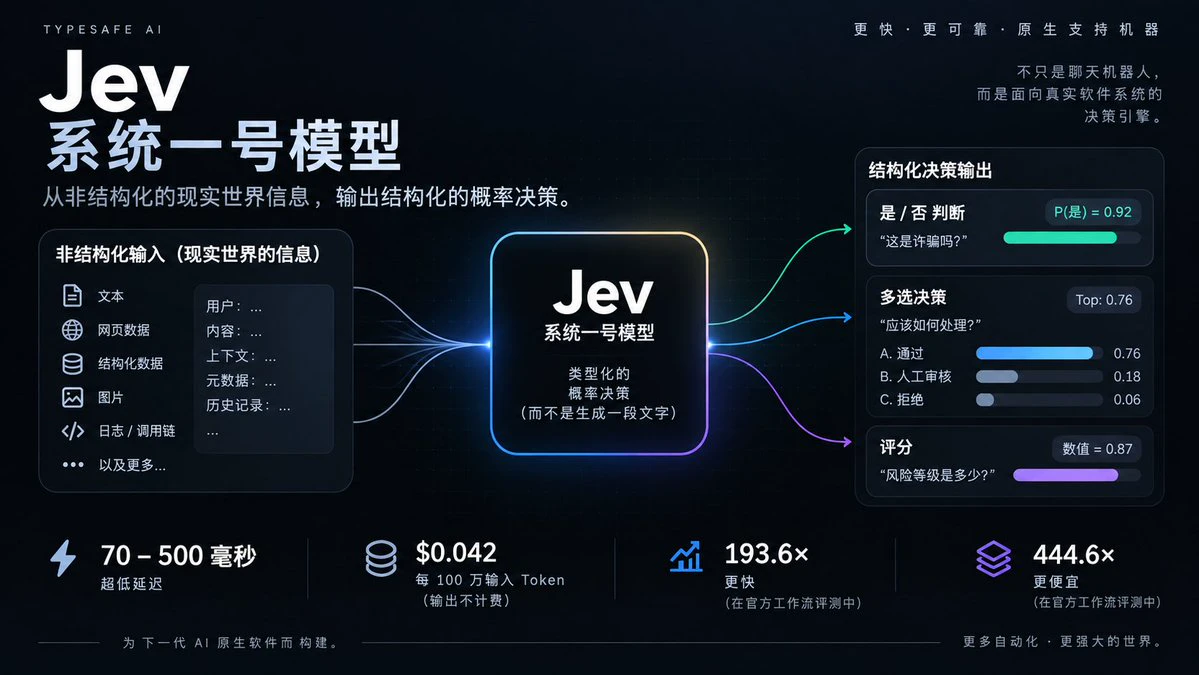
這兩天 AI 圈有個新模型 Jev,我覺得值得單獨看一下。
它最反直覺的地方,不是 benchmark 又高了多少,而是它根本不想做一個「更會聊天」的 LLM。
@typesafeai 的思路是:
很多軟體任務根本不需要模型「生成一段話」。
現在大量 AI workflow 實際上是:
state → LLM → 生成文字 / JSON → parse → validate → retry → 程式再決定下一步
但軟體內部真正需要 AI 回答的,經常只是:
這是詐騙嗎?
應該 route 給哪個 agent?
continue / retry / stop?
risk 是 low / medium / high?
這個判斷的機率是多少?
Jev 把介面直接收縮成:
unstructured state → typed probabilistic decisions
不寫文章,不聊天。
直接返回 Boolean / Choice / Score + probability。
TypeSafe 把這類模型叫做 System One Model,訓練方法叫 RLCD(Reinforcement Learning for Calibrated Decisions)。
官方給出的數字也很誇張:
70–500ms latency
$0.042 / 100 萬輸入 token
workflow
它最反直覺的地方,不是 benchmark 又高了多少,而是它根本不想做一個「更會聊天」的 LLM。
@typesafeai 的思路是:
很多軟體任務根本不需要模型「生成一段話」。
現在大量 AI workflow 實際上是:
state → LLM → 生成文字 / JSON → parse → validate → retry → 程式再決定下一步
但軟體內部真正需要 AI 回答的,經常只是:
這是詐騙嗎?
應該 route 給哪個 agent?
continue / retry / stop?
risk 是 low / medium / high?
這個判斷的機率是多少?
Jev 把介面直接收縮成:
unstructured state → typed probabilistic decisions
不寫文章,不聊天。
直接返回 Boolean / Choice / Score + probability。
TypeSafe 把這類模型叫做 System One Model,訓練方法叫 RLCD(Reinforcement Learning for Calibrated Decisions)。
官方給出的數字也很誇張:
70–500ms latency
$0.042 / 100 萬輸入 token
workflow
- 1
推薦一集播客:Web3 101 E83《關於比特幣面臨的量子威脅,我們需要了解的事》
簡單說:量子電腦將來可能利用你公開過的「金鑰資訊」,推導出私鑰,把幣轉走。挖礦不是重點,錢包地址類型才是。
尤其是玩過銘文、符文、地址特別多的人。以 bc1p 開頭的地址,金鑰資訊本來就在鏈上;地址反覆使用,也會把金鑰資訊暴露出來。相對更穩妥的是沒用過的 bc1q,而且一個地址不要反覆使用。
我用 AI 掃了一遍自己以前玩銘文留下的地址清單,發現不少 bc1p,還有少量反覆使用過的地址裡仍有幣。
不用慌,也別急著買各種「抗量子」產品。先把地址盤點清楚,有風險的轉移到全新、沒用過的 bc1q。
簡單說:量子電腦將來可能利用你公開過的「金鑰資訊」,推導出私鑰,把幣轉走。挖礦不是重點,錢包地址類型才是。
尤其是玩過銘文、符文、地址特別多的人。以 bc1p 開頭的地址,金鑰資訊本來就在鏈上;地址反覆使用,也會把金鑰資訊暴露出來。相對更穩妥的是沒用過的 bc1q,而且一個地址不要反覆使用。
我用 AI 掃了一遍自己以前玩銘文留下的地址清單,發現不少 bc1p,還有少量反覆使用過的地址裡仍有幣。
不用慌,也別急著買各種「抗量子」產品。先把地址盤點清楚,有風險的轉移到全新、沒用過的 bc1q。
BTC-1.15%
- 1
最近我終於想明白,我要做的不是一個「鏈上新幣監控」,而是一套個人機會操作系統。
最開始,我以為問題只是:為什麼某隻後來暴漲、進入熱榜的幣,我的監控沒有及時看到?
但把整條鏈路剝開以後才發現,真正需要優化的不是某一個幣、某一個榜單,甚至也不是簡單多加幾個數據源,而是從發現到結果的整個系統。
我想要的流程是:
多鏈、Launchpad、專案動態、社交、熱榜、聰明錢和市場異動,先進入原始發現層,保留全局最早的 first_seen。
然後完成身分歸一、風險初篩、持續追蹤、研究、執行路徑和賠率判斷。只有真正值得我注意的狀態變化,才推送給我。
如果買了,還要繼續進入持倉監控、加減倉、退出和最終結果復盤。
我不想等一個資產漲了 10 倍、進入所有熱榜以後,系統才告訴我:「它火了。」
我真正想知道的是:
它最早什麼時候出現?
為什麼開始加速?
第一次沒有參與的條件,後來有沒有發生變化?
如果最終錯過,到底是沒發現、發現晚、身分沒對上、被過濾、沒研究、沒提醒、沒執行,還是持倉管理出了問題?
而且不能只復盤贏家。
每一個後來跑出來的資產,都要和同期、同鏈、同估值、當時看起來相似但最終失敗的樣本放在一起比較。
否則所謂的「AI 學習」,很容易只是看到結果以後,重新編一個聽起來合理的故事。
所以接下來,我不會再給每一隻漏掉的幣單獨加一個 watcher。
我要做的是把全局 first_seen、身分圖、
最開始,我以為問題只是:為什麼某隻後來暴漲、進入熱榜的幣,我的監控沒有及時看到?
但把整條鏈路剝開以後才發現,真正需要優化的不是某一個幣、某一個榜單,甚至也不是簡單多加幾個數據源,而是從發現到結果的整個系統。
我想要的流程是:
多鏈、Launchpad、專案動態、社交、熱榜、聰明錢和市場異動,先進入原始發現層,保留全局最早的 first_seen。
然後完成身分歸一、風險初篩、持續追蹤、研究、執行路徑和賠率判斷。只有真正值得我注意的狀態變化,才推送給我。
如果買了,還要繼續進入持倉監控、加減倉、退出和最終結果復盤。
我不想等一個資產漲了 10 倍、進入所有熱榜以後,系統才告訴我:「它火了。」
我真正想知道的是:
它最早什麼時候出現?
為什麼開始加速?
第一次沒有參與的條件,後來有沒有發生變化?
如果最終錯過,到底是沒發現、發現晚、身分沒對上、被過濾、沒研究、沒提醒、沒執行,還是持倉管理出了問題?
而且不能只復盤贏家。
每一個後來跑出來的資產,都要和同期、同鏈、同估值、當時看起來相似但最終失敗的樣本放在一起比較。
否則所謂的「AI 學習」,很容易只是看到結果以後,重新編一個聽起來合理的故事。
所以接下來,我不會再給每一隻漏掉的幣單獨加一個 watcher。
我要做的是把全局 first_seen、身分圖、
九月剛升息完,點陣中位還寫著「今年再升息一次」。
十月是最近窗口,Polymarket 升息25大約 44–45%。
我的讀法:略偏低,公允大概 48–55%。
優勢薄弱,不是重倉信號。
所以只買了很小一筆:
是 / 升息25 / @0.45 / 約 $40
沒做的:升息50、年線再次升息、沒數據就加倉。
離場:沒優勢了就平倉,數據轉冷就認錯。
公開學習,不是投資建議。
十月是最近窗口,Polymarket 升息25大約 44–45%。
我的讀法:略偏低,公允大概 48–55%。
優勢薄弱,不是重倉信號。
所以只買了很小一筆:
是 / 升息25 / @0.45 / 約 $40
沒做的:升息50、年線再次升息、沒數據就加倉。
離場:沒優勢了就平倉,數據轉冷就認錯。
公開學習,不是投資建議。
POLYMARKET+2.06%
- 1
Grok bot 這 100 美元你薅到了嗎?
本來只想在 Grok Bot 接通 X 付費 API,好做搜尋/時間線/mentions。
充了 $25 試試,結果 total 顯示約 $123。
拆開才明白:
• prepaid ≈ $23.7 → 我充的剩餘
• free ≈ $99 → 接通時送的起步 credits(約 1 年過期
官方 8/29:付費 Grok Bot 使用者可獲得免費 X API credits 以開始使用
金額官方沒寫死;上圖是我實測。接通之前先看 free,別被 total 騙去狂充。
本來只想在 Grok Bot 接通 X 付費 API,好做搜尋/時間線/mentions。
充了 $25 試試,結果 total 顯示約 $123。
拆開才明白:
• prepaid ≈ $23.7 → 我充的剩餘
• free ≈ $99 → 接通時送的起步 credits(約 1 年過期
官方 8/29:付費 Grok Bot 使用者可獲得免費 X API credits 以開始使用
金額官方沒寫死;上圖是我實測。接通之前先看 free,別被 total 騙去狂充。

- 1
- 3
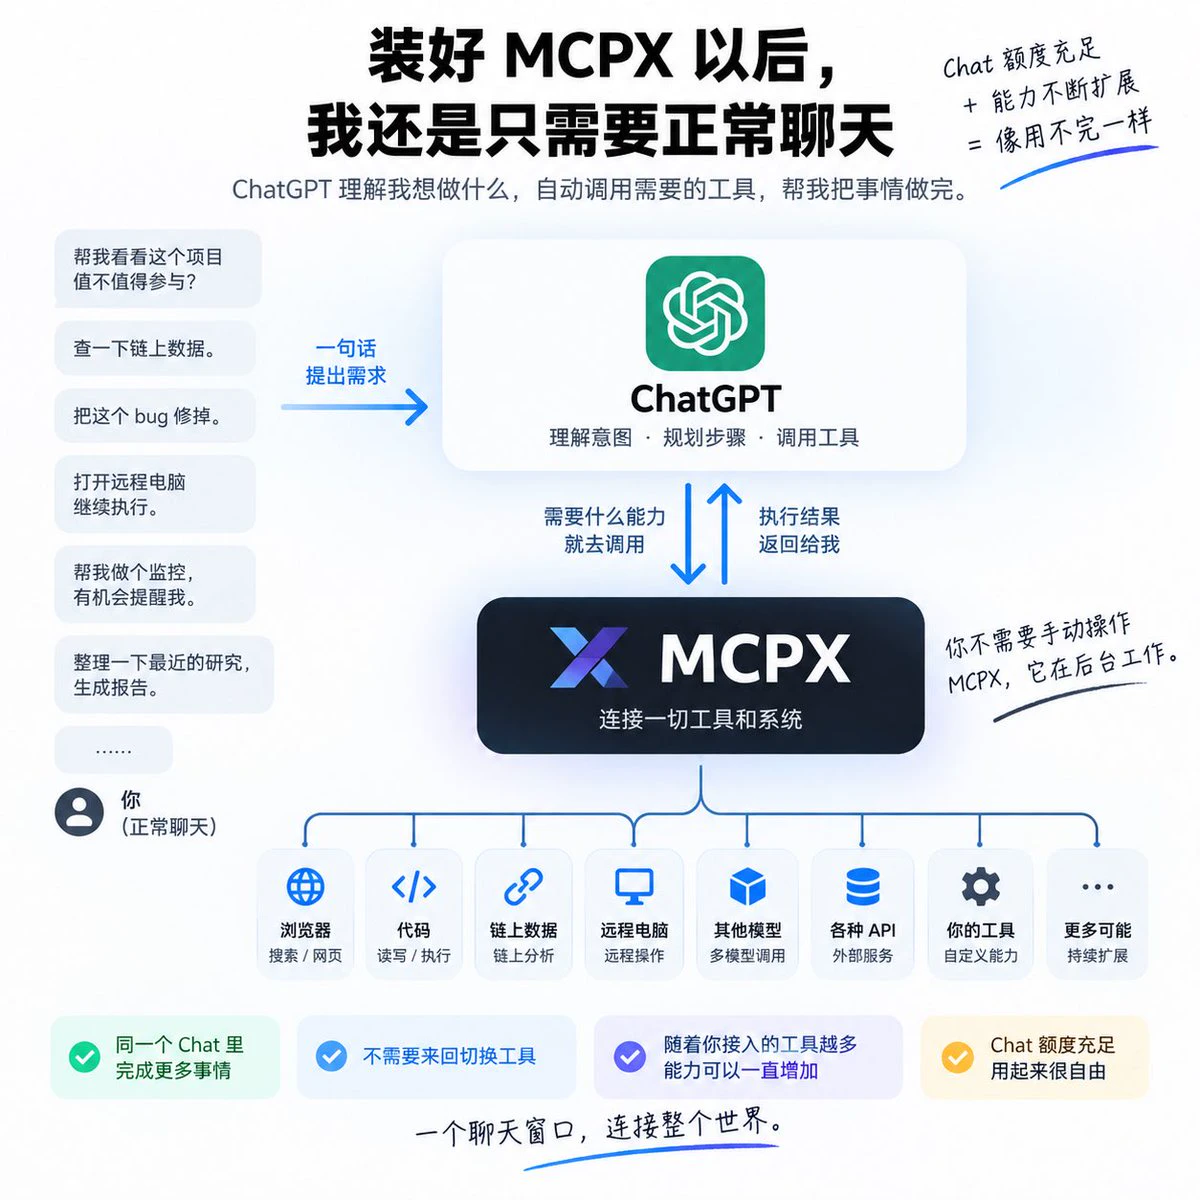
有了 MCPX 之後,我最近真的有一種感覺:
ChatGPT 好像被我用出了「無限額度」。
當然不是真的無限。
主要是 Chat 模式本身額度就挺夠用,再把 MCPX 裝好、設定好以後,很多原本需要我自己切換軟體、找工具、執行命令的事情,現在都可以直接在 Chat 裡完成。
而且我覺得 MCPX 最好用的地方,不是「多了一個新工具」。
恰恰是裝好以後,你甚至可以忘掉 MCPX 的存在。
還是和平時一樣正常跟 ChatGPT 說話:
幫我查一下這個專案。
看看鏈上資料。
把這個 bug 修掉。
繼續執行監控。
後面的事情,ChatGPT 自己判斷需要什麼能力,再透過 MCPX 去呼叫對應的 Tool、MCP、API、Remote Session,做完以後把結果帶回來,然後繼續往下推進。
所以我現在遇到新的需求,已經很少先想:
「ChatGPT 支不支援這個功能?」
我更在意的是:
「這件事能不能接成一個 Tool?」
只要能接進去,後面很多時候還是一句話的事。
這其實也是我覺得它對一般使用者最有價值的地方。
你不需要為了每一種工作都重新學習一套 AI 工具,也不用研究、程式碼、鏈上、遠端電腦、各種 API 之間來回切換。
入口還是同一個 Chat,但後面能呼叫的能力可以一直增加。
當然,也不是什麼事情都可以無條件自動完成。沒接入的能力還是沒有,登入、驗證碼、權限會卡住,資金、發文、帳
ChatGPT 好像被我用出了「無限額度」。
當然不是真的無限。
主要是 Chat 模式本身額度就挺夠用,再把 MCPX 裝好、設定好以後,很多原本需要我自己切換軟體、找工具、執行命令的事情,現在都可以直接在 Chat 裡完成。
而且我覺得 MCPX 最好用的地方,不是「多了一個新工具」。
恰恰是裝好以後,你甚至可以忘掉 MCPX 的存在。
還是和平時一樣正常跟 ChatGPT 說話:
幫我查一下這個專案。
看看鏈上資料。
把這個 bug 修掉。
繼續執行監控。
後面的事情,ChatGPT 自己判斷需要什麼能力,再透過 MCPX 去呼叫對應的 Tool、MCP、API、Remote Session,做完以後把結果帶回來,然後繼續往下推進。
所以我現在遇到新的需求,已經很少先想:
「ChatGPT 支不支援這個功能?」
我更在意的是:
「這件事能不能接成一個 Tool?」
只要能接進去,後面很多時候還是一句話的事。
這其實也是我覺得它對一般使用者最有價值的地方。
你不需要為了每一種工作都重新學習一套 AI 工具,也不用研究、程式碼、鏈上、遠端電腦、各種 API 之間來回切換。
入口還是同一個 Chat,但後面能呼叫的能力可以一直增加。
當然,也不是什麼事情都可以無條件自動完成。沒接入的能力還是沒有,登入、驗證碼、權限會卡住,資金、發文、帳
- 1
最近 X 上都在薄肌俱樂部
我也來報個到
我也來報個到
- 1
最近碰到一個很詭異的問題:
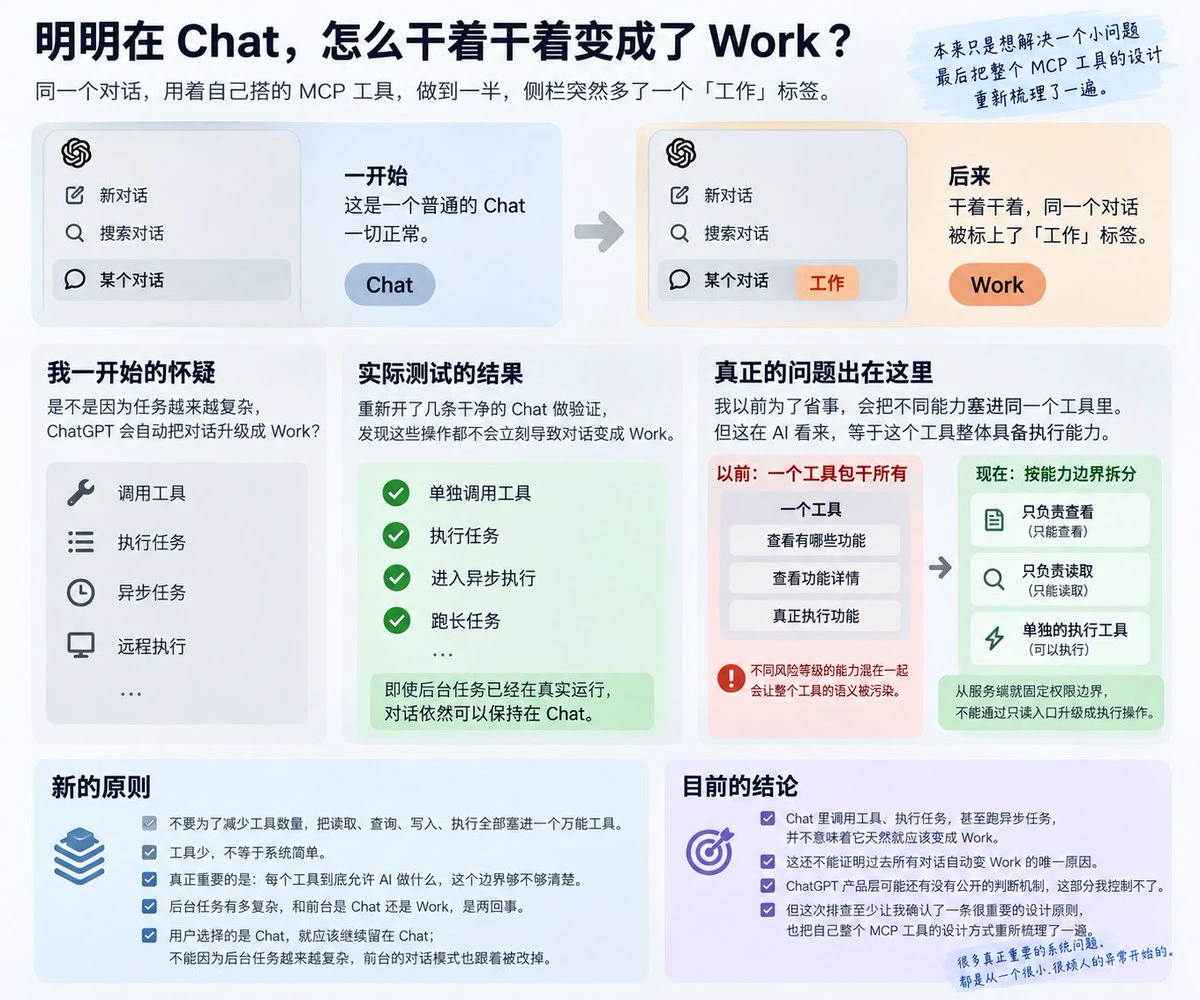
我明明開的是普通 Chat,接上自己長期在用的 MCP 工具後,幹著幹著,同一個對話卻會變成 Work。
不是新開了一個 Work,也不是我自己的後台任務名字裡有 Work,而是原來的對話在 ChatGPT 側欄裡真的多出了一個「工作」標籤。
我一開始懷疑,是不是遠端執行、非同步任務、長任務這些機制觸發了 ChatGPT 的某種自動升級。於是乾脆一路拆下去,重新開了幾條乾淨的 Chat 做驗證。
結果發現,事情沒那麼簡單。
單獨呼叫工具不會立刻變 Work,真正執行任務也不會,甚至已經進入非同步執行,對話依然可以保持在 Chat。也就是說,「任務越來越複雜」本身,並不能解釋為什麼一個 Chat 最後會變成 Work。
繼續往下查,我反而發現了自己 MCP 工具設計裡的一個問題。
以前為了讓介面看起來更整齊,我會把一組相關能力塞進同一個工具裡。比如一個工具既可以「查看有哪些功能」,也可以「查看功能詳情」,最後還可以「真正執行功能」。
程式碼上這樣寫很方便,但站在 AI 的角度,這三件事根本不是同一種能力。
前兩件只是讀取,最後一件卻可能真的連網、寫資料、執行操作。可一旦把它們塞進同一個工具,ChatGPT 看到的就不再是每個功能各自準確的邊界,而是這個工具整體「有可能做什麼」。
於是會出現一個很奇怪的結果:你明明只是讓它查一下有哪些功能,暴露給模型的卻還是
我明明開的是普通 Chat,接上自己長期在用的 MCP 工具後,幹著幹著,同一個對話卻會變成 Work。
不是新開了一個 Work,也不是我自己的後台任務名字裡有 Work,而是原來的對話在 ChatGPT 側欄裡真的多出了一個「工作」標籤。
我一開始懷疑,是不是遠端執行、非同步任務、長任務這些機制觸發了 ChatGPT 的某種自動升級。於是乾脆一路拆下去,重新開了幾條乾淨的 Chat 做驗證。
結果發現,事情沒那麼簡單。
單獨呼叫工具不會立刻變 Work,真正執行任務也不會,甚至已經進入非同步執行,對話依然可以保持在 Chat。也就是說,「任務越來越複雜」本身,並不能解釋為什麼一個 Chat 最後會變成 Work。
繼續往下查,我反而發現了自己 MCP 工具設計裡的一個問題。
以前為了讓介面看起來更整齊,我會把一組相關能力塞進同一個工具裡。比如一個工具既可以「查看有哪些功能」,也可以「查看功能詳情」,最後還可以「真正執行功能」。
程式碼上這樣寫很方便,但站在 AI 的角度,這三件事根本不是同一種能力。
前兩件只是讀取,最後一件卻可能真的連網、寫資料、執行操作。可一旦把它們塞進同一個工具,ChatGPT 看到的就不再是每個功能各自準確的邊界,而是這個工具整體「有可能做什麼」。
於是會出現一個很奇怪的結果:你明明只是讓它查一下有哪些功能,暴露給模型的卻還是
- 1
機器人快要做失敗時,人類臨時接管糾正幾步。這幾步,真的值得模型學嗎?
@axisrobotics 8 月 19 日公布的一份單任務模擬實驗報告裡,有這樣一組結果。
任務是把一塊豆腐放到盤子上。項目方在同一批 480 個新起點上測試:
• 原模型:成功率 40.0%
• 直接學習人類完整糾錯過程:36.7%
• 用篩選後的短糾錯片段訓練:48.3%(三個訓練種子的平均值)
至少在這次對照裡,直接模仿人類完整操作,沒有帶來更好的結果。
報告作者給出的解釋是:完整操作裡混著暫停、猶豫、繞路和真正起作用的那幾步。整個過程能完成任務,不代表其中每個動作都值得模型模仿。
這次實驗最有意思的,是它怎麼驗證「人到底幫到了哪一步」。
先把完整操作放回模擬環境重播,確認能複現成功;再檢查原模型在起點和人接管前是否確實會失敗,排除那些本來就不需要人幫忙的情況。
最後,只執行約 0.8 秒的人工糾錯片段,立刻把控制權交還原模型:它能不能自己把剩下的任務做完?
能,才把這段糾錯用於訓練。
最初的 660 條候選經過幾輪篩選,414 條能進入最後這步短片段測試,161 條通過。
這套驗證比「錄下一次成功操作」多做了一件關鍵的事:檢查這幾步人工操作,是否真的讓原模型從失敗狀態恢復了。
但 40.0% 到 48.3% 的提升,也不能全部記到「篩選」一個因素上。實驗改變了學習的樣本形式,訓練時還約束模型保留原有能力
@axisrobotics 8 月 19 日公布的一份單任務模擬實驗報告裡,有這樣一組結果。
任務是把一塊豆腐放到盤子上。項目方在同一批 480 個新起點上測試:
• 原模型:成功率 40.0%
• 直接學習人類完整糾錯過程:36.7%
• 用篩選後的短糾錯片段訓練:48.3%(三個訓練種子的平均值)
至少在這次對照裡,直接模仿人類完整操作,沒有帶來更好的結果。
報告作者給出的解釋是:完整操作裡混著暫停、猶豫、繞路和真正起作用的那幾步。整個過程能完成任務,不代表其中每個動作都值得模型模仿。
這次實驗最有意思的,是它怎麼驗證「人到底幫到了哪一步」。
先把完整操作放回模擬環境重播,確認能複現成功;再檢查原模型在起點和人接管前是否確實會失敗,排除那些本來就不需要人幫忙的情況。
最後,只執行約 0.8 秒的人工糾錯片段,立刻把控制權交還原模型:它能不能自己把剩下的任務做完?
能,才把這段糾錯用於訓練。
最初的 660 條候選經過幾輪篩選,414 條能進入最後這步短片段測試,161 條通過。
這套驗證比「錄下一次成功操作」多做了一件關鍵的事:檢查這幾步人工操作,是否真的讓原模型從失敗狀態恢復了。
但 40.0% 到 48.3% 的提升,也不能全部記到「篩選」一個因素上。實驗改變了學習的樣本形式,訓練時還約束模型保留原有能力
- 1
今天把 ChatGPT $200 Pro 的 GPT-6 額度直接用完了。
一開始我還以為是不是哪裡出 Bug 了,查了 OpenAI 剛更新的官方說明,又把自己帳號後台的額度狀態扒出來看了一遍,才發現:
GPT-6 Astra 在 ChatGPT 裡雖然叫 GPT-6 Pro,但 $200/月的 Pro 會員,實際上只有 200 則訊息 / 週。
不是每天 200 條,是一週 200 條。
我帳號現在已經直接撞到 limit=200,GPT-6 Pro 被限制,ChatGPT 自動 fallback 到 GPT-5.6 Thinking。
更有意思的是,$200 Pro 的額度結構其實是:
GPT-6 Pro:200 則/週
GPT-5.6 Sol Pro:170 則/天
兩個 Pro 模型加起來:最多 200 則/天
而 Chat 和 Work / Codex 還是分開的額度池。
所以以前我腦子裡那個「$200 Pro 基本可以隨便用最強模型」的印象,其實是不對的。
尤其如果你不是把 ChatGPT 當搜尋框,而是真的把它當工作系統:一天同時開十幾個對話,研究、寫作、策略、產品、自動化一起推進,200 則真的燒得非常快。
我這次後台給的 reset 時間是 9 月 12 日凌晨。
如果按這個 reset anchor 往前倒一個完整週窗口,我大概是在不到一天的時間裡就把 200
一開始我還以為是不是哪裡出 Bug 了,查了 OpenAI 剛更新的官方說明,又把自己帳號後台的額度狀態扒出來看了一遍,才發現:
GPT-6 Astra 在 ChatGPT 裡雖然叫 GPT-6 Pro,但 $200/月的 Pro 會員,實際上只有 200 則訊息 / 週。
不是每天 200 條,是一週 200 條。
我帳號現在已經直接撞到 limit=200,GPT-6 Pro 被限制,ChatGPT 自動 fallback 到 GPT-5.6 Thinking。
更有意思的是,$200 Pro 的額度結構其實是:
GPT-6 Pro:200 則/週
GPT-5.6 Sol Pro:170 則/天
兩個 Pro 模型加起來:最多 200 則/天
而 Chat 和 Work / Codex 還是分開的額度池。
所以以前我腦子裡那個「$200 Pro 基本可以隨便用最強模型」的印象,其實是不對的。
尤其如果你不是把 ChatGPT 當搜尋框,而是真的把它當工作系統:一天同時開十幾個對話,研究、寫作、策略、產品、自動化一起推進,200 則真的燒得非常快。
我這次後台給的 reset 時間是 9 月 12 日凌晨。
如果按這個 reset anchor 往前倒一個完整週窗口,我大概是在不到一天的時間裡就把 200
熱門話題
#MSTR領漲納指100
73.71k 瀏覽量2.82k 人討論中
#Gate 24 小時淨流入居交易所 Top1
26.31k 瀏覽量3.67k 人討論中
#BTC重回80K
56.61k 瀏覽量60.21k 人討論中
#GarrettJin曬單持有3.2億美元ZEC
38.14k 瀏覽量1.46k 人討論中
#Gate股票永續合約覆蓋數量行業第一
39.86k 瀏覽量2.75k 人討論中
#渣打預計ARB 2030年達10美元
28.23k 瀏覽量1.22k 人討論中
#日股地產電力半導體板塊走強
60.25k 瀏覽量4.78k 人討論中
#以太坊現貨ETF單日淨流入1.44億美元
21.48k 瀏覽量1.28k 人討論中
#日本央行加息至1.25%創31年新高
83.33k 瀏覽量1.25k 人討論中
#Gate廣場中秋團圓局
4.22k 瀏覽量7.44k 人討論中