


Sleepy0x13

幣齡 5.4年
最高等級 0
用戶暫無簡介
如果你看完了 OpenAI DevDay 2026,想去搜一搜這個 dot,然後你輸入了 ,你就會來到 grok bot 的官網。
應該是老馬把這個網域給搶了。
樸實無華的商戰如是。
應該是老馬把這個網域給搶了。
樸實無華的商戰如是。
- 1
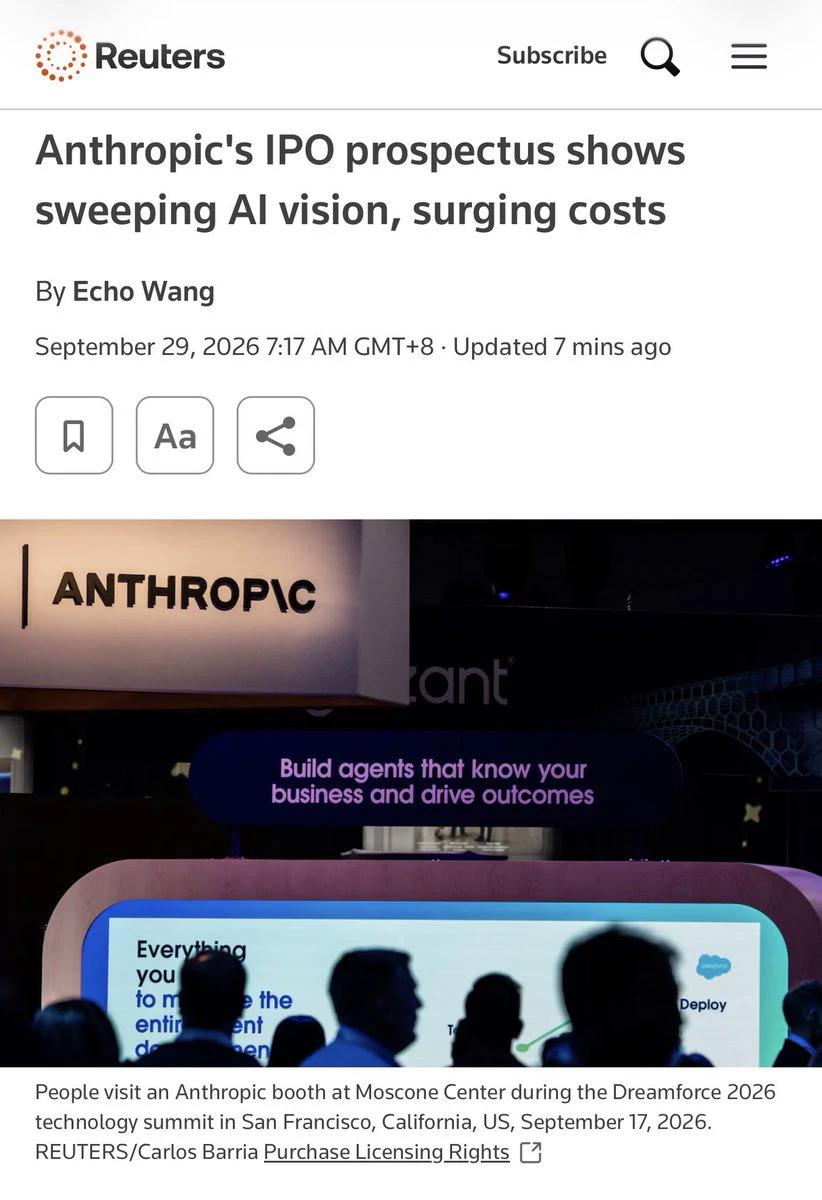
Anthropic 招股書曝光了,這家公司現在的帳,比外界想像得還要激進。
2025 年,Anthropic 營收 45.9 億美元,同比增長 1088%,但營業層面依然虧損超過 80 億美元。
更誇張的是未來支出。
截至去年底,Anthropic 手裡有 202.8 億美元現金、現金等價物和短期投資,但已經為未來數年的雲端運算、算力和基礎設施簽下了 5180 億美元的承諾。
差不多是現有現金的 25 倍,也是 2025 年全年營收的 113 倍。
這份招股書第一次把 Anthropic 的增長模式攤得這麼開。
一邊是極快的收入增長,另一邊是同樣驚人的算力投入。
而且收入本身也沒有想像中那麼穩。
去年接近四分之一營收來自兩家客戶,Anthropic 還專門在風險因素裡提醒,很多最大客戶都沒有簽長期合約,可以隨時削減甚至停止支出。
也就是說,它已經提前把幾千億美元的算力鎖下來了,但對應的收入,並沒有一起鎖下來。
過去幾年,一級市場願意為 AI 的增長速度買單。現在公司真正進入公開市場,投資者終於可以把收入、虧損、客戶集中度和未來幾千億美元的算力承諾放在同一張表裡算。
Anthropic 要證明的已經不只是 Claude 能不能繼續增長。
還要證明今天簽下的這張巨額算力帳單,未來真的有人來買單。
- 2
一個月,Instinct 的估值從 25 億美元漲到 100 億美元。
這家 2025 年才成立的 Personal Agent 公司,剛融了 10 億美元,Sequoia、Benchmark、Coatue 都進來了。上個月,它才剛以 25 億美元估值融完 2.5 億美元。
更有意思的是,Reuters 沒披露它的營收、付費用戶、留存率和任務成功率。
錢已經先到了。
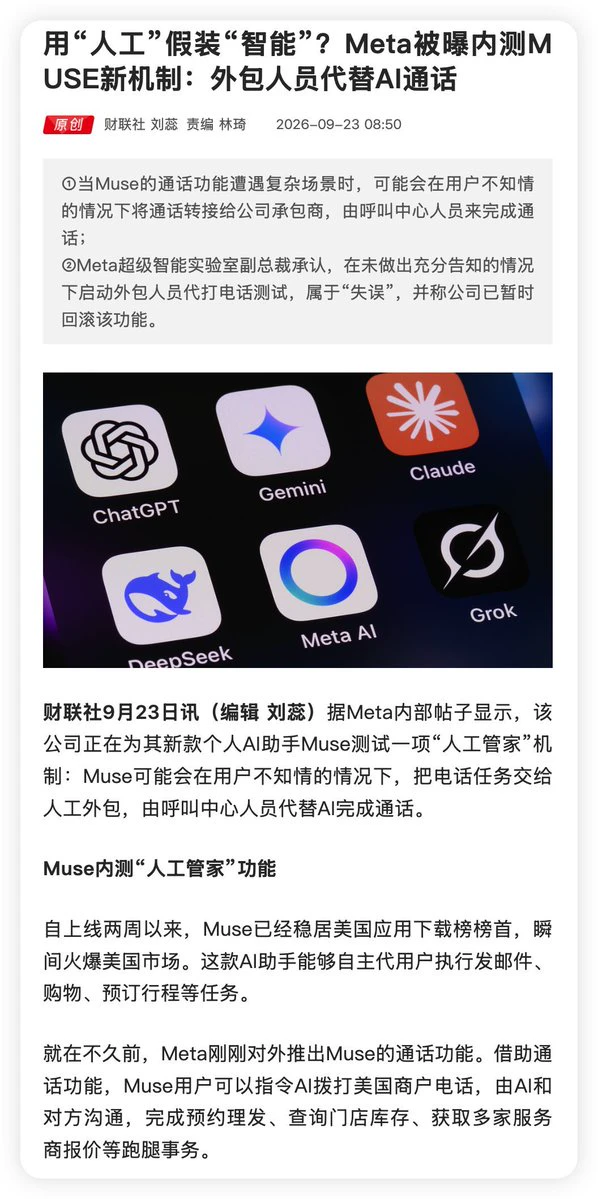
Instinct 做的事和 Muse 很像,讓 Agent 真正替用戶行動:訂票、買菜、取消訂閱,甚至直接打電話訂位。
VC 押的其實是一個很大的判斷——Personal Agent 會成為新的消費級入口。
因為搜尋知道你想買什麼,Agent 可以直接替你刷卡。
所以這個賽道最後最難的護城河,可能也不是模型,而是用戶願不願意把支付、身分、通訊錄和決策權交給你。
OpenAI 首席科學家 Jakub Pachocki、Anthropic 聯合創始人 Jack Clark、微軟首席科學官 Eric Horvitz、Meta 的 Dawn Song 等人共同發表了一篇新論文,警告自動化 AI 研究可能把整個行業推向「智能爆炸」。
現在模型已經能幫研究員寫程式、跑實驗、分析結果。再往前一步,它開始參與設計和訓練下一代模型;下一代模型能力更強,又回來繼續做 AI 研究。
這套循環一旦真的跑起來,AI 進步的時間尺度可能直接變掉。原本幾年才能完成的研發,被壓縮到幾個月,甚至更短。
以前大家擔心的是 AI 會不會搶程式設計師的工作。
現在最頂尖的一批 AI 研究員已經開始擔心,AI 會不會先把 AI 研究員自己的工作搶了,而且幹得比他們快很多。
所以論文提出了一個很有意思的監管指標。以後看一家模型公司到底跑到哪一步,光盯 benchmark、參數和算力可能已經不夠了,還得看它內部有多少 AI 研發工作已經交給了 AI。
這其實是個很關鍵的變化。
過去「智能爆炸」聽起來還很像 LessWrong 論壇裡的科幻討論,現在 OpenAI、Anthropic、微軟、Meta 這群真正天天造模型的人,已經開始認真研究該怎麼給它裝煞車了。
卡還在繼續買,模型也還在繼續訓。
只是大家終於開始問一句,如果有一天 AI 接手了「造 AI」這件事,煞車到底還握在誰手裡。
- 1
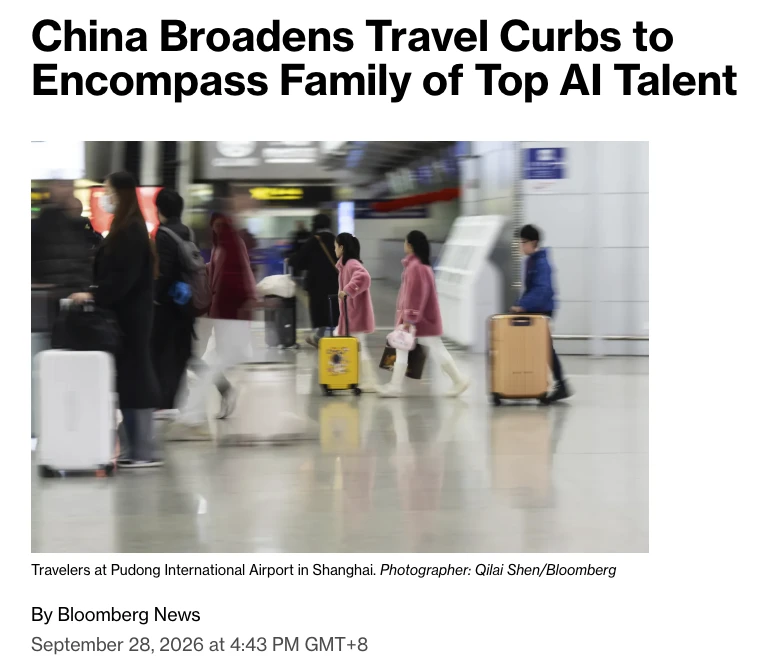
中國對頂尖 AI 人才的出境管理越來越嚴了。
彭博援引知情人士稱,部分 AI 新創公司創辦人、關鍵科技企業負責人,現在不光自己出國需要審批,配偶和子女即使短期出境,也要提前獲得批准。相關部門已經通知了一部分人,但到底覆蓋多少人,目前還不清楚。
今年 5 月,彭博就報導過,阿里、DeepSeek 等公司的部分 AI 人才出境前需要獲得批准。幾個月後,這套管理如果真的開始延伸到直系親屬,性質明顯又往前走了一步。
時間點也很巧。中國新的出入境管理規定剛剛在 9 月 15 日生效,其中已經為涉及產業安全、技術安全的出境限制提供了更明確的制度框架。
目前關於家屬限制的說法,仍然只有彭博的匿名消息來源,官方沒有公開確認。
彭博援引知情人士稱,部分 AI 新創公司創辦人、關鍵科技企業負責人,現在不光自己出國需要審批,配偶和子女即使短期出境,也要提前獲得批准。相關部門已經通知了一部分人,但到底覆蓋多少人,目前還不清楚。
今年 5 月,彭博就報導過,阿里、DeepSeek 等公司的部分 AI 人才出境前需要獲得批准。幾個月後,這套管理如果真的開始延伸到直系親屬,性質明顯又往前走了一步。
時間點也很巧。中國新的出入境管理規定剛剛在 9 月 15 日生效,其中已經為涉及產業安全、技術安全的出境限制提供了更明確的制度框架。
目前關於家屬限制的說法,仍然只有彭博的匿名消息來源,官方沒有公開確認。
美國大公司開始覺得 GPT 和 Claude 太貴了。
《金融時報》最近統計發現,今年 8、9 月,美國企業在財報電話會和投資者會議裡提到開放權重、開源模型的次數,較去年同期增加了大約 6 倍。PNC Financial、CH Robinson、西門子都開始公開講自己怎麼用這類模型。
理由沒那麼宏大,就是帳單越來越難看。
Tinder 的 AI 年化支出,今年 1 月還只有大約 100 萬美元,到 7 月已經漲到 1000 萬美元。現在他們開始把一部分普通請求切到更便宜的開放權重模型。
AT&T 更典型。
它內部 AI 系統每天處理大約 450 億 Token,目前約 40% 的任務已經交給開放模型,接下來準備提高到 70%。簡單任務用便宜模型,真碰到複雜問題,再把 OpenAI、Anthropic 請出來。
企業以前挑模型,多少還有點「誰最強我用誰」的意思。等 Token 真跑到幾十億、幾百億每天,基準測試就沒那麼浪漫了。
分類、摘要、客服、資訊擷取這些活,能用便宜模型做完,就沒必要每次都請最貴的那個。
- 1
Peter Thiel 最近說了一句很不像 Peter Thiel 的話:
AI 可能養不出幾個真正的壟斷巨頭,最後反而是消費者占了便宜。
Thiel 過去最出名的一套商業理論,就是競爭是給失敗者準備的,好公司要想辦法逃離競爭,建立壟斷。Google、Facebook 這些網際網路公司,基本就是他心目中的標準答案。
結果到了 AI,他開始覺得這套劇本可能演不下去了。
《泰晤士報》報導,Thiel 判斷 AI 時代產生的壟斷公司可能比網際網路時代更少,而且 AI 創造的相當一部分價值最終會流向消費者。
翻譯一下,AI 當然可能創造天量價值,但這筆錢未必留在做 AI 的公司帳上。
這個區別其實很要命。
現在大家給 OpenAI、Anthropic 這些公司估值,多少都藏著一個熟悉的網際網路劇本:
模型越做越強,使用者越積越多,最後贏家通吃,形成下一個 Google 級別的利潤池。
但 AI 目前偏偏在往另一個方向跑。
模型能力差距不斷被追上,價格不斷往下打,開源模型在後面追著放血。你這週剛把 benchmark 拉開,下個月別人追上來了;你剛準備靠能力領先漲價,隔壁又把 token 打成白菜。
AI 比網際網路重要得多,AI 公司卻未必有網際網路巨頭那麼好賺錢。
技術革命成功了,消費者贏麻了,模型公司每天繼續捲 benchmark。
Thiel 研究了一輩子怎麼逃離競爭,到了 AI 這
GOOGL-0.54%
- 2
- 2
Muse 和 Grok Bot 這兩個產品證明了一件事,最強的 AI 模型其實不是競爭壁壘。
到了產品層,普通用戶根本不關心你 Humanity’s Last Exam 高了幾個點。他只關心這個東西好不好用、能不能把事辦完,以及他每天打開手機的時候能不能順手用上。
Muse 吃的是 Meta 多年攢下來的用戶和產品能力,Grok Bot 也直接站在現成的生態和分發入口上。模型只要跨過「夠用」那條線,後面的競爭馬上就變了。
未來很多 AI 產品的勝負可能會很像手機。晶片跑分當然重要,但沒人因為安兔兔高 3% 就換手機。
到了產品層,普通用戶根本不關心你 Humanity’s Last Exam 高了幾個點。他只關心這個東西好不好用、能不能把事辦完,以及他每天打開手機的時候能不能順手用上。
Muse 吃的是 Meta 多年攢下來的用戶和產品能力,Grok Bot 也直接站在現成的生態和分發入口上。模型只要跨過「夠用」那條線,後面的競爭馬上就變了。
未來很多 AI 產品的勝負可能會很像手機。晶片跑分當然重要,但沒人因為安兔兔高 3% 就換手機。
META+3.25%
- 2
Anthropic 要上市了,Dario 先想辦法把方向盤焊死在創辦人手裡。
據 The Information,Anthropic 正在讓股東批准一套新的股權結構,Dario Amodei 和另外 6 名聯合創辦人,未來將合計掌握公司 50.1% 的投票權。
有意思的是,這幫人並不需要真的持有公司一半股份。
Dario 現在的經濟權益大概只有 2%。新的方案會讓創辦人透過一家單獨的 LLC 持有特殊投票權股票,相當於股份可以一路稀釋,控制權盡量不稀釋。
而且 Anthropic 的治理結構本來就已經夠套娃了。
Long-Term Benefit Trust 繼續掌握多數董事的任命權;創辦人在董事會的席位從 2 個增加到 3 個;員工還可能拿到一類特殊股票,在部分事項上負責平票加時賽。
所以以後 Anthropic 可能會出現一個很矽谷的局面,資本出了大部分的錢,創辦人拿著大部分的票,一個長期主義信託管著董事會,員工手裡還塞了一張裁判牌。
公司治理直接做成了多代理系統。
The Information 稱,Anthropic 目前計畫在 10 月底到 11 月左右 IPO,目標估值至少 1.5 萬億美元。5 月份它的估值還只有 9650 億美元。
- 2
Peter Thiel 昨天在柏林先把特朗普第二屆政府給罵了,說他們人是更忠誠了,就是不是特別聰明。
他說特朗普第一屆的問題,是政府裡塞了一群互相什麼都談不攏的人;到了第二屆發現不對,開始猛補忠誠度,結果方向盤打太狠,最後招進來的人確實忠誠,就是腦子沒跟上。
然後是他最近天天念叨的 AI。
Thiel 說 AI 可能比網際網路還重要,風險也是真的,但如果想讓全球一起減速,美國、中國、歐洲誰都不偷跑,那最後恐怕需要一個真正有權力的世界政府。
然後自由意志主義者 Thiel 看了一眼這個答案,表示算了,藥比病還猛。
他的原話大意就是,真正的危險在於西方認真把自己限速了,中國沒限。所以他寧願繼續承受 AI 往前衝的技術風險,也不願意為了管 AI 搞出一套全球超國家權力。
這也是這場訪談最有意思的地方。以前聽 Thiel 一會兒講 AI,一會兒講《聖經》,一會兒敵基督,一會兒世界政府,昨天終於把 README 發出來了。
甚至連自己十幾年前留下的網際網路案底也一起處理了。
2009 年那句自由和民主已經不再相容,這些年幾乎焊死在 Thiel 身上。昨天頒獎現場他乾脆公開說:「我支持民主與選舉。」
Thiel 沒突然換陣營,也沒突然變溫和,只是一次性把很多邊界都說清楚了。Trump 可以支持,也可以嫌棄;Vance 可以押,但不代表他覺得穩贏;右翼可以站一起,也不代表 AfD 說什麼他都接;
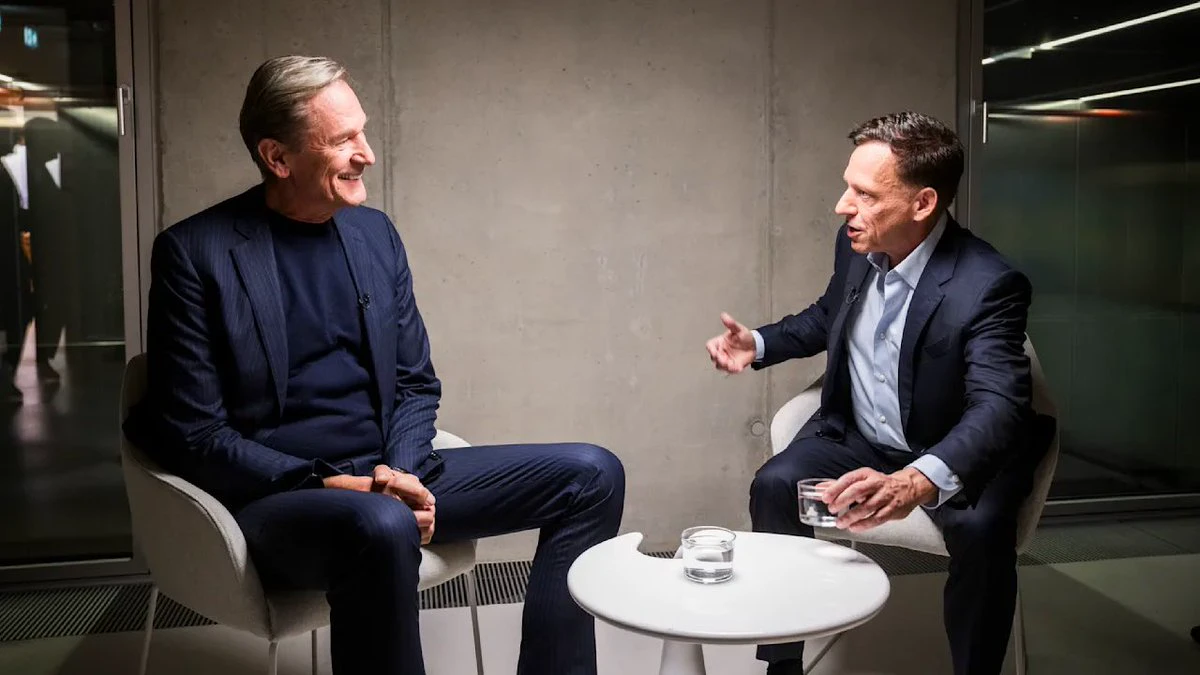
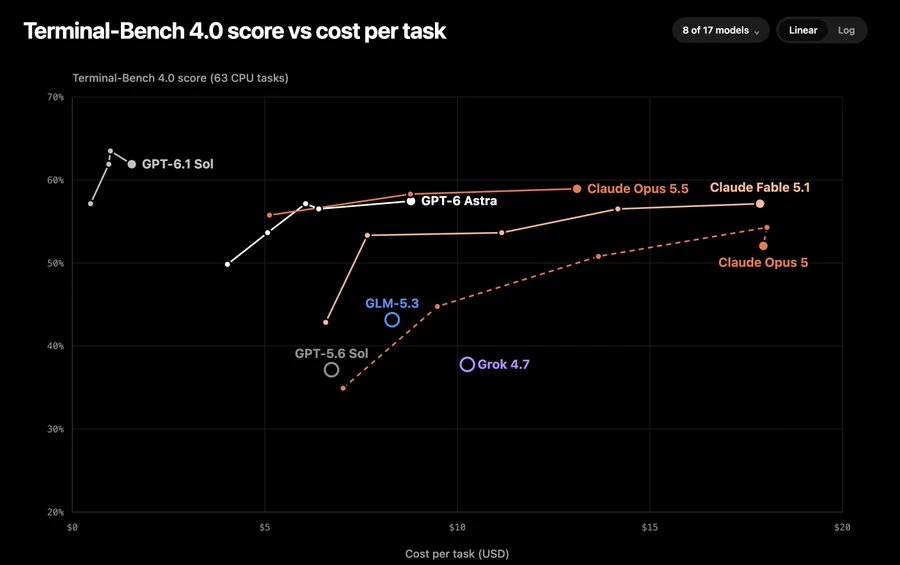
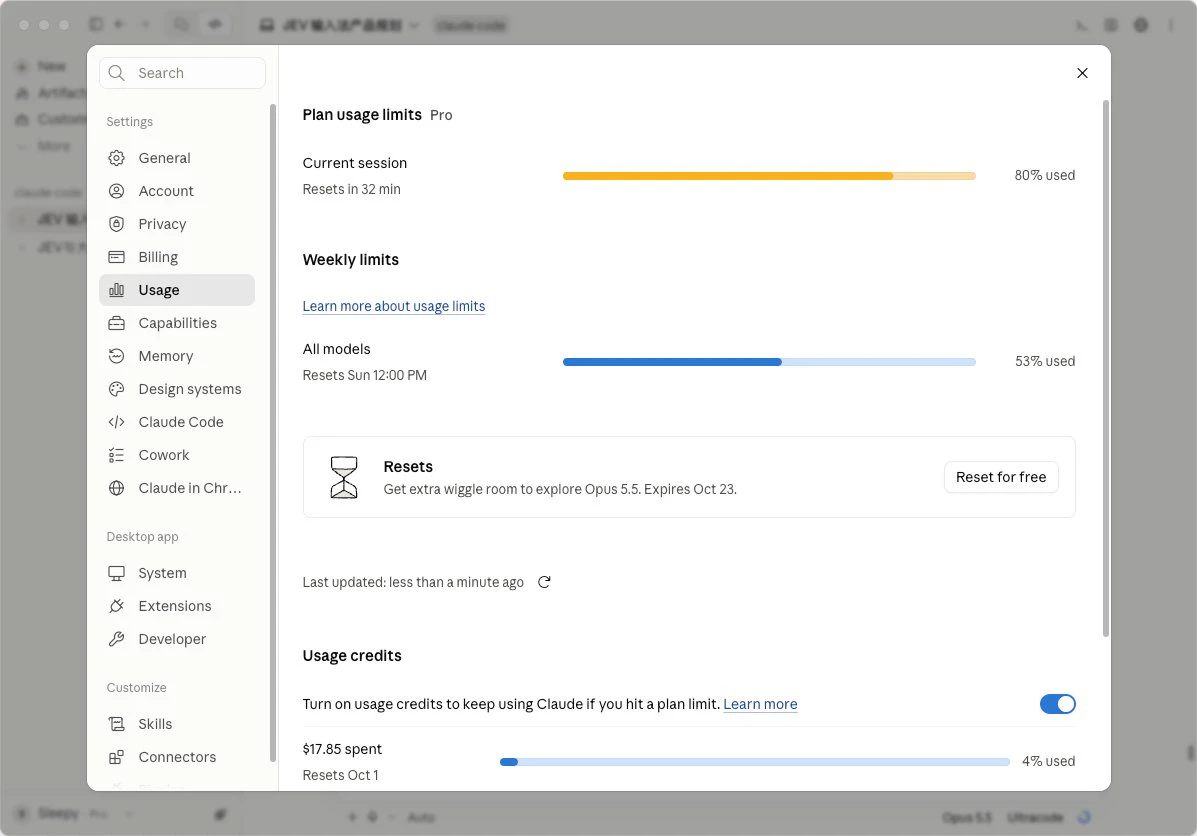
Opus 5.5 總給我一種怎麼都蹬不完的錯覺
- 2
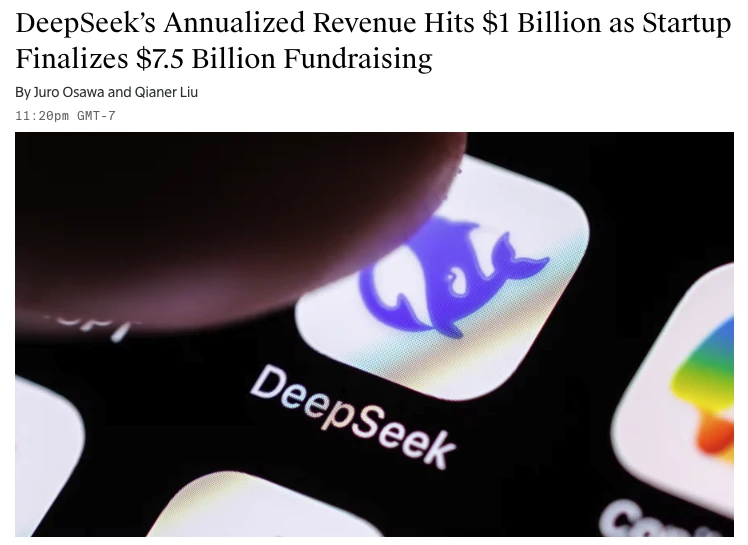
DeepSeek 把 API 最高漲價 4.5 倍,客戶沒跑,年化收入反而幾個月翻到了 10 億美元。
大型模型產業終於出現了一種很傳統的商業奇蹟,東西賣貴了,大家還得接著買。
DeepSeek 之前把部分 API 價格漲了 2.3 到 4.5 倍,梁文鋒最近跟投資人說,漲完之後客戶數量幾乎沒掉,需求還是很強。今年前 7 個月,API 業務毛利率已經做到 82.9%。
價格翻幾倍,客戶繼續續杯。
國內 SaaS 創業者看到這裡,應該會暫時退出群聊。
錢開始賺起來以後,DeepSeek 也準備繼續狠狠地幹。現在正在推進第二輪融資,計畫募 500 億人民幣,估值大概 5000 億,希望 10 月底前搞定,同時還在準備科創板 IPO。
但最符合 DeepSeek 氣質的地方在後面。
它現在 70% 以上算力還在拿去訓練模型,真正留給推理的不到 30%。甚至還在想辦法讓更多小模型直接跑遊戲顯示卡,把真正貴的高階卡繼續扣下來煉大型模型。
大型模型公司往法律、金融、醫療這些產業衝,最後很可能會衝成一支豪華乙方團隊。
模型發布的時候氣勢都很足,下一站 Legal,下一站 Healthcare,感覺馬上就要把整個軟體堆疊從下往上吃一遍。
真的進去以後畫風迅速變成:
請問貴司現在使用 Epic 還是其他 EHR?Bloomberg 的資料能不能授權?你們律所的文件存在 iManage 還是 Clio?好的老師,我們這邊支援串接。
OpenAI 最近推出 Astra for Law 就很典型。產品當然強,但官方自己列出來的陣容裡,Harvey、Thomson Reuters、Relativity、Clio、Intapp 全都在。
說是 OpenAI 進軍法律產業,仔細一看,法律產業原來的幾位大佬一個都沒走,OpenAI 主要負責逐一握手。
醫療更有意思。Epic 已經把 AI Charting 直接做進系統裡,OpenAI 真想進醫院,也得先把 ChatGPT 接進 Epic。
金融也是類似的情況,Bloomberg 現在自己做 ASKB,背後直接調用自己的資料、新聞、研究報告和分析工具。模型你可以比我強,問題是分析師早上九點到公司,Bloomberg Terminal 已經開著了。
科技產業特別愛講轉換成本,講著講著容易把自己騙進去,以為無非就是資料遷移貴一點、員工培訓麻煩一點。
很多垂直產業真正難以遷移的東西根本沒法報價
突然發現 Claude 現在也有重置了,而且送我了一次重置機會。
世界上除了 Tibo 又多了一位義父,目前暫時不知道是誰。
世界上除了 Tibo 又多了一位義父,目前暫時不知道是誰。
笑死了,這這是能工智人了
看來智慧發展到現在,benchmark 那些分數真是越來越不重要,還得看最後誰能在真實場景裡解決人類的真實問題。
另外也說明現在 token 比人力成本貴,暫時沒有失業的風險,不過長期可能還是沒有不失業的風險
看來智慧發展到現在,benchmark 那些分數真是越來越不重要,還得看最後誰能在真實場景裡解決人類的真實問題。
另外也說明現在 token 比人力成本貴,暫時沒有失業的風險,不過長期可能還是沒有不失業的風險
國內大型模型最近開始集體重做預訓練了。
這件事最有節目效果的地方在於,前兩年大家天天聊 Scaling Law,參數往萬億堆,GPU 一車一車買,token 燒得像不用錢。最後模型效果不對,查了半天,發現吃的是鵝腿阿姨的蔥汁鵝腿。
雷峰網提到一個匿名案例。有家公司花了接近一年,訓練了一個萬億參數模型,最後被參數量只有它大概 1% 的小模型反超。最後排查下來,問題主要出在資料。
網頁垃圾、重複語料、低品質標註,全都往訓練集裡塞。
萬億參數模型:收到,這就認真學習。
騰訊混元已經算是公開重做過一次。今年 2 月開始,重新搭建預訓練和強化學習基礎設施,重新制定資料標準、清洗原來的語料。之前的老混元也被爆出過打榜資料混進訓練集、標註規則混亂之類的問題。
阿里和百度當然沒有承認這個問題,但新模型的動作都很誠實。Qwen3 開始用 Qwen2.5 系列模型清洗文件,再補充大量數學和程式碼合成資料。文心 4.5 也開始做去重、低品質過濾、資料地圖和人工複核。
過去業界預設,只要模型夠大、資料夠多、算力夠用,能力總能被硬堆出來。現在大家慢慢發現,Scaling Law 可以幫你放大能力,也可以幫你高效率地學習網際網路垃圾。
所以接下來我反而挺想看,哪家公司開始敢公開講自己的資料工程。畢竟參數量還能往 PPT 上寫,資料裡到底摻了多少屎,只有模型自己知道。
熱門話題
#OneGate見證計劃
31.47k 瀏覽量707 人討論中
#核心PCE與GDP終值
97.06k 瀏覽量962 人討論中
#Marvell漲4.5%
70.71k 瀏覽量432 人討論中
#Anthropic披露與SpaceX簽署最高845億美元算力協議
15.69k 瀏覽量1.76k 人討論中
#ETH理財享5%加息年化
57.53k 瀏覽量920 人討論中
#美光即將披露四季度財報
642 瀏覽量356 人討論中
#美國30年期國債收益率創2002年以來新高
13.39k 瀏覽量65 人討論中
#美伊談判陷入僵持布倫特站上106美元
303 瀏覽量120 人討論中
#OpenAI年化經常性收入接近700億美元
19.41k 瀏覽量952 人討論中
#輝達追加1500億回購授權
7.25k 瀏覽量2.06k 人討論中