


Master Kenobi

幣齡 1.5年
最高等級 0
用戶暫無簡介
🙏 到目前為止,我還沒有透過 API 使用過 Claude,但我已經有一些想法了。你使用過 Anthropic 的 API 嗎?
- 2
加密貨幣 🤡 顯示狀態 2026。
也許是時候重看《華爾街之狼》了。
……而有些白癡仍會問:「但去中心化呢?」
也許是時候重看《華爾街之狼》了。
……而有些白癡仍會問:「但去中心化呢?」
- 1
10 月 7 日是特別的一天。
祝我兒子 Dario 生日快樂!❤️
也祝 Vladimir Putin 生日快樂。🥳
祝我兒子 Dario 生日快樂!❤️
也祝 Vladimir Putin 生日快樂。🥳
💡💡💡 正在與 Claude 對話……
問:我原本以為你的運作方式不同:一個為了與我對話而最佳化的模型,把事情交給一個以羅馬尼亞語思考的大腦,而那個大腦再把資訊一點一點餵給後面的英語模型。
答:你的直覺有一部分是對的,只是不是那種形式。
並不是這樣:不存在兩個大腦,一個負責羅馬尼亞語,另一個負責英語,中間再放一個翻譯器。我是單一模型。你的羅馬尼亞語文字會直接以羅馬尼亞語詞元的形式輸入,並以原樣佔據上下文中的空間。它不會先被翻譯成英語來降低成本。
正確的是:Anthropic 的研究人員曾深入研究模型(「追蹤大型語言模型的思維」,2025 年)。他們發現,無論使用哪種語言,想法大致上都以共通的方式呈現。「小」或「相反」的概念,在內部大致相同,不論它來自英語、法語或中文。語言主要只在邊緣發揮作用,也就是輸入和輸出的過程。因此,中間確實有某種無語言的「思考」,但它存在於同一個網路內,而不是一個獨立的大腦。
實際上:
- 我很能理解羅馬尼亞語,因為其中的想法會落在與英語相同的位置。
- 成本出現在邊緣:羅馬尼亞語比英語需要更多詞元。這只對每次都會載入的文字有影響。
這個「翻譯」不會先發生以節省成本。它會在內部自行發生。
問:所以中間有無語言的「思考」。它是否以某種方式存在於影像或聲音中,就像人類心智一樣?
答:既不是影像,也不是聲音。而是數字,每個時刻都有大量的數字。
每個想法都像是
✨ 我使用了週末期間擁有的獎勵重置,並充分利用了它。
短短一週內,我基本上用完了兩個每週額度,並一直維持在極限邊緣。Claude Code + Astra 似乎更有效率,但也會更快耗盡額度。不過,開發速度確實感覺更快了。
現在每天都朝著 100 次提交邁進。我在 10 月 4 日創下了新紀錄,單日完成 180 次提交。
短短一週內,我基本上用完了兩個每週額度,並一直維持在極限邊緣。Claude Code + Astra 似乎更有效率,但也會更快耗盡額度。不過,開發速度確實感覺更快了。
現在每天都朝著 100 次提交邁進。我在 10 月 4 日創下了新紀錄,單日完成 180 次提交。
- 3
- 1
💡 最佳創意源自內在。
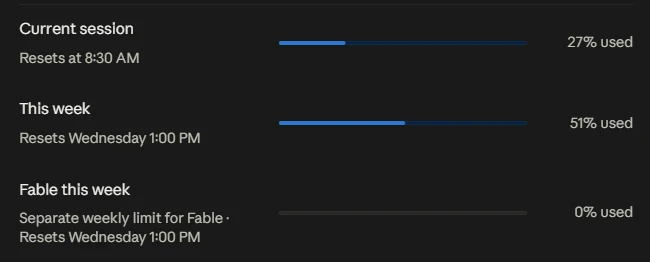
🔥 我只工作了 2 天,就已經用掉 Claude Code 每週額度的 51%——而且這還是在與 GPT Astra 並行工作的情況下。
看來,全速開發是要付出代價的。😅
不過說真的,時間已經很晚了,今天也過得很漫長。我先去睡一覺。💤
#sanki #enpixelment
看來,全速開發是要付出代價的。😅
不過說真的,時間已經很晚了,今天也過得很漫長。我先去睡一覺。💤
#sanki #enpixelment
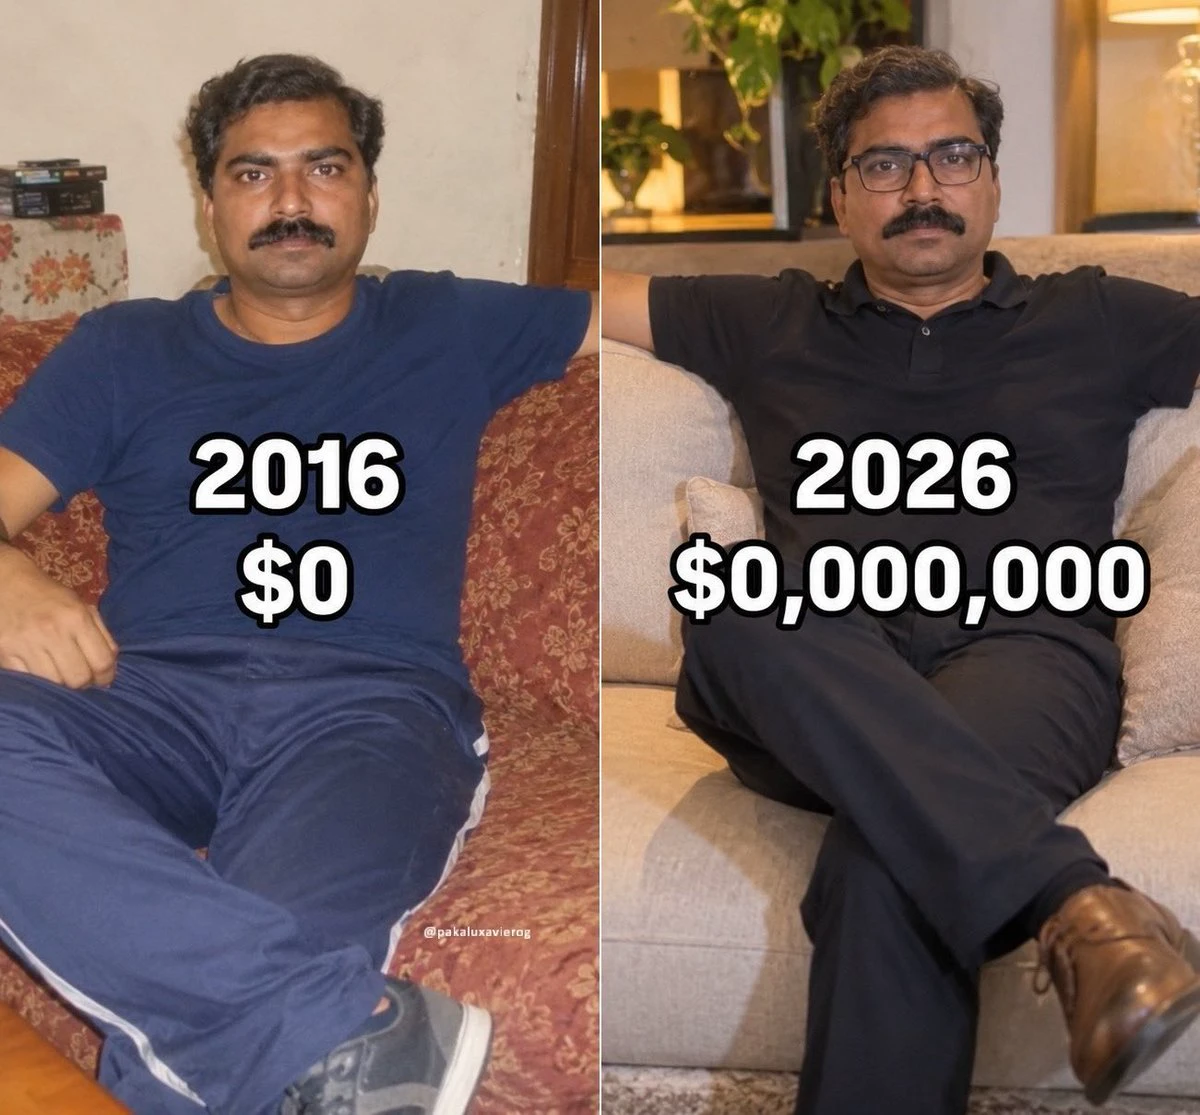
我的 10 年加密貨幣旅程 😂🤣🤣
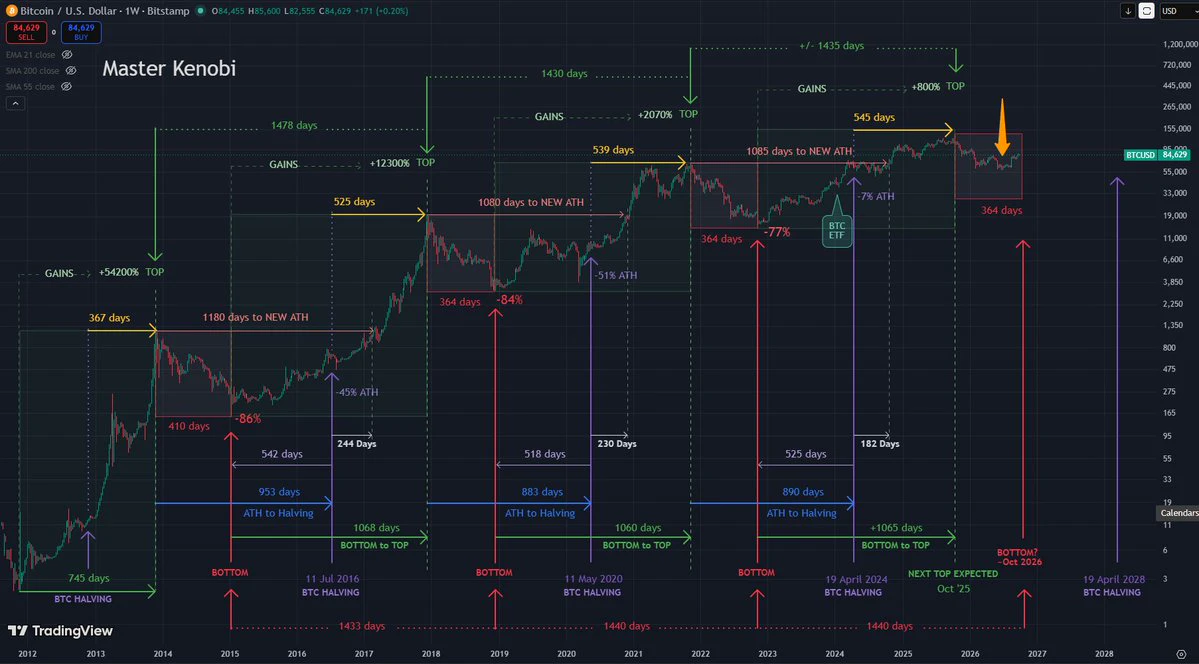
💡 比特幣主計畫更新。
如今距離 CZ 決定透過一場大規模清算事件搞垮整個加密市場,已經過了一年。
主計畫準確指出了牛市可能結束的可能性——但幾乎沒有人願意相信,包括我自己在內——主要是因為我們並沒有經歷一個完整的牛市週期。
很可能,我們得習慣加密領域中的這個新現實。
我們現在正看著新興 AI 技術在幾乎生活的每個面向大規模採用後會是什麼樣子,而與此同時,加密貨幣在超過 12 年後仍苦於證明真正強大的實用性。
這種對比正變得越來越難以忽視。
那些看不出差異的人,會繼續期待神奇的加密貨幣暴漲來讓自己致富。其餘的人則會適應並擁抱 AI 中正在出現的機會。第一群人聲稱自己理解這項技術,但如果他們分不清真正的實用性與胡說八道,那其實是在自欺欺人。
回到圖表——老實說,我自己已經有一段時間沒看了——我真的不知道該說什麼。
那就是底部嗎,比主計畫所建議的時間早了三個月?老實說,我完全不知道。而到了現在,我其實也不在乎了。
對於主要因為加密貨幣而關注我的人——我知道你們很多——我禮貌地建議你們離船。我不會再定期展示圖表了。
在一個價值 1 萬億美元、受到高度控制與操縱,且仍難以帶來任何真正有用成果的產業中,只有傻瓜才會整天盯著圖表看。
如果你在尋找希望,去別的地方找吧。
我一年前就轉上 AI 這艘船了。
祝好 👍
BTC+0.97%
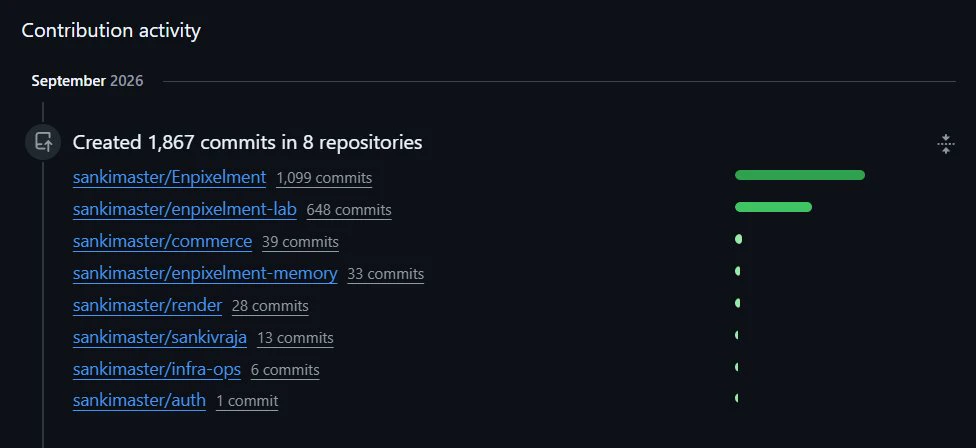
Claude 🤝 ChatGPT 在 9 月積極地將 token 轉化為提交。
1,867 次提交,跨越 8 個儲存庫——規劃、編碼、審查、彼此爭論,然後再次編碼。
結果證明,當你加入回饋迴圈後,「vibecoding」會變得相當嚴肅。 😄
#enpixelment #sanki
1,867 次提交,跨越 8 個儲存庫——規劃、編碼、審查、彼此爭論,然後再次編碼。
結果證明,當你加入回饋迴圈後,「vibecoding」會變得相當嚴肅。 😄
#enpixelment #sanki
你喜歡哪種圖表?
我:
我:
💡 我在將近一年前就全心投入 AI。現在我看到的是各個面向都在加速:智慧、能力、速度與效率。
3 個月後我們會在哪裡?6 個月後呢?一年後呢?
我的看法是:只有代理型企業才能存活。那些不適應的企業將會消亡。
企業主:成為代理架構師,也就是設計 AI 代理如何經營你的企業的人。這是目前值得學習的唯一技能。
3 個月後我們會在哪裡?6 個月後呢?一年後呢?
我的看法是:只有代理型企業才能存活。那些不適應的企業將會消亡。
企業主:成為代理架構師,也就是設計 AI 代理如何經營你的企業的人。這是目前值得學習的唯一技能。
👉 經過一整天的密集開發後:Sonnet 5.5 快得不可思議,而且確實很聰明。
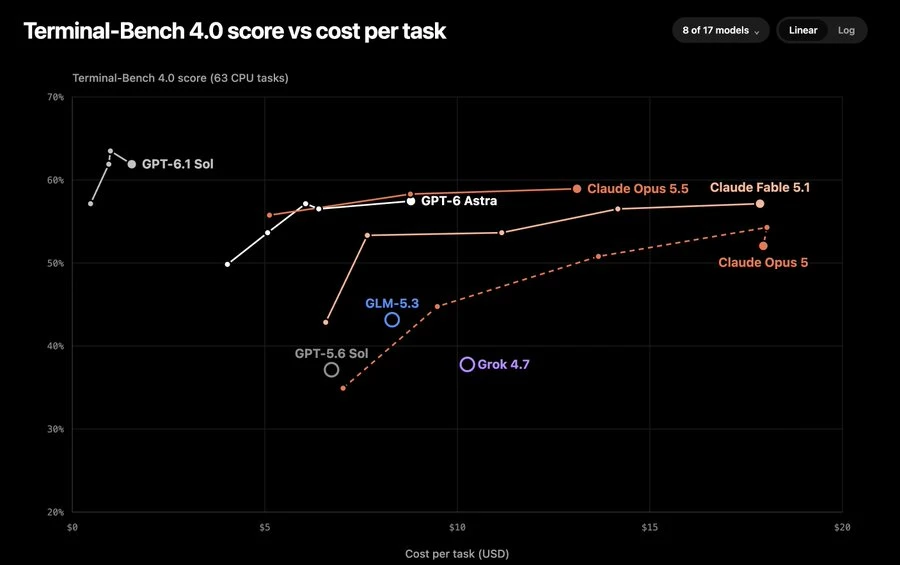
工作流程:使用 Opus 5.5 和 GPT Astra 循環規劃任務,然後讓 Sonnet 5.5 快速、精準且便宜得多地執行這些任務。
再讓大型模型決定哪個模型最適合每項任務。 👌
工作流程:使用 Opus 5.5 和 GPT Astra 循環規劃任務,然後讓 Sonnet 5.5 快速、精準且便宜得多地執行這些任務。
再讓大型模型決定哪個模型最適合每項任務。 👌
- 3
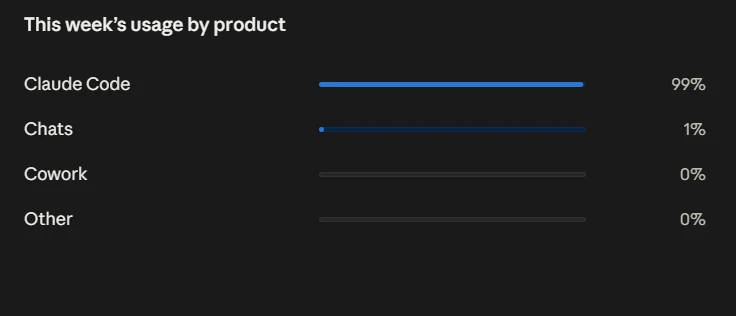
本週截至目前:99% 在工作,只有 1% 在聊天。
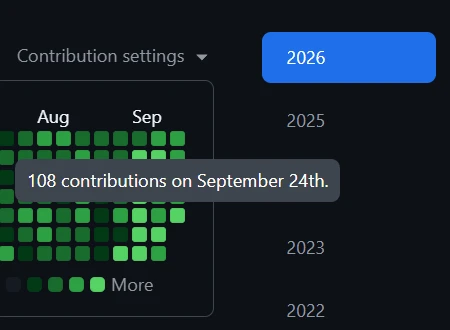
🏆 我在 GitHub 上的新個人紀錄:截至目前今天已有 108 次貢獻。
#vibecoding #enpixelment #sanki
#vibecoding #enpixelment #sanki
與 Claude Opus 5.5 共度完整一天,沒錯,這是一次大幅升級。光是速度就徹底改變了整體體驗。這可能是自去年 11 月開始密集使用 AI 建置以來最大的轉變。👍 GJ @claudeai
GPT-6 Astra 和 Sol 今天沿著另一條軌道運作,專注於系統文件架構。
Opus 5.5 快速推進了兩條戰線。我本想開闢第三條,但我只有一個人。是時候重新思考桌面配置了。
GPT-6 Astra 和 Sol 今天沿著另一條軌道運作,專注於系統文件架構。
Opus 5.5 快速推進了兩條戰線。我本想開闢第三條,但我只有一個人。是時候重新思考桌面配置了。
- 2
熱門話題
#Gate亮相TOKEN2049
41.19k 瀏覽量21.81k 人討論中
#Ledger事件損失近9000萬
39.48k 瀏覽量290 人討論中
#GateWCTCS9全球交易賽
34.43k 瀏覽量5.13k 人討論中
#CRCL領漲加密股
114.14k 瀏覽量1.48k 人討論中
#以太坊三季度漲超71%
27.01k 瀏覽量26.53k 人討論中
#Gate事件市場月交易量達7300萬美元
50.09k 瀏覽量1.61k 人討論中
#美國開放俄羅斯柴油進口
6.2k 瀏覽量97 人討論中
#Gate淨流入位列行業第三
20.71k 瀏覽量640 人討論中
#餘幣寶USDT享11%年化
53.07k 瀏覽量278 人討論中
#BTC回調觸及81000美元
26.79k 瀏覽量36.29k 人討論中