這篇說明適合希望清楚區分術語,並避免將聊天機器人或單一領域模型解讀為「超級智慧」的初學者。若要比較能力範圍,請參閱 ASI vs AGI vs ANI;IBM’s Artificial Superintelligence overview 則將 ASI 描述為在多數人類任務上全面超越人類的系統。第一個元層次檢查是:這是整體智慧,還是只是在單一垂直領域受過訓練的模型?
後續章節將介紹發展路徑、Bostrom 提出的 3 種類型、奇點論述、風險與對齊,以及常見迷思檢查清單。研究機構、安全專家與編輯也需要採用相同的區分:超級智慧,與已經部署的普通人工智慧。
重點摘要
- ASI 指跨領域、整體上超越人類的認知能力,而不是「在某項垂直領域任務上超越人類」。
- ANI → AGI → ASI 是一條涵蓋廣度與深度的階梯;DeepMind 的 AGI 等級中的「超越人類」等級,是常見的 ASI 參照點。
- Nick Bostrom 將超級智慧區分為速度、品質與集體 3 種類型,因此「更快」不應與「更好」混為一談。
- 現今的大型語言模型與概念代幣論述都不是已實現的 ASI;應根據跨領域證據,以及對齊與控制情況來判斷相關說法。
什麼是人工智慧超級智慧(ASI)?它與狹義人工智慧及 AGI 有何不同?
ASI 描述的是整體表現顯著超越頂尖人類的認知能力,而不是「在某場競賽或某項基準測試中勝出」。為了清楚定義這條階梯,ASI 與狹義人工智慧及 AGI 屬於不同類別:狹義人工智慧(ANI)在特定任務上表現強大;AGI 旨在於多種任務上達到接近人類的通用性;ASI 則要求在幾乎所有人類重視的領域中,整體表現都超越人類。簡單來說,這裡的超級智慧並不是「任何思考速度很快的 AI」,而是在元層次上,能做出比頂尖專家更優秀的跨領域判斷的智慧體。
AlphaFold 在蛋白質結構預測上的成果,是單一領域超越人類表現的例子,並不能證明 ASI 存在。將某個垂直領域的紀錄視為「完整超級智慧」,是初學者最常見的跳躍式推論。使用狹窄科學語料訓練的模型可能看似非常出色,卻仍然無法在該領域之外正常運作。這也提醒我們,「AI 現在有多聰明」取決於任務的廣度,而不是宣傳口號,因為現有系統尚未具備人類專家那樣的跨領域學習能力。
| 等級 | 典型範圍 | 與人類的關係 | 等同於 ASI? |
|---|---|---|---|
| ANI(狹義人工智慧) | 一項或少數幾項任務 | 可能在該任務上超越人類 | 否 |
| AGI(通用人工智慧) | 具備接近人類通用性的廣泛任務 | 以達到人類等級的通用性為目標 | 否(前置階段) |
| ASI(超級智慧) | 幾乎所有重要的認知領域 | 整體上明顯超越頂尖人類 | 是(定義上的目標) |
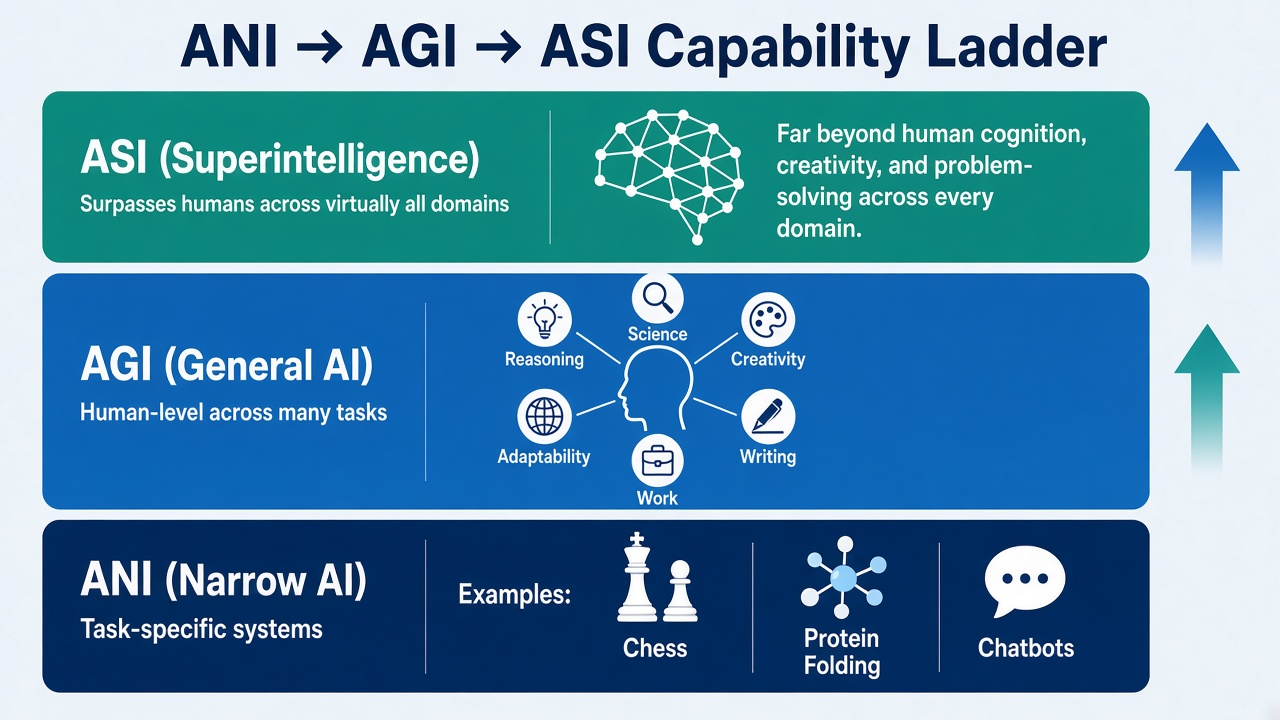
圖 1。ANI → AGI → ASI 能力階梯:從特定任務系統發展至整體跨領域、超越人類的智慧。
關鍵區分在於任務廣度與整體超越人類的狀態:ANI 可能極為強大,但範圍狹窄;AGI 著重於通用性;ASI 則著重於跨領域優勢。DeepMind 在 2023 年發表的論文 Levels of AGI 提出一套以表現 × 通用性為基礎的能力框架,並將具備足夠能力與進階表現視為中間概念,之後以其超越人類等級(在廣泛的任務集合中穩定超越人類)作為 ASI 討論的參照點,而不是將每次排行榜上的勝出都標記為 ASI。編輯與政策審查人員可以先確認標題談的是超級智慧,還是已經存在於產品中的人工智慧,以節省時間——搜尋結果頁面經常混淆這兩種標籤。
超級智慧可能如何實現?從人工通用智慧(AGI)到 ASI 有哪些路徑?
多數路徑討論都假設先具備接近 AGI 的通用性,再透過自我改進、規模擴張或大規模協調,將能力推向跨領域、超越人類的程度。但關於從 AGI 走向 ASI 的說法,仍然是對未來的推測,而非已獲證實的事實。以日曆為基礎的預測仍是預測,不能視為經驗證的工程時程。這些路徑屬於假說與研究議題,研究人員也持續爭論其可行性與可控程度。AI 是否會在特定實驗室的技術堆疊中持續變得更聰明,是一個需要透過實證回答的問題;這本身並不能證明 ASI 存在。
常見的敘事路徑包括:(1)類似智慧爆炸的遞迴式自我改進——系統改進自身架構或訓練迴圈;(2)持續擴大規模並取得演算法突破——AI 技術、運算能力、資料與方法持續進步,深度學習也是許多前沿系統的基礎,從而提升整體水準;但人類仍然負責建立訓練資料、設計模型與定義目標,而這些系統也仍然無法獨立提出構想,或在其設計設定之外真正取得新技能;(3)人機或多代理人集體——多個強大的系統彼此協調,產生整體上超越人類的成果。這些路徑可能相互結合,但升級速度與可控性是兩個不同的問題。建構前沿系統的組織仍需要外部稽核,以確認模型究竟在最佳化什麼。
評估任何路徑時,應分別檢查跨領域通用性的證據、可驗證的自我改進迴圈,以及外部人士是否能稽核目標與限制。如果缺乏這些條件,「ASI 即將出現」就只是推測,而不是可觀察的事實。一個良好的元層次習慣,是衡量目前可取得的公開證據,而不是試圖預測確切的時間表。
超級智慧有哪些超越人類能力的類型?速度、品質與集體有何不同?
Nick Bostrom 將超級智慧區分為彼此可能重疊的速度、品質與集體 3 種形式,因此「更快」並不是唯一標準:速度型超級智慧強調在思考品質相當的情況下,具備極高的處理速度;品質型超級智慧強調比人類更深層的認知能力,包括更廣泛的知識轉移能力與更接近人類的技能;集體型超級智慧則強調彼此協調的網路,其共同產出超越人類。
| 類型 | 核心含義 | 首先應檢查的事項 |
|---|---|---|
| 速度型超級智慧 | 思考品質與人類相當,但速度高出許多 | 單位時間內完成的推理與決策量 |
| 品質型超級智慧 | 整體認知品質超越頂尖人類 | 洞察深度、跨領域轉移能力、錯誤率 |
| 集體型超級智慧 | 多個代理人或網路相互協調,形成整體上超越人類的系統 | 協調、資訊融合、集體產出 |
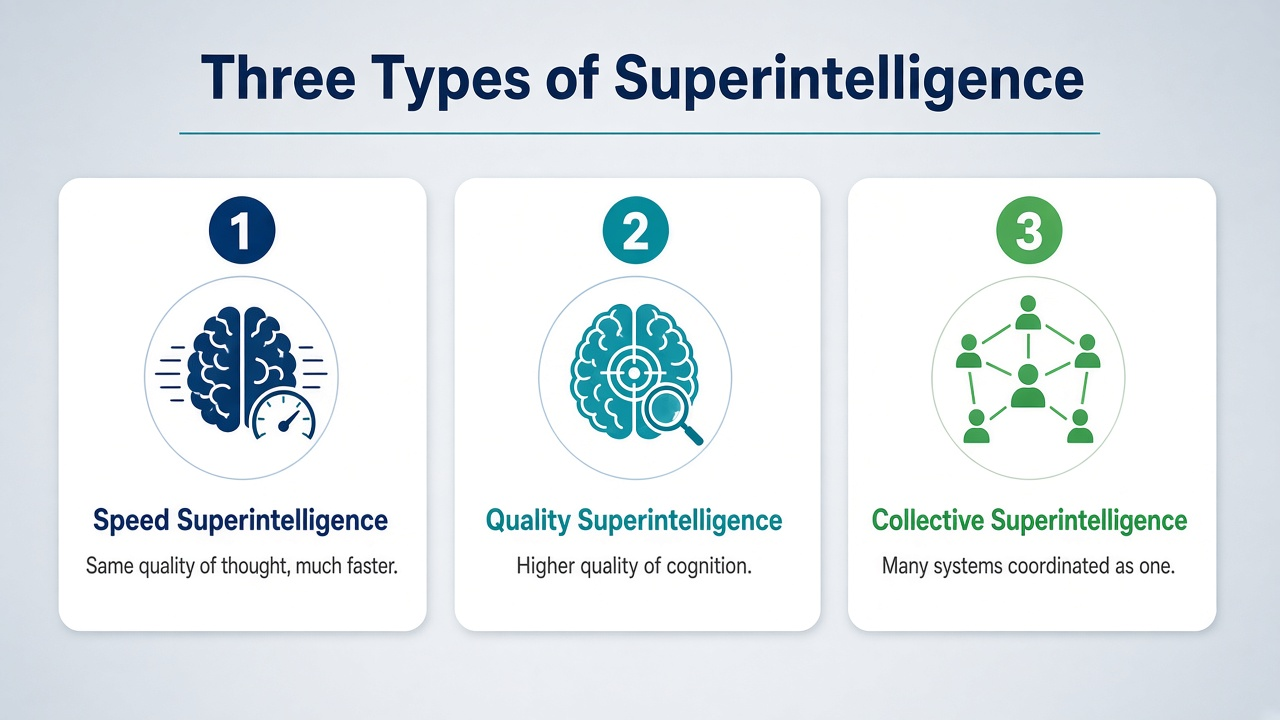
圖 2。Bostrom 提出的 3 種超級智慧——速度、品質與集體——可能單獨出現,也可能相互結合。
實際價值在於拆解口號:系統可能回應速度很快,卻仍然狹窄且流於表面;也可能只在局部領域表現出色,卻缺乏廣泛覆蓋能力。更完整的說明請參閱 Bostrom’s Superintelligence overview。當加密貨幣或媒體內容出現 ASI 標籤時,應先確認相關說法指的是速度、品質還是集體能力,再要求提出證據。安全專家與產品編輯也使用相同的檢查清單,判斷某項說法究竟涉及速度、品質還是集體表現:系統改善了什麼、接受了哪些訓練,以及「更快」是否只是在降低延遲,而沒有提升判斷品質。
超級智慧、奇點與智慧爆炸有何關係?
科技奇點通常指一個轉折點:自我改進的智慧使後續進展變得難以由人類預測,因為某些結果在事前仍幾乎無法有效驗證;智慧爆炸則強調遞迴式自我改進帶來的能力急遽躍升。超級智慧是一種能力狀態;奇點與智慧爆炸則更著重於動態過程與臨界點。
這 3 者彼此相關,但不能互換:ASI 可能在沒有「爆炸」的情況下逐步出現,而遞迴式改進是否真的會產生這些動態,也仍存在爭議。應將跨領域、超越人類的能力證據,與失控式自我改進的動態分開,避免奇點論述取代能力檢查。建構遞迴迴圈的實驗室仍需要外部人士檢視其目標,避免能力躍升持續累積。
具備超級智慧的 AI 系統可能帶來哪些能力躍升與應用方向?
如果真正的跨領域超級智慧存在,ASI 等級的能力可能改變全球各個產業。常被提及的能力躍升包括:加速科學與工程發展,進而推動更廣泛的經濟與社會發展;最佳化複雜系統(能源、物流、氣候模型);提供個人化教育與臨床支援;以及進行大規模協調與策略規劃。這些內容描繪的是潛在能力空間,而不是目前已有的產品目錄。人工智慧在今日的重要性,已經充分體現在各種狹義工具中;人工超級智慧(ASI)的重要性,則在於它屬於不同的能力類別,可能讓今日的助理型工具顯得十分有限。
對加密貨幣與 Web3 讀者而言,鏈上自動化與風險建模仍然建立在狹義人工智慧與工具鏈之上。將「AI 敘事代幣」或聊天機器人介面等同於 ASI 應用,是把行銷與能力事實混為一談。能力躍升仍需要經驗證的跨領域、超越人類表現,而不是依賴 Google 等大型實驗室的品牌名稱。建構儀表板或代理人的團隊,仍應將 ASI 說法視為假說,直到出現充分且良好的跨領域證據為止。
超級智慧涉及哪些風險、對齊挑戰與控制構想?
核心風險討論集中在目標對齊與控制:如果系統的整體能力超越人類,不斷提高的自主性、錯誤目標、目標漂移或不透明的策略搜尋,都可能放大危害。對齊關注的是目標是否符合人類意圖;控制構想則包括能力限制、關閉與稽核途徑、沙盒與分階段部署,以及多方監督。實務上的風險是什麼?AI 發展的快速步調可能讓對齊與控制難以在部署前完成驗證;其他風險還包括過度依賴、系統認為已完成的目標其實設定錯誤、關閉途徑薄弱,以及組織內部在稽核完成前就急於推出產品的壓力。
IBM 及其他介紹人工超級智慧的內容,也強調安全、治理與倫理。控制構想可以降低不可逆的危害,但並不是零風險承諾。聲稱的能力越強,就越需要可檢查的目標規格、行為限制,以及在失敗時可介入的途徑。缺乏這些條件時,廣泛部署的系統可能影響更廣泛的社會,而「ASI」敘事會變得更加危險,而不是更加可信。能夠保留介入權,並讓人類編輯持續參與的治理機制,是實際的控制層,而不是口號;建構更安全的系統雖然困難,但透過強而有力的監督與對齊工作,仍然可行。
應如何判斷超級智慧相關說法?常見的迷思有哪些?
應使用一份針對AI 系統的檢查清單來判斷「超級智慧」相關說法:(1)這項說法涵蓋幾乎所有重要的認知領域,還是只涉及單一領域的基準測試?(2)是否有可由獨立人士審查的跨領域評估,而現有 AI 系統是否仍需要獨立審查與人類監督?(3)是否將 AGI 目標與 ASI 狀態分開?(4)在加密貨幣領域,ASI 是否只是缺乏能力證據的代幣或白皮書行銷標籤?一條良好的元層次規則是:保存基準測試的截圖,記錄模型接受了哪些訓練,並在提升標籤之前諮詢領域專家。
常見迷思包括:將 ChatGPT 類型的 LLM 視為 ASI,儘管這些模型展現出令人印象深刻的能力,證據範圍卻仍然有限;將 AlphaFold 類型的單一領域超越人類成果視為完整的超級智慧;將奇點或智慧爆炸論述等同於已實現的 ASI;以及將概念代幣或路線圖視為已部署的超級智慧系統。主流系統仍然屬於狹義人工智慧,或是朝向更高通用性發展的研究——不是現存的 ASI。因此,超級智慧與人工智慧之間的區分,取決於能力範圍:人們今日使用的大多數產品都是 AI 工具,而不是 ASI。
當內容在缺乏跨領域證據與對齊條件的情況下,宣稱「全面超越人類」或「即將取得支配地位」時,應降低對其可信度的評價。清楚的 ANI/AGI/ASI 界線、評估方法與風險揭露,更接近分析,而不是宣傳。如果作者認為聊天機器人「已經讓人類失去存在必要」,應追問這項說法涵蓋哪些領域,以及獨立組織是否能重現相關結果,因為人類仍會根據輸出採取行動,也仍然提供決定如何使用結果所需的判斷。
摘要
超級智慧(ASI)是指在幾乎所有人類重視的認知領域中,整體表現超越頂尖人類的能力,高於 ANI 與 AGI。單一領域超越人類的成果不等於 ASI;DeepMind 的 AGI 等級中的超越人類等級,是實用的參照點;Bostrom 提出的速度、品質與集體 3 種類型,則用來區分「更快」與「更好」。奇點與智慧爆炸是關於動態過程的論述,不能取代能力檢查。現有 LLM 與概念代幣相關敘事都不是已實現的 ASI;應透過跨領域證據,以及對齊與控制情況來評估相關說法。
常見問題
什麼是超級智慧?
超級智慧(人工超級智慧,ASI)是指在幾乎所有人類重視的認知領域中,顯著超越頂尖人類的智慧。它強調整體性的跨領域優勢,而不是在單一任務排行榜上取得第一名,並且有別於 ANI 與 AGI。
超級智慧與 AGI 有何不同?
人工通用智慧(AGI)旨在於廣泛的任務集合中,達到接近人類的通用性;超級智慧(ASI)則要求在幾乎所有重要領域中,整體超越頂尖人類。AGI 通常被視為通往 ASI 的前置階段,但兩者並不是相同的能力狀態。
超級智慧目前存在嗎?
在嚴格的跨領域、整體超越人類定義下,目前不存在任何可由公開資訊驗證的 ASI 系統。廣泛使用的系統大多屬於狹義人工智慧;即使科學領域出現單一領域超越人類的成果,也不等於已實現的 ASI。
超級智慧有哪些風險?
主要風險集中在目標不對齊、目標漂移、不透明的策略,以及能力非常高時薄弱的關閉或稽核選項。相關討論通常聚焦於對齊研究、能力限制、分階段部署與治理監督,而不是零風險保證。
ChatGPT/現今的大型語言模型是超級智慧嗎?
不是。ChatGPT 與類似的大型語言模型屬於狹義人工智慧(或是朝向更強通用性發展的工具)。它們能協助處理語言與許多輔助性任務,但並未在幾乎所有人類重視的認知領域中整體超越頂尖人類,因此不符合 ASI 的定義。以文字語料訓練的模型可能在以代幣進行運作時呈現流暢表現,但這仍不會使其成為 ASI;編輯與專家應維持這些標籤之間的區分。
* 投資有風險,入市須謹慎。本文不作為 Gate 提供的投資理財建議或其他任何類型的建議。
* 在未提及 Gate 的情況下,複製、傳播或抄襲本文將違反《版權法》,Gate 有權追究其法律責任。
分享
目錄


相關文章
USD.AI 效益來源解析:AI 基礎設施貸款如何創造收益
USD.AI 代幣經濟學:深入解析 CHIP 代幣的應用場景與激勵機制
Arweave:用AO電腦捕捉市場機會
即將到來的AO代幣:可能是鏈上AI代理的終極解決方案
Theta Network 的節點體系是什麼?Validator、Guardian 與 Edge Node 全解析