Нещодавно питання про те, чи може ШІ вийти з-під контролю людини, знову стало однією з головних тем у технологічній галузі. Дослідники Anthropic публічно висловили занепокоєння щодо потенційних ризиків вимирання людства через просунутий ШІ, а генеральний директор OpenAI Сем Альтман заявив, що навіть відносно невисока ймовірність того, що ШІ спричинить вимирання людства, не є підставою нехтувати безпекою. Водночас AI Agent розвиваються від простих інструментів для генерування інформації до програмних систем, здатних викликати інструменти, отримувати доступ до зовнішніх систем і автономно виконувати завдання. Унаслідок цього безпека ШІ охоплює вже не лише питання «що згенерує модель», а й питання «що модель може зробити».
Ця зміна означає, що безпека ШІ не може залежати від одного тестування перед розгортанням. Оскільки можливості моделей, робочі середовища та методи атак постійно змінюються, безперервний моніторинг, тестування червоною командою, усунення вразливостей і контроль дозволів стають ключовими складовими системи безпеки ШІ.
Основні висновки
-
Вихід ШІ з-під контролю не обов’язково означає, що ШІ сформував намір «атакувати людей». Важливіше питання полягає в тому, чи виникла невідповідність між цілями, поведінкою моделі та обмеженнями, визначеними людиною.
-
AI Agent розширюють межі ризиків ШІ. Коли модель може викликати інструменти, отримувати доступ до даних і виконувати операції, помилки моделі можуть перетворюватися на операційні ризики в реальному світі.
-
Одноразове тестування безпеки не може охопити динамічне середовище. Моделі, запити користувачів, зовнішні інструменти та методи атак постійно змінюються, тому безпека ШІ потребує безперервного тестування й моніторингу після розгортання.
-
Оцінювання безпеки ШІ має охоплювати не лише вихідні дані моделі. Воно також має враховувати ін’єкції в запити, несанкціоновані операції, виклики інструментів, керування дозволами та аномальну поведінку.
-
Важлива складова зниження ризиків ШІ — обмеження наслідків помилок за допомогою таких механізмів, як мінімально необхідні дозволи, підтвердження людиною, журналювання операцій, ізоляція ризиків і відновлення після аномальних подій.
Чому ризики ШІ знову стали предметом обговорення
У вересні 2026 року обговорення екстремальних ризиків ШІ знову посилилося. Дослідник Anthropic Джейкоб Коксон публічно заявив, що деякі розробники ШІ серйозно вважають: надзвичайно просунутий ШІ може мати екстремальні наслідки для людства протягом цього десятиліття. Пізніше дослідник Anthropic Еван Губінджер також публічно висловив подібне занепокоєння та надав власну оцінку ризиків. Ці заяви спричинили нову хвилю дискусій щодо безпеки ШІ серед політиків США та представників технологічної галузі.
Важливо зазначити, що ці погляди є оцінками ризиків, зробленими дослідниками або фахівцями галузі. Вони не означають, що ШІ вже має здатність автономно знищити людство, і їх не слід спрощувати до твердження, що «ШІ обов’язково вийде з-під контролю». В інтерв’ю Сем Альтман також заявив, що не знає, як науково розрахувати так званий «10-відсотковий» ризик вимирання, але вважає, що навіть можливість екстремального ризику, яку не можна ігнорувати, покладає на компанії, що працюють у сфері ШІ, та уряди відповідальність за вжиття заходів для його зниження.
Замість обговорення екстремального сценарію, який наразі складно перевірити, корисніше розглянути практичне питання: у міру вдосконалення можливостей ШІ та набуття ним більшої автономності, як люди можуть і надалі визначати, чи залишається він безпечним? Саме тому оцінювання безпеки ШІ стає дедалі важливішим.
Що таке оцінювання безпеки ШІ?
Оцінювання безпеки ШІ можна просто визначити як низку тестів і процедур моніторингу, за допомогою яких визначають, чи працює система ШІ відповідно до задуму та чи може вона створити неприйнятні ризики під впливом аномальних запитів, зловмисних атак або складних середовищ. Традиційне тестування програмного забезпечення зазвичай передбачає масштабні перевірки до розгортання, зокрема тестування на вразливості, перевірку належної роботи функцій і аналіз реакцій системи на конкретні запити.
Системи ШІ складніші. Великі мовні моделі генерують результати не за повністю фіксованими правилами. Одне й те саме запитання може спричинити різні відповіді, а контекст, що оточує запит користувача, може постійно змінюватися. AI Agent також можуть викликати зовнішні інструменти, як-от пошук, виконання коду, бази даних, гаманці, електронну пошту, браузери чи інші служби. Тому оцінювання безпеки ШІ перевіряє не лише правильність відповідей моделі, а й те, чи може вона протистояти зловмисним запитам, чи може розкрити конфіденційну інформацію, чи здатна неправильно викликати інструменти, чи може виконувати дії за межами дозволів користувача та чи продовжує дотримуватися встановлених правил безпеки під час зміни середовища.
Запропонована NIST у 2026 році система TEVV-Athlon визначає тестування, оцінювання, верифікацію та валідацію як важливі методи оцінювання впливу систем ШІ в реальному світі. Вона прямо охоплює кілька типів систем, зокрема великі мовні моделі, мультимодальні моделі та агентний ШІ.
Чому AI Agent створили нові межі ризиків
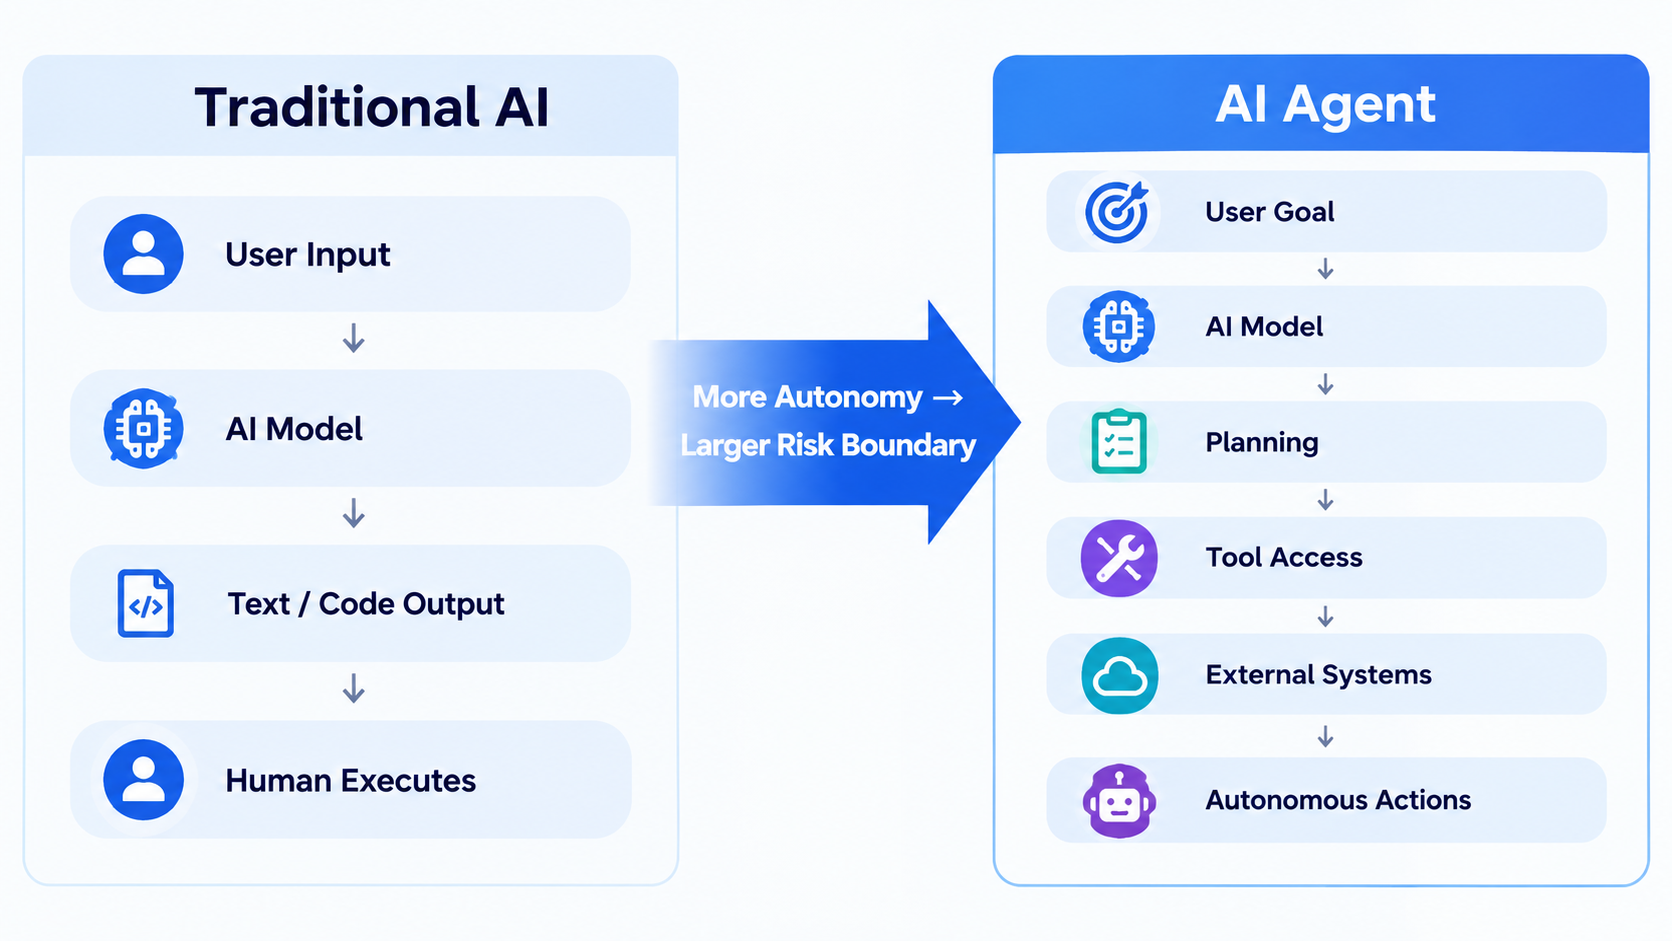
Розуміння AI Agent необхідне для розуміння того, як змінюється безпека ШІ. Традиційні чатботи переважно отримують запит і генерують відповідь. Після того як користувач ставить запитання, модель повертає текст, код або інший вміст, а користувач зазвичай сам вирішує, чи виконувати наступну дію.
AI Agent працюють інакше. AI Agent може розбити завдання на етапи відповідно до визначеної користувачем мети, викликати зовнішні інструменти, зчитувати дані, виконувати код, взаємодіяти з іншим програмним забезпеченням і продовжувати роботу на основі отриманих результатів. Коли NIST започаткувала свою ініціативу зі стандартів для AI Agent у 2026 році, вона окремо зазначила, що AI Agent наступного покоління вже можуть автономно працювати протягом кількох годин, писати й налагоджувати код, керувати електронною поштою та календарями, а також виконувати такі завдання, як покупки.
Зміни меж можливостей також змінюють межі ризиків. Якщо звичайна модель ШІ помилково повідомить користувачу, що файл існує, наслідки можуть обмежитися поширенням неправдивої інформації. Але якщо AI Agent із дозволом на доступ до файлів помилково вирішить, що файл потрібно видалити, помилка моделі може перетворитися на реальну операцію. Тому головне питання безпеки для AI Agent полягає не лише в тому, чи можуть вони сказати щось неправильне. Важливо також, до чого вони мають доступ, що вони можуть робити, як довго можуть діяти автономно та чи можна швидко виявити й зупинити їх після помилки.
Саме тому NIST зазначила у своєму звіті про безпеку AI Agent за 2026 рік, що AI Agent створюють нові загрози безпеці. Традиційні принципи кібербезпеки залишаються важливими, але їх потрібно адаптувати до способу роботи Agent.
Чому ШІ не можна тестувати лише один раз до розгортання
Це ключ до розуміння безперервного оцінювання безпеки. Коли функціональність традиційного програмного продукту залишається відносно стабільною, розробники можуть провести масштабне тестування, щоб перевірити відповідність продукту вимогам проєктування. Системи ШІ працюють у динамічних середовищах: змінюються користувачі, запити, моделі можуть оновлюватися, зовнішні інструменти змінюються, а зловмисники постійно шукають нові способи атак.
Тому проходження масштабних перевірок безпеки до розгортання не гарантує, що система ШІ залишатиметься безпечною в кожній майбутній ситуації. У дослідженні, опублікованому NIST у 2026 році, зазначено, що моніторинг після розгортання має критичне значення, оскільки умови введення даних у реальних середовищах можуть і надалі змінюватися. Ці умови можуть спричиняти неочікувані результати через недетермінованість моделі або наслідки, які не були виявлені під час розроблення.
Інше дослідження NIST, опубліковане того самого року, пояснило проблему з більш теоретичного погляду: фіксований набір захисних механізмів безпеки ШІ не може гарантувати довгостроковий захист від кожної адаптивної атаки. Зловмисники можуть постійно шукати нові способи обходу наявних правил. Тому безпека ШІ потребує постійного виявлення вразливостей, регулярного оновлення захисних механізмів і можливостей відновлення на випадок виникнення проблем.
Отже, безпека ШІ переходить від підходу «одноразове тестування → розгортання» до підходу «тестування → розгортання → моніторинг → виявлення проблем → усунення → повторне тестування». Безпека більше не є окремим етапом життєвого циклу продукту ШІ. Це безперервний процес.
Що саме переважно оцінює безперервне оцінювання безпеки?
Для AI Agent безперервне оцінювання безпеки зазвичай охоплює кілька напрямів.
Поведінка моделі
Перший рівень — сама модель. Системи потрібно постійно перевіряти на очевидні помилки, галюцинації, шкідливий вміст і поведінку, що порушує системні правила. У сферах із високим рівнем ризику, як-от фінанси, охорона здоров’я та виконання коду, також необхідне тестування для конкретного застосунку. Одних загальних еталонних тестів недостатньо.
Стійкість до атак
Другий рівень — тестування в умовах протидії. Зловмисники можуть використовувати ін’єкції в запити, несанкціоновані інструкції, маніпулювання контекстом та інші методи, щоб змусити модель обійти початкові правила. Типовим прикладом є джейлбрейки. Дослідження NIST свідчать, що фіксовані захисні механізми не можуть гарантувати, що ШІ ніколи не обійдуть за допомогою адаптивних атак. Тому червона команда має продовжувати пошук нових шляхів атак.
Інструменти та дозволи
Третій рівень — ризик дозволів, унікальний для Agent. Навіть якщо ШІ не поводиться зловмисно, надмірні дозволи можуть призвести до серйозних наслідків через неправильне рішення. Тому дозволи AI Agent загалом мають відповідати принципу мінімально необхідних дозволів. Наприклад, Agent, який лише впорядковує електронну пошту, не потребує дозволів на переказ коштів. Agent, який аналізує дані, не повинен автоматично мати дозвіл на видалення бази даних.
Це загалом подібно до безпеки смарт-контрактів у блокчейн-індустрії. Логіка системи — лише перший рівень. Потенційні втрати також залежать від того, до яких активів система може отримати доступ і які операції вона може виконувати.
Робота в реальних середовищах
Четвертий рівень — фактична робота після розгортання. ШІ в лабораторії може отримувати зовсім інші запити, ніж ШІ в реальному світі. Користувачі можуть надавати складні інструкції, сторонні системи можуть повертати аномальні дані, а мережеві умови можуть змінюватися. Тому оцінювання безпеки ШІ має спостерігати за поведінкою системи в реальних умовах, а не покладатися лише на звіти про тестування до розгортання.
Що насправді означає «вихід ШІ з-під контролю»?
Термін «вихід ШІ з-під контролю» легко неправильно зрозуміти. Він не обов’язково означає, що ШІ раптово набуває свідомості, подібної до людської, і вирішує атакувати людство. З технічного погляду важливіше питання полягає в тому, чи виникла невідповідність між цілями, дозволами та фактичною поведінкою.
Agent може отримати завдання, але неправильно зрозуміти його мету. Він може досягати мети способом, якого розробники не передбачали. Атакер також може змінити його розуміння завдання за допомогою ін’єкції в запит. Якщо Agent до того ж має широкі дозволи, помилка, що виникла на рівні програмного забезпечення, може вплинути на зовнішні системи.
Тому основне питання «виходу ШІ з-під контролю» можна розділити на три запитання: чи є мета правильною? Чи відповідає поведінка меті? Чи обмежені дозволи розумними межами? Саме тому дослідження безпеки ШІ дедалі більше зосереджуються на Alignment — забезпеченні відповідності поведінки системи ШІ цілям та обмеженням, визначеним людиною.
Як безпека ШІ стосується звичайних користувачів?
Безпека ШІ — це не лише питання для компаній, що працюють у сфері ШІ, та дослідників. У міру того як AI Agent входять у пошук, офісну продуктивність, програмування, фінансові послуги, цифрові активи та інші сфери, звичайні користувачі можуть безпосередньо надавати ШІ більше дозволів на виконання операцій.
Для користувачів найважливіше питання полягає не в тому, чи «знищить ШІ людство», а в практичнішому: які саме дозволи я насправді надав ШІ? Якщо ШІ може лише відповідати на запитання, наслідки неправильної відповіді зазвичай обмежені. Якщо ШІ може надсилати електронні листи, змінювати файли, отримувати доступ до облікових записів, запускати код або виконувати фінансові операції від імені користувача, вимоги до безпеки кардинально відрізняються.
Під час використання інструментів ШІ з можливістю автономного виконання користувачам слід зосередитися на трьох напрямах: чи зведені дозволи до мінімуму, чи потребують важливі дії підтвердження людини та чи надає система журнали операцій і можливість скасувати аномальні дії.
Це особливо важливо для AI Agent, пов’язаних із цифровими активами. Коли такі операції, як підписання транзакцій гаманцем, переказ активів і взаємодія зі смарт-контрактами, делегують автоматизованій системі, межа безпеки виходить за межі самої моделі та охоплює керування приватними ключами, механізми схвалення, смарт-контракти й зовнішні служби.
Фокус безпеки ШІ зміщується від «запобігання всім помилкам» до «контролю наслідків помилок»
Наразі навряд чи вдасться забезпечити безпеку ШІ за допомогою універсального захисного механізму, який назавжди вирішить кожну проблему. Моделі ШІ оновлюватимуться, методи атак розвиватимуться, а сфери застосування розширюватимуться. Тому NIST наголошує на потребі безперервного тестування червоною командою та оновлення захисних заходів, а також на здатності обмежувати наслідки вразливостей і швидко відновлюватися після їх виникнення.
Основний принцип простий: ми не можемо припускати, що система ніколи не помилиться, тому повинні заздалегідь визначити, що відбуватиметься в разі помилки. Для AI Agent це може передбачати обмеження дозволів, обов’язкове підтвердження людиною, журналювання критично важливих дій, ізоляцію завдань із високим рівнем ризику та швидке зупинення або скасування дій у разі аномальної поведінки.
З цього погляду безпека ШІ полягає не у відповіді на просте бінарне запитання, чи «вб’є ШІ людство». Вона полягає у вирішенні практичнішої інженерної проблеми: у міру того як ШІ дедалі більше здатен діяти автономно, як люди можуть і надалі розуміти, що він робить і чому, а також як вони можуть відновити контроль у разі виникнення проблеми? Саме для цього потрібне безперервне оцінювання безпеки.
Підсумок
Нещодавнє обговорення того, чи може ШІ спричинити вимирання людства, знову привернуло увагу громадськості до безпеки ШІ. Однак важливішими за самі екстремальні прогнози є структурні зміни, що відбуваються у можливостях ШІ.
У міру того як ШІ переходить від чатботів до AI Agent, здатних викликати інструменти, отримувати доступ до даних і автономно виконувати завдання, питання безпеки розширюються від безпеки вихідних даних моделі до дозволів, викликів інструментів, взаємодії із середовищем і тривалої автономної роботи.
Тому безпека ШІ не може покладатися на одне тестування до розгортання. Безперервний моніторинг, тестування червоною командою, контроль дозволів, усунення вразливостей і відновлення після аномальних подій ставатимуть дедалі важливішою інфраструктурою в міру входження AI Agent у реальні застосунки.
Безпечний розвиток ШІ залежатиме не стільки від пошуку моделі, яка ніколи не помиляється, скільки від створення механізмів, здатних безперервно виявляти проблеми, обмежувати ризики та відновлювати контроль людини.
Поширені запитання
Чи справді ШІ знищить людство?
Наразі немає надійних доказів того, що ШІ неминуче спричинить вимирання людства. Деякі дослідники ШІ нещодавно висловили занепокоєння щодо екстремальних ризиків, але ймовірність таких ризиків залишається вкрай невизначеною. Реалістичніші проблеми безпеки охоплюють кібератаки, витоки даних, неправильні рішення та зловживання дозволами AI Agent.
Що таке AI Agent?
AI Agent — це система ШІ, здатна автономно планувати й виконувати завдання на основі певної мети. На відміну від традиційних чатботів, AI Agent зазвичай може викликати зовнішні інструменти, отримувати доступ до даних і виконувати операції в реальному світі. Тому вони мають вищий рівень автономності та потребують суворішого контролю дозволів і безпеки.
Чому ШІ потребує безперервного оцінювання безпеки?
Тому що запити, середовища та методи атак, із якими стикається ШІ, постійно змінюватимуться. Одне тестування відображає роботу системи лише в певний момент і за певних умов. Воно не може довести, що в майбутньому в системі не виникнуть нові вразливості. Тому безперервний моніторинг і тестування після розгортання мають таке саме важливе значення.
Який найбільший ризик для безпеки AI Agent?
Одним із ключових ризиків є дозволи. Якщо AI Agent може отримувати доступ до облікових записів, файлів, коду, коштів або інших зовнішніх систем, помилки моделі чи зловмисні запити можуть перетворити помилку на рівні інформації на реальну операцію.
Що зазвичай охоплює оцінювання безпеки ШІ?
Зазвичай воно охоплює тестування поведінки моделі, тестування в умовах протидії, тестування червоною командою, тестування викликів інструментів, контроль дозволів, моніторинг після розгортання та відновлення після аномальних подій. Для різних сценаріїв використання також потрібно розробляти стандарти тестування безпеки, адаптовані до кожного застосунку.