Недавно вопрос о том, может ли ИИ выйти из-под контроля человека, вновь стал одной из главных тем в технологической отрасли. Исследователи Anthropic публично выразили обеспокоенность потенциальными рисками исчезновения человечества из-за передового ИИ. Генеральный директор OpenAI Сэм Альтман заявил, что даже относительно небольшая вероятность исчезновения человечества по вине ИИ не позволяет игнорировать вопросы безопасности. Одновременно ИИ-агенты превращаются из простых инструментов генерации информации в программные системы, которые могут вызывать инструменты, получать доступ к внешним системам и автономно выполнять задачи. Поэтому безопасность ИИ теперь связана не только с тем, «что сгенерирует модель», но и с тем, «что модель может сделать».
Это означает, что безопасность ИИ нельзя обеспечить одним тестированием до запуска. Возможности моделей, операционные среды и методы атак продолжают меняться. Поэтому постоянный мониторинг, тестирование красной командой, устранение уязвимостей и управление разрешениями становятся ключевыми элементами системы безопасности ИИ.
Основные выводы
-
Потеря контроля над ИИ не обязательно означает, что ИИ намеревается «атаковать людей». Гораздо важнее понять, не возникло ли рассогласование между целями, поведением модели и ограничениями, заданными человеком.
-
ИИ-агенты расширяют границы рисков ИИ. Когда модель может вызывать инструменты, получать доступ к данным и выполнять операции, её ошибки могут приводить к операционным рискам в реальном мире.
-
Однократное тестирование безопасности не охватывает динамичную среду. Модели, пользовательские запросы, внешние инструменты и методы атак постоянно меняются. Поэтому безопасность ИИ требует непрерывного тестирования и мониторинга после запуска.
-
Оценка безопасности ИИ должна учитывать не только результаты работы модели. Необходимо также проверять устойчивость к внедрению запросов, предотвращать несанкционированные операции, контролировать вызовы инструментов, управлять разрешениями и отслеживать аномальное поведение.
-
Важная часть снижения рисков ИИ заключается в ограничении последствий ошибок. Для этого применяются минимально необходимые разрешения, подтверждение действий человеком, журналирование операций, изоляция рисков и восстановление после аномальных событий.
Почему риски ИИ вновь стали предметом обсуждения
В сентябре 2026 года обсуждение экстремальных рисков ИИ вновь усилилось. Исследователь Anthropic Джейкоб Коксон публично заявил, что некоторые разработчики ИИ всерьёз считают: крайне развитый ИИ может привести к катастрофическим последствиям для человечества в течение этого десятилетия. Позднее исследователь Anthropic Эван Хубингер также публично выразил обеспокоенность и представил собственную оценку рисков. Эти заявления вызвали новую волну обсуждений безопасности ИИ среди американских законодателей и представителей технологической отрасли.
Важно понимать, что это оценки рисков, сделанные исследователями и отраслевыми специалистами. Они не означают, что ИИ уже способен автономно уничтожить человечество. Их также нельзя сводить к утверждению, что «ИИ обязательно выйдет из-под контроля». В одном из интервью Сэм Альтман заявил, что не знает, как научно рассчитать так называемый «10-процентный» риск исчезновения человечества. Однако он считает, что даже возможность экстремального риска, которую нельзя игнорировать, возлагает на компании, занимающиеся ИИ, и правительства ответственность за принятие мер по его снижению.
Вместо обсуждения экстремального сценария, который сейчас трудно проверить, полезнее рассмотреть практический вопрос: по мере развития возможностей ИИ и роста его автономности, как люди смогут и дальше определять, остаётся ли он безопасным? Именно поэтому оценка безопасности ИИ приобретает всё большее значение.
Что такое оценка безопасности ИИ?
Оценка безопасности ИИ представляет собой серию тестов и процедур мониторинга. С их помощью определяют, работает ли система ИИ в соответствии с замыслом и может ли она создавать неприемлемые риски при воздействии аномальных входных данных, вредоносных атак или сложной среды. Традиционное тестирование программного обеспечения обычно включает масштабные проверки до запуска. Они охватывают поиск уязвимостей, проверку корректной работы функций и анализ реакции системы на определённые входные данные.
Системы ИИ устроены сложнее. Большие языковые модели генерируют результаты не по полностью фиксированным правилам. Один и тот же вопрос может привести к разным ответам, а контекст пользовательского запроса может постоянно меняться. ИИ-агенты также могут вызывать внешние инструменты, включая поиск, выполнение кода, базы данных, кошельки, электронную почту, браузеры и другие сервисы. Поэтому оценка безопасности ИИ проверяет не только правильность ответов модели. Она также должна определить, способна ли модель противостоять вредоносным запросам, может ли раскрыть конфиденциальную информацию, способна ли неправильно вызвать инструменты, может ли выполнить действия за пределами разрешений пользователя и продолжает ли она соблюдать установленные правила безопасности при изменении среды.
Предложенная NIST в 2026 году система TEVV-Athlon определяет тестирование, оценку, верификацию и валидацию как важные методы оценки воздействия систем ИИ в реальном мире. Она прямо охватывает несколько типов систем, включая большие языковые модели, мультимодальные модели и агентный ИИ.
Почему ИИ-агенты создали новые границы рисков
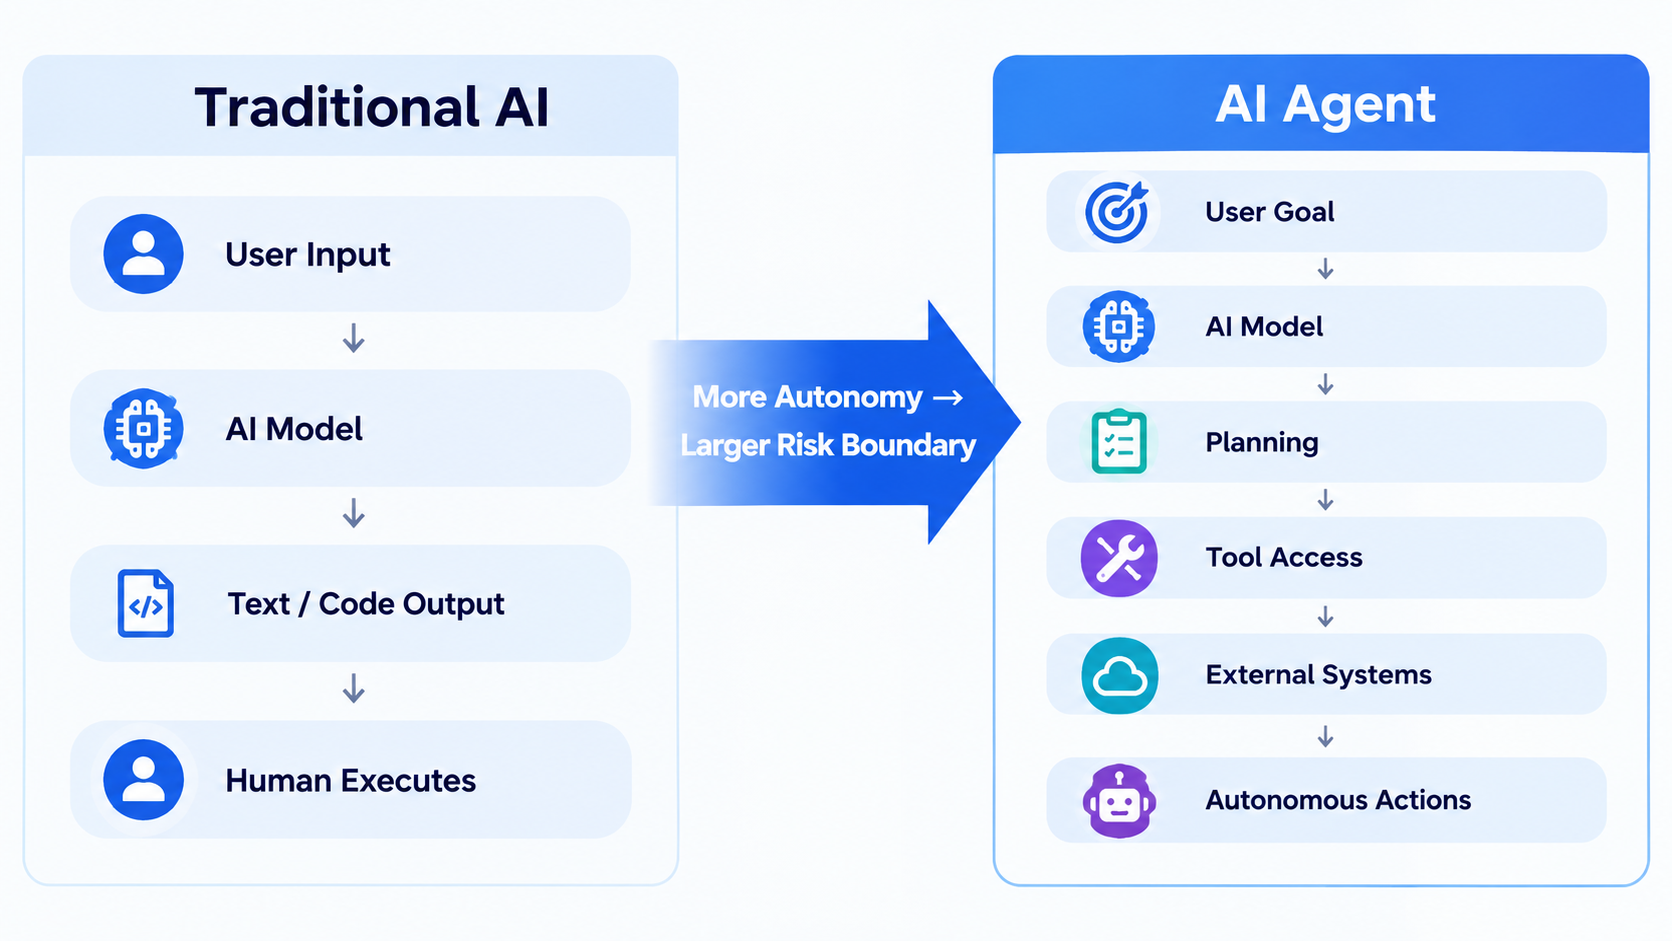
Понимание ИИ-агентов необходимо для понимания изменений в сфере безопасности ИИ. Традиционные чат-боты в основном получают входные данные и генерируют результат. После того как пользователь задаёт вопрос, модель возвращает текст, код или другой контент, а пользователь обычно сам решает, выполнять ли следующее действие.
ИИ-агенты работают иначе. ИИ-агент может разбить задачу на этапы в соответствии с целью, заданной пользователем, вызвать внешние инструменты, прочитать данные, выполнить код, взаимодействовать с другими программами и продолжить работу с учётом полученных результатов. Когда NIST запустил Инициативу по стандартам ИИ-агентов в 2026 году, организация отдельно отметила, что ИИ-агенты следующего поколения уже могут автономно работать в течение нескольких часов, писать и отлаживать код, управлять электронной почтой и календарями, а также выполнять такие задачи, как покупки.
Изменение границ возможностей приводит и к изменению границ рисков. Если обычная модель ИИ ошибочно сообщит пользователю о наличии файла, последствия могут ограничиться распространением недостоверной информации. Но если ИИ-агент с разрешением на доступ к файлам ошибочно решит, что файл следует удалить, ошибка модели может привести к реальной операции. Поэтому главный вопрос безопасности ИИ-агентов заключается не только в том, могут ли они сообщить что-то неверное. Важно также понимать, к чему они могут получить доступ, какие действия способны выполнять, как долго могут работать автономно и можно ли быстро обнаружить и остановить их после ошибки.
Именно поэтому NIST заявил в своём отчёте о безопасности ИИ-агентов за 2026 год, что ИИ-агенты создают новые угрозы безопасности. Традиционные принципы кибербезопасности по-прежнему важны, но их необходимо адаптировать к особенностям работы агентов.
Почему ИИ нельзя тестировать только один раз до запуска
Это ключ к пониманию непрерывной оценки безопасности. Если функциональность традиционного программного продукта относительно стабильна, разработчики могут провести масштабное тестирование и проверить соответствие продукта проектным требованиям. Системы ИИ работают в динамичной среде. Пользователи меняются, входные данные меняются, модели могут обновляться, внешние инструменты изменяются, а злоумышленники постоянно ищут новые способы атак.
Поэтому успешное прохождение масштабных проверок безопасности до запуска не гарантирует, что система ИИ останется безопасной в любой будущей ситуации. В исследовании, опубликованном NIST в 2026 году, отмечается критическая важность мониторинга после запуска, поскольку условия обработки входных данных в реальной среде могут продолжать меняться. Такие изменения могут приводить к неожиданным результатам из-за недетерминированности модели или к последствиям, которые не были выявлены на этапе разработки.
Другое исследование NIST, опубликованное в том же году, объясняет эту проблему с более теоретической точки зрения. Фиксированный набор защитных механизмов ИИ не может обеспечить долгосрочную защиту от любой адаптивной атаки. Злоумышленники могут постоянно искать новые способы обхода существующих правил. Поэтому безопасность ИИ требует постоянного поиска уязвимостей, регулярного обновления защитных механизмов и возможностей восстановления после сбоев.
Таким образом, безопасность ИИ переходит от подхода «однократно протестировать → запустить» к процессу «протестировать → запустить → отслеживать → выявить проблемы → устранить → протестировать снова». Безопасность больше не является отдельным этапом жизненного цикла продукта с ИИ. Это непрерывный процесс.
Что в первую очередь оценивает непрерывная проверка безопасности?
Для ИИ-агентов непрерывная оценка безопасности обычно охватывает несколько направлений.
Поведение модели
Первый уровень связан с самой моделью. Системы необходимо постоянно проверять на наличие очевидных ошибок, галлюцинаций, вредоносного контента и поведения, нарушающего системные правила. В сферах повышенного риска, таких как финансы, здравоохранение и выполнение кода, также необходимо проводить тестирование с учётом особенностей конкретного приложения. Одних общих эталонных тестов недостаточно.
Устойчивость к атакам
Второй уровень представляет собой тестирование в условиях противодействия. Злоумышленники могут использовать внедрение запросов, несанкционированные инструкции, манипуляции контекстом и другие методы, чтобы заставить модель обойти исходные правила. Типичным примером являются джейлбрейки. Исследования NIST показывают, что фиксированные защитные механизмы не могут гарантировать, что ИИ никогда не будет взломан с помощью адаптивных атак. Поэтому красная команда должна продолжать поиск новых путей атаки.
Инструменты и разрешения
Третий уровень связан с риском разрешений, характерным именно для агентов. Даже если ИИ не ведёт себя вредоносно, чрезмерные разрешения могут привести к серьёзным последствиям из-за ошибочного решения. Поэтому разрешения ИИ-агентов должны, как правило, соответствовать принципу минимально необходимых прав. Например, агенту, который только сортирует электронную почту, не нужны разрешения на перевод средств. Агенту, анализирующему данные, не следует автоматически предоставлять разрешение на удаление базы данных.
В целом это схоже с безопасностью смарт-контрактов в блокчейн-индустрии. Логика системы является лишь первым уровнем. Потенциальный ущерб также зависит от того, к каким активам система может получить доступ и какие операции способна выполнять.
Работа в реальной среде
Четвёртый уровень связан с фактической работой после запуска. ИИ в лабораторных условиях может сталкиваться с совершенно другими входными данными, чем ИИ в реальном мире. Пользователи могут предоставлять сложные инструкции, сторонние системы могут возвращать аномальные данные, а состояние сети может меняться. Поэтому оценка безопасности ИИ должна учитывать поведение системы в реальных условиях, а не основываться только на отчётах о тестировании до запуска.
Что на самом деле означает «потеря контроля над ИИ»?
Термин «потеря контроля над ИИ» легко понять неправильно. Он не обязательно означает, что ИИ внезапно обретёт сознание, подобное человеческому, и решит атаковать человечество. С технической точки зрения важнее другое: не возникло ли рассогласование между целями, разрешениями и фактическим поведением.
Агент может получить задачу, но неправильно понять цель. Он может попытаться достичь цели способом, которого разработчики не предусмотрели. Злоумышленник также может изменить его понимание задачи с помощью внедрения запроса. Если у агента при этом есть широкие разрешения, ошибка, возникшая на уровне программного обеспечения, может повлиять на внешние системы.
Поэтому ключевую проблему «потери контроля над ИИ» можно разделить на три вопроса: правильна ли цель, соответствует ли поведение этой цели и ограничены ли разрешения разумными рамками? Именно поэтому исследования безопасности ИИ всё больше сосредоточены на согласовании, то есть на обеспечении соответствия поведения системы ИИ целям и ограничениям, заданным человеком.
Как безопасность ИИ связана с обычными пользователями?
Безопасность ИИ волнует не только компании и исследователей в сфере ИИ. По мере внедрения ИИ-агентов в поиск, офисные приложения, программирование, финансовые сервисы, цифровые активы и другие области обычные пользователи могут напрямую предоставлять ИИ всё больше операционных разрешений.
Для пользователей важнее всего не вопрос о том, «уничтожит ли ИИ человечество», а более практичный вопрос: какие именно разрешения я предоставил ИИ? Если ИИ может только отвечать на вопросы, последствия неправильного ответа обычно ограничены. Если ИИ может отправлять электронные письма, изменять файлы, получать доступ к аккаунтам, запускать код или совершать финансовые операции от имени пользователя, требования к безопасности становятся совершенно иными.
При использовании инструментов ИИ с возможностью автономного выполнения задач пользователям следует обратить внимание на три аспекта: минимизированы ли разрешения, требуют ли важные действия подтверждения человека и предоставляет ли система журнал операций и возможность отменить аномальные действия.
Это особенно важно для ИИ-агентов, связанных с цифровыми активами. Если операции с подписями кошелька, переводами активов и взаимодействием со смарт-контрактами передаются автоматизированной системе, границы безопасности выходят за пределы самой модели и охватывают управление приватными ключами, механизмы подтверждения, смарт-контракты и внешние сервисы.
Фокус безопасности ИИ смещается с предотвращения всех ошибок на контроль последствий ошибок
В настоящее время безопасность ИИ вряд ли можно обеспечить с помощью универсального защитного механизма, который навсегда решит все проблемы. Модели ИИ будут обновляться, методы атак будут развиваться, а сценарии применения будут расширяться. Поэтому NIST подчёркивает необходимость постоянного тестирования красной командой и обновления защитных мер, а также важность способности ограничивать последствия уязвимостей и быстро восстанавливаться после их обнаружения.
Основной принцип прост: нельзя исходить из того, что система никогда не ошибётся. Необходимо заранее определить, что произойдёт, если ошибка всё же возникнет. Для ИИ-агентов это может включать ограничение разрешений, обязательное подтверждение действий человеком, журналирование критически важных операций, изоляцию задач повышенного риска, а также быстрое прекращение или отмену действий при аномальном поведении.
С этой точки зрения безопасность ИИ заключается не в ответе на простой бинарный вопрос о том, «убьёт ли ИИ человечество». Она связана с решением более практической инженерной задачи: по мере роста способности ИИ действовать автономно, как люди смогут продолжать понимать, что он делает и почему, а также как они смогут вернуть контроль, если что-то пойдёт не так? Именно для этого и нужна непрерывная оценка безопасности.
Итоги
Недавнее обсуждение того, может ли ИИ привести к исчезновению человечества, вновь привлекло внимание общества к безопасности ИИ. Однако важнее самих экстремальных прогнозов структурные изменения, происходящие в возможностях ИИ.
По мере перехода ИИ от чат-ботов к ИИ-агентам, способным вызывать инструменты, получать доступ к данным и автономно выполнять задачи, вопросы безопасности выходят за рамки безопасности результатов работы модели. Они также охватывают разрешения, вызовы инструментов, взаимодействие со средой и длительную автономную работу.
Поэтому безопасность ИИ не может основываться на одном тестировании до запуска. Непрерывный мониторинг, тестирование красной командой, управление разрешениями, устранение уязвимостей и восстановление после аномальных событий будут приобретать всё большее значение как инфраструктура по мере внедрения ИИ-агентов в реальные приложения.
Безопасное развитие ИИ будет в меньшей степени зависеть от поиска модели, которая никогда не ошибается, и в большей степени от создания механизмов, способных постоянно выявлять проблемы, ограничивать риски и возвращать контроль человеку.
Часто задаваемые вопросы
Действительно ли ИИ уничтожит человечество?
В настоящее время нет надёжных доказательств того, что ИИ неизбежно приведёт к исчезновению человечества. Некоторые исследователи ИИ недавно выразили обеспокоенность экстремальными рисками, однако вероятность их реализации остаётся крайне неопределённой. Более реалистичные угрозы безопасности включают кибератаки, утечки данных, ошибочные решения и злоупотребление разрешениями ИИ-агентов.
Что такое ИИ-агент?
ИИ-агент — это система ИИ, которая может автономно планировать и выполнять задачи на основе заданной цели. В отличие от традиционных чат-ботов, ИИ-агенты обычно способны вызывать внешние инструменты, получать доступ к данным и выполнять операции в реальном мире. Поэтому они обладают большей автономностью и требуют более строгого управления разрешениями и мерами безопасности.
Почему ИИ требует непрерывной оценки безопасности?
Потому что входные данные, среда и методы атак, с которыми сталкивается ИИ, продолжают меняться. Один тест отражает результаты работы системы только в определённый момент и при определённых условиях. Он не может доказать, что в будущем в системе не появятся новые уязвимости. Поэтому непрерывный мониторинг и тестирование после запуска имеют не меньшее значение.
Какой риск для безопасности ИИ-агентов является самым серьёзным?
Одним из ключевых рисков являются разрешения. Если ИИ-агент может получать доступ к аккаунтам, файлам, коду, средствам или другим внешним системам, ошибки модели или вредоносные входные данные могут превратить ошибку на уровне информации в реальную операцию.
Что обычно включает оценка безопасности ИИ?
Обычно она включает тестирование поведения модели, тестирование в условиях противодействия, тестирование красной командой, проверку вызовов инструментов, управление разрешениями, мониторинг после запуска и восстановление после аномальных событий. Для разных сценариев применения также необходимо разрабатывать стандарты тестирования безопасности с учётом особенностей каждого приложения.