Для начинающих, которые разбираются в границах возможностей ИИ, модель мира отвечает на вопрос, способна ли система предвидеть последствия действий, а не на вопрос, умеет ли она формулировать связные ответы. В разделах ниже рассматриваются определение, цикл прогнозирования, три технических подхода, выбор задач модели мира и LLM, отличия от генерации видео, сценарии применения и границы оценки. Смежные понятия разобраны в материалах Gate Learn о сверхинтеллекте (ASI) и приватном ИИ.
Основные выводы
- Ключевая способность — прогнозирование с учетом действия: по состоянию и действию система определяет следующее состояние или следующее представление для планирования и управления.
- Три распространенных подхода: обучение с подкреплением на основе модели (MBRL) и обучение в воображаемой среде, генеративное интерактивное моделирование и предиктивные представления в стиле JEPA.
- Большие языковые модели хорошо прогнозируют следующий токен, а генераторы видео поддерживают визуальную непрерывность. Однако ни один из этих подходов сам по себе не означает наличие модели мира, пригодной для планирования.
- При оценке следует учитывать имитацию физики, накопление ошибок на длинных горизонтах, сбои вне распределения данных, строгие метрики и границу с симуляторами, созданными вручную.
Что такое модель мира и какую проблему она решает?
Модель мира отвечает на практический вопрос: может ли агент до выполнения действия надежно оценить, что произойдет дальше? Без этой способности обучение зависит от реальных проб и ошибок, которые часто обходятся дорого, требуют времени или небезопасны. Автономное планирование без взаимодействия со средой также становится сложнее.
В робототехнике, автономном вождении, игровых агентах и обучении в симуляциях, особенно для воплощенных агентов в виртуальной или физической среде, обратная связь может быть дорогой или рискованной. Например, неудачная политика управления автомобилем может привести к реальной аварии еще до того, как система чему-либо научится. Модель мира переносит «пробные действия» в изученную динамику: она прокручивает развитие событий в латентном пространстве или пространстве наблюдений, а затем позволяет применить более сильную политику в реальном мире. Эта цель отличается от цели диалоговых систем, которые в основном воспроизводят знания. Она ближе к причинному предвидению в интерактивной среде.
В глоссарии NVIDIA о моделях мира они определяются как внутренние представления, помогающие ИИ понимать и прогнозировать развитие физического мира. В работе Янна ЛеКуна «Путь к автономному машинному интеллекту» предиктивные модели мира рассматриваются как шаг к более автономному интеллекту. Работа Дэвида Ха «World Models», опубликованная в 2018 году, помогла сформировать современный подход на основе машинного обучения. Агент обычно получает лишь частичные наблюдения, поэтому полное состояние среды ему напрямую недоступно. Во всех этих подходах прогнозирование служит для поддержки решений.
Как работает модель мира? Состояние, действие и цикл прогнозирования
Наиболее надежный признак системы, ориентированной на модель мира, — прогнозирование с учетом действия. Входные данные должны явно включать действие агента или управляющий сигнал, а выходом должно быть следующее состояние либо следующее представление, обусловленное этим действием.
Обычно цикл состоит из трех этапов: наблюдения кодируются в состояние, затем система учитывает предполагаемое действие и прогнозирует следующее состояние. После действия среда изменяется и возвращает новые наблюдения. При необходимости прогноз можно прокручивать дальше, используя его как новую начальную точку. Политика или планировщик сопоставляет воображаемые траектории по вознаграждению, риску или ограничениям, после чего выполняет действие. Новое наблюдение запускает кодирование заново.
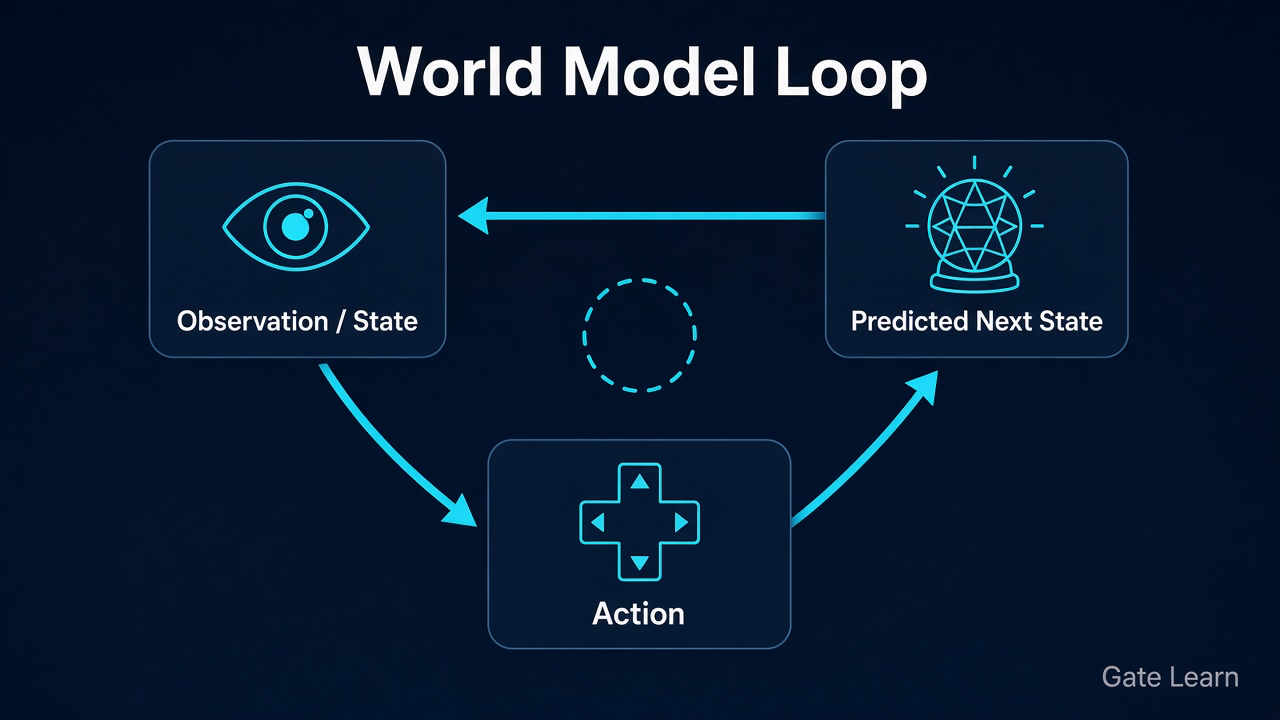
Рисунок 1. Цикл модели мира: наблюдение или состояние вместе с действием дают прогнозируемое следующее состояние, которое используется в следующем цикле.
Многие практические системы избегают долгосрочного прогнозирования в пространстве необработанных пикселей и вместо этого изучают латентную динамику. Они сжимают высокоразмерные визуальные данные в компактное состояние, а затем прокручивают развитие событий в этом пространстве. Латентные траектории снижают влияние визуального шума и делают обучение в воображаемой среде менее затратным. Однако соответствие латентного состояния реальной физике все равно необходимо проверять на последующих задачах и вне распределения данных. Это особенно важно, поскольку физическая среда наблюдается лишь частично и должна выводиться из обратной связи.
Каковы основные технические подходы к моделям мира?
«Модель мира» — это широкий термин, охватывающий несколько технических семейств, а не название одного алгоритма. Выбор начинается с задачи: управляемые политики, интерактивная пиксельная симуляция или переносимые абстрактные представления.
| Подход |
Основная идея |
Наиболее подходящие задачи |
Главная сложность |
| MBRL / обучение в воображаемой среде |
Изучение динамики с последующим обучением политики на траекториях модели (Dreamer) |
Управление, игры, обучение с подкреплением с высокой эффективностью по данным |
Ошибка модели ухудшает политику, накопление ошибок |
| Генеративное интерактивное моделирование |
Изучение интерактивной среды, генерирующей следующие кадры или наблюдения |
Дополнение данных, интерактивные видеомиры |
Внешний вид ≠ физика, затратная оценка |
| Предиктивные представления JEPA |
Прогнозирование будущих или скрытых эмбеддингов в пространстве представлений (I-JEPA) |
Обучение представлений, абстрактное прогнозирование для планирования |
Нет пикселей, требуется стек управления |
Один подход может быть основан на видеомодели, прогнозирующей будущие кадры, тогда как другой нацелен на латентную динамику, готовую для планирования, а не на полную визуальную реконструкцию.
Три подхода могут сосуществовать. Методы в стиле Dreamer акцентируют обучение политик в воображаемой среде. Генеративные видеомодели мира акцентируют интерактивную имитацию внешнего вида. I-JEPA от Meta AI демонстрирует прогнозирование в совместном пространстве эмбеддингов вместо реконструкции каждого пикселя. Разные системы также используют разные методы обучения в зависимости от того, учатся ли они на парах входных и выходных данных, траекториях управления или предиктивных эмбеддингах. Сначала необходимо сопоставить задачу, а затем обсуждать названия.
Чем модели мира отличаются от LLM и генерации видео?
Все три подхода «прогнозируют», но в рамках генеративного ИИ они прогнозируют разные объекты и по-разному учитывают действия. LLM прогнозируют следующий токен, генераторы видео — внешний вид следующего кадра, а системы, ориентированные на модели мира, — развитие состояния после действия.
| Параметр |
Модель мира |
Большая языковая модель (LLM) |
Генерация видео |
| Цель прогнозирования |
Следующее состояние или латентная динамика, часто с учетом действия |
Следующий токен или структура текста |
Внешний вид следующего кадра или клипа |
| Связь с действием |
Прогнозирование с учетом действия — основа принятия решений |
Обычно нет физического цикла управления |
Может учитывать текст или первый кадр, но не исполнимое действие |
| Типичное применение |
Планирование, управление, воплощенный ИИ |
Язык, написание текстов, оркестрация инструментов |
Создание контента, предпросмотры, интерактивные симуляции |
| Распространенная ошибка |
Способность к диалогу = модель мира |
Описание физики = знание физики |
Фотореалистичные кадры = корректная динамика |
Таким образом, генератор видео наподобие Sora может создавать согласованные кадры с высокой визуальной точностью и даже кажущейся пространственной согласованностью. Его могут называть «видеомоделью мира», однако этих свойств недостаточно, чтобы доказать понимание физики. Без стабильного интерфейса действий, проверяемых переходов состояний и цикла планирования корректнее относить такую систему к генеративному видео. Более сильная система также способна оценивать последовательности действий для поддержки планирования и принятия решений, а не только пассивно отображать вероятные виды. LLM может описать, «что произойдет, если слегка толкнуть чашку», но это не создает динамику среды, которую можно прокручивать и оценивать.
Где обычно применяются модели мира?
Воплощенный ИИ — одна из наиболее распространенных областей применения. Манипуляторам и мобильным роботам необходим пространственный интеллект: способность рассуждать о расположении объектов, движении и изменениях в физическом мире. Им также нужно прогнозировать контакт и смещение до прикосновения к объектам, поскольку многие взаимодействия сложно обратить после начала движения. Прогнозирование с учетом действия позволяет системам отбрасывать неудачные траектории в симуляции или латентном пространстве до затрат, связанных с реальными столкновениями. Демонстрации могут служить начальной основой поведения, но не заменяют обучение через взаимодействие.
Игры и обучение с подкреплением на основе модели — еще одна ключевая область. Методы в стиле Dreamer улучшают политики на воображаемых траекториях, поэтому рабочее управление может появляться при меньшем числе реальных взаимодействий. Аналогичные идеи применимы к журналам промышленного управления, где симулятор, созданный вручную, неполон, но доступна обширная история наблюдений. В этом случае модель пытается восстановить динамику системы по этой истории.
Автономное вождение, планирование работы склада и многоагентные симуляции также могут включать компоненты модели мира. Они используются не как полная замена стеков планирования, а как слой краткосрочного прогнозирования последствий. Виртуальное тестирование и отобранные видеоданные часто используются для обучения и оценки этих компонентов в различных сценариях до развертывания в реальном мире. Модуль модели мира может применяться в любой системе управления, которой необходимо «думать до действия».
Какие преимущества, риски и ограничения важны при оценке моделей мира?
Преимущества заключаются в эффективности использования данных и более безопасном методе проб и ошибок. Моделирование в воображаемой среде может сократить опасное исследование, а прогнозы с учетом действия позволяют строить планирование на проверяемой динамике. Ограничения и риски часто проявляются, когда модель выглядит корректно, но не заслуживает доверия. Качественное внутреннее представление не равнозначно поведению, которое сохранится после развертывания.
| Механизм |
Что наблюдается |
Почему это скрыто |
Вопросы для проверки |
| Имитация физики |
Плавные траектории, нарушающие законы сохранения или правила контакта |
Визуальная связность вызывает доверие |
Сохраняются ли ключевые величины? Могут ли объекты проходить друг через друга? |
| Накопление ошибок на длинных горизонтах |
Короткие траектории корректны, длинные разрушаются |
Демонстрации часто показывают короткие клипы |
Как растет ошибка с числом шагов? Есть ли перепланирование? |
| Сбой вне распределения данных |
Система дает сбой с новыми объектами, освещением или диапазонами действий |
Метрики внутри распределения выглядят высокими |
Есть ли протокол OOD? Публикуются ли режимы отказа? |
| Сложность оценки |
Нет общей метрики «понимания мира» |
Успех задачи поглощает метрику |
Сообщается ли ошибка прогнозирования помимо оценки задачи? |
| Граница с симуляторами, созданными вручную |
Обученные модели представляют как проверенные движки |
Маркетинг смешивает понятия симулятора и модели мира |
Какие ограничения заданы жестко? Какие получены только путем подгонки? |
Перенос в реальный мир затруднен из-за разрыва между симуляцией и реальностью. Хорошие тесты должны проверять, прогнозирует ли модель управляемые результаты действий, а не только создает правдоподобные визуальные образы.
Используйте таблицу как контрольный список для заявлений: сначала подтвердите наличие интерфейса с учетом действия, затем запросите доказательства для длинных горизонтов и OOD, а в конце отделите «выглядит хорошо» от «динамика пригодна для планирования». Без таких доказательств безопаснее говорить, что система «включает компоненты модели мира или исследовательские цели», а не что она «имеет полноценную модель мира». Поскольку возможности агентов ограничены, оценка должна быть сосредоточена на состоянии, важном для целей, а не на полном воспроизведении сцены.
Итоги
Модели мира переводят ИИ от способности «говорить или рисовать» к способности «предвидеть последствия действий». Например, они позволяют прогнозировать, что робот опрокинет чашку, если выберет неверную траекторию. Рабочая основа — это замкнутый цикл состояния, действия и прогнозирования, а наиболее четким критерием принятия решений служит прогнозирование с учетом действия.
Три подхода — MBRL и обучение в воображаемой среде, генеративное интерактивное моделирование и предиктивные представления JEPA — решают разные задачи и не являются взаимозаменяемыми. По сравнению с LLM и генераторами видео следует сопоставлять цели прогнозирования и интерфейсы действий. При оценке приоритет следует отдавать имитации физики, накоплению ошибок, сбоям OOD, строгим метрикам и границам с симуляторами.
Часто задаваемые вопросы
Что такое модель мира?
Модель мира — это изученная внутренняя модель динамики, представляющая возможные изменения среды при текущем состоянии или наблюдении и действии. Мир в любой момент сложнее того, что агент может непосредственно наблюдать, поэтому модель обобщает переменные, важные для планирования. Например, она может определить, где окажется робот после поворота налево. Ее цель — поддерживать планирование и пробы в воображаемой среде, а не только генерировать текст или внешний вид видео.
Чем модель мира отличается от большой языковой модели?
Большие языковые модели главным образом прогнозируют следующий токен и хорошо справляются с языком и оркестрацией знаний. Модели мира главным образом прогнозируют развитие состояния после действий для управления и планирования. LLM может обсуждать физику, не предоставляя динамику среды, которую можно прокручивать и оценивать.
Как работает модель мира?
Типичный цикл кодирует наблюдения в состояние, учитывает предполагаемое действие, прогнозирует следующее состояние после этого действия и может продолжать прогнозирование в латентном пространстве. Планировщик сравнивает воображаемые траектории, выполняет действие, а затем обновляет состояние по новому наблюдению.
Можно ли считать Sora или генерацию видео моделью мира?
Не автоматически. Если система в основном создает визуально согласованное видео без стабильного интерфейса с учетом действия, проверяемых переходов состояний и применения для планирования, ее точнее описывать как генератор видео. Она становится ближе к модели мира только тогда, когда продемонстрированы прогнозирование с учетом действия и цикл, пригодный для планирования.
Чем модель мира отличается от традиционного симулятора?
Традиционные симуляторы обычно включают вручную заданные правила физики и ограничения, тогда как модели мира на основе данных часто обучаются с помощью нейронных сетей. Обученные модели могут быть более гибкими и лучше учитывать шум датчиков, однако они также сильнее подвержены имитации физики и накоплению ошибок на длинных горизонтах. Их не следует считать эквивалентом проверенного физического движка.