В отличие от GPU, которые предназначены для широкого спектра задач массово-параллельных вычислений, LPU Groq используют архитектуру с акцентом на встроенную SRAM, статическое планирование компилятором и детерминированное выполнение. Такой подход направлен на сокращение передачи данных и накладных расходов на планирование во время инференса, обеспечивая более специализированные вычислительные возможности для ИИ-приложений реального времени.
По мере того как большие языковые модели всё чаще применяются в интеллектуальной службе поддержки, голосовом взаимодействии, ИИ-агентах и корпоративной автоматизации, требования к инференсу выходят за рамки максимальной скорости обработки. Они также включают задержку ответа, стабильность сервиса и стоимость вычислений на единицу работы. Подход со специализированными ускорителями, представленный LPU Groq, предлагает инфраструктуре ИИ техническое решение, отличающееся от традиционных архитектур вычислений общего назначения. В этой статье подробно рассматривается принцип работы LPU Groq, анализируется влияние SRAM, детерминированного выполнения и компиляторов на производительность инференса, а также обсуждаются подходящие сценарии использования и технические ограничения.
Ключевые выводы
-
Groq LPU — специализированный процессор для задач ИИ-инференса с акцентом на низкую задержку, предсказуемое выполнение и эффективную передачу данных.
-
Инференс больших языковых моделей обычно состоит из двух этапов: предварительной обработки (Prefill) и генерации (Decode). Для этих этапов требуются разные вычислительные мощности и пропускная способность памяти.
-
LPU Groq используют встроенную SRAM для сокращения некоторых путей доступа к данным, однако сравнительно ограниченная ёмкость встроенной памяти также предъявляет требования к развертыванию моделей и масштабированию на несколько чипов.
-
Детерминированное выполнение и статическое планирование компилятором могут сократить часть накладных расходов на планирование во время выполнения, но это не означает, что каждый запрос будет иметь абсолютно одинаковое время ответа.
-
LPU могут иметь преимущества в приложениях с низкой задержкой, таких как генерация текста в реальном времени и голосовое взаимодействие. Их фактическая производительность по-прежнему зависит от модели, нагрузки, конфигурации системы и стоимости услуг.
Что такое Groq LPU и чем он отличается от традиционных ускорителей ИИ?
Groq LPU — специализированный процессор для ИИ-инференса, разработанный Groq. LPU означает Language Processing Unit, или блок обработки языка. Его конструкция предназначена для оптимизации перемещения данных, выполнения вычислений и контроля задержки при инференсе языковых моделей, а не для обеспечения вычислений общего назначения для любых типов задач.
Чтобы понять техническое позиционирование LPU, необходимо сначала рассмотреть различные подходы к проектированию ускорителей ИИ. GPU изначально создавались преимущественно для обработки графики. Позднее они стали широко использоваться для обучения и инференса глубоких нейросетей благодаря возможностям масштабных параллельных вычислений и зрелой программной экосистеме. Специализированные ускорители, такие как TPU, повышают эффективность выполнения отдельных вычислительных задач за счёт оптимизации операций машинного обучения.
LPU Groq уделяют дополнительное внимание координации между компилятором и оборудованием. Их архитектура направлена на планирование вычислений и передачи данных до запуска модели. Это позволяет чипу выполнять задачи по заранее определённому расписанию и сокращать часть накладных расходов, связанных с динамическим планированием.
Этот подход к проектированию тесно связан с технологическим направлением Tensor Streaming Processor (TSP), представленным Groq на раннем этапе развития. Организуя вычислительные ресурсы, встроенное хранилище и пути передачи данных, процессор позволяет выполнять операции модели в последовательности, заданной компилятором.
Важно отметить, что LPU не является стандартизированной отраслевой категорией для всех процессоров языковых моделей. Это техническое название, используемое Groq. Разные производители могут применять различные конструкции чипов или обеспечивать инференс с низкой задержкой с помощью GPU, ASIC или других специализированных ускорителей.
Поэтому для оценки технической ценности LPU Groq недостаточно учитывать только название процессора. Необходимо анализировать, как они обрабатывают доступ к данным, планирование вычислений и межчиповую связь во время инференса.
Почему большим языковым моделям нужны вычисления с низкой задержкой?
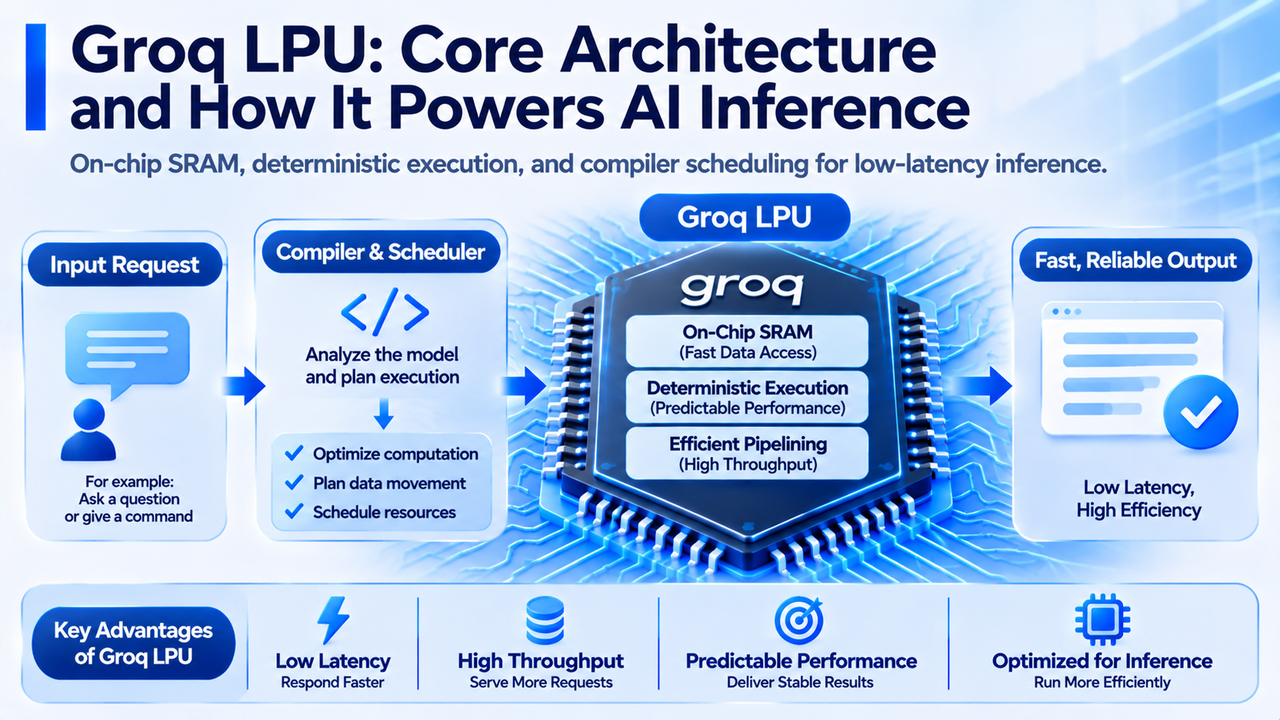
Инференс большой языковой модели — это процесс, при котором модель получает входные данные и использует обученные параметры для формирования результата. Для распространённых авторегрессионных языковых моделей инференс обычно состоит из двух этапов: предварительной обработки (Prefill) и генерации (Decode). На этапе предварительной обработки в основном обрабатывается запрос пользователя и формируется вычислительное состояние, необходимое для последующей генерации. Поскольку на этом этапе можно одновременно обрабатывать несколько входных токенов, для него обычно характерны интенсивные параллельные вычисления.
На этапе генерации выходные токены формируются по одному. Обычно модели необходимо предсказать следующий токен на основе уже имеющихся входных данных и ранее сгенерированного контента, поэтому между несколькими шагами генерации существуют зависимости. В результате эти шаги нельзя полностью распараллелить так же легко, как некоторые вычисления при обучении.
Это различие означает, что производительность инференса нельзя измерить одним показателем.
Время до первого токена (TTFT) измеряет время от начала запроса до формирования первого выходного токена. Этот показатель главным образом влияет на то, как долго пользователь ожидает ответа.
Скорость генерации токенов показывает, сколько токенов модель может создать за единицу времени после начала вывода. Она напрямую влияет на плавность непрерывной генерации текста. Пропускная способность показывает, сколько запросов или токенов система может обработать за определённый период, и отражает общую мощность сервиса инференса при сравнительно высокой одновременной нагрузке.
Например, две платформы инференса могут запускать одну и ту же языковую модель, однако платформа A может обеспечивать более быструю генерацию токенов для одного пользовательского запроса, тогда как платформа B может достигать более высокой общей пропускной способности при одновременной обработке сотен запросов.
Это означает, что низкая задержка и высокая пропускная способность не являются полностью одинаковыми целями производительности. Система, оптимизированная для взаимодействия с одним пользователем в реальном времени, может не иметь таких же преимуществ в каждом сценарии пакетной обработки или высокой одновременной нагрузки.
Для голосовых помощников, перевода в реальном времени и интерактивных ИИ-приложений особенно важны TTFT и скорость непрерывной генерации. Пользователи обычно ожидают, что система быстро начнёт отвечать и продолжит формировать естественный, связный контент.
Для таких задач, как автономный анализ документов и пакетная обработка данных, немедленное время ответа на отдельный запрос может быть менее важным. Вместо этого компании могут уделять больше внимания общей пропускной способности и стоимости обработки на единицу работы.
Одним из приоритетов при проектировании LPU Groq является оптимизация эффективности выполнения для задач инференса, чувствительных ко времени ответа.
Как LPU Groq используют SRAM для повышения эффективности доступа к данным?
Производительность современных процессоров ИИ зависит не только от количества операций, которые могут выполнять их вычислительные блоки, но и от того, поступают ли данные к этим блокам вовремя.
Во время инференса больших языковых моделей процессоры многократно считывают веса модели, обращаются к промежуточным результатам и поддерживают данные, связанные с контекстом. Если данные не удаётся считывать достаточно быстро, даже чип с высокой теоретической вычислительной мощностью может не работать на полную мощность из-за ожидания данных.
Эта проблема обычно называется узким местом памяти.
Одна из ключевых архитектурных особенностей LPU Groq заключается в акценте на использовании встроенной SRAM (статической памяти с произвольным доступом) для хранения данных и доступа к ним.
SRAM обычно обеспечивает низкую задержку доступа и может быть интегрирована непосредственно в чип процессора. По сравнению с данными, доступ к которым осуществляется через внешний интерфейс памяти, встроенное хранилище может сокращать пути передачи данных и уменьшать часть накладных расходов при доступе.
Чтобы понять эту конструкцию, полезно сравнить базовые характеристики SRAM и памяти с высокой пропускной способностью (HBM).
| Параметр сравнения |
SRAM |
HBM |
| Типичное расположение |
Внутри чипа процессора |
Отдельный стек памяти в корпусе процессора |
| Основные преимущества |
Низкая задержка доступа и тесная интеграция |
Большая ёмкость и высокая совокупная пропускная способность |
| Основные ограничения |
Высокая стоимость площади кристалла и ограниченная ёмкость |
Для доступа к данным по-прежнему требуется интерфейс памяти |
| Типичное применение |
Кэш и встроенная рабочая память |
Крупные массивы данных, такие как веса модели и активации |
| Значение для инференса |
Оптимизация отдельных путей доступа к данным |
Поддержка более крупных моделей и вычислительных состояний |
Однако нельзя просто считать, что SRAM всегда быстрее HBM или что использование SRAM устраняет узкое место памяти. Фактическая производительность также зависит от размещения данных, шаблонов параллельного доступа, пропускной способности памяти и архитектуры модели.
Основные ограничения SRAM связаны с плотностью хранения и стоимостью площади кристалла. Для языковых моделей с большим количеством параметров SRAM одного процессора обычно недостаточно для хранения всех весов модели и состояний во время выполнения.
Поэтому Groq необходимо использовать координацию нескольких чипов и распределение данных на уровне системы для запуска моделей на более крупных вычислительных системах. Это означает, что преимущества LPU не обусловлены исключительно SRAM отдельного чипа. Они являются результатом общей конструкции встроенного хранилища, вычислительных конвейеров, межчиповых соединений и компиляторов.
Как детерминированное выполнение и планирование компилятором влияют на производительность инференса?
Детерминированное выполнение — ещё одно ключевое понятие для понимания архитектуры Groq LPU. Его основная идея заключается в том, чтобы максимально заранее определить порядок выполнения вычислительных операций, пути передачи данных и распределение ресурсов до запуска программы. Это сокращает потребность во временных решениях по планированию во время выполнения.
В традиционных архитектурах вычислений общего назначения процессоры должны адаптироваться к различным типам программ и нагрузок. Для повышения использования ресурсов системы обычно включают динамическое планирование задач, управление кэшем и другие механизмы времени выполнения. Такие конструкции обеспечивают значительную гибкость, но также могут создавать дополнительные накладные расходы на планирование.
LPU Groq используют другой подход. До запуска модели компилятор анализирует её вычислительный граф и создаёт план выполнения вычислительных операций и перемещения данных. Затем процессор работает в соответствии с этим планом, обеспечивая упорядоченное перемещение данных между различными вычислительными блоками. Например, языковой модели может требоваться непрерывное выполнение матричных операций, функций активации и других вычислений. Компилятор может заранее определить, когда эти задачи будут выполняться на различных вычислительных ресурсах, и скоординировать необходимую передачу данных.
Этот подход похож на предварительное планирование каждого этапа производственной линии, чтобы разные стадии работали согласованно в заданном ритме.
Для ИИ-инференса детерминированное выполнение имеет три основных следствия.
-
Оно может сократить часть накладных расходов на планирование во время выполнения. Процессору не требуется повторно определять порядок выполнения каждой задачи на каждом вычислительном этапе, что может повысить эффективность выполнения для определённых нагрузок.
-
Оно может сделать время выполнения вычислений более предсказуемым. Для ИИ-сервисов реального времени стабильность времени ответа так же важна, как и низкая средняя задержка. Детерминированное выполнение не означает, что время ответа фактических API-запросов будет полностью фиксированным. Длина входных данных, количество выходных токенов, очереди запросов, передача по сети и нагрузка на сервис по-прежнему могут вызывать различия в сквозной задержке.
-
Статическое планирование также может снизить гибкость некоторых вычислительных задач. Если модель имеет сложный динамический поток управления или путь выполнения должен часто меняться в зависимости от результатов в реальном времени, компилятору может потребоваться применять дополнительные стратегии обработки.
Таким образом, ценность детерминированного выполнения заключается не в устранении всей неопределённости. Для подходящих вычислительных задач оно повышает эффективность использования аппаратных ресурсов за счёт более явного планирования выполнения.
Почему LPU Groq подходят для ИИ-инференса с низкой задержкой?
Конструкция LPU Groq с низкой задержкой не зависит от одной технологии. Она является результатом совокупного действия встроенной SRAM, детерминированного выполнения, оптимизации компилятором и межсоединений на уровне системы. Во время генерации большой языковой моделью необходимо непрерывно выполнять вычисления и формировать последующие токены на основе уже полученных результатов. Если процессор может сократить часть задержек доступа к данным и накладных расходов на планирование во время выполнения, он может уменьшить время, необходимое для последовательных шагов генерации.
Это особенно актуально для этапа Decode. Поскольку авторегрессионным моделям обычно необходимо генерировать токены по одному, задержка каждого шага генерации накапливается и в итоге влияет на воспринимаемую пользователями скорость вывода текста. Однако узкие места производительности разных задач инференса не всегда одинаковы. Обработка длинных запросов может сильнее зависеть от возможностей масштабных параллельных вычислений, тогда как на непрерывную генерацию могут больше влиять доступ к памяти и задержка пошагового выполнения.
Поэтому фактическую производительность LPU Groq необходимо оценивать с учётом типа модели, длины входных данных, длины вывода и количества одновременных запросов.
С точки зрения применения следующие типы сервисов особенно чувствительны к инференсу с низкой задержкой.
Голосовое взаимодействие в реальном времени. Голосовому помощнику необходимо преобразовать речь пользователя в текст, вызвать языковую модель для формирования ответа, а затем озвучить результат с помощью синтеза речи. Если языковая модель медленно генерирует ответы, в разговоре могут возникать заметные паузы.
Интерактивные ИИ-агенты. При выполнении задач ИИ-агенту может потребоваться многократно вызывать языковую модель для определения следующего действия. Каждая задержка инференса влияет на общее время выполнения задачи, поэтому сокращение времени ожидания отдельных инференсов может улучшить пользовательский опыт.
Интеллектуальная служба поддержки и приложения реального времени. Онлайн-сервисы, обслуживающие большое количество пользователей, должны не только быстро отвечать, но и контролировать колебания задержки между запросами для поддержания стабильного качества обслуживания.
Однако низкая задержка не обязательно означает самую низкую стоимость вычислений на единицу работы. Например, платформа инференса может быстро обрабатывать отдельный запрос, но если её оборудование дорого в приобретении или значительные ресурсы простаивают при низкой нагрузке, фактическая стоимость обслуживания на миллион токенов всё равно может превышать показатели других решений. И наоборот, другая платформа может медленнее генерировать токены для отдельных запросов, но одновременно обслуживать многих пользователей с помощью пакетной обработки и в итоге достигать более низкой средней стоимости.
Поэтому при выборе платформы инференса компаниям необходимо сопоставлять задержку, пропускную способность, стоимость и совместимость с моделями, а не принимать решение исключительно на основе количества токенов в секунду.
Каковы технические ограничения LPU Groq?
Хотя LPU Groq специально оптимизированы для ИИ-инференса, специализированная архитектура не означает, что они будут превосходить другие решения в каждой вычислительной задаче. Их основные технические ограничения связаны с ёмкостью памяти, масштабированием на несколько чипов, совместимостью моделей и стоимостью системы.
Ограничения ёмкости встроенной SRAM. Поскольку SRAM имеет сравнительно низкую плотность хранения, объём встроенного хранилища на одном чипе ограничен. Когда параметры модели и состояния во время выполнения превышают ёмкость одного чипа, вычисления и данные необходимо распределять между многочиповой системой.
Например, большой языковой модели может требоваться десятки гигабайт памяти или больше. Обычно сложно хранить все эти данные, используя только встроенную SRAM одного чипа. Поэтому система должна распределять модель по нескольким процессорам и использовать межчиповые соединения для необходимого обмена данными.
Такой подход может увеличить размер моделей, доступных для развертывания, но также повышает сложность проектирования системы.
Накладные расходы на межчиповую связь. Даже если отдельный LPU может быстро выполнять вычисления, на общую скорость инференса всё равно могут влиять пропускная способность межсоединений, задержка связи и стратегии распределения данных, когда модели требуется частая передача данных между чипами. В крупномасштабных системах инференса производительность зависит не только от вычислительной мощности отдельного процессора, но и от согласованной работы всего кластера чипов.
Совместимость моделей. LPU Groq используют компиляторы для отображения вычислений модели на специализированное оборудование и поэтому нуждаются в соответствующей поддержке программного обеспечения. Когда новые ИИ-модели внедряют другие вычислительные операторы, механизмы внимания или методы динамического выполнения, платформе может потребоваться обновление компилятора и среды выполнения. По сравнению с GPU общего назначения, имеющими широкие программные экосистемы, специализированные процессоры инференса требуют постоянной разработки ПО для адаптации к быстро меняющимся технологиям моделей.
Инфраструктурные и коммерческие затраты. Преимущества LPU в производительности требуют полноценной вычислительной системы. Фактическое развертывание по-прежнему связано с расходами на производство чипов, серверы, сети, электроснабжение и системы охлаждения. Для поставщиков облачных сервисов инференса использование оборудования и спрос клиентов также определяют окупаемость инвестиций.
Поэтому LPU Groq следует оценивать вместе с фактическими условиями их развертывания. Высокая скорость генерации токенов в конкретном тесте не доказывает напрямую более высокую экономическую эффективность для всех моделей и коммерческих сценариев.
Что LPU Groq означают для будущего инфраструктуры ИИ-инференса?
Развитие LPU Groq отражает растущую специализацию рынка вычислений для ИИ. По мере расширения генеративных ИИ-приложений компании начинают выбирать более специализированные вычислительные архитектуры для разных нагрузок, а не сосредотачиваться только на теоретической пиковой производительности одного процессора.
При обучении моделей по-прежнему важны масштабные параллельные вычисления, ёмкость памяти и связь между несколькими устройствами. В инференсе более прямыми коммерческими показателями стали TTFT, скорость непрерывной генерации, пропускная способность при одновременной нагрузке и стоимость на токен.
Различия между вычислительными задачами создают возможности для развития специализированных чипов инференса. В то же время специализированные процессоры и GPU не обязательно имеют исключительно взаимозаменяемые отношения. В марте 2026 года NVIDIA представила архитектуру инференса, объединяющую Groq 3 LPX с платформой Vera Rubin, исследуя возможности использования разных типов вычислительных устройств для задач инференса, соответствующих их характеристикам.
Это направление отражает тенденцию развития гетерогенных вычислений. В будущем центры обработки данных для ИИ могут одновременно использовать GPU, специализированные ускорители инференса и другие вычислительные устройства, а программные системы будут координировать выполнение различных задач.
Например, подходящие ресурсы GPU можно использовать для нагрузок, требующих масштабной параллельной обработки, тогда как специализированные процессоры инференса могут давать преимущества для некоторых задач генерации, особенно чувствительных к задержке. Однако гетерогенные вычисления не означают, что простое добавление большего числа типов чипов повысит эффективность. Системам также необходимо решать вопросы межустройственной связи, планирования задач, совместимости программного обеспечения и инфраструктурных затрат.
Для отрасли ИИ-чипов это означает, что конкуренция расширяется от производительности отдельных аппаратных компонентов до эффективности полноценных вычислительных систем. Архитектура процессоров, компиляторы, системы памяти, технологии межсоединений и эксплуатация облачных сервисов могут стать факторами, определяющими итоговую производительность и коммерческую ценность.
Технологический подход, представленный LPU Groq, служит конкретным примером этого сдвига. Их долгосрочная ценность будет зависеть не только от скорости инференса определённого поколения чипов, но и от способности адаптироваться к развитию моделей и превращать техническую производительность в стабильные масштабируемые вычислительные сервисы.
Заключение
Groq LPU — специализированный процессор для ИИ-инференса. Он использует такие технологии, как встроенная SRAM, детерминированное выполнение и статическое планирование компилятором, чтобы оптимизировать доступ к данным и выполнение вычислений для определённых нагрузок больших языковых моделей.
По сравнению с GPU общего назначения LPU Groq уделяют больше внимания низкой задержке и предсказуемости выполнения для конкретных задач инференса. Такая конструкция подходит для исследования оптимизации производительности в приложениях, таких как генерация текста в реальном времени, голосовое взаимодействие и ИИ-агенты, но не означает, что LPU могут заменить GPU во всех сценариях использования моделей и вычислений.
В то же время ёмкость SRAM, межчиповая связь, адаптация моделей и инфраструктурные затраты остаются важными вопросами, которые необходимо решать специализированным архитектурам инференса.
По мере расширения отрасли ИИ от разработки моделей к масштабным приложениям конкуренция в области вычислений для инференса смещается от простого максимального увеличения вычислительной мощности к оптимизации задержки, пропускной способности, стоимости и общей эффективности системы. Развитие LPU Groq показывает, что специализированные ускорители могут играть более важную роль в будущей инфраструктуре ИИ, однако их фактическую ценность ещё необходимо подтвердить конкретными нагрузками и результатами коммерческого развертывания.
Часто задаваемые вопросы
Что такое Groq LPU?
Groq LPU — специализированный процессор для ИИ-инференса, разработанный Groq. Он главным образом использует такие технологии, как встроенная SRAM, детерминированное выполнение и планирование компилятором, чтобы оптимизировать отдельные задачи инференса языковых моделей.
Каковы основные различия между LPU и GPU?
LPU уделяют больше внимания оптимизации выполнения и передачи данных для конкретных задач инференса, тогда как GPU предлагают широкие возможности параллельных вычислений и зрелую программную экосистему. Различия в их производительности зависят от конкретной модели и среды выполнения.
Почему LPU Groq используют SRAM?
SRAM обеспечивает доступ к данным на чипе с низкой задержкой, что может помочь сократить накладные расходы на считывание данных в отдельных задачах инференса. Однако ёмкость SRAM ограничена, поэтому для развертывания крупных моделей обычно требуется координация нескольких чипов.
Что означает детерминированное выполнение?
Детерминированное выполнение означает максимально возможное предварительное планирование порядка вычислений, передачи данных и распределения ресурсов до запуска программы. Это может сократить часть накладных расходов на планирование во время выполнения и сделать выполнение вычислений более предсказуемым.
Можно ли использовать LPU Groq для обучения ИИ-моделей?
LPU Groq в первую очередь предназначены для задач инференса и не ориентированы главным образом на обучение крупномасштабных моделей общего назначения. Их фактическая поддержка зависит от аппаратной архитектуры и набора программных инструментов.
Всегда ли LPU Groq быстрее GPU NVIDIA при инференсе?
Не обязательно. На результаты могут влиять разные модели, длина входных и выходных данных, уровень одновременной нагрузки и условия тестирования. Более высокая скорость генерации токенов для одного пользователя не обязательно означает более высокую общую пропускную способность или меньшую стоимость на токен.
Почему LPU Groq подходят для ИИ-агентов?
ИИ-агентам может требоваться последовательно выполнять несколько вызовов инференса. Сокращение задержки ответа на каждый запрос может уменьшить время выполнения всей задачи, однако итоговый результат также зависит от вызовов инструментов, передачи по сети и других этапов обработки.