Bagi pembaca yang memilih berdasarkan tugas, kuncinya bukan “mana yang lebih kuat”, melainkan apakah kegagalan lebih merugikan sebagai omong kosong yang fasih atau sebagai penyimpangan dinamika. Bagian di bawah ini membandingkan model dunia dengan LLM berdasarkan target prediksi, data/evaluasi, kecocokan tugas, aturan penggabungan, dan kesalahpahaman. Batas kemampuan dibahas bersama Superinteligensi (ASI); batas penerapan dibahas bersama AI Privat.
Poin Utama
- Model dunia mengoptimalkan dinamika keadaan berikutnya / laten yang dikondisikan oleh tindakan; LLM mengoptimalkan token berikutnya dan struktur teks.
- Utamakan model dunia untuk perencanaan dan kontrol berwujud; utamakan LLM untuk penulisan, tanya jawab yang didukung pengambilan informasi, dan pemanggilan alat.
- Saat suatu pekerjaan memerlukan antarmuka bahasa sekaligus dinamika lingkungan yang dapat di-rollout, gabungkan keduanya alih-alih menganggapnya sebagai pengganti satu sama lain.
- Mode kegagalan berbeda: LLM sering gagal melalui halusinasi bahasa; model dunia melalui penyimpangan dinamika dan fisika palsu.
Apa Itu Model Dunia?
Model dunia adalah sistem dinamika terpelajar: berdasarkan keadaan saat ini (atau observasi) dan tindakan kandidat, sistem ini memprediksi bagaimana lingkungan akan berubah agar agen dapat mencoba tindakan dalam imajinasi sebelum membuat rencana. Sumbu keputusan yang paling jelas adalah prediksi yang dikondisikan oleh tindakan—bukan kefasihan percakapan.
Berbeda dari sistem yang hanya menghasilkan teks atau tampilan, tumpukan berorientasi model dunia menghubungkan prediksi ke dalam perulangan perencanaan, kontrol, atau pelatihan imajinasi. Pendekatan umum mencakup RL berbasis model (misalnya Dreamer), simulasi interaktif generatif, dan prediksi representasi bergaya JEPA; tujuannya berbeda sehingga nama merek tidak dapat dipertukarkan.
Apa Itu Model Bahasa Besar?
Model bahasa besar (LLM) adalah model generatif yang dilatih pada korpus teks besar dengan prediksi token berikutnya sebagai tujuan utamanya. LLM unggul dalam pemahaman bahasa, peringkasan, penerjemahan, bantuan pengodean, serta orkestrasi teks multilangkah melalui prompt dan antarmuka alat.
LLM dapat menjelaskan dunia fisik atau menulis langkah untuk “apa yang terjadi jika Anda mendorong cangkir”, tetapi deskripsi bukanlah dinamika lingkungan yang dapat di-rollout dan dievaluasi. Tanpa antarmuka tindakan–keadaan dan pemeriksaan loop tertutup, memperlakukan LLM sebagai pengontrol atau mesin fisika adalah kesalahan pemilihan—bukan masalah “model terlalu kecil”.
Bagaimana Perbedaan Target Prediksi?
Perbedaan utamanya adalah objek prediksi: model dunia memprediksi keadaan berikutnya atau dinamika laten setelah suatu tindakan; LLM memprediksi token berikutnya dan struktur teks. Keduanya “memprediksi”, tetapi tidak memiliki satu standar keberhasilan yang sama.
| Fitur |
Model Dunia |
LLM |
| Target prediksi |
Keadaan berikutnya / dinamika laten (sering dikondisikan oleh tindakan) |
Token berikutnya / teks dan mengikuti instruksi |
| Keterkaitan dengan tindakan |
Prediksi yang dikondisikan oleh tindakan adalah sumbu keputusan |
Biasanya tidak memodelkan loop kontrol fisik |
| Bentuk keluaran |
Keadaan, representasi, lintasan, atau observasi interaktif |
Teks, kode, argumen pemanggilan alat |
| Kriteria keberhasilan |
Konsekuensi yang dapat diperiksa, dapat direncanakan, kesalahan yang dapat dilacak |
Ketepatan semantik, format yang dapat digunakan, sitasi yang dapat diperiksa |
| Kegagalan umum |
Penyimpangan dinamika, fisika palsu |
Halusinasi bahasa, sitasi palsu |
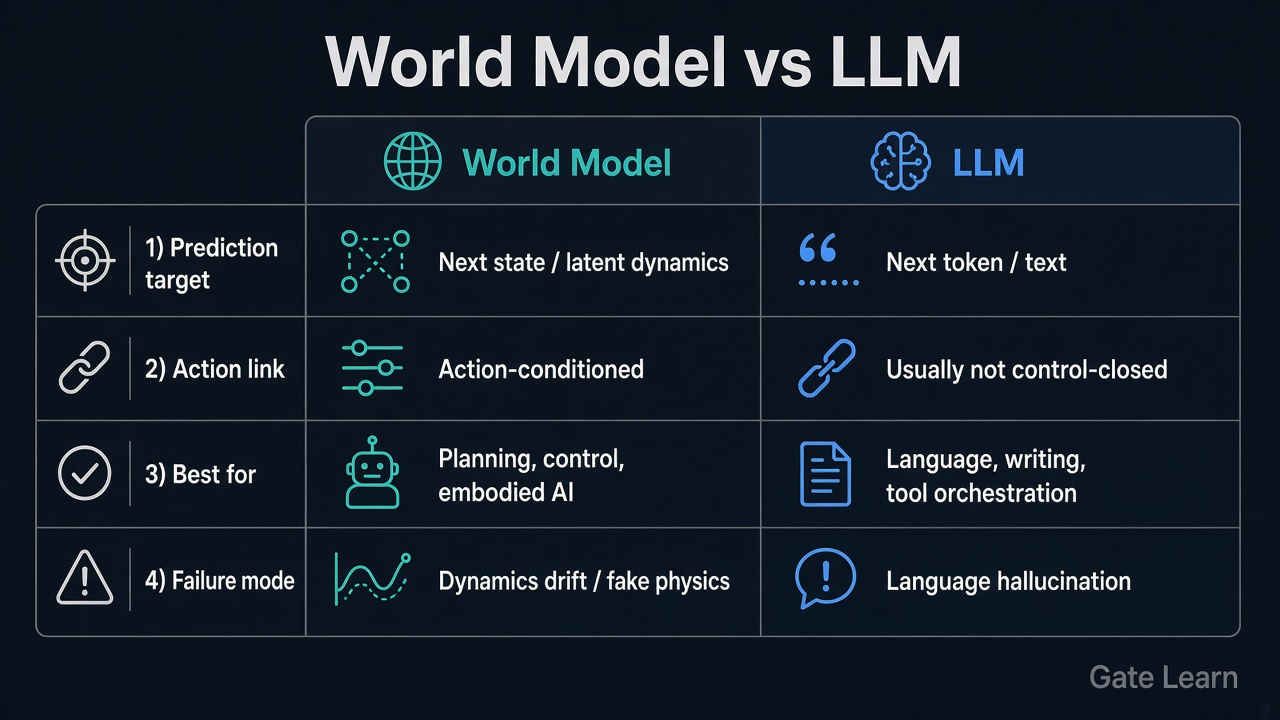
Gambar 1. Kontras empat aspek antara model dunia dan LLM: target prediksi, keterkaitan tindakan, tugas yang paling sesuai, dan mode kegagalan.
JEPA dan LLM sering disamakan. JEPA (misalnya I-JEPA Meta AI) memprediksi representasi masa depan abstrak dalam ruang embedding gabungan dan berorientasi pada model dunia; LLM tetap merupakan sistem pemodelan bahasa. Nama yang mirip tidak berarti dapat dipertukarkan. Lihat Glosarium NVIDIA: Model Dunia dan pembahasan jalur LeCun (Jalur Menuju Kecerdasan Mesin Otonom).
Bagaimana Perbedaan Data, Keluaran, dan Evaluasi?
Data dan evaluasi mengikuti target prediksi: model dunia mengandalkan lintasan interaktif, transisi keadaan, sinyal kontrol, dan terkadang video; LLM mengandalkan korpus, data instruksi, dan (opsional) log alat. Penggunaan hilir menentukan metrik kesalahan.
| Dimensi |
Model Dunia |
Model Bahasa Besar |
| Data umum |
Lintasan observasi–tindakan–observasi berikutnya / imbalan (terkadang termasuk video) |
Teks, dialog, kode, jejak alat |
| Keluaran utama |
Keadaan berikutnya, dinamika laten, lintasan imajiner |
Teks, jawaban terstruktur, pemanggilan fungsi |
| Fokus evaluasi |
Kesalahan multilangkah, keberhasilan tugas, ketahanan OOD |
Ketepatan, kesetiaan, format, dan keamanan |
| Masalah yang sulit terdeteksi |
Fisika palsu yang tampak mulus; pertumbuhan kesalahan jangka panjang |
Halusinasi fasih; sitasi yang gagal diperiksa |
Menggunakan “tulis paragraf fisika yang benar” untuk mengesahkan model dunia, atau “klipnya terlihat bagus” untuk mengesahkan loop kontrol LLM, berarti menukar sumbu evaluasi. Tetapkan terlebih dahulu keluaran yang dapat diperiksa, lalu pilih keluarga model.
Tugas Apa yang Lebih Cocok untuk Model Dunia? Tugas Apa yang Lebih Cocok untuk LLM?
Mulailah dari lokasi biaya kegagalan—fisika/kontrol atau semantik/komunikasi. Utamakan model dunia untuk yang pertama dan LLM untuk yang kedua. Saat keduanya harus terpenuhi, gunakan “harus digabungkan” alih-alih memaksakan satu pemenang.
| Kondisi tugas |
Utamakan model dunia |
Utamakan LLM |
Saat penggabungan diperlukan |
| Memerlukan prediksi tindakan → keadaan berikutnya secara eksplisit |
Ya |
Tidak |
— |
| Memerlukan antarmuka bahasa alami, pembuatan dokumentasi/kode |
Tidak |
Ya |
— |
| Perencanaan berwujud; menyaring lintasan yang gagal sebelum kontak, seperti pada kendaraan otonom |
Ya |
Tidak (LLM hanya dapat menjelaskan) |
LLM untuk instruksi; model dunia untuk dinamika yang di-rollout |
| Tanya jawab yang didukung pengambilan informasi, penulisan, orkestrasi alat |
Tidak |
Ya |
— |
| Melatih kebijakan dalam imajinasi (MBRL) |
Ya |
Tidak |
LLM dapat menyusun teks tugas; dinamika tetap memerlukan model dunia |
| Dialog untuk tujuan ditambah loop kontrol yang dapat dieksekusi |
Tidak cukup jika sendiri |
Tidak cukup jika sendiri |
Harus digabungkan: LLM mengurai tujuan → model dunia / perencana mengeksekusi |
“Harus digabungkan” sesuai dengan pola umum: LLM menangani maksud dan antarmuka; model dunia (atau simulator ditambah dinamika terpelajar) menangani prediksi konsekuensi dan penyaringan lintasan. Menghilangkan salah satu sisi sering kali menyebabkan sistem jatuh ke mode kegagalan sisi lainnya.
Kapan Anda Harus Menggabungkan Keduanya?
Gabungkan keduanya ketika tugas mencakup tujuan pada lapisan bahasa sekaligus konsekuensi pada lapisan lingkungan—jangan memperdebatkan penggantian. Rangkaian umum: LLM mengubah tujuan menjadi subtujuan atau batasan; model dunia melakukan rollout tindakan kandidat; perencana memilih lintasan berdasarkan biaya dan keamanan; eksekusi menghasilkan observasi baru yang memperbarui keadaan.
Penggabungan bukanlah “menggabungkan dua prompt”. Antarmuka harus eksplisit: tujuan terstruktur apa yang dihasilkan LLM, tindakan apa yang diterima model dunia, serta bagaimana kesalahan multilangkah memicu perencanaan ulang atau fallback konservatif. Tanpa kontrak tersebut, sistem tampak seperti “ucapan fasih, gerakan rusak” atau “lintasan indah, instruksi tidak sesuai”.
Penggabungan ketat juga kurang sesuai ketika tanya jawab dokumen murni hampir tidak memerlukan model dunia, atau ketika servoing tingkat rendah sudah memiliki dinamika andal dan tidak memerlukan LLM umum. Nilai penggabungan berasal dari pembagian tugas—bukan jumlah model.
Kesalahan Penilaian dan Risiko Apa yang Muncul Saat Memilih?
Kesalahpahaman yang paling umum adalah menganggap “dapat berbicara tentang fisika” sebagai “dapat melakukan fisika”, serta “frame/lintasan yang indah” sebagai “dinamika yang dapat direncanakan”. Kedua keluarga model gagal dengan cara berbeda; mencampurkan pemeriksaan penerimaan meningkatkan risiko penerapan.
| Mode kegagalan |
Lebih umum pada |
Wujudnya |
Risiko pemilihan |
Cara mendeteksinya |
| Halusinasi bahasa |
LLM |
Fakta/sitasi yang fasih tetapi salah |
Satu-satunya sumber pengetahuan atau “manual” kontrol |
Wajibkan asal-usul, pemeriksaan alat, tolak klaim tanpa dukungan |
| Penyimpangan dinamika |
Model dunia |
Langkah pendek baik; rollout panjang terdistorsi |
Kepercayaan loop terbuka pada horizon panjang |
Buat grafik kesalahan vs. horizon; periksa perencanaan ulang |
| Fisika palsu |
Model dunia |
Lintasan mulus yang melanggar kontak/kekekalan |
Demo visual sebagai penerimaan fisika |
Periksa penetrasi, energi, batasan kontak |
| Memperlakukan LLM sebagai simulator |
Ketidaksesuaian pemilihan |
Deskripsi teks menggantikan transisi keadaan |
Tugas berwujud tanpa loop yang dikondisikan oleh tindakan |
Tanyakan antarmuka tindakan dan keadaan yang dapat di-rollout |
| Memperlakukan model dunia sebagai mesin percakapan |
Ketidaksesuaian pemilihan |
Memaksakan prediksi keadaan ke dalam tanya jawab dukungan |
Biaya tinggi, UX bahasa lemah |
Tanyakan apakah kualitas teks adalah tugas utama |
Pemeriksaan risiko harus terikat pada pemicu: jika pekerjaan utamanya adalah ketepatan semantik, kelola halusinasi terlebih dahulu; jika utamanya adalah konsekuensi kontrol, kelola penyimpangan dan fisika palsu terlebih dahulu. Narasi kemampuan tidak menggantikan pemeriksaan penerimaan.
Ringkasan
Model dunia dan model bahasa besar menyelesaikan masalah prediksi yang berbeda: yang pertama menargetkan konsekuensi tindakan dan dinamika yang dapat direncanakan; yang kedua menargetkan bahasa dan orkestrasi alat. Untuk pemilihan, tetapkan sisi mana yang menanggung biaya kegagalan, lalu gunakan tabel kondisi untuk penggunaan tunggal atau penggabungan.
Prediksi representasi bergaya JEPA berorientasi pada model dunia dan bukan LLM. Pada saat penerimaan, periksa halusinasi bahasa secara terpisah dari penyimpangan dinamika / fisika palsu agar satu demo tidak dapat menyembunyikan mode kegagalan lainnya.
FAQ
Apa perbedaan antara model dunia dan model bahasa besar?
Model dunia terutama memprediksi keadaan berikutnya atau dinamika laten setelah suatu tindakan untuk perencanaan dan kontrol; LLM terutama memprediksi token berikutnya untuk pemahaman bahasa, pembuatan konten, dan orkestrasi alat. Keduanya dapat “menghasilkan”, tetapi keberhasilan berarti konsekuensi yang dapat diperiksa dibandingkan semantik dan format yang dapat digunakan.
Dapatkah model dunia menggantikan model bahasa besar?
Biasanya tidak. Model dunia tidak secara alami menyediakan antarmuka bahasa yang kuat atau orkestrasi teks skala besar; LLM tidak secara alami menyediakan dinamika yang dikondisikan oleh tindakan dan dapat di-rollout. Utamakan LLM untuk tugas bahasa dan tambahkan komponen model dunia ketika tugas memerlukan konsekuensi lingkungan.
Kapan Anda harus menggunakan model dunia?
Gunakan sistem berorientasi model dunia ketika tugas harus memprediksi keadaan berikutnya dari keadaan dan tindakan, lalu merencanakan, mengontrol, atau mencoba tindakan dalam imajinasi. Contoh umum mencakup perencanaan berwujud, RL berbasis model, dan prediksi konsekuensi jangka pendek. Penulisan murni atau tanya jawab dokumen biasanya bukan kecocokan utama.
Bagaimana hubungan JEPA dan LLM?
JEPA (Joint Embedding Predictive Architecture) memprediksi representasi masa depan atau representasi yang dimasker dalam ruang embedding dan termasuk pembelajaran representasi terkait model dunia; LLM berpusat pada prediksi token berikutnya. Keduanya dapat berada dalam tumpukan agen, tetapi tujuan dan metriknya berbeda—JEPA bukanlah “LLM lain”.
Dapatkah Anda menggunakan keduanya bersama-sama?
Ya—dan untuk pekerjaan yang memadukan instruksi bahasa alami dengan eksekusi dalam lingkungan, penggabungan sering kali diperlukan: LLM mengurai tujuan dan batasan; model dunia atau perencana memprediksi konsekuensi serta menyaring lintasan. Kuncinya adalah antarmuka yang jelas dan pemicu perencanaan ulang, bukan merangkai keduanya dalam satu prompt.