Pada 3 November 2026, AMD melaporkan hasil keuangan kuartal ketiganya, dengan pendapatan kuartalan mencapai $13,377 miliar, naik 45% secara tahunan. Pendapatan pusat data mencapai $8,546 miliar, naik 97% secara tahunan. Perusahaan memperkirakan pendapatan kuartal keempat sekitar $17 miliar dan menekankan bahwa GPU Instinct, CPU EPYC, serta sistem skala rak Helios akan bersama-sama mendorong pertumbuhan bisnis pusat datanya. Perkembangan ini meningkatkan perhatian investor terhadap kemampuan AMD untuk merebut pangsa lebih besar di pasar komputasi AI yang didominasi oleh NVIDIA.
Namun, persaingan chip AI bukan sekadar perbandingan kinerja produk dari dua perusahaan. Kapasitas memori GPU, throughput inferensi, kompatibilitas perangkat lunak, jaringan, konsumsi daya, dan total biaya kepemilikan semuanya dapat memengaruhi keputusan pengadaan oleh penyedia layanan cloud besar. Artikel ini menganalisis dinamika persaingan antara AMD dan NVIDIA melalui karakteristik teknis inferensi AI, serta arti perubahan ini bagi industri chip AI dan investor saham AS terkait.
Poin Utama
-
Persaingan chip AI berkembang dari komputasi pelatihan menuju efisiensi inferensi. Seiring aplikasi model bahasa besar berkembang, biaya komputasi, kecepatan respons, dan konsumsi daya selama inferensi menjadi faktor penting dalam pengadaan pusat data.
-
AMD memperluas bisnis AI pusat datanya. Pada kuartal ketiga 2026, pendapatan pusat data AMD mencapai sekitar $8,55 miliar, naik 97% secara tahunan, sehingga mendorong total pendapatan perusahaan ke rekor tertinggi.
-
Keunggulan kompetitif NVIDIA tidak hanya mencakup perangkat keras GPU. Ekosistem perangkat lunak CUDA, jaringan, alat pengembang, dan sistem rak terintegrasinya menyediakan kemampuan integrasi sistem yang kuat untuk penerapan infrastruktur AI berskala besar.
-
AMD berupaya membangun alternatif komprehensif melalui GPU Instinct, Helios, dan ROCm. Fokus persaingannya secara bertahap beralih dari kinerja chip individual ke kemampuan komputasi tingkat sistem dan total biaya kepemilikan.
-
Meningkatnya permintaan inferensi AI tidak serta-merta berarti saham AMD atau NVIDIA akan naik. Investor juga perlu memantau kemampuan pengiriman chip, margin laba, belanja modal pelanggan, dan valuasi pasar.
Apa Itu Inferensi AI? Apa Perbedaannya dengan Pelatihan Model AI?
Inferensi AI mengacu pada proses komputasi ketika model kecerdasan buatan yang telah dilatih menghasilkan prediksi, teks, gambar, atau keluaran lain berdasarkan masukan pengguna. Sebagai contoh, ketika pengguna mengajukan pertanyaan kepada asisten AI dan model secara bertahap menghasilkan respons berdasarkan masukan tersebut, proses itu adalah inferensi. Berbeda dari pelatihan yang terus menyesuaikan parameter model, inferensi standar terutama menggunakan parameter model yang sudah ada untuk melakukan komputasi. Namun, beberapa sistem inferensi juga dapat mencakup pengambilan data, pemanggilan alat, dan langkah komputasi tambahan.
Pelatihan AI dan inferensi memiliki kebutuhan sumber daya komputasi yang sangat berbeda. Pelatihan model besar biasanya memerlukan banyak GPU untuk bekerja bersama dalam waktu lama, sehingga menuntut kinerja komputasi, kapasitas memori, dan interkoneksi berkecepatan tinggi. Inferensi lebih menekankan waktu respons permintaan, jumlah tugas yang dapat diproses per satuan waktu, serta biaya komputasi yang diperlukan untuk setiap permintaan. Untuk aplikasi seperti obrolan waktu nyata dan asisten suara, pengguna sangat peka terhadap latensi respons. Untuk tugas pemrosesan teks batch atau analisis data, throughput keseluruhan dan biaya mungkin lebih penting.
| Dimensi Perbandingan |
Pelatihan AI |
Inferensi AI |
| Tujuan utama |
Mempelajari dan mengoptimalkan parameter model |
Menggunakan model untuk menghasilkan hasil |
| Karakteristik komputasi |
Komputasi berskala besar dan berdurasi panjang |
Pemrosesan permintaan berkelanjutan dengan frekuensi tinggi |
| Metrik utama |
Kecepatan pelatihan, efisiensi penskalaan |
Latensi, throughput, biaya per unit |
| Kebutuhan memori |
Parameter, gradien, dan status pelatihan |
Bobot model, KV Cache, dan lainnya |
| Kasus penggunaan bisnis |
Pengembangan model dasar |
Asisten AI, pencarian, Agent, aplikasi perusahaan |
Seiring aplikasi AI berkembang, permintaan inferensi dapat terus meningkat. Sebagai contoh, sebuah model mungkin hanya memerlukan sejumlah terbatas pelatihan berskala besar, tetapi dapat melayani jutaan pengguna dalam jangka panjang setelah diterapkan. Hal ini menciptakan kemungkinan bahwa pengeluaran inferensi kumulatif menjadi sumber utama biaya infrastruktur AI. Namun, rasio pengeluaran pelatihan terhadap inferensi sangat berbeda antar model dan aplikasi, sehingga tidak dapat diasumsikan bahwa biaya inferensi akan selalu melampaui biaya pelatihan.
Mengapa Inferensi AI Menjadi Fokus Persaingan antara AMD dan NVIDIA?
Pasar inferensi AI semakin mendapat perhatian terutama karena model bisnis AI berkembang dari persaingan kemampuan model menjadi persaingan biaya penggunaan aktual. Bagi penyedia layanan cloud dan pengembang aplikasi AI, kemampuan model untuk menyelesaikan tugas hanyalah persyaratan dasar. Kemampuannya untuk terus menyediakan layanan kepada banyak pengguna dengan biaya yang wajar juga menentukan apakah produk tersebut dapat dikomersialkan. Seiring jumlah pengguna dan frekuensi pemanggilan meningkat, bahkan penurunan kecil pada biaya per inferensi dapat memberikan dampak berarti terhadap total biaya operasional.
Beban kerja inferensi tidak identik. Percakapan waktu nyata membutuhkan latensi rendah, model penalaran kompleks mungkin perlu menghasilkan proses penalaran yang panjang, dan AI Agent dapat memanggil model, mengambil data, serta menjalankan alat beberapa kali dalam satu tugas. Beban kerja yang berbeda memiliki kebutuhan berbeda terhadap presisi komputasi, kapasitas memori, bandwidth memori, dan interkoneksi sistem. Hal ini menciptakan ruang persaingan bagi arsitektur perangkat keras yang berbeda dan membuat sulit untuk menentukan chip mana yang lebih unggul berdasarkan satu metrik kinerja.
Bagi AMD, pentingnya pasar inferensi terletak pada potensinya untuk memperluas pangsa pasar GPU AI. Penyedia layanan cloud besar biasanya berupaya menghindari ketergantungan berlebihan pada satu pemasok sambil mengendalikan biaya pengadaan perangkat keras. Jika AMD dapat menawarkan alternatif yang selaras dalam hal kinerja, harga, kompatibilitas perangkat lunak, dan kemampuan pengiriman, AMD mungkin dapat berpartisipasi dalam lebih banyak rencana pengadaan pusat data. Namun, NVIDIA juga terus mengoptimalkan produk inferensi dan platform perangkat lunaknya, sehingga pertumbuhan permintaan inferensi tidak serta-merta berarti posisi kompetitif NVIDIA akan melemah.
Bagaimana Kinerja Bisnis Pusat Data AMD Baru-Baru Ini?
Hasil kuartal ketiga AMD yang diumumkan pada November 2026 menunjukkan bahwa pusat data telah menjadi salah satu sumber pertumbuhan bisnis terpenting perusahaan. Total pendapatan mencapai $13,377 miliar, naik 45% secara tahunan, sementara pendapatan pusat data mencapai $8,546 miliar, naik 97% secara tahunan. Pada periode yang sama, laba per saham non-GAAP mencapai $2,09, naik 74% secara tahunan, yang mencerminkan kontribusi ekspansi pusat data terhadap profitabilitas keseluruhan.
Perlu diperhatikan bahwa bisnis pusat data AMD tidak hanya mencakup GPU AI Instinct, tetapi juga CPU server EPYC. Oleh karena itu, tidak semua pendapatan pusat data dapat langsung diperlakukan sebagai pendapatan chip inferensi AI. Pertumbuhan bisnis perusahaan didorong oleh permintaan akselerator AI serta permintaan komputasi server serbaguna. Bagi investor, untuk menentukan apakah AMD benar-benar memperluas pangsa pasar GPU AI memerlukan pengamatan lebih lanjut terhadap pengiriman produk, penerapan pelanggan, dan komposisi bisnis spesifik.
AMD juga memperkirakan total pendapatan sekitar $17 miliar pada kuartal keempat 2026, melanjutkan pertumbuhan dari kuartal ketiga. Perusahaan juga memajukan penerapan sistem skala rak Helios dan memperluas kerja sama dengan penyedia layanan cloud besar serta perusahaan AI. Perkembangan ini menunjukkan bahwa AMD berupaya berevolusi dari pemasok chip menjadi penyedia infrastruktur AI yang lebih komprehensif. Namun, apakah pendapatan di masa depan dapat terus tumbuh masih bergantung pada pengadaan pelanggan, rantai pasokan, dan daya saing produk.
Apa Perbedaan antara AMD Instinct dan GPU NVIDIA untuk Inferensi AI?
GPU AI AMD dan NVIDIA sama-sama dapat mendukung tugas pelatihan dan inferensi model, tetapi kedua perusahaan berbeda dalam peta jalan produk, ekosistem perangkat lunak, dan pendekatan integrasi sistem. Seri Instinct AMD terutama menargetkan komputasi berkinerja tinggi dan akselerasi AI di pusat data, sementara NVIDIA telah membangun kerangka komputasi AI yang lebih komprehensif melalui GPU pusat data, platform perangkat lunak CUDA, dan teknologi jaringan pendukung.
Untuk tugas inferensi, kinerja komputasi teoretis GPU hanyalah salah satu kriteria evaluasi. Model perlu sering mengakses bobot dan data perantara, sehingga kapasitas memori, bandwidth memori, dan manajemen cache juga sama pentingnya. Kapasitas memori yang lebih besar membantu menampung parameter model dan KV Cache yang dihasilkan oleh lebih banyak permintaan bersamaan, sedangkan bandwidth memori yang lebih tinggi dapat mengurangi hambatan akses data dalam tugas inferensi tertentu. Namun, manfaat spesifiknya bergantung pada ukuran model, presisi kuantisasi, strategi batching, dan tingkat optimasi perangkat lunak.
Keunggulan NVIDIA terletak pada kemampuan koordinasi perangkat keras dan perangkat lunaknya. Selain GPU, NVIDIA menyediakan CUDA, TensorRT-LLM, kerangka kerja penyajian inferensi, serta teknologi interkoneksi berkecepatan tinggi, yang memungkinkan pengembang menerapkan beban kerja AI dengan rangkaian alat yang relatif matang. Sementara itu, AMD meningkatkan kompatibilitas dan kinerja sistem melalui ROCm, GPU Instinct, dan sistem Helios untuk mengurangi biaya migrasi bagi pelanggan yang mengadopsi perangkat keras alternatif.
| Dimensi Perbandingan |
AMD |
NVIDIA |
| Akselerator AI |
Seri Instinct |
Seri GPU pusat data |
| Ekosistem perangkat lunak |
ROCm |
CUDA |
| Solusi tingkat sistem |
Helios |
Platform skala rak seperti NVL |
| Fokus persaingan utama |
Ekosistem terbuka, biaya, dan kinerja |
Kematangan perangkat lunak, integrasi sistem |
| Fokus optimasi inferensi |
Kapasitas memori, throughput, adaptasi perangkat lunak |
Latensi, throughput, koordinasi perangkat keras dan perangkat lunak |
| Tantangan utama |
Kompatibilitas ekosistem dan kematangan penerapan |
Biaya sistem dan konsentrasi pemasok pelanggan |
Penting untuk ditekankan bahwa perbandingan di atas mencerminkan posisi produk dan ekosistem, bukan peringkat kinerja universal. GPU yang berbeda dapat menunjukkan kinerja yang sangat berbeda pada model, tingkat presisi, dan kondisi penerapan yang berbeda. Efisiensi inferensi aktual tidak dapat ditentukan hanya berdasarkan kapasitas memori atau kinerja komputasi teoretis.
Mengapa CUDA dan ROCm Memengaruhi Lanskap Persaingan Chip AI?
CUDA adalah platform komputasi paralel NVIDIA yang telah dikembangkan dalam waktu lama, sedangkan ROCm adalah platform perangkat lunak AMD untuk komputasi GPU dan beban kerja AI. Keduanya menyediakan alat pengembangan, pustaka komputasi, dan lingkungan waktu proses yang memungkinkan pengembang menggunakan GPU untuk tugas komputasi kompleks. Bagi perusahaan AI besar, memilih GPU lebih dari sekadar pengadaan perangkat keras. Hal tersebut juga berkaitan dengan apakah kode model yang ada, kerangka kerja pelatihan, mesin inferensi, dan sistem operasional dapat berjalan dengan andal.
Keunggulan kompetitif CUDA berasal dari ekosistem perangkat lunaknya yang telah lama terbentuk. Banyak model AI dan alat pengembangan telah diadaptasi serta dioptimalkan untuk GPU NVIDIA, sehingga perusahaan yang menggunakan perangkat keras NVIDIA sering kali dapat mengurangi sebagian pekerjaan migrasi dan penelusuran masalah. Terutama dalam lingkungan klaster berskala besar, stabilitas perangkat lunak, alat analisis kinerja, dan dukungan teknis dapat secara langsung memengaruhi pemanfaatan sumber daya komputasi.
AMD meningkatkan pengalaman pengembang dan dukungan untuk kerangka kerja AI utama melalui ROCm. Pada kuartal ketiga 2026, AMD merilis ROCm 10, yang semakin meningkatkan alat pengembangan, kompilator, pustaka komputasi, dan dukungan model terkait. Peningkatan ini membantu memperluas jangkauan aplikasi GPU AMD, tetapi perilisan versi baru tidak berarti semua aplikasi CUDA dapat dimigrasikan ke ROCm tanpa modifikasi.
Dari perspektif komersial, kompatibilitas perangkat lunak memengaruhi total biaya kepemilikan GPU yang sebenarnya. Jika perusahaan membeli akselerator dengan harga lebih rendah tetapi harus menginvestasikan sumber daya rekayasa yang besar untuk mengoptimalkan kembali model, penghematan biaya perangkat keras pada akhirnya dapat diimbangi oleh biaya pengembangan. Oleh karena itu, persaingan antara AMD dan NVIDIA tidak hanya terjadi pada tingkat chip, tetapi juga pada ekosistem pengembang, kerangka kerja inferensi, dan efisiensi penerapan sistem.
Bagaimana AMD Helios Mengubah Persaingan Tingkat Sistem dengan NVIDIA?
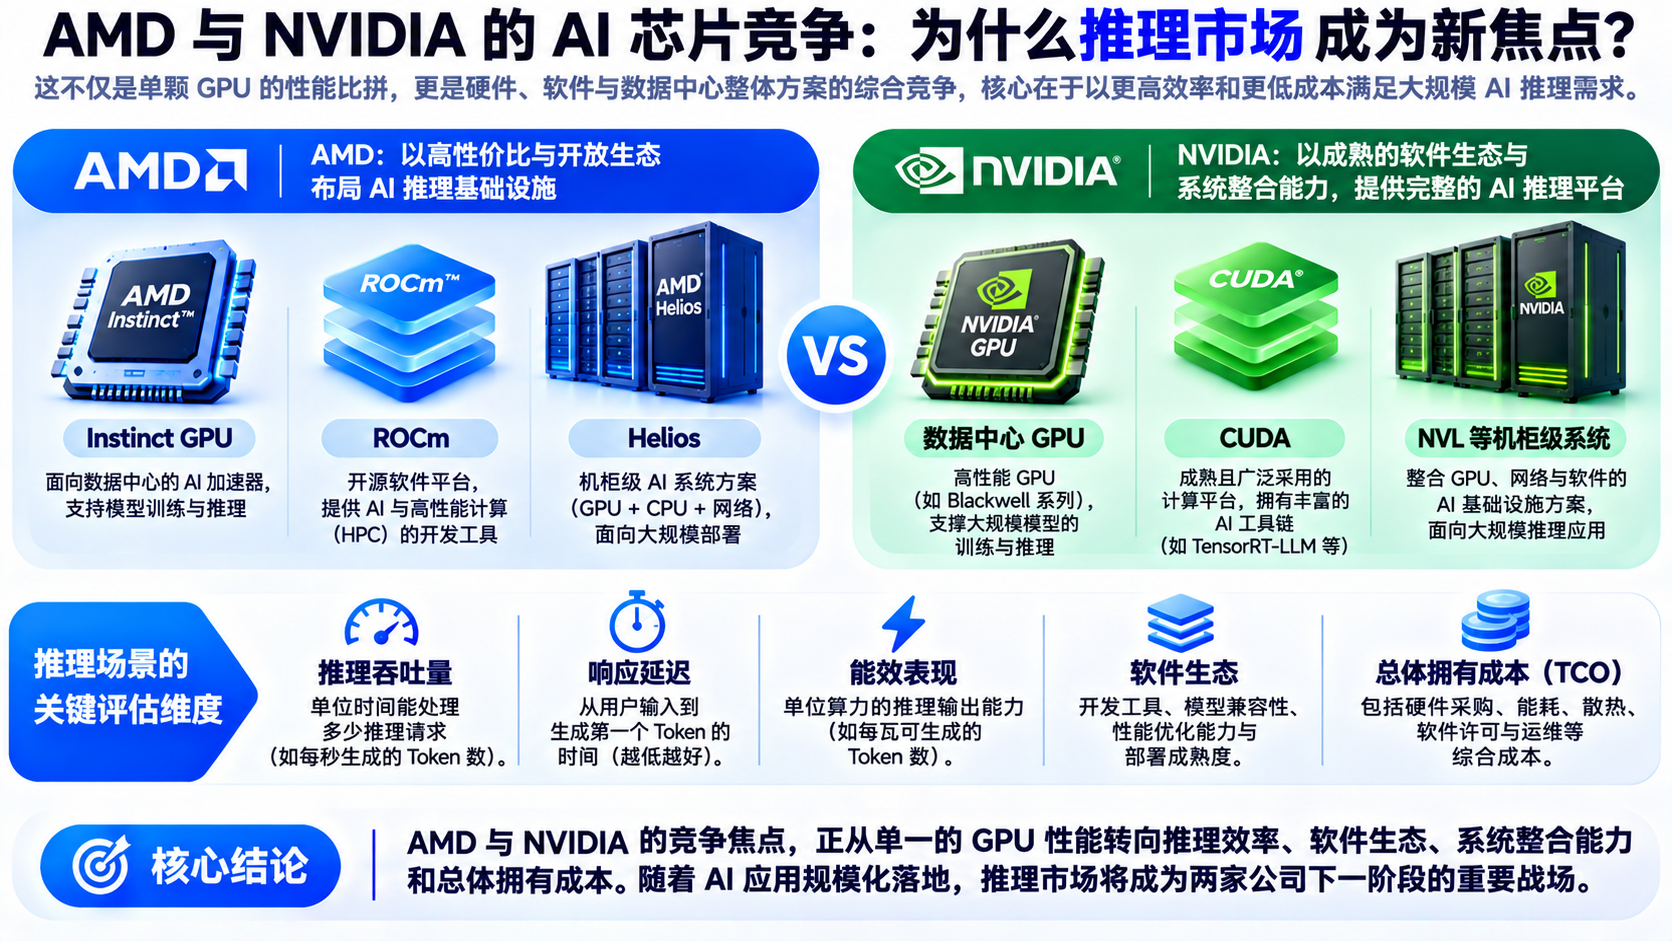
Helios adalah platform komputasi skala rak AMD untuk pusat data AI besar. Platform ini menggabungkan GPU Instinct, CPU EPYC, interkoneksi jaringan, dan komponen perangkat lunak terkait untuk menyediakan sistem komputasi AI yang lebih lengkap bagi pelanggan. Dibandingkan membeli GPU secara terpisah lalu mengintegrasikan sistem, solusi skala rak dapat mengoptimalkan desain komputasi, komunikasi, dan penerapan dalam arsitektur terpadu.
Perubahan ini mencerminkan bagaimana persaingan infrastruktur AI berkembang dari chip individual menjadi sistem komputasi lengkap. Pelatihan dan inferensi model besar biasanya memerlukan beberapa GPU untuk bekerja bersama. Kecepatan transfer data antar-GPU, interkoneksi dalam server, topologi jaringan, dan kemampuan pendinginan semuanya dapat memengaruhi efisiensi keseluruhan. Bahkan jika sebuah chip individual memiliki kinerja komputasi tinggi, throughput klaster aktual masih dapat dibatasi apabila komunikasi sistem menjadi hambatan.
NVIDIA telah membangun jajaran produk yang relatif lengkap melalui sistem AI skala rak, sedangkan AMD bertujuan menawarkan pilihan lain melalui Helios. Dalam pengumuman pendapatan terbarunya, AMD menyatakan bahwa pelanggan termasuk Anthropic, Meta, Microsoft, OpenAI, dan Oracle Cloud Infrastructure menjalankan model atau beban kerja berdasarkan solusi Helios pertama. Penerapan ini menunjukkan bahwa AMD memajukan peluncuran produk tingkat sistem, tetapi skala penerapan, jumlah pengadaan, dan tahap komersialisasi setiap pelanggan masih perlu dievaluasi secara terpisah.
Bagi penyedia layanan cloud besar, memiliki beberapa pemasok sistem AI yang kompetitif dapat meningkatkan fleksibilitas pengadaan dan mengurangi risiko konsentrasi rantai pasokan. Namun, persaingan tingkat sistem juga menuntut AMD lebih tinggi, termasuk dalam pasokan chip, interkoneksi jaringan, stabilitas perangkat lunak, penerapan rak, dan pemeliharaan jangka panjang.
Mengapa Biaya Inferensi AI Lebih Penting daripada Kinerja GPU Individual?
Nilai komersial inferensi AI pada akhirnya bergantung pada apakah layanan dapat disediakan secara berkelanjutan dengan biaya yang dapat diterima. Bagi platform AI yang memproses banyak permintaan setiap hari, harga pembelian GPU hanya merupakan salah satu bagian dari biaya. Pemanfaatan server, konsumsi daya, pendinginan, jaringan, pemeliharaan, dan efisiensi waktu proses model semuanya dapat memengaruhi total pengeluaran.
Sebagai contoh, anggap dua sistem GPU masing-masing memiliki biaya pengadaan $1 juta dan $1,2 juta. Jika sistem kedua dapat memproses lebih banyak permintaan dengan kualitas layanan yang sama atau secara signifikan mengurangi konsumsi energi setiap inferensi, sistem yang lebih mahal tersebut tetap dapat memiliki biaya per inferensi jangka panjang yang lebih rendah. Sebaliknya, jika sebuah sistem memiliki kinerja teoretis tinggi tetapi aplikasi di dunia nyata tidak dapat memanfaatkan sumber daya perangkat kerasnya secara penuh, nilai ekonominya dapat berada di bawah ekspektasi.
Oleh karena itu, saat mengevaluasi chip inferensi AI, penting untuk mempertimbangkan metrik seperti jumlah Token yang dihasilkan per detik, waktu hingga Token pertama, kapasitas permintaan bersamaan, dan biaya pemrosesan aktual per juta Token. Model dan beban kerja yang berbeda memiliki tingkat kepentingan yang berbeda terhadap metrik tersebut. Sebagai contoh, interaksi suara waktu nyata memprioritaskan latensi, sedangkan analisis dokumen batch mungkin lebih menekankan throughput dan biaya per unit.
Perubahan ini berarti AMD tidak harus mengungguli NVIDIA pada setiap metrik kinerja untuk memperoleh peluang pasar. Selama produknya dapat menyediakan biaya dan kinerja yang kompetitif untuk beban kerja tertentu sambil memenuhi persyaratan pelanggan terkait stabilitas dan dukungan perangkat lunak, produk tersebut dapat menjadi alternatif yang layak. Demikian pula, NVIDIA dapat mempertahankan daya saing melalui optimasi perangkat lunak dan efisiensi sistem, bukan hanya dengan mengandalkan kinerja chip teoretis yang lebih tinggi.
Bagaimana Persaingan di Pasar Inferensi AI Akan Memengaruhi Valuasi Saham AMD dan NVIDIA?
AMD dan NVIDIA sama-sama merupakan perusahaan terbuka penting dalam industri semikonduktor AS, tetapi investor tidak menerapkan logika valuasi yang sama persis untuk kedua perusahaan tersebut. NVIDIA telah membangun bisnis komputasi AI berskala besar dan ekosistem perangkat keras-perangkat lunak yang relatif matang, sehingga pasar umumnya berfokus pada kemampuannya dalam mempertahankan skala pendapatan, margin laba, dan keunggulan teknologi. Sementara itu, AMD memiliki peluang untuk memperluas pangsa pasar AI, sehingga investor lebih berfokus pada apakah penerapan produk baru, pesanan pelanggan, dan pertumbuhan pendapatan dapat diterjemahkan menjadi profitabilitas berkelanjutan.
Perluasan pasar inferensi AI dapat menguntungkan beberapa pemasok chip pada saat yang sama, tetapi pertumbuhan permintaan pasar tidak berarti laba setiap perusahaan akan meningkat secara proporsional. Seiring persaingan semakin ketat, harga produk, daya tawar pelanggan, dan investasi penelitian serta pengembangan dapat berubah. Jika perusahaan menurunkan harga untuk memperoleh pangsa pasar atau perlu mencurahkan lebih banyak sumber daya untuk mendukung penerapan pelanggan, pertumbuhan pendapatan mungkin tidak menghasilkan tingkat pertumbuhan laba yang sama.
Selain itu, harga saham bergantung pada seberapa besar ekspektasi pertumbuhan yang telah diperhitungkan pasar. Bahkan jika perusahaan melaporkan hasil keuangan yang kuat, harga sahamnya masih dapat menghadapi tekanan apabila investor mengharapkan hasil yang lebih tinggi. Sebaliknya, jika pengiriman aktual, margin laba, atau prospek perusahaan melampaui ekspektasi, pasar dapat menilai kembali valuasinya. Oleh karena itu, menilai nilai investasi AMD dan NVIDIA memerlukan lebih dari sekadar membandingkan GPU mana yang memiliki kinerja lebih kuat. Penilaian juga memerlukan pertimbangan terhadap komposisi pendapatan, profitabilitas, belanja modal, lingkungan persaingan, dan kelipatan valuasi.
Indikator Pasar Inferensi AI Apa yang Perlu Dipantau Investor?
Investor yang ingin memahami pergerakan saham chip AI dapat mengamati perubahan pasar dari tiga perspektif. Pertama adalah permintaan, termasuk belanja modal AI oleh penyedia layanan cloud besar, penggunaan layanan inferensi, dan penerapan aktual oleh pelanggan perusahaan. Indikator ini dapat membantu menentukan apakah permintaan daya komputasi AI terus berkembang, tetapi rencana belanja modal tidak sama dengan pendapatan terkonfirmasi bagi produsen chip.
Kedua adalah pasokan, termasuk volume pengiriman GPU, pasokan memori bandwidth tinggi (HBM), kapasitas pengemasan canggih, dan kemajuan penerapan sistem. Bahkan ketika permintaan pasar kuat, produsen chip mungkin tidak dapat menyelesaikan pengiriman sesuai rencana jika pasokan komponen penting tidak mencukupi. AMD dan NVIDIA sama-sama bergantung pada rantai pasokan semikonduktor yang kompleks, sehingga keterbatasan pasokan dapat memengaruhi laju pertumbuhan kedua perusahaan.
Area terakhir adalah metrik profitabilitas dan valuasi. Investor dapat memantau pendapatan pusat data, margin bruto, margin operasional, arus kas bebas, dan perubahan ekspektasi pasar, kemudian menggunakan rasio harga terhadap laba atau kelipatan laba masa depan untuk menilai apakah harga saham sudah wajar. Sangat penting untuk membedakan antara hasil keuangan yang telah dicapai dan panduan berorientasi masa depan dari manajemen, serta menghindari perlakuan pesanan yang belum dipenuhi atau proyeksi pertumbuhan sebagai pendapatan yang pasti.
Ringkasan
Persaingan antara AMD dan NVIDIA dalam chip AI berkembang dari perbandingan murni kinerja komputasi menuju efisiensi inferensi, ekosistem perangkat lunak, sistem skala rak, dan total biaya kepemilikan. Seiring aplikasi AI memasuki tahap penerapan berskala besar, pusat data tidak hanya membutuhkan kemampuan komputasi yang lebih kuat, tetapi juga kemampuan untuk terus memproses volume besar permintaan pengguna dengan biaya yang lebih wajar.
Pertumbuhan pesat bisnis pusat data AMD pada kuartal ketiga 2026, bersama dengan pengembangan berkelanjutan Instinct, ROCm, dan Helios, menunjukkan bahwa AMD memperluas bisnis infrastruktur AI-nya. Namun, NVIDIA tetap memiliki keunggulan penting dalam CUDA, integrasi sistem, dan ekosistem pengembang. Hasil persaingan di masa depan akan bergantung pada pengiriman produk, kinerja di dunia nyata, adopsi pelanggan, dan profitabilitas komersial, bukan pada satu metrik teknis dari satu generasi chip.
Bagi investor saham, pasar inferensi AI memberikan perspektif baru untuk mengamati industri semikonduktor, tetapi daya saing teknologi dan imbal hasil investasi saham tidak memiliki hubungan langsung yang setara. Menganalisis permintaan industri, profitabilitas perusahaan, dan valuasi pasar secara bersamaan memberikan pemahaman yang lebih menyeluruh tentang lanskap persaingan antara AMD dan NVIDIA.
FAQ
Apa Itu Inferensi AI?
Inferensi AI adalah proses penggunaan model kecerdasan buatan yang telah dilatih untuk memproses masukan dan menghasilkan keluaran, seperti obrolan AI, pembuatan gambar, pengenalan suara, dan tugas yang dilakukan oleh asisten cerdas.
Mengapa Pasar Inferensi AI Menjadi Lebih Penting?
Seiring jumlah pengguna aplikasi AI dan frekuensi penggunaannya meningkat, perusahaan harus terus menanggung biaya komputasi inferensi yang besar. Akibatnya, kecepatan inferensi, throughput, konsumsi daya, dan biaya per unit menjadi semakin penting.
Apakah GPU AI AMD Dapat Menggantikan NVIDIA?
Untuk model dan skenario aplikasi tertentu yang didukung, GPU AMD dapat menjadi alternatif bagi NVIDIA. Namun, kelayakan aktual bergantung pada kompatibilitas perangkat lunak, kinerja, biaya penerapan, dan persyaratan pelanggan. Keduanya tidak boleh dianggap sepenuhnya setara dalam setiap skenario.
Apa Perbedaan antara CUDA dan ROCm?
CUDA adalah platform komputasi paralel GPU NVIDIA, sedangkan ROCm adalah platform perangkat lunak komputasi GPU AMD. Keduanya mendukung komputasi AI, tetapi berbeda dalam alat pengembangan, kematangan ekosistem, dan kompatibilitas spesifik.
Apa Itu AMD Helios?
Helios adalah platform komputasi AI skala rak AMD yang mengintegrasikan GPU, CPU, interkoneksi, dan komponen perangkat lunak untuk beban kerja pelatihan serta inferensi AI di pusat data besar.
Apakah Meningkatnya Permintaan Inferensi AI Berarti Saham AMD Pasti Naik?
Belum tentu. Harga saham dipengaruhi tidak hanya oleh pertumbuhan bisnis, tetapi juga oleh profitabilitas, lanskap persaingan, rantai pasokan, ekspektasi pasar, dan valuasi saham.