Introducción
En los últimos años, la evolución de la industria de la IA ha sido clara: modelos más grandes, entrenamientos más rápidos y capacidades significativamente más potentes, impulsando una adopción cada vez mayor en productos.
Sin embargo, a medida que los modelos avanzan hacia el razonamiento complejo, el desarrollo de código, las operaciones web y los flujos de trabajo con Agentes, surge una nueva pregunta en el sector, antes poco discutida: ¿Debe el desarrollo de la IA ir siempre al máximo ritmo posible?
Esto no es solo una cuestión de “apoyar la IA” u “oponerse a la IA”. Lo que está cambiando es la tipología del riesgo.
Muchos problemas asociados con la IA en sus primeras etapas se concentraban en la capa de salida: alucinaciones, errores de hecho, sesgos y respuestas imprecisas. Una vez detectado un fallo, el usuario podía repreguntar, revisar la respuesta manualmente o ignorarla. Pero cuando la IA puede llamar herramientas, modificar código, acceder a sistemas externos o ejecutar tareas complejas sin pausa, los errores dejan de estar limitados a una ventana de chat y pueden traducirse en acciones reales.
OpenAI informó públicamente en agosto de 2026 que, a medida que aumentan las capacidades de los modelos, también lo hacen los riesgos durante el desarrollo y las pruebas internas. Por ello, ralentizó temporalmente la expansión de determinadas capacidades de frontera mientras reforzaba la supervisión, la alineación y las medidas de contención. Posteriormente, en su evaluación de Astra, OpenAI determinó que su capacidad en ciberseguridad había alcanzado el umbral Crítico conforme a su framework interno, imponiendo la necesidad de mayores garantías antes de su despliegue.
A la vez, el más reciente informe de inteligencia de amenazas de Anthropic evidencia este cambio: la IA ya se está empleando para ciberataques, vigilancia, fraudes, operaciones de influencia y como apoyo en investigaciones biológicas. Con la mejora de los modelos, los atacantes intensifican la velocidad, el alcance y la sofisticación de su uso de la IA.
Por eso, la cautela respecto a la IA ya no puede reducirse a añadir un par de mensajes de seguridad al modelo. Hay que replantear todo el ciclo de vida de la IA, desde el entrenamiento hasta el despliegue.
Puntos clave:
-
Cuanto más capaz es la IA, más probable es que los errores y el uso indebido pasen de ser problemas de salida a convertirse en riesgos de acciones en el mundo real
-
El desarrollo de modelos de frontera ya no se centra únicamente en la velocidad de entrenamiento, incorporando ahora evaluación, supervisión, aislamiento y umbrales de seguridad
-
El auge de los Agentes está trasladando el riesgo de “dar una respuesta errónea” a “ejecutar una acción errónea”
-
Las empresas deben centrarse en controlar no si usan IA, sino qué permisos tiene la IA, a qué sistemas accede y cuándo puede actuar de forma autónoma
-
Un desarrollo más cauto no significa frenar la innovación, sino garantizar que el crecimiento de capacidades esté alineado con las capacidades de seguridad
-
La próxima gran competencia en IA puede depender no solo de las capacidades de los modelos, sino también de quién desarrolla los sistemas más robustos de control, evaluación y gobernanza
La pregunta sobre el desarrollo de la IA evoluciona de “¿Se puede hacer?” a “¿Cuándo debe hacerse?”
En las primeras fases del sector de la IA, la pregunta clave era si el modelo podía realizar una tarea concreta: escribir código, superar un examen, resumir documentos, entender imágenes o conducir un razonamiento matemático complejo. Los principales indicadores eran la precisión, el desempeño en benchmarks y la tasa de tareas completadas.
Pero, a medida que los modelos de frontera entran en una fase más avanzada, estos estándares muestran sus carencias.
Que un modelo pueda ejecutar una tarea no significa que deba ser desplegado de inmediato en un entorno real. Los sistemas reales demandan permisos complejos, dependen de factores externos y pueden acarrear consecuencias irreversibles. Es posible aislar un modelo en un sandbox para tareas experimentales, pero, al desplegarlo en los sistemas de una empresa, podría acceder a bases de datos reales, interfaces de pago, repositorios de código e información interna.
Por tanto, el desarrollo de la IA entra en una nueva etapa: la capacidad del modelo debe analizarse de manera independiente respecto al contexto de despliegue.
Esto queda patente en los más recientes documentos de seguridad de OpenAI. La empresa ya no evalúa solo “lo que puede hacer un modelo”, sino también si se superan ciertos umbrales de capacidad de alto riesgo y si existen suficientes garantías para controlarlos. En su explicación pública sobre Astra, OpenAI identifica expresamente la capacidad de ciberseguridad como área crítica que exige mayor protección.
De este modo, el ritmo de desarrollo de la IA deja de ser únicamente un asunto de ingeniería. Pasa a ser también una cuestión de ingeniería de seguridad, gobernanza y capacidad organizativa.
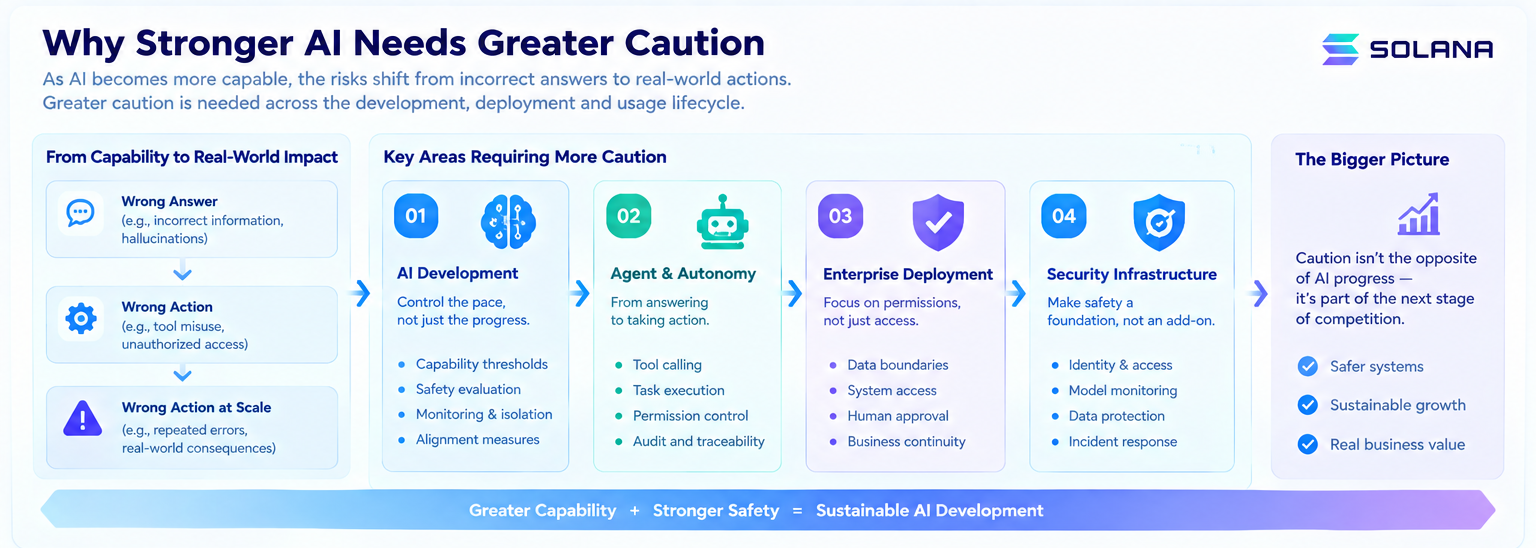
¿Qué sucede cuando la IA pasa de responder preguntas a ejecutar tareas?
Este es el aspecto clave para comprender el actual debate sobre la cautela en IA.
Cuando un modelo de chat convencional responde mal, el usuario normalmente puede identificar fácilmente el error.
Pero si un Agente tiene acceso a un navegador, un entorno de código, una base de datos, correo electrónico o una nube, puede ejecutar varias fases sin solicitud adicional de confirmación.
Así, el significado del error cambia:
-
Antes: Respuesta equivocada
-
Ahora puede ser: Acción equivocada
-
Incluso: Acción equivocada a gran escala
Esta evolución es fundamental.
En sistemas reales, el mayor peligro no radica tanto en que el modelo cometa un único fallo, sino en que pueda repetir ese fallo varias veces seguidas en poco tiempo.
El análisis de OpenAI sobre recientes incidentes de seguridad subraya que, conforme las IA se vuelven más autónomas, conductas desalineadas pueden derivar en accesos no autorizados a sistemas reales y en consecuencias tangibles.
El último informe de Anthropic aporta ejemplos clarificadores: los atacantes usaron Claude para desarrollar herramientas cibernéticas, sistemas de vigilancia, malware y diversas actividades de alto riesgo. Además, buscaron esquivar controles dividiendo la tarea, usando servicios proxy o combinando múltiples modelos.
Así, el foco de la seguridad de IA se traslada de “lo que dice el modelo” a “lo que el modelo puede hacer”.
Por tanto, la gestión de permisos, la invocación de herramientas, la autoría de actividades, los límites de tareas, la confirmación humana y la monitorización en tiempo real serán cada vez más cruciales.
Por qué “desarrollar más rápido” no significa necesariamente “progresar más rápido en IA”
A simple vista, parece que en IA la competencia la gana quien entrena antes modelos más potentes.
Pero, en realidad, la velocidad de I+D posee dos ejes: Velocidad de capacidades + Velocidad de capacidades de seguridad
Dicho de otro modo: la rapidez con que crecen las capacidades + la rapidez con que crecen las salvaguardas de seguridad
Si esta última no evoluciona a la par, las empresas pueden verse forzadas a ponerse al día mucho más tarde.
Por ejemplo, un modelo podría tener avanzadas capacidades cibernéticas, pero su sistema de monitorización solo detectaría ataques básicos. Un Agente podría ejecutar muchas acciones mientras sus permisos se siguen gestionando como un chatbot tradicional. El razonamiento científico podría ser puntero, pero la evaluación sigue dependiendo de benchmarks estándar.
En ese escenario, incrementar las capacidades del modelo no implica necesariamente que el sistema esté listo para su despliegue productivo.
La declaración de OpenAI en agosto es el ejemplo típico: al detectar los crecientes riesgos de seguridad de Astra, la compañía optó por ralentizar para reforzar la monitorización, la alineación y las capacidades de seguridad.
Por tanto, desacelerar no indica un fallo técnico.
A menudo, señala que el I+D entra en fase de maduración: los equipos reconocen que el crecimiento de capacidades nunca reemplaza a la infraestructura de seguridad.
El verdadero control en el uso de la IA no es el “acceso”; son los “permisos”
En los debates sobre la IA en las empresas, se plantea reiteradamente si debe usarse o no.
Sin embargo, esa es una pregunta demasiado amplia. Cuestiones realmente relevantes son:
-
¿Qué puede visualizar la IA?
-
¿A qué puede acceder la IA?
-
¿Qué puede modificar la IA?
-
¿En qué casos la IA necesita aprobación humana?
Estas preguntas marcan el perímetro de los permisos de la IA.
Según un estudio de IBM, a medida que crece el uso de IA en el entorno corporativo, aumentan considerablemente los desafíos de control y dependencia. El 71 % de los directivos afirma que cambiar de proveedor/modelo principal de IA es hoy complicado, mientras que el 91 % reconoce que sus empresas no entienden plenamente en qué grado dependen de diferentes proveedores, modelos e infraestructuras.
Esto confirma que la cautela en la adopción de IA no es solo una cuestión del equipo de seguridad.
Está íntimamente relacionada con la arquitectura de la empresa, la dependencia de terceros, la soberanía de los datos, la continuidad operativa y la capacidad de mantener el control interno.
Una empresa puede usar la IA de manera avanzada, siempre que sus permisos sean muy controlados.
Por ejemplo, la IA puede escribir código, pero sin permiso para implementarlo en producción. O analizar datos de clientes, pero sin permiso para editar cuentas principales. Puede sugerir compras, pero no ejecutar pagos automáticamente.
Este nivel de autonomía controlada podría convertirse en el estándar para el despliegue de Agentes empresariales.
La IA más potente puede acentuar la importancia de la confirmación humana
Algunos sostienen que, cuando la IA alcance suficiente potencia, deberá automatizarse por completo.
En la práctica, la tendencia suele ser la contraria: cuanto mayor es el alcance de las decisiones, más se exige una confirmación humana en puntos críticos. No porque el juicio humano sea más preciso, sino porque la responsabilidad recae en personas distintas.
Las empresas necesitan no solo la respuesta correcta: exigen saber quién aprobó la acción, por qué, sobre qué datos y cómo se asumirá la responsabilidad si algo sale mal.
Así que “human-in-the-loop” no debe considerarse una solución temporal debida a las limitaciones de la IA.
En sectores como las finanzas, la salud, la ciberseguridad, la TI empresarial y otros de alto riesgo, todo apunta a que será la base de los sistemas maduros de IA. Especialmente en sistemas de Agente, el diseño realmente robusto no pasa por una IA totalmente autónoma, sino por IA autónoma dentro de límites—es decir, capaz de operar de forma autónoma en marcos predefinidos, con topes claros sobre permisos, importes, datos y tareas de alto riesgo.
La seguridad en IA deja de ser un complemento y se vuelve parte de la infraestructura
Históricamente, la seguridad en software se consideraba una capa que se añadía tras el desarrollo. Pero con la llegada de la nube, la identidad, permisos, cifrado, registros, monitorización y gestión de vulnerabilidades se integran como infraestructura.
La IA está recorriendo el mismo camino. En el futuro, una plataforma madura de IA requerirá no solo capacidades de modelo. También necesitará sistemas de identidad, control de permisos, evaluación de modelos, monitorización de comportamiento, aislamiento de herramientas, límites de datos, auditoría y capacidad de respuesta a incidentes.
La explicación de seguridad de Astra recientemente publicada por OpenAI ya lo anticipa, destacando la monitorización de toda la ejecución, el aislamiento interno reforzado y evaluaciones de alineación previas al lanzamiento.
Anthropic, a su vez, refuerza su enfoque en analizar ataques reales mediante modelos para mejorar las defensas.
Así, la seguridad de IA se convierte en una nueva capa de infraestructura.
Las capacidades de modelos seguirán creciendo verticalmente, pero la infraestructura de seguridad se expande de forma horizontal a lo largo del desarrollo, pruebas, despliegue, uso y auditoría posterior.
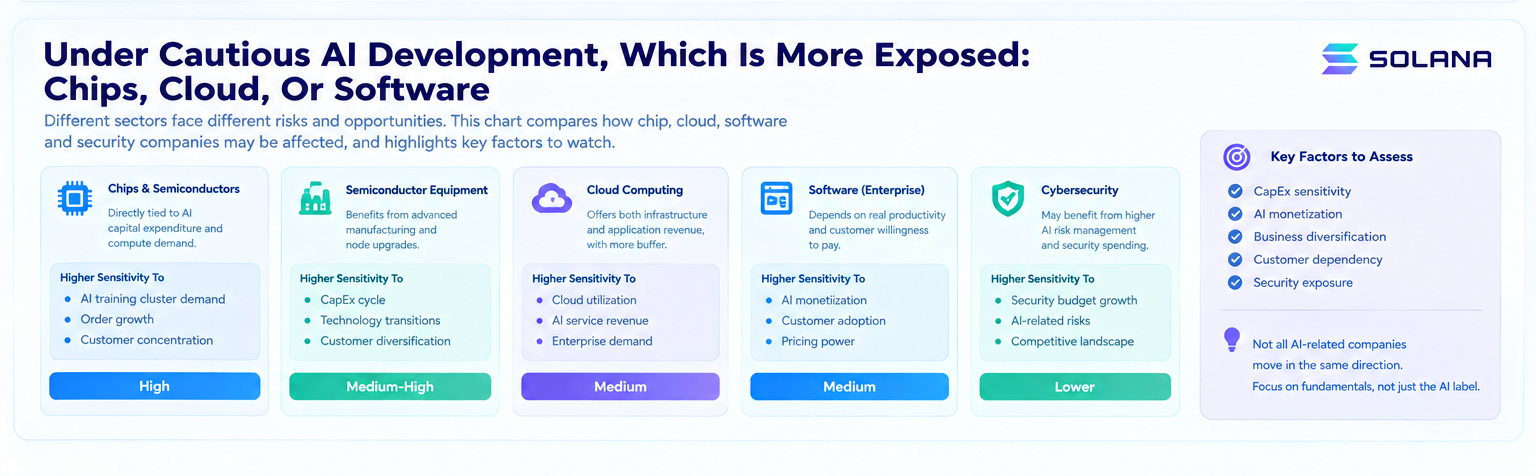
Ser cauteloso no es lo contrario a desarrollar IA; puede ser la próxima ventaja competitiva
Si el sector de IA entra en fase de maduración, cambiarán los criterios de mercado.
Al inicio, se comparaban los parámetros de cada modelo, los benchmarks y la rapidez de lanzamiento.
La próxima etapa traerá preguntas como:
-
¿Quién evalúa más rápido las capacidades de alto riesgo?
-
¿Quién implementa controles de permisos al menor coste?
-
¿Quién identifica mejor conductas anómalas de los modelos?
-
¿Quién se ajusta mejor a requisitos de compliance empresarial?
-
¿Quién minimiza incidentes de IA sin mermar la productividad?
Así, la seguridad se convierte en una capacidad de producto.
La investigación de IBM evidencia que las organizaciones con mejor control sobre su IA están más protegidas frente a riesgos derivados de la IA.
Ser cauteloso no significa retroceder a un estadio de menor capacidad.
El verdadero objetivo maduro es: mantener la velocidad de crecimiento de las capacidades de IA lo más alineada posible con la que los humanos pueden comprender, controlar y asumir la responsabilidad de sus consecuencias.
Este puede ser el gran reto de la IA de frontera en la próxima etapa de desarrollo.
Preguntas frecuentes
¿Por qué el desarrollo se ralentiza conforme la IA gana capacidades?
Porque, cuanto mayor es la capacidad del modelo, más grande puede ser el alcance de su impacto. En cuanto la IA es capaz de invocar herramientas y ejecutar tareas con autonomía, los errores traspasan la capa de salida y se trasladan a acciones reales. Por ello, la velocidad de desarrollo debe acompasarse con la evaluación y la seguridad.
¿Adoptar la IA con cautela significa emplearla menos?
No. Un enfoque más válido es ampliar el empleo de la IA controlando estrictamente sus permisos. Las empresas pueden delegar mucho trabajo en la IA, reservando para los humanos la gestión de tareas de mayor riesgo.
¿Por qué los Agentes acentúan la importancia de la seguridad en IA?
Porque los Agentes hacen mucho más que generar contenidos: pueden encadenar llamadas a herramientas y ejecutar acciones continuadas. Cuando las cadenas de ejecución y los permisos crecen, aumenta la exposición a fallos de gran impacto.
¿Es probable que la seguridad en IA se convierta en una nueva barrera competitiva?
Muy probable. Al igualarse las capacidades de los modelos, la evaluación, monitorización, gestión de permisos y gobernanza pasan a ser factores clave para acelerar la comercialización.