El 3 de noviembre de 2026, Binance publicó una declaración preliminar de la investigación sobre el incidente de seguridad del 29 de octubre. La declaración reveló que los atacantes comprometieron los dispositivos de ingenieros mediante malware y utilizaron herramientas internas de IA para ampliar aún más su acceso. Según la declaración, el ataque terminó implicando un acceso no autorizado al servicio interno de firma de billeteras, lo que afectó aproximadamente a 6,34 mil millones de dólares en activos digitales. Sin embargo, la declaración no reveló la arquitectura completa de las herramientas internas de IA ni confirmó que el ataque explotara vulnerabilidades en un modelo de lenguaje grande o implicara inyección de instrucciones.
Este incidente plantea una cuestión importante sobre la seguridad empresarial: cuando un Agente de IA puede acceder a más herramientas internas y sistemas sensibles, ¿cómo deben distinguir las empresas entre los permisos de procesamiento de información y los permisos operativos reales? Partiendo de cómo los Agentes de IA llaman a herramientas, este artículo explica los límites de permisos, la inyección de instrucciones, la gestión de credenciales y los riesgos de movimiento lateral, y analiza los controles de seguridad que pueden adoptar las empresas.
Puntos clave:
-
Los Agentes de IA pueden hacer más que generar texto. También pueden ejecutar código, leer archivos, acceder a API u operar sistemas empresariales internos mediante llamadas a herramientas.
-
La declaración preliminar de la investigación de Binance, publicada el 3 de noviembre de 2026, indicó que los atacantes utilizaron dispositivos comprometidos de ingenieros y herramientas internas de IA para obtener acceso adicional a los dispositivos y permisos de otros ingenieros.
-
Uno de los riesgos de seguridad principales de los Agentes de IA es convertir información procedente de entornos externos o de baja confianza en acciones con privilegios reales de ejecución.
-
La inyección de instrucciones, las salidas maliciosas de herramientas, los permisos excesivos y las filtraciones de credenciales pueden agravarse mutuamente. Sin embargo, no todos los ataques que involucran herramientas de IA son ataques de inyección de instrucciones.
-
Las empresas deben tratar a los Agentes de IA como entidades de ejecución de software con identidades y permisos específicos, y controlar los riesgos mediante el principio de mínimo privilegio, el aislamiento de herramientas, las aprobaciones de operaciones y los mecanismos de auditoría.
¿En qué se diferencian los Agentes de IA de los chatbots de IA tradicionales?
Los chatbots de IA tradicionales completan tareas principalmente recibiendo entradas del usuario y generando respuestas de texto. Aunque un modelo pueda proporcionar código, analizar archivos o explicar pasos operativos, por lo general no puede modificar directamente una base de datos empresarial, desplegar una aplicación o llamar a un servicio interno sin estar conectado a un entorno de ejecución real.
La diferencia de los Agentes de IA es que pueden conectar las decisiones generadas por el modelo con herramientas externas. Por ejemplo, los desarrolladores pueden configurar un Agente con herramientas de búsqueda de código, ejecución de terminal, consultas de bases de datos y gestión de repositorios Git. Cuando un usuario envía una tarea, el Agente puede recuperar primero los archivos pertinentes, llamar después a herramientas para obtener información y decidir posteriormente qué hacer en función de los resultados. Con los permisos adecuados, un Agente puede incluso crear confirmaciones de código, activar pruebas o ejecutar procesos de despliegue.
Este modelo transforma a un Agente de IA de una simple herramienta de generación de información en un sistema de software con determinadas capacidades operativas. El Agente en sí puede no tener privilegios independientes de administrador, pero puede adquirir la capacidad de acceder a sistemas externos mediante autorización de usuarios, cuentas de servicio, tokens de API u otras credenciales de identidad.
Por lo tanto, la seguridad de los Agentes de IA no puede evaluarse únicamente en función de si las respuestas del modelo son precisas. Incluso si el contenido generado por el modelo no contiene errores evidentes, el Agente podría seguir realizando operaciones que excedan las expectativas del usuario si sus permisos de herramientas se configuran de forma incorrecta. Las empresas deben centrarse no solo en lo que genera la IA, sino también en lo que puede leer, a qué puede llamar y qué operaciones pueden modificar realmente el estado del sistema.
¿Cómo llaman los Agentes de IA a las herramientas?
La llamada a herramientas es un mecanismo importante mediante el cual los Agentes de IA interactúan con sistemas externos. Los desarrolladores suelen proporcionar al modelo los nombres, las descripciones funcionales y las estructuras de parámetros de las herramientas disponibles. A continuación, el modelo determina si debe llamar a una herramienta concreta en función de la tarea actual. La ejecución real suele llevarla a cabo el entorno de ejecución o la aplicación del Agente, tras lo cual los resultados de la herramienta se proporcionan al modelo para su procesamiento posterior.
Por ejemplo, un Agente interno de desarrollo empresarial puede leer repositorios de código, consultar registros de errores y ejecutar pruebas. Cuando un usuario le pide que investigue un problema de un servicio, el Agente puede llamar a una herramienta de consulta de registros para localizar el problema, leer el código pertinente y generar después recomendaciones de modificación. Si la empresa también concede permisos para escribir código o realizar despliegues, el Agente puede pasar de proporcionar asistencia analítica a llevar a cabo operaciones reales.
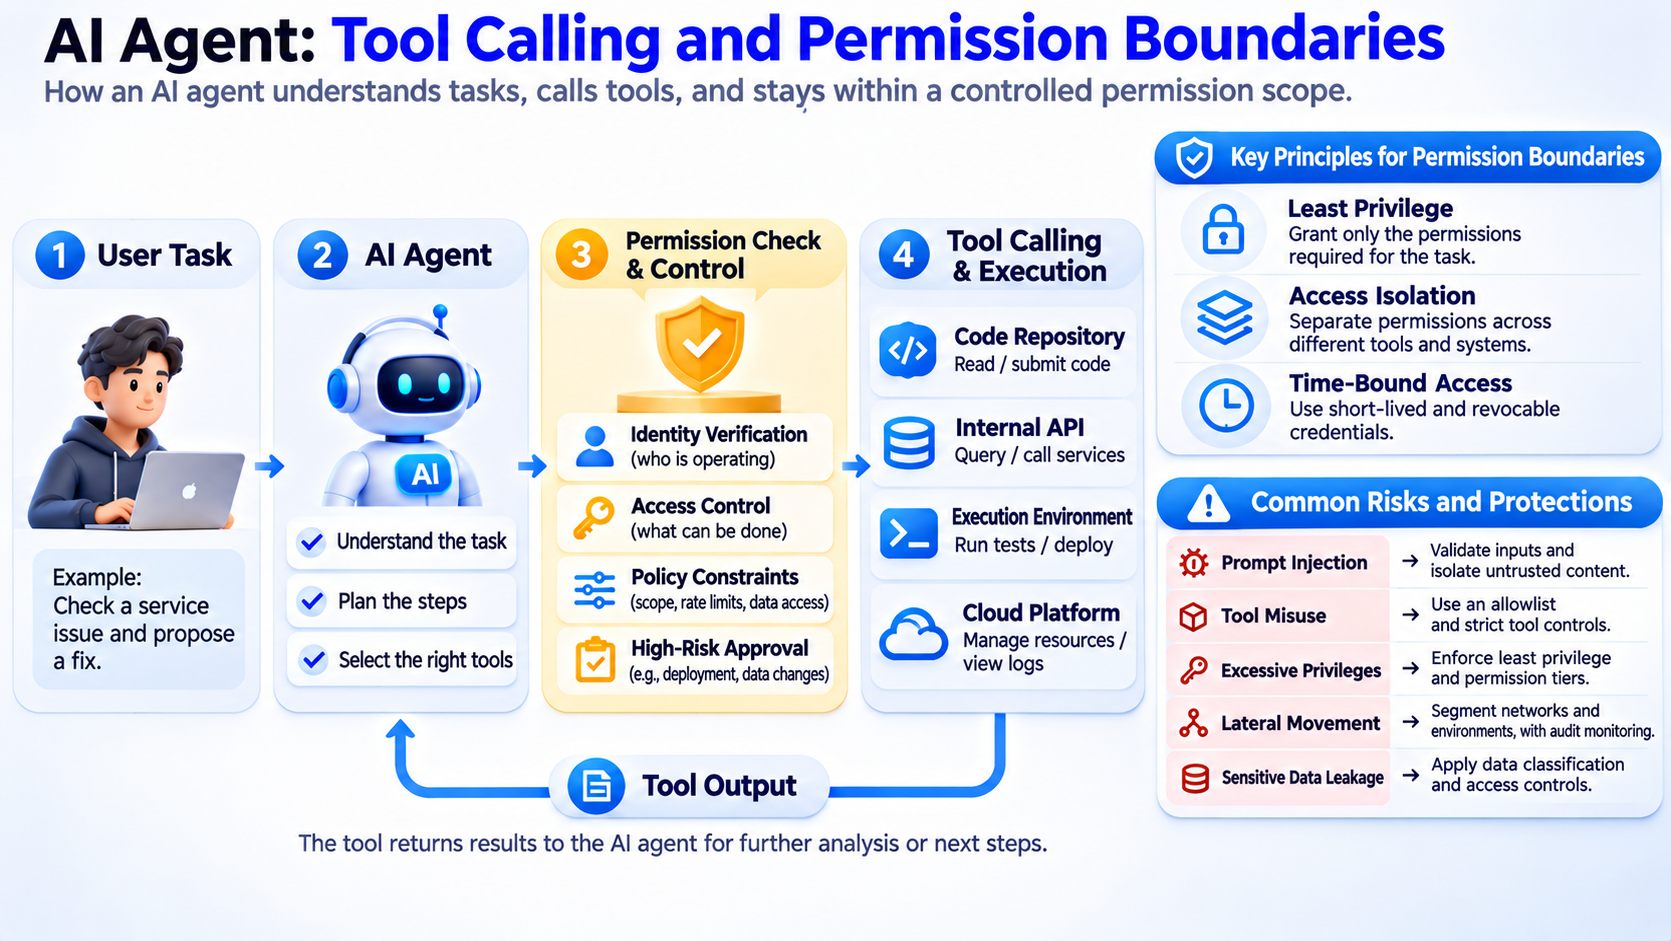
Los riesgos de las llamadas a herramientas proceden principalmente de dos ámbitos.
-
El Agente puede recibir permisos de ejecución excesivos. Por ejemplo, puede necesitar únicamente leer registros, pero también tener la capacidad de modificar configuraciones del entorno de producción.
-
El Agente puede procesar contenido no confiable procedente de páginas web externas, comentarios de código, correos electrónicos o resultados de herramientas. Si el sistema no distingue correctamente este contenido de la autorización real del usuario, la información externa podría influir en las llamadas posteriores a herramientas.
Esto significa que las empresas no pueden tratar simplemente las llamadas a herramientas generadas por el modelo como operaciones confiables. Cada llamada a una herramienta que implique datos sensibles o cambios en el sistema requiere una verificación independiente de permisos. El modelo puede enviar una solicitud de ejecución, pero la autorización de esa solicitud debe determinarse mediante políticas de seguridad explícitas.
¿Por qué los Agentes de IA pueden ampliar la superficie de ataque de una empresa?
Los sistemas de seguridad empresarial tradicionales suelen establecer controles de acceso en torno a las identidades de empleados, servidores, aplicaciones y límites de red. Cada empleado tiene distintos permisos de sistema, mientras que los servicios críticos pueden restringir el acceso mediante credenciales y reglas de red independientes. Cuando los Agentes de IA se conectan a sistemas empresariales, crean de hecho nuevas rutas de acceso automatizadas.
Por ejemplo, un Agente de desarrollo puede conectarse simultáneamente a un repositorio Git, una base de conocimientos interna, una plataforma en la nube y un sistema de gestión de tareas. Para completar tareas entre sistemas, los desarrolladores pueden configurar varios tokens de API o cuentas de servicio. Si estas credenciales no se restringen estrictamente, un atacante que obtenga el control del entorno de ejecución del Agente o de la identidad relacionada podría utilizar estas capacidades de acceso para llegar a más sistemas.
Otro problema es la velocidad operativa. Los empleados suelen tener que iniciar sesión manualmente en varias plataformas para completar una serie de operaciones, mientras que un Agente de IA puede llamar a herramientas de forma continua en un período breve. La automatización no es insegura por naturaleza. Sin embargo, sin límites de velocidad, detección de anomalías y aprobación de operaciones de alto riesgo, las instrucciones erróneas o maliciosas pueden ejecutarse rápidamente.
Por lo tanto, los Agentes de IA no solo amplían el número de interfaces de software, sino también las relaciones de permisos que conectan diferentes sistemas. Las empresas deben evaluar a qué recursos puede acceder cada Agente, si puede atravesar distintos dominios de seguridad y si existen rutas desde herramientas de bajo riesgo hacia sistemas de alto riesgo.
¿Por qué la inyección de instrucciones puede afectar a las llamadas a herramientas de los Agentes de IA?
La inyección de instrucciones se refiere a un ataque en el que un atacante introduce contenido similar a instrucciones en datos que un modelo puede leer, con el objetivo de modificar la tarea que el modelo debe realizar. En los chatbots convencionales, estos ataques pueden provocar respuestas incorrectas o divulgación de información. En los Agentes de IA con capacidad para llamar a herramientas, también pueden afectar a operaciones reales.
Por ejemplo, una empresa puede utilizar un Agente de IA para organizar automáticamente informes de incidencias en un repositorio de código. Si un atacante puede controlar el contenido de un informe, puede insertar instrucciones disfrazadas de requisitos de mantenimiento del sistema e inducir al Agente a leer archivos adicionales o llamar a herramientas no relacionadas. El riesgo real no es que el Agente lea el informe, sino si trata el contenido no confiable del informe como una instrucción con autoridad de ejecución.
Estos ataques se conocen habitualmente como inyección indirecta de instrucciones. El atacante no necesita enviar comandos directamente al usuario del Agente. En su lugar, puede influir en el Agente mediante páginas web, documentos, comentarios de código, resultados de búsqueda o salidas de herramientas. OWASP incluye la inyección de instrucciones, el uso indebido de herramientas, la escalada de privilegios y la divulgación de información sensible entre los riesgos de seguridad importantes para los Agentes de IA.
Sin embargo, la inyección de instrucciones debe distinguirse de los ataques tradicionales de malware. Si un atacante ya ha tomado el control del ordenador de un ingeniero mediante código malicioso y después utiliza credenciales existentes para acceder a sistemas internos, el hecho de que la ruta del ataque involucrara una herramienta de IA no significa necesariamente que se produjera una inyección de instrucciones. Ambos mecanismos pueden aparecer juntos, pero son técnicamente distintos.
¿Qué riesgos para las herramientas de IA y la gestión de permisos revela el incidente de seguridad de Binance?
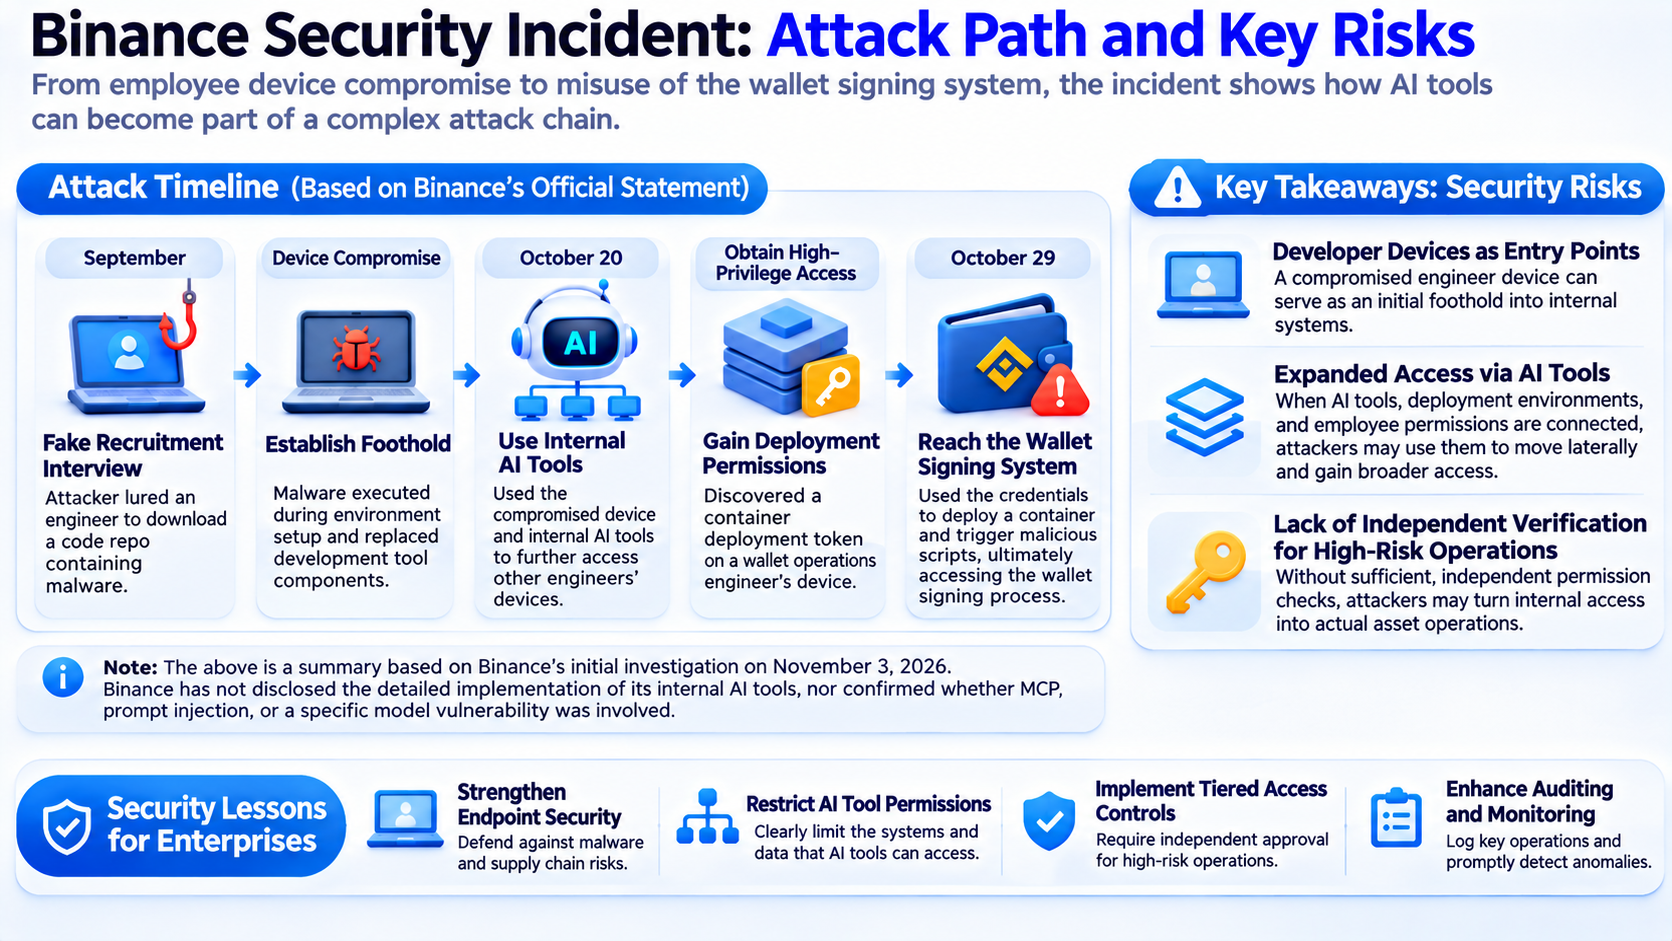
En su declaración preliminar de la investigación publicada el 3 de noviembre de 2026, Binance reveló un ataque en varias etapas que avanzó desde el compromiso de un dispositivo de empleado hasta el uso indebido del sistema interno de firma de billeteras. Según la declaración, en septiembre los atacantes indujeron a un ingeniero de software a descargar un repositorio que contenía código malicioso mediante una falsa entrevista de trabajo. El código malicioso se ejecutó durante la configuración del entorno y estableció canales de comunicación controlados por los atacantes al sustituir componentes de herramientas de desarrollo y utilizar otros métodos.
El 20 de octubre, los atacantes utilizaron el ordenador de un ingeniero comprometido y herramientas internas de IA para tomar el control de los dispositivos de otros ingenieros. También descubrieron un token de permiso de despliegue de contenedores en el dispositivo de un ingeniero de operaciones de billeteras. El 29 de octubre, los atacantes utilizaron las credenciales pertinentes para desplegar contenedores y activar scripts maliciosos, llegando finalmente al proceso de operaciones de firma de billeteras.
Desde la perspectiva de la arquitectura de seguridad, este incidente refleja al menos tres cuestiones que merecen estudiarse. En primer lugar, los dispositivos de los desarrolladores pueden convertirse en puntos de entrada a sistemas internos de alto valor. En segundo lugar, cuando las herramientas internas de IA, los entornos de despliegue y los permisos de los empleados están conectados, los atacantes pueden aprovechar estas conexiones para ampliar su acceso. Por último, si las operaciones de alto riesgo carecen de una verificación independiente de permisos suficiente, los atacantes pueden convertir los permisos internos que obtienen en la capacidad de realizar operaciones reales sobre activos.
Es importante destacar que Binance no ha revelado la implementación específica de sus herramientas internas de IA. Por lo tanto, es imposible confirmar si estas herramientas eran Agentes de IA con capacidades de planificación autónoma o concluir que el ataque involucró MCP, inyección de instrucciones o una vulnerabilidad en un modelo específico. El incidente muestra que las herramientas de IA pueden formar parte de una ruta de ataque compleja, pero no demuestra por sí solo que un Agente de IA fuera la causa principal del ataque.
¿Qué es el límite de permisos de un Agente de IA? ¿Por qué es tan importante el principio de mínimo privilegio?
Un límite de permisos define a qué recursos puede acceder una entidad de software, qué operaciones puede realizar y en qué condiciones puede obtener permisos adicionales. Para un Agente de IA, el límite de permisos involucra no solo al modelo en sí, sino también al entorno de ejecución del Agente, las interfaces de herramientas, la identidad del usuario, las cuentas de servicio y los sistemas externos.
El principio de mínimo privilegio exige que un sistema conceda únicamente los permisos necesarios para completar la tarea actual. Por ejemplo, un Agente responsable de analizar registros de servidores normalmente solo necesita acceso a datos de registro específicos. No debería poder eliminar bases de datos, modificar entornos de producción o transferir activos digitales automáticamente. Si una tarea realmente requiere una operación de alto riesgo, el Agente debe obtener permiso temporal mediante un mecanismo de autorización independiente.
OWASP incluye la autonomía excesiva entre los riesgos importantes de las aplicaciones de modelos de lenguaje grandes. El problema principal no es que el modelo tenga capacidades de llamada a herramientas, sino que el sistema haya otorgado al modelo funciones innecesarias, permisos excesivos o capacidades autónomas de operación sin restricciones. Cuando el modelo se ve influido por entradas incorrectas, inyección de instrucciones o resultados maliciosos de herramientas, estos permisos pueden aumentar el daño potencial.
Por lo tanto, las empresas deben situar las comprobaciones de permisos en un entorno de ejecución confiable, en lugar de limitarse a indicar al Agente mediante una instrucción del sistema que no realice operaciones peligrosas. Incluso si un modelo solicita incorrectamente acceso a una herramienta sensible, el servicio de backend debe poder rechazar la solicitud no autorizada según la identidad, el alcance del recurso y el tipo de operación.
¿Qué nuevos desafíos de seguridad pueden crear los protocolos de conexión de herramientas como MCP?
El Protocolo de Contexto de Modelo (MCP) es un protocolo abierto para conectar aplicaciones de IA con herramientas externas y recursos de datos. Mediante MCP, los desarrolladores pueden conectar Agentes de IA a sistemas de archivos, bases de datos, repositorios de código y otros servicios sin tener que diseñar un método de integración completamente distinto para cada herramienta.
Este método de conexión estandarizado puede mejorar la eficiencia del desarrollo, pero también significa que los Agentes pueden acceder más fácilmente a múltiples sistemas externos. Si una empresa no gestiona los servidores MCP, las definiciones de herramientas y los permisos de acceso, puede afrontar problemas como permisos de herramientas excesivos, descripciones maliciosas de herramientas, servicios de terceros comprometidos o exposición accidental de información sensible.
Por ejemplo, un Agente de desarrollo puede necesitar leer un repositorio de código, pero no necesita acceder al sistema de pagos de la empresa. Si ambos tipos de herramientas se configuran en el mismo entorno de ejecución y utilizan credenciales compartidas con permisos de alto nivel, un Agente destinado originalmente a ayudar con el desarrollo puede adquirir capacidades operativas no relacionadas con su tarea.
OWASP recomienda establecer un mecanismo de auditoría para los servidores MCP conectados a herramientas de programación con IA, restringir las herramientas que pueden llamarse y comprobar si las definiciones de herramientas contienen instrucciones maliciosas. Los Agentes que ejecutan código también deben utilizar medidas como el aislamiento en entornos controlados, las restricciones de acceso a la red y la gestión independiente de credenciales.
MCP no constituye por sí mismo una vulnerabilidad de seguridad. Lo que debe evaluarse es la implementación de las herramientas, la autenticación, la configuración de permisos y cómo el contenido externo afecta al comportamiento del Agente tras conectar el protocolo.
¿Cómo deben proteger las empresas las identidades y los permisos de acceso de los Agentes de IA?
Las empresas deben establecer primero un sistema de identidad identificable y auditable para los Agentes de IA. Las aplicaciones tradicionales suelen utilizar cuentas de servicio o claves de API para acceder a otros sistemas. Sin embargo, las operaciones de los Agentes de IA pueden involucrar autorización de usuarios, tareas automatizadas y múltiples herramientas simultáneamente. Por ello, las empresas deben distinguir claramente entre la identidad del usuario, la identidad del Agente y los permisos de ejecución reales.
Por ejemplo, que un empleado pida a un Agente recuperar un informe interno no significa que el Agente pueda utilizar su cuenta de servicio para leer otros archivos a los que el empleado no está autorizado a acceder. Un diseño de autorización adecuado debe verificar tanto si el usuario solicitante está autorizado a acceder al recurso objetivo como si el Agente tiene permiso para realizar la operación correspondiente. Esto ayuda a evitar que el Agente eluda los controles de acceso existentes porque su servicio proxy tiene privilegios más elevados.
En febrero de 2026, el Centro Nacional de Excelencia en Ciberseguridad (NCCoE), dependiente del Instituto Nacional de Estándares y Tecnología (NIST), publicó un documento conceptual sobre identidad y autorización de software y Agentes de IA. El documento abordó cuestiones como el reconocimiento de identidad del Agente, la autenticación, la autorización, las credenciales temporales, los permisos delegados y la auditoría. Esto refleja cómo la seguridad de los Agentes de IA se está ampliando desde los controles de salida del modelo hacia un marco completo de gestión de identidades y accesos.
En implementaciones reales, las empresas pueden utilizar credenciales de acceso de corta duración y restringir los permisos a tareas, recursos y períodos de tiempo específicos. También deben requerirse aprobación independiente y verificación secundaria para actividades de alto riesgo, como despliegues de producción, operaciones financieras y cambios de permisos. De este modo, incluso si el entorno de ejecución del Agente se ve comprometido, es posible que un atacante no pueda obtener directamente credenciales de larga duración y altos privilegios.
¿Cómo pueden las empresas reducir los riesgos de seguridad de las llamadas a herramientas de los Agentes de IA?
Las empresas pueden establecer medidas de protección en cuatro ámbitos: permisos de herramientas, entornos de ejecución, operaciones sensibles y supervisión del comportamiento.
-
Las empresas deben restringir las herramientas que un Agente puede utilizar según los requisitos del negocio. Un Agente que solo recupera información no necesita capacidades arbitrarias de ejecución de código, y un Agente utilizado para revisión de código no debe recibir automáticamente permisos de despliegue en producción. Para las herramientas con capacidades de escritura, las empresas pueden restringir adicionalmente las rutas de archivos, las tablas de bases de datos, los tipos de operaciones de API y los ámbitos de acceso.
-
Las herramientas de alto riesgo deben ejecutarse en entornos aislados. La ejecución de código, la instalación de paquetes de terceros y el procesamiento de páginas web externas pueden introducir contenido no confiable. Por ello, las empresas pueden utilizar contenedores u otras tecnologías de entornos controlados para restringir el acceso a sistemas de archivos, redes y recursos del sistema. El aislamiento reduce la probabilidad de que un ataque contra una herramienta concreta afecte a otros sistemas.
-
Las empresas deben requerir aprobación humana para operaciones irreversibles. Las operaciones como eliminar datos importantes, modificar permisos, desplegar servicios de producción o transferir activos no deben completarse automáticamente solo porque el Agente determine que la tarea es razonable. Las directrices de seguridad del Marco de Agentes de Microsoft también recomiendan determinar si se requiere confirmación humana según el impacto, la sensibilidad de los datos y la reversibilidad de la operación.
-
Por último, las empresas deben establecer mecanismos de auditoría continua que registren qué herramientas utilizó el Agente, a qué recursos accedió, si se produjeron solicitudes de permisos anómalas y si los resultados reales de la ejecución coincidieron con la tarea autorizada. Para llamadas repetidas a herramientas que fallen, acceso anómalo a datos y gran número de operaciones en un período breve, las empresas pueden combinar la detección basada en reglas con el análisis de comportamiento para identificar riesgos potenciales.
| Medida de seguridad |
Función principal |
| Mínimo privilegio |
Restringir las herramientas y los recursos a los que puede acceder el Agente |
| Aprobaciones de llamadas a herramientas |
Evitar que se realicen operaciones de alto riesgo sin confirmación |
| Aislamiento en entorno controlado |
Reducir el impacto del código malicioso o del uso indebido de herramientas |
| Credenciales de acceso temporales |
Reducir el riesgo de exposición prolongada de credenciales |
| Validación de entradas y salidas |
Reducir el riesgo de que contenido malicioso afecte a la ejecución de herramientas |
| Auditoría de comportamiento |
Detectar llamadas anómalas y uso anómalo de permisos |
Estas medidas no pueden garantizar la eliminación completa de los riesgos de seguridad de los Agentes de IA. Sin embargo, pueden reducir el alcance del impacto tras un ataque exitoso y aumentar la probabilidad de que se detecte y aborde un comportamiento anómalo.
¿Por qué la seguridad de los Agentes de IA se está convirtiendo en una cuestión importante para la infraestructura Web3?
La combinación de Agentes de IA e infraestructura de cadena de bloques otorga implicaciones más directas a las llamadas a herramientas y la gestión de permisos para la seguridad de los activos. En escenarios empresariales tradicionales, un Agente puede ejecutar código, enviar correos electrónicos o modificar una base de datos. En escenarios Web3, un Agente también puede conectarse a billeteras, consultar activos en cadena, llamar a contratos inteligentes o iniciar solicitudes de transacción.
Por ejemplo, un Agente utilizado para gestionar automáticamente activos en cadena puede necesitar consultar saldos, analizar el mercado y proporcionar recomendaciones de trading según la configuración del usuario. Si también recibe capacidades de firma de transacciones o de llamada a contratos inteligentes, las empresas deben definir claramente qué operaciones pueden ejecutarse automáticamente, cuáles requieren confirmación del usuario y cómo limitar el importe por transacción, el alcance de los activos y el período de validez de la autorización.
En este proceso, las claves de sesión, las cuentas inteligentes y los mecanismos de autorización granular pueden proporcionar distintas formas de gestión de permisos. Sin embargo, su seguridad específica depende de cómo se implementen. Las claves de sesión pueden limitar determinados permisos operativos a un período o ámbito específico, mientras que las cuentas inteligentes pueden restringir el comportamiento de las transacciones mediante reglas de contrato. No obstante, los riesgos de seguridad pueden seguir surgiendo si las condiciones de autorización son demasiado amplias, la lógica de validación contiene defectos o el entorno de ejecución se ve comprometido.
Por lo tanto, el desarrollo de Agentes de IA para Web3 no puede centrarse únicamente en la eficiencia del trading automatizado o los pagos en cadena. También debe abordar la verificación de identidad, la delegación de permisos, las aprobaciones de transacciones y la revocación de autorizaciones. Para los sistemas de IA conectados a activos reales, el límite de seguridad debe abarcar todo el proceso, desde las decisiones del modelo hasta las llamadas a herramientas, la construcción de transacciones, la verificación de firmas y la ejecución en cadena.
Conclusión
Los Agentes de IA están cambiando la forma en que las empresas utilizan la inteligencia artificial. A medida que los modelos se conectan a repositorios de código, API internas, bases de datos y herramientas de automatización, los sistemas de IA ya no son meramente puntos de entrada para el procesamiento de información. Cada vez se están convirtiendo más en entidades de ejecución de software con capacidades operativas reales.
La investigación preliminar de Binance sobre el incidente de seguridad revelado el 3 de noviembre de 2026 indica que las herramientas internas de IA pueden haber aparecido en una ruta de ataque compleja. Sin embargo, la información disponible es insuficiente para demostrar que el incidente fuera causado directamente por una vulnerabilidad de un Agente de IA o por inyección de instrucciones. La lección más importante es que las empresas deben reevaluar las relaciones de acceso entre los entornos de desarrollo, las herramientas de automatización y los sistemas con altos privilegios.
En el futuro, la seguridad de los Agentes de IA dependerá no solo de si los modelos pueden identificar instrucciones maliciosas, sino también de si las empresas pueden establecer mecanismos fiables de autenticación de identidad, mínimo privilegio, aislamiento de herramientas y aprobación independiente. Solo separando adecuadamente las capacidades de toma de decisiones de la IA de los permisos de ejecución reales podrán las empresas controlar los riesgos potenciales mientras mejoran la eficiencia de la automatización.
Preguntas frecuentes
¿Por qué los Agentes de IA presentan más riesgos de seguridad que los chatbots convencionales?
Los Agentes de IA pueden acceder a datos empresariales, ejecutar código o modificar sistemas mediante llamadas a herramientas. En comparación con los chatbots que solo generan texto, sus errores o comportamientos manipulados pueden tener consecuencias operativas reales.
¿Qué es la llamada a herramientas de un Agente de IA?
La llamada a herramientas se refiere a que un Agente de IA solicita a un programa o servicio externo que realice una operación según los requisitos de una tarea, como consultar una base de datos, leer un archivo, llamar a una API o ejecutar código.
¿Puede la inyección de instrucciones controlar siempre a un Agente de IA?
No necesariamente. El éxito de la inyección de instrucciones depende del diseño del sistema, el comportamiento del modelo y los controles de seguridad. Incluso si un atacante influye en la salida del modelo, la verificación independiente de permisos puede impedir operaciones no autorizadas con herramientas.
¿Demuestra el incidente de seguridad de Binance que los Agentes de IA tienen vulnerabilidades?
No. La investigación preliminar de Binance confirmó que la ruta del ataque involucró herramientas internas de IA, pero no reveló pruebas técnicas suficientes para establecer la existencia de una vulnerabilidad de un Agente de IA o de inyección de instrucciones.
¿MCP aumenta los riesgos de seguridad de los Agentes de IA?
MCP puede ayudar a las aplicaciones de IA a conectarse a herramientas externas, pero los principales riesgos de seguridad proceden de la implementación de las herramientas, los permisos de acceso y la gestión de contenido no confiable. Una autenticación adecuada, la auditoría de herramientas y las restricciones de permisos pueden reducir estos riesgos.
¿Cómo deben las empresas restringir los permisos de los Agentes de IA?
Las empresas pueden utilizar el principio de mínimo privilegio, credenciales temporales específicas para cada tarea, aprobaciones independientes de operaciones, aislamiento en entornos controlados y auditoría de llamadas a herramientas para garantizar que los Agentes solo puedan realizar operaciones explícitamente autorizadas.







