سكوير
متابعة
رائج
أخبار
نظرة عامة على المركز الشخصي

Stephan_

vip
العمر 3.6سنة
الطبقة القصوى 0
لا يوجد محتوى حتى الآن
0
متابعة
2
المتابعون
24
أُعجب به
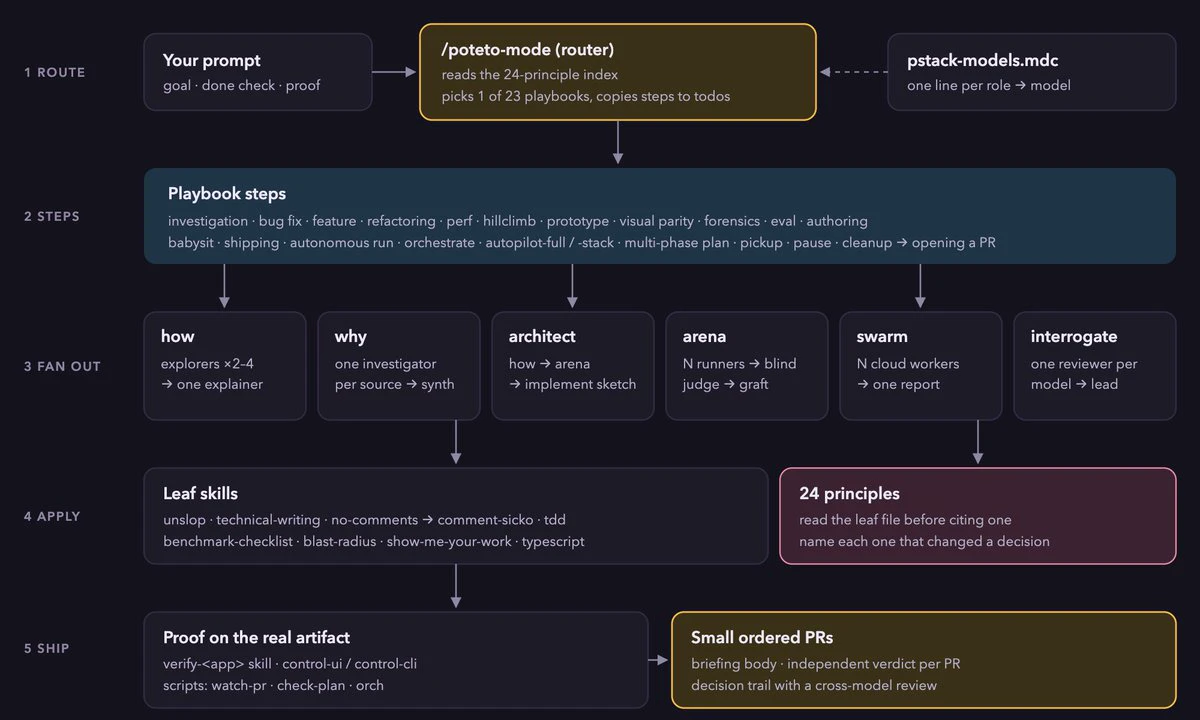
أدرس حالياً بشكل منهجي pstack الخاص بـ @poteto، إنه رائع حقاً! أشعر أن الأمور أصبحت واضحة تماماً!
سأشارك ما أتعلمه تباعاً:
post-image
الاشتراك الأكثر جدوى الآن ليس opencode-go
ولا commandcode-goat
بل ChatGPT-plus 😂
كنت أفكر مؤخراً باستمرار في سؤال: كيف نوازن بين الحتمية والمرونة عند كتابة المهارات للنماذج المتقدمة؟
تشير الحتمية إلى كتابة المهارة باستخدام مزيد من القيود الصارمة أو التعليمات البرمجية
وتشير المرونة إلى استخدام قدر أقل من التفاصيل والقيود، وكتابة المهارة من منظور عالي المستوى ومدفوع بالمطالبات
يحتاج هذان الجانبان إلى توازن ديناميكي، ولا توجد إجابة وحيدة
ما دفعني إلى ذلك هو مقارنة /spec-implement الذي كتبه matt مع /pi-matt-implement-flow الذي كتبته أنا
يفرض سير عملي وإطاري قيوداً كثيرة، وميزته أن الحتمية فيه قوية، لذلك لا ينحرف الوكيل بسهولة. لكن عيبه أيضاً هو قوة الحتمية، إذ لا يترك للوكيل م
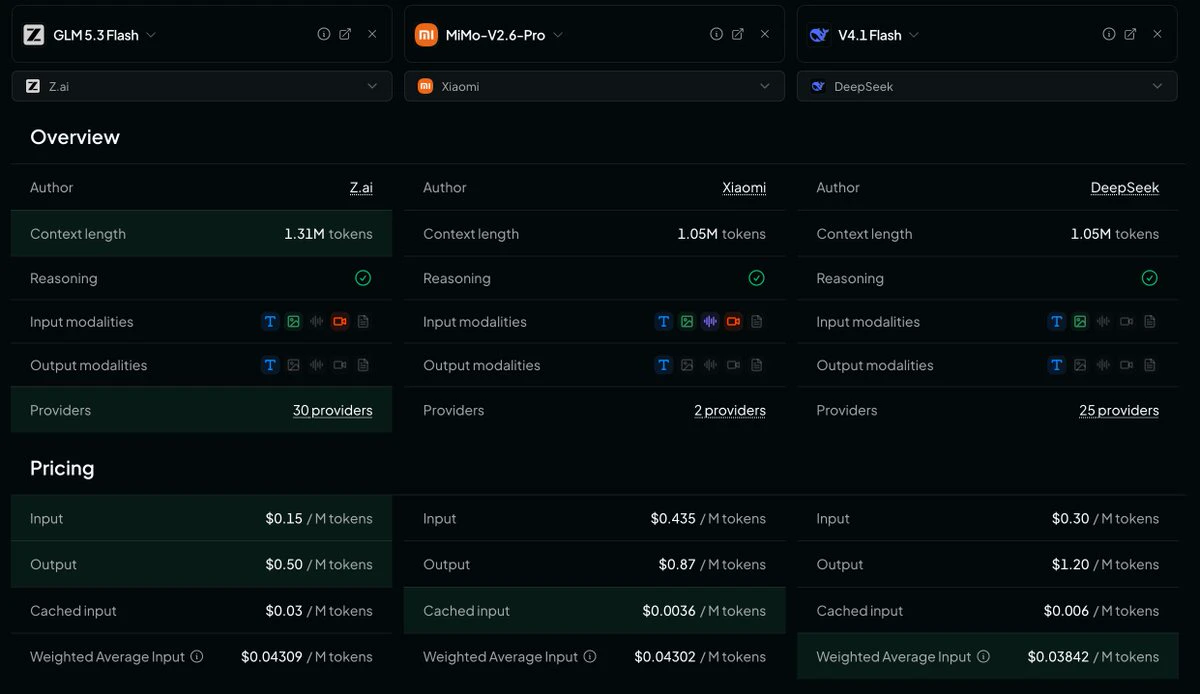
بالنظر إلى Weighted Average Input الفعلي على OpenRouter، فإن تكلفة هذه النماذج الثلاثة متقاربة جدًا. لذا، إذا اخترت نموذجًا واحدًا منها ليكون النموذج الأساسي، فأيّها ستختار؟
post-image
تعطّل مستودع npm الرسمي، في الوقت الذي كنت أستعد فيه للتسجيل في مستودع npm الرسمي ونشر الحزمة 😤
أفكار حديثة🤔:
ينبغي تخصيص مزيد من وقت التطوير لإعداد مجموعات بيانات التقييم eval وتقييم دقتها واكتمالها، ثم دفع تكرار الأعمال عبر بناء حلقة تقييم
بدلاً من كتابة كود الأعمال مباشرة بأسلوب vibe coding
في الحالة المثالية، ينبغي لكود الأعمال أن يكرر نفسه ذاتياً من خلال هدف مناسب + حلقة تقييم
أحاول حالياً إجراء هذا التحول، وأرحب بالنقاش.
لماذا تختلف نتائج كثير من تقييمات الذكاء الاصطناعي عن تجربتنا الفعلية معه؟
أعتقد أن العامل الأساسي هو أن معظم التقييمات تبدأ بإطلاق إشارة الانطلاق، ثم تنظر إلى من يركض أبعد
أما إلى أين يركض فلا يهم؛ حتى لو ركض إلى السماء، فعملية التقييم بأكملها لا تتطلب الوصول إلى نتيجة مستقرة
في السيناريوهات الواقعية، أكثر ما يستنزف الجهد هو الوصول إلى الاستقرار والمواءمة؛ فالأبعد ركضاً ليس بالضرورة الأفضل، بل الأفضل هو من يستطيع مواصلة الركض داخل المضمار.
استخدمت Grok لإنشاء مهمة مؤتمتة تحصي حصص النماذج الرئيسية في commandcode GOAT وعدد مرات استدعائها التقديري شهرياً (مرتبة حسب عدد مرات الاستدعاء)، وأشاركها معكم:
post-image
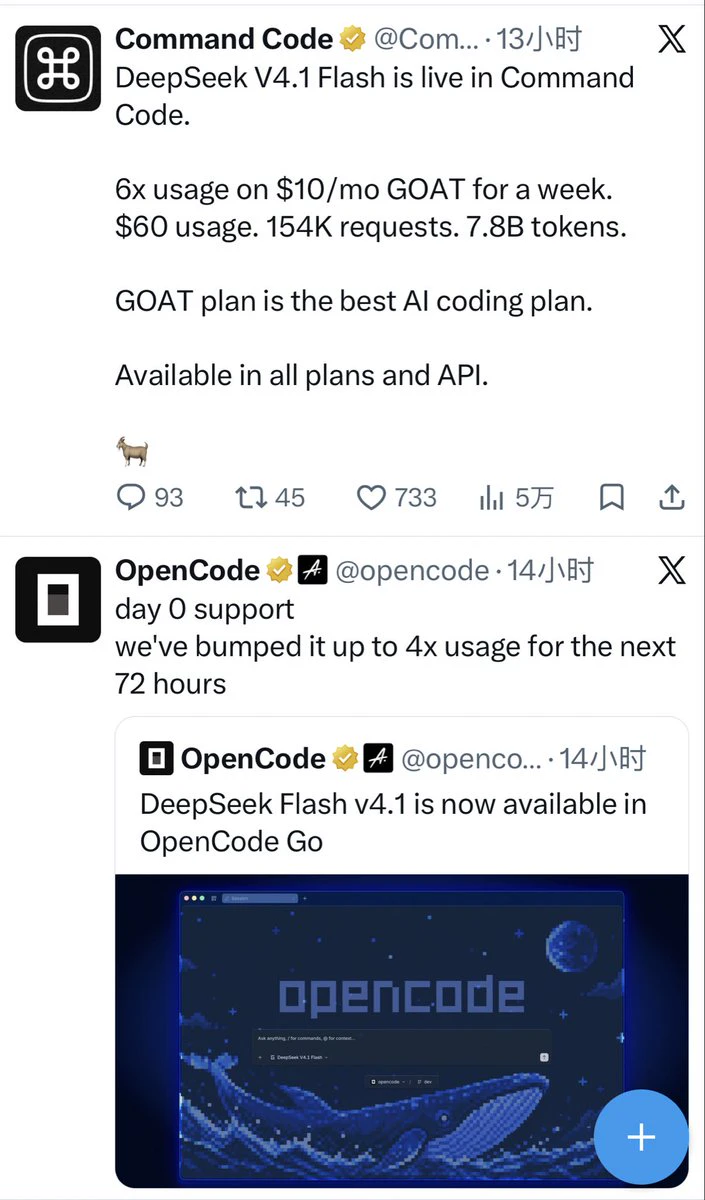
OpenCode-Go: خلال الأيام الثلاثة المقبلة، نمنح الجميع حصة ds-4.1 بأربعة أضعاف😆
CommandCode-GOAT: خلال الأيام السبعة المقبلة، نمنح الجميع حصة بستة أضعاف🥹
post-image
4%⁦2.09⁩+
GOAT%⁦0.43⁩-
ds، لقد أصبح هذا توحيداً كاملاً؛ فالموقع بأكمله لا يضم سوى نموذج واحد 😂
post-image
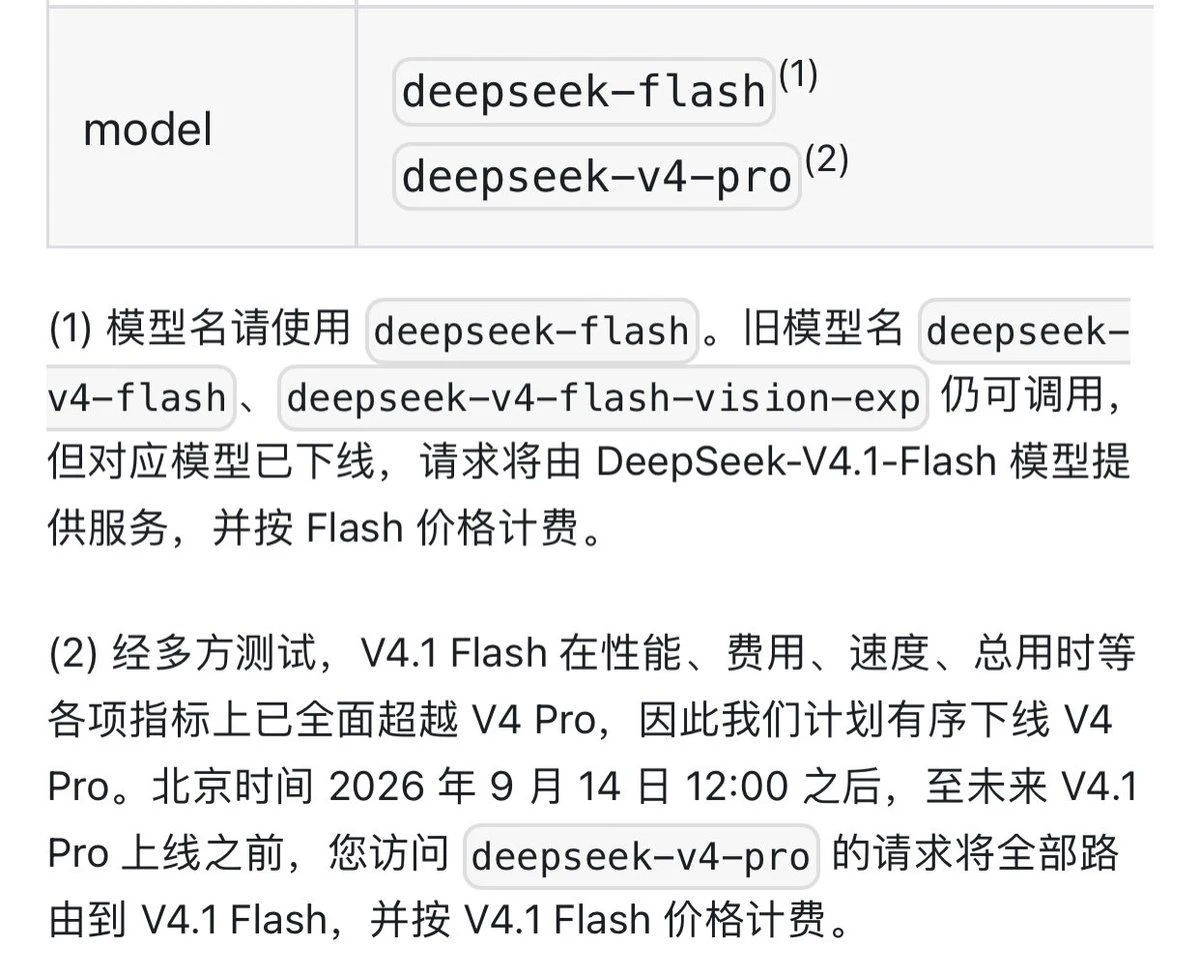
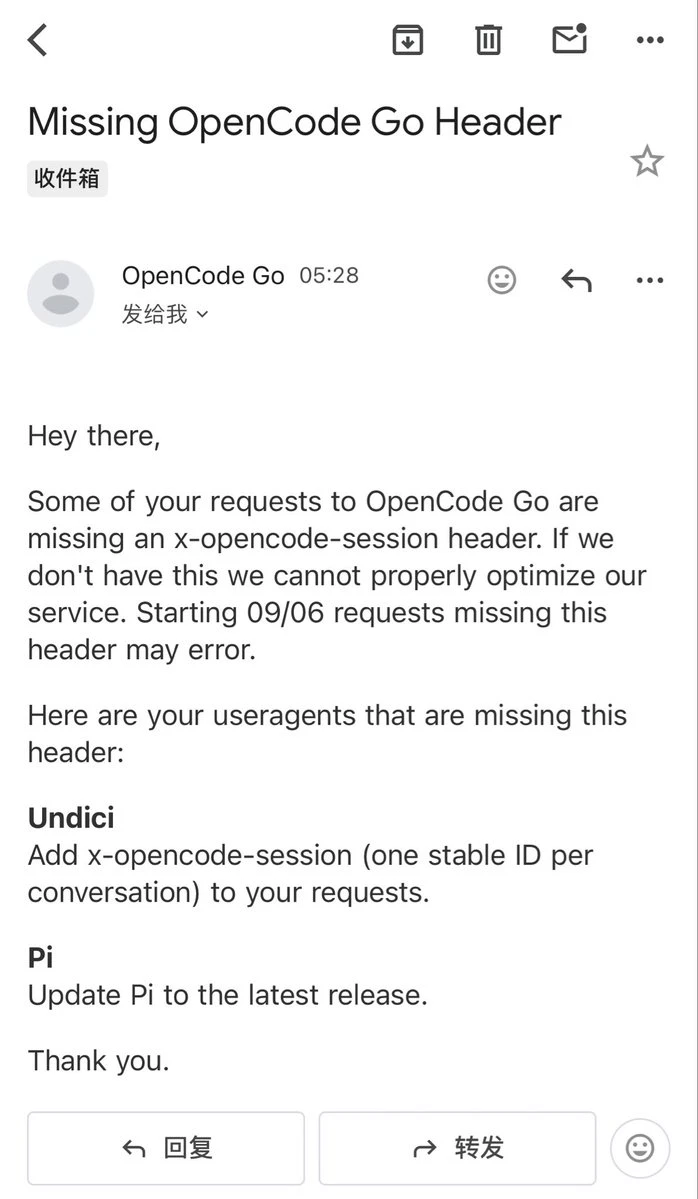
أستخدم اشتراك pi + opencode-go منذ فترة، وقد تلقيت للتو البريد الإلكتروني التالي:
لطالما شعرت بأن هذا الأمر غريب بعض الشيء: أن يرسل provider بريداً إلكترونياً إلى عملاء harness ويطلب منهم الترقية سريعاً، وإلا فلن تتمكنوا من استخدامنا بعد الآن😂
وبالمناسبة، لماذا لا يكون ua هو pi-agent؟ هل تُعدّ Undici حزمة sdk التي يستخدمها pi للاتصالات الأساسية؟
post-image
بعد الاعتياد على Deepseek-v4-flash، لم أعد أحتمل GLM-5.3-flash 😂
المشكلة أن GLM بطيء، ناهيك عن كثرة ظهور الأخطاء، كما أن استقراره ليس جيداً جداً
في هذه الحالة، يمكن تماماً استخدام نموذج أقوى للتخطيط وDeepseek-v4-flash للتنفيذ بدلاً منه.
DEEPSEEK%⁦7.30⁩+
GLM%⁦2.12⁩-
فكّروا في سؤال: هل توجد منظومة تتيح تحويل قالب خدمة SaaS متكامل + AI harness + مهارات مخصصة إلى إطار عمل قابل للتوصيل؟
هل يمكن أن يصبح DeepSeek Harness بنية تحتية من هذا النوع؟ وهل توجد مشاريع أخرى ناضجة بالفعل؟
DEEPSEEK%⁦7.30⁩+
ذكر Matt Pocock أن «النطاق الذكي» لطول السياق يبلغ نحو 120 ألفاً، وتجربتي مع grok-4.6 تكاد تكون مماثلة؛ فعند الاقتراب من 200 ألف، يبدأ النموذج في إظهار غباء ملحوظ. ما تجاربكم؟ وهل لدى النماذج الأخرى أيضاً «نطاق ذكي» واضح؟
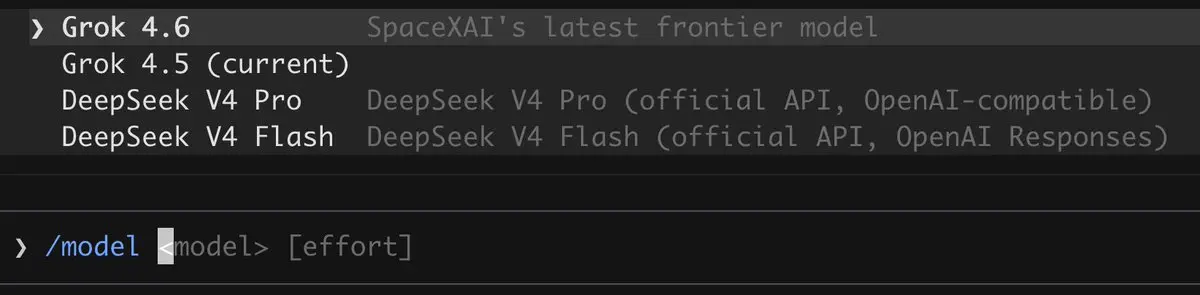
grok build هو أفضل TUI استخدمته على الإطلاق، ومع grok-4.6 يمكن القول إنه الأفضل من حيث القيمة مقابل السعر. ويرجع ذلك أساساً إلى أن سرعة grok تتفوق على سرعة العديد من النماذج الرائدة، وإذا تمكنت جودته من بلوغ الصف الأول، فستصبح قدرته التنافسية هائلة للغاية (فضلاً عن إمكانية شحن الرصيد بحرية من دون حظر الحساب)!
تم إطلاق grok-4.6 وdeepseek-v4-pro معًا!
post-image
بعد الانتهاء من الاستماع إلى البودكاست الذي استمر ثلاث ساعات ونصف والذي أجرى فيه لاو ليو مقابلة مع زو هونغ يي، يمكنني أن ألاحظ أن لاو زو لديه بالفعل الكثير من الخبرة العملية في الصناعة، لكن للأسف كانت أسئلة لاو رو غير عميقة وغير مهنية، وهو ما يمثل نوعًا من خيبة الأمل.
على سبيل المثال، عندما تحدث لاو لو عن أن النموذج الرائد في الخارج هو هذه الفكرة، أعتقد أن ذلك متحيز بعض الشيء. لأنه في مجالات مختلفة توجد نماذج مثالية مختلفة، على سبيل المثال في مجال البرمجة، قد يكون كل من claude-4 و gpt-5-codex أفضل في الوقت الحالي؛ ومثلما ذكر لاو تشو أكثر من مرة، ما هي مشكلة الوهم في LLM، وكيف تم تحسينها في 360
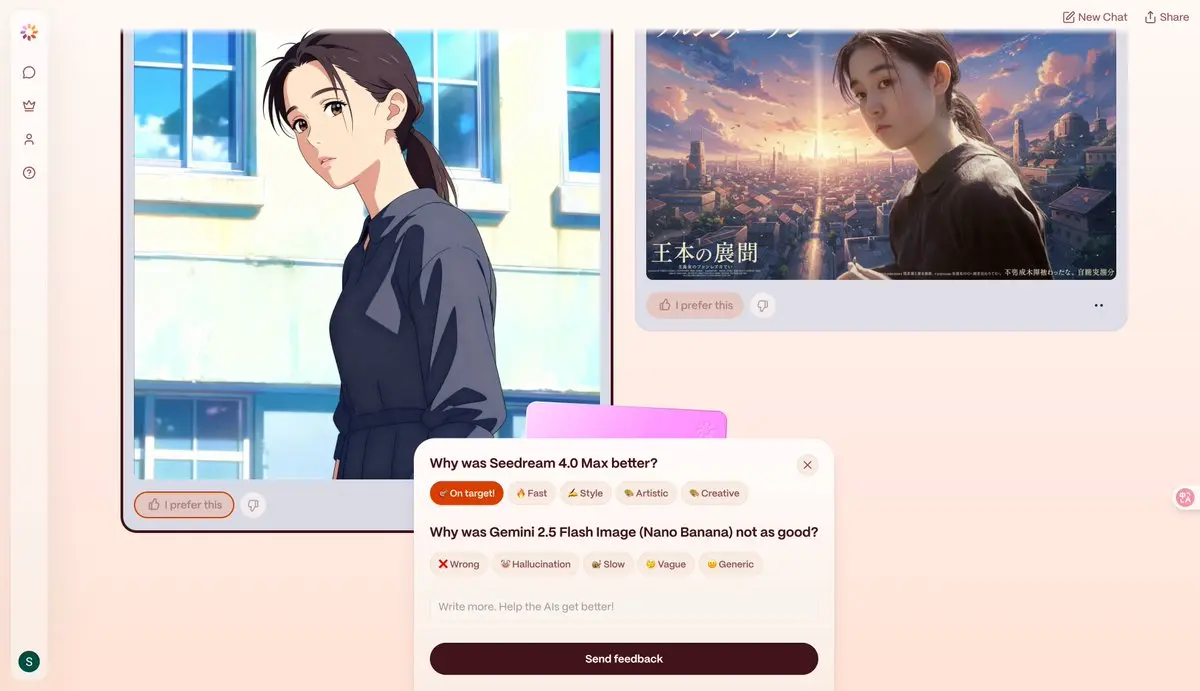
نعم، هذا الموقع مثير للاهتمام، حيث يمكن استخدامه مجانًا ومقارنة أحدث نماذج الذكاء الاصطناعي.
في كل محادثة على yupp، هناك نموذجين كبيرين من الذكاء الاصطناعي يجيبان في ذات الوقت، يمكنك اختيار الإجابة التي تعتقد أنها أفضل، ومشاركة ملاحظاتك حول الاستخدام مع yupp.
يمكن للمستخدمين الحصول على نقاط من خلال تقديم الملاحظات، والملاحظات ذات الجودة الأعلى يمكن أن تحصل على المزيد من النقاط، والمزيد من النقاط يعني أنه يمكنك استخدام المزيد من النماذج المتقدمة، وحتى سحب النقاط.
إن سبب إمكانية استخدام هذا الموقع لنموذج كبير مجاناً مرتبط مباشرة بآلية تغذية راجعة من المستخدمين التي أنشأها. ستُقدم هذه البيانات ال
post-image
أصدرت OpenAI دليل "ترميز GPT-5" الذي يحتوي على 6 أفضل الممارسات لاستخدام GPT-5 في برمجة الذكاء الاصطناعي:
# 1. يجب أن تكون التعليمات دقيقة، وتجنب تضارب المعلومات
لقد شهد نموذج GPT-5 الجديد تحسناً ملحوظاً في قدرته على اتباع التعليمات، لكن هذا جاء مع تأثير جانبي: عندما يواجه تعليمات غامضة أو متضاربة، قد يجد صعوبة في المعالجة. يجب الانتباه بشكل خاص لهذه الحالة في ملف .cursor/rules أو في تكوينك.
# 2. تحديد مستوى الاستدلال المناسب
يتمتع GPT-5 دائمًا بقدرة معينة على الاستدلال عند حل المشكلات. للحصول على أفضل النتائج، يُنصح باستخدام "جهد استدلالي عالي" عند معالجة المهام المعقدة. إذا وجدت أن النموذج ي
XPRT%⁦12.08⁩+