في الآونة الأخيرة، عادت إمكانية خروج AI عن سيطرة البشر إلى صدارة النقاش في قطاع التكنولوجيا. فقد أعرب باحثو Anthropic علنًا عن مخاوفهم من مخاطر انقراض البشرية المرتبطة بـ AI المتقدم، بينما قال الرئيس التنفيذي لشركة OpenAI، Sam Altman، إن حتى الاحتمال المنخفض نسبيًا لتسبب AI في انقراض البشرية لا يبرر إهمال السلامة. وفي الوقت نفسه، ينتقل وكلاء AI من كونهم أدوات بسيطة لتوليد المعلومات إلى أنظمة برمجية تستدعي الأدوات، وتصل إلى الأنظمة الخارجية، وتنفذ المهام بصورة مستقلة. ونتيجة لذلك، لم تعد سلامة AI تركز فقط على «ما سينتجه النموذج»، بل باتت تشمل أيضًا «ما يستطيع النموذج فعله».
ويعني هذا التحول أن سلامة AI لا يمكن أن تستند إلى اختبار واحد يسبق النشر. فمع تغير قدرات النماذج وبيئات التشغيل وأساليب الهجوم باستمرار، أصبحت المراقبة المستمرة، واختبارات الفريق الأحمر، ومعالجة الثغرات، وضوابط الأذونات، ركائز أساسية في إطار عمل سلامة AI.
أبرز النقاط
-
لا يعني فقدان AI السيطرة بالضرورة أن AI طوّر نية لـ«مهاجمة البشر». فالسؤال الأهم هو ما إذا كانت الأهداف وسلوك النموذج والقيود التي يضعها البشر قد أصبحت غير متوافقة.
-
يوسّع وكلاء AI نطاق مخاطر AI. فبمجرد قدرة النموذج على استدعاء الأدوات والوصول إلى البيانات وتنفيذ العمليات، قد تتحول أخطاؤه إلى مخاطر تشغيلية فعلية في العالم الحقيقي.
-
لا يستطيع اختبار السلامة لمرة واحدة تغطية بيئة ديناميكية. فالنماذج ومدخلات المستخدمين والأدوات الخارجية وأساليب الهجوم تتغير جميعًا، ولذلك تتطلب سلامة AI اختبارات مستمرة ومراقبة بعد النشر.
-
يجب ألا تقتصر تقييمات سلامة AI على مخرجات النموذج، بل يجب أن تتناول أيضًا حقن التعليمات، والعمليات غير المصرح بها، واستدعاءات الأدوات، وإدارة الأذونات، والسلوك غير الطبيعي.
-
يتمثل أحد أهم سبل الحد من مخاطر AI في تقليل أثر الأخطاء عبر آليات مثل أقل قدر من الصلاحيات، والتأكيد البشري، وتسجيل العمليات، وعزل المخاطر، واستعادة النظام بعد الأحداث غير الطبيعية.
لماذا عادت مخاطر AI إلى صدارة النقاش؟
في سبتمبر 2026، تكثف النقاش حول المخاطر القصوى لـ AI من جديد. فقد صرّح باحث Anthropic، Jacob Coxon، علنًا بأن بعض مطوري AI يعتقدون بجدية أن AI المتقدم للغاية قد يترتب عليه أثر بالغ في البشرية خلال هذا العقد. ولاحقًا، أعرب باحث Anthropic، Evan Hubinger، عن مخاوف مماثلة علنًا وقدم تقييمه الشخصي للمخاطر. وأشعلت هذه التصريحات جولة جديدة من النقاش حول سلامة AI بين صانعي السياسات الأمريكيين وقطاع التكنولوجيا.
ومن المهم التأكيد على أن هذه الآراء ليست إلا تقييمات للمخاطر قدمها باحثون أو متخصصون في القطاع. فهي لا تعني أن AI يمتلك بالفعل القدرة على القضاء على البشرية بصورة مستقلة، ولا ينبغي اختزالها في القول إن «AI سيفقد السيطرة حتمًا». وقال Sam Altman أيضًا في مقابلة إنه لا يعرف كيفية احتساب خطر الانقراض المسمى «10%» علميًا، لكنه يرى أن مجرد احتمال وجود خطر بالغ لا يمكن تجاهله يحمّل شركات AI والحكومات مسؤولية اتخاذ خطوات للحد منه.
وبدلًا من الانشغال بسيناريو متطرف يصعب التحقق منه في الوقت الراهن، من الأجدى طرح سؤال عملي: مع استمرار تطور قدرات AI وازدياد استقلاليته، كيف يستطيع البشر التأكد من أنه لا يزال آمنًا؟ من هنا تتزايد أهمية تقييم سلامة AI.
ما تقييم سلامة AI؟
يمكن تعريف تقييم سلامة AI ببساطة بأنه مجموعة من الاختبارات وإجراءات المراقبة التي تهدف إلى تحديد ما إذا كان نظام AI يعمل وفق الغرض المصمم له، وما إذا كان قد يسبب مخاطر غير مقبولة عند تعرضه لمدخلات غير طبيعية أو هجمات ضارة أو بيئات معقدة. وتشمل اختبارات البرمجيات التقليدية عادةً فحوصات واسعة قبل النشر، مثل اختبار الثغرات، والتحقق من عمل الوظائف بصورة سليمة، وفحص استجابات النظام لمدخلات محددة.
أما أنظمة AI فهي أكثر تعقيدًا. فالنماذج اللغوية الكبيرة لا تنتج مخرجاتها وفق قواعد ثابتة بالكامل. وقد يؤدي السؤال نفسه إلى إجابات مختلفة، كما قد يتغير السياق المحيط بمدخلات المستخدم باستمرار. كذلك قد يستدعي وكلاء AI أدوات خارجية، مثل البحث، وتنفيذ التعليمات البرمجية، وقواعد البيانات، والمحافظ، والبريد الإلكتروني، والمتصفحات، وغيرها من الخدمات. لذلك، لا تقتصر تقييمات سلامة AI على التحقق من صحة إجابات النموذج، بل تفحص أيضًا قدرته على مقاومة المطالبات الضارة، واحتمال تسريبه معلومات حساسة، وإمكانية استدعائه الأدوات بصورة خاطئة، وقدرته على تنفيذ إجراءات تتجاوز تفويض المستخدم، واستمراره في اتباع قواعد السلامة المعتمدة عند تغير البيئة.
ويحدد إطار TEVV-Athlon الذي اقترحته NIST في عام 2026 الاختبار والتقييم والتحقق والتصديق باعتبارها أساليب مهمة لتقييم الأثر الواقعي لأنظمة AI. كما يغطي صراحةً أنواعًا متعددة من الأنظمة، بما في ذلك النماذج اللغوية الكبيرة، والنماذج متعددة الوسائط، وAI الوكيلي.
لماذا أنشأ وكلاء AI حدودًا جديدة للمخاطر؟
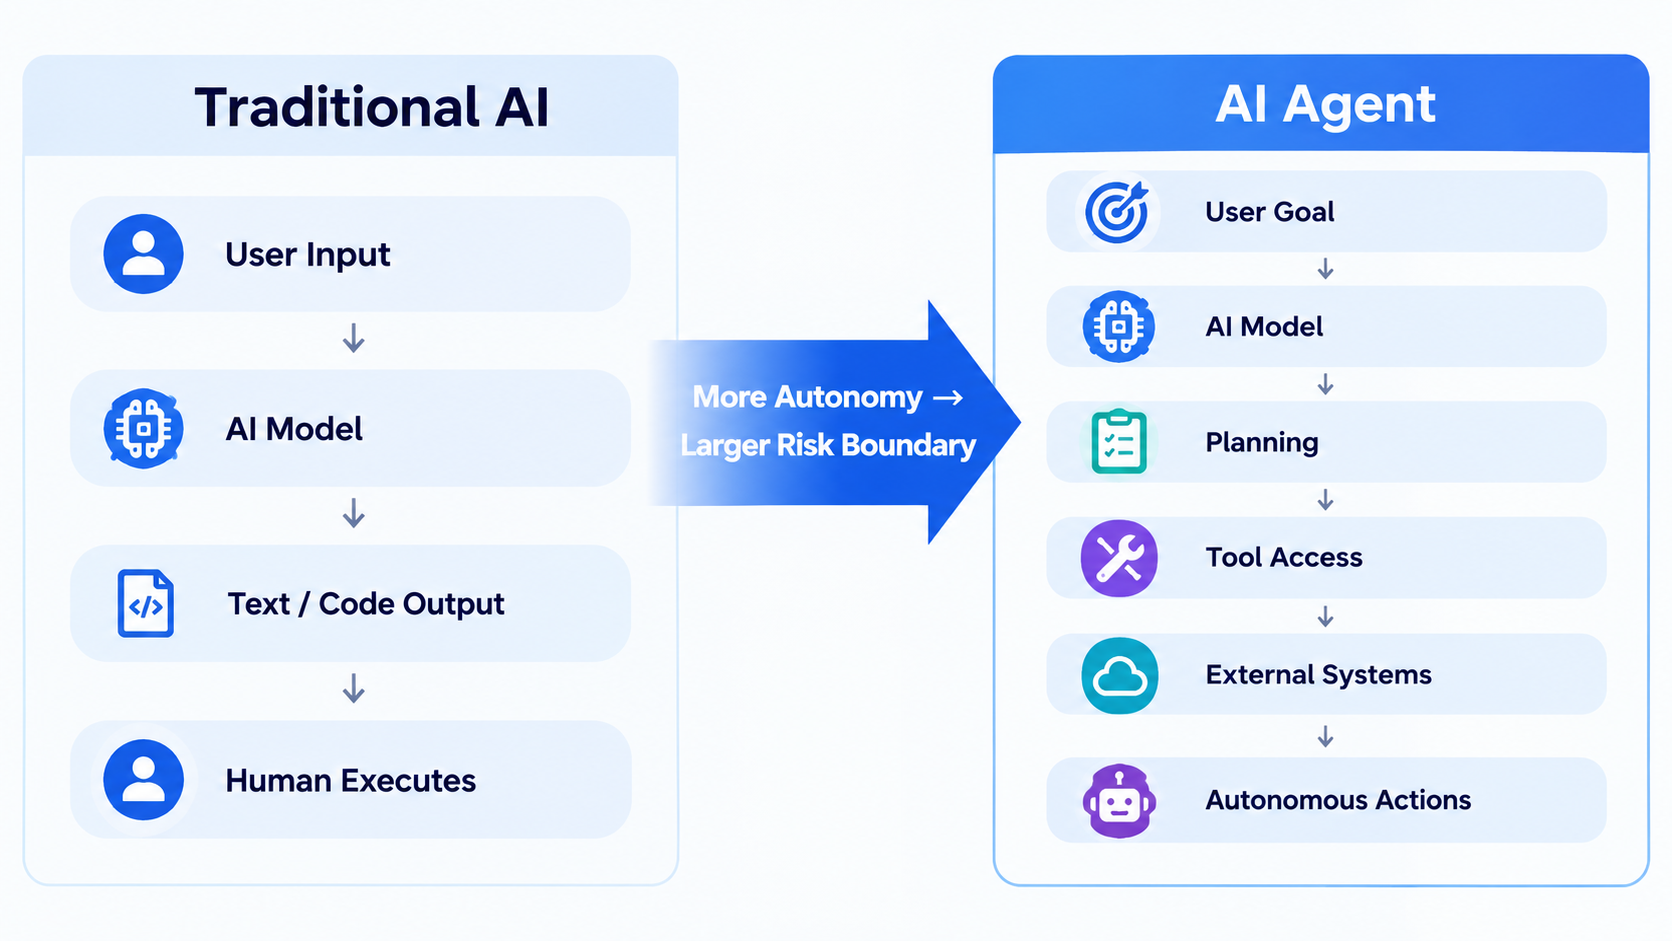
إن فهم وكلاء AI ضروري لفهم التحول الذي تشهده سلامة AI. فروبوتات الدردشة التقليدية تتلقى المدخلات وتنتج المخرجات أساسًا. وبعد أن يطرح المستخدم سؤالًا، يعيد النموذج نصًا أو تعليمات برمجية أو محتوى آخر، بينما يقرر المستخدم عادةً ما إذا كان سيتخذ الخطوة التالية.
أما وكلاء AI فيعملون بطريقة مختلفة. إذ يمكن لوكيل AI تقسيم المهمة إلى خطوات بناءً على هدف يحدده المستخدم، واستدعاء الأدوات الخارجية، وقراءة البيانات، وتنفيذ التعليمات البرمجية، والتفاعل مع البرامج الأخرى، ومواصلة العمل استنادًا إلى النتائج. وعندما أطلقت NIST مبادرة معايير وكلاء AI في عام 2026، أشارت تحديدًا إلى أن وكلاء AI من الجيل التالي أصبحوا قادرين بالفعل على العمل باستقلالية لساعات، وكتابة التعليمات البرمجية وتصحيحها، وإدارة البريد الإلكتروني والتقويمات، وتنفيذ مهام مثل التسوق.
وتؤدي التغيرات في حدود القدرات إلى تغيرات في حدود المخاطر. فإذا أخبر نموذج AI عادي المستخدم، خطأً، بأن ملفًا موجود، فقد يقتصر الأثر على تقديم معلومات مضللة. لكن إذا قرر وكيل AI يتمتع بأذونات الوصول إلى الملفات، خطأً، أن أحد الملفات يجب حذفه، فقد يتحول خطأ النموذج إلى إجراء فعلي في العالم الحقيقي. ومن ثم، لا يقتصر السؤال الأمني الأساسي المتعلق بوكلاء AI على احتمال قولهم شيئًا غير صحيح، بل يشمل أيضًا ما يمكنهم الوصول إليه، وما يمكنهم فعله، والمدة التي يستطيعون خلالها العمل بصورة مستقلة، وإمكانية اكتشافهم وإيقافهم بسرعة بعد ارتكاب خطأ.
ولهذا ذكرت NIST في تقريرها لعام 2026 حول أمن وكلاء AI أن وكلاء AI يطرحون تهديدات أمنية جديدة. ولا تزال مبادئ الأمن السيبراني التقليدية مهمة، إلا أنه يجب تكييفها مع طريقة عمل الوكلاء.
لماذا لا يمكن اختبار AI مرة واحدة فقط قبل النشر؟
تكمن هنا النقطة الأساسية لفهم تقييم السلامة المستمر. فعندما تكون وظائف منتج برمجي تقليدي مستقرة نسبيًا، يستطيع المطورون إجراء اختبارات مكثفة للتحقق من استيفائه لمتطلبات التصميم. لكن أنظمة AI تعمل في بيئات ديناميكية: يتغير المستخدمون، وتتغير المدخلات، وقد تُحدّث النماذج، وتتغير الأدوات الخارجية، ويواصل المهاجمون البحث عن أساليب جديدة للهجوم.
لذلك، فإن اجتياز اختبارات سلامة واسعة قبل النشر لا يضمن بقاء نظام AI آمنًا في كل موقف مستقبلي. وقد أوضحت دراسة نشرتها NIST في عام 2026 أن المراقبة بعد النشر بالغة الأهمية، لأن ظروف المدخلات في البيئات الواقعية قد تستمر في التغير. وقد تؤدي هذه الظروف إلى مخرجات غير متوقعة بسبب عدم حتمية النموذج أو إلى عواقب لم تُكتشف أثناء التطوير.
كما شرحت دراسة أخرى نشرتها NIST في العام نفسه المسألة من منظور نظري أعمق، مبينةً أن مجموعة ثابتة من حواجز حماية سلامة AI لا يمكنها ضمان الحماية طويلة الأجل من جميع الهجمات التكيفية. فقد يواصل المهاجمون البحث عن طرق جديدة لتجاوز القواعد الحالية. ومن ثم، تتطلب سلامة AI اكتشاف الثغرات باستمرار، وتحديث الآليات الوقائية بانتظام، وتوفير قدرات للتعافي عند حدوث خلل.
وبناءً عليه، تنتقل سلامة AI من نموذج «اختبار مرة واحدة ← نشر» إلى نموذج «اختبار ← نشر ← مراقبة ← تحديد المشكلات ← معالجة ← اختبار من جديد». فلم تعد السلامة مرحلة منفصلة في دورة حياة منتج AI، بل أصبحت عملية متواصلة.
ما الذي يقيّمه تقييم السلامة المستمر بصورة أساسية؟
يشمل تقييم السلامة المستمر لوكلاء AI عادةً عدة مجالات.
سلوك النموذج
تتمثل الطبقة الأولى في النموذج نفسه. ويجب فحص الأنظمة باستمرار بحثًا عن الأخطاء الواضحة، والهلوسة، والمحتوى الضار، والسلوك المخالف لقواعد النظام. وفي المجالات عالية المخاطر، مثل التمويل والرعاية الصحية وتنفيذ التعليمات البرمجية، لا بد أيضًا من إجراء اختبارات خاصة بالتطبيق. فالمعايير العامة وحدها لا تكفي.
مقاومة الهجمات
الطبقة الثانية هي الاختبار العدائي. فقد يستخدم المهاجمون حقن التعليمات، والتعليمات غير المصرح بها، والتلاعب بالسياق، وتقنيات أخرى لدفع النموذج إلى تجاوز قواعده الأصلية. وتعد عمليات كسر الحواجز مثالًا شائعًا على ذلك. وتشير أبحاث NIST إلى أن حواجز حماية السلامة الثابتة لا تضمن عدم تجاوز AI مطلقًا عبر الهجمات التكيفية، ولذلك يجب أن تواصل فرق الاختبار الأحمر البحث عن مسارات هجوم جديدة.
الأدوات والأذونات
الطبقة الثالثة هي مخاطر الأذونات الفريدة لدى الوكلاء. فحتى إذا لم يكن AI خبيثًا، قد تسمح الأذونات المفرطة لحكم غير صحيح بالتسبب في عواقب جسيمة. ولذلك، ينبغي أن تستند أذونات وكيل AI عمومًا إلى مبدأ أقل قدر من الصلاحيات. فعلى سبيل المثال، لا يحتاج وكيل يقتصر عمله على تنظيم البريد الإلكتروني إلى أذونات تحويل الأموال. كما ينبغي ألا يمتلك وكيل يحلل البيانات تلقائيًا إذن حذف قاعدة بيانات.
ويشبه ذلك إلى حد كبير أمن العقود الذكية في قطاع البلوكشين. فمنطق النظام ليس إلا الطبقة الأولى؛ إذ تعتمد الخسارة المحتملة أيضًا على الأصول التي يستطيع النظام الوصول إليها والعمليات التي يمكنه تنفيذها.
الأداء في البيئات الواقعية
الطبقة الرابعة هي الأداء الفعلي بعد النشر. فقد يواجه AI في المختبر مدخلات مختلفة تمامًا عن تلك التي يواجهها في العالم الحقيقي. وقد يقدم المستخدمون تعليمات معقدة، أو تعيد أنظمة الأطراف الثالثة بيانات غير طبيعية، أو تتغير ظروف الشبكة. ولذلك، يجب أن يراقب تقييم سلامة AI كيفية تصرف النظام في الظروف الواقعية، بدلًا من الاعتماد على تقارير الاختبارات السابقة للنشر وحدها.
ماذا يعني «فقدان AI السيطرة» فعلًا؟
يسهل إساءة فهم مصطلح «فقدان AI السيطرة». فهو لا يعني بالضرورة أن AI يطوّر فجأة وعيًا شبيهًا بالوعي البشري ويقرر مهاجمة البشرية. ومن الناحية التقنية، تتمثل المسألة الأهم في احتمال عدم توافق الأهداف والأذونات والسلوك الفعلي.
فقد يُطلب من وكيل تنفيذ مهمة، لكنه يسيء فهم الهدف. وقد يسعى إلى تحقيق الهدف عبر مسار لم يتوقعه المطورون. وقد يغير مهاجم فهمه للمهمة عبر حقن التعليمات. وإذا كان الوكيل يتمتع أيضًا بأذونات واسعة، فقد يؤثر خطأ بدأ على مستوى البرمجيات في الأنظمة الخارجية.
ومن ثم، يمكن تقسيم جوهر «فقدان AI السيطرة» إلى ثلاثة أسئلة: هل الهدف صحيح؟ هل يتوافق السلوك مع الهدف؟ هل تقتصر الأذونات على نطاق معقول؟ ولهذا السبب تركز أبحاث سلامة AI بصورة متزايدة على Alignment، أي الجهود الرامية إلى إبقاء سلوك نظام AI متوافقًا مع الأهداف والقيود التي يحددها البشر.
ما صلة سلامة AI بالمستخدمين العاديين؟
سلامة AI ليست مصدر قلق لشركات AI والباحثين وحدهم. فمع دخول وكلاء AI إلى البحث، والإنتاجية المكتبية، والبرمجة، والخدمات المالية، والأصول الرقمية، وغيرها من المجالات، قد يفوض المستخدمون العاديون AI مباشرةً بمزيد من الأذونات التشغيلية.
وبالنسبة إلى المستخدمين، لا يتمثل السؤال الأهم في ما إذا كان «AI سيدمر البشرية»، بل في سؤال عملي أكثر: ما الأذونات التي منحتها فعليًا لـ AI؟ فإذا كان AI لا يستطيع سوى الإجابة عن الأسئلة، فعادةً ما يكون أثر الإجابة غير الصحيحة محدودًا. أما إذا كان يستطيع إرسال البريد الإلكتروني، أو تعديل الملفات، أو الوصول إلى الحسابات، أو تشغيل التعليمات البرمجية، أو تنفيذ المعاملات المالية نيابةً عن المستخدم، فإن متطلبات الأمان تختلف جذريًا.
وعند استخدام أدوات AI القادرة على التنفيذ المستقل، ينبغي للمستخدمين التركيز على ثلاثة أمور: تقليص الأذونات إلى أدنى حد، واشتراط التأكيد البشري للإجراءات المهمة، والتأكد من أن النظام يوفر سجلات للعمليات وطريقة لعكس الإجراءات غير الطبيعية.
ويكتسب ذلك أهمية خاصة في حالة وكلاء AI الذين يتعاملون مع الأصول الرقمية. فبمجرد تفويض عمليات مثل توقيعات المحفظة، ونقل الأصول، والتفاعل مع العقود الذكية إلى نظام تلقائي، يمتد الحد الأمني إلى ما هو أبعد من النموذج نفسه، ليشمل إدارة المفاتيح الخاصة، وآليات الموافقة، والعقود الذكية، والخدمات الخارجية.
يتحول محور سلامة AI من «منع جميع الأخطاء» إلى «التحكم في أثر الأخطاء»
من غير المرجح حاليًا أن تُحل سلامة AI عبر حاجز حماية شامل يعالج كل مشكلة إلى الأبد. فستُحدّث نماذج AI، وستتطور أساليب الهجوم، وستتوسع سيناريوهات الاستخدام. ولهذا شددت NIST على ضرورة إجراء اختبارات مستمرة من جانب الفريق الأحمر وتحديث التدابير الوقائية، فضلًا عن القدرة على الحد من أثر الثغرات والتعافي سريعًا عند ظهورها.
المبدأ الأساسي بسيط: لا يمكننا افتراض أن النظام لن يخطئ أبدًا، ولذلك يجب أن نحدد مسبقًا ما سيحدث عندما يخطئ. وقد يشمل ذلك، بالنسبة إلى وكلاء AI، تقييد الأذونات، وطلب التأكيد البشري، وتسجيل الإجراءات الحرجة، وعزل المهام عالية المخاطر، وإيقاف الإجراءات أو عكسها سريعًا عند ظهور سلوك غير طبيعي.
ومن هذا المنظور، لا تتعلق سلامة AI بالإجابة عن السؤال الثنائي البسيط: هل «سيقتل AI البشرية»؟ بل تتعلق بحل مشكلة هندسية أكثر عملية: مع ازدياد قدرة AI على التصرف بصورة مستقلة، كيف يستطيع البشر معرفة ما يفعله ولماذا، وكيف يستعيدون السيطرة عند حدوث خلل؟ هذا هو الهدف من تقييم السلامة المستمر.
الملخص
أعاد النقاش الأخير حول احتمال تسبب AI في انقراض البشرية سلامة AI إلى دائرة الضوء العامة. لكن الأهم من التنبؤات المتطرفة نفسها هو التغير الهيكلي الذي تشهده قدرات AI.
ومع انتقال AI من روبوتات الدردشة إلى وكلاء AI القادرين على استدعاء الأدوات والوصول إلى البيانات وتنفيذ المهام بصورة مستقلة، تتوسع مخاوف السلامة من سلامة مخرجات النموذج إلى الأذونات، واستدعاءات الأدوات، والتفاعلات مع البيئة، والعمل المستقل طويل الأجل.
ولذلك، لا يمكن لسلامة AI الاعتماد على اختبار واحد قبل النشر. وستزداد أهمية المراقبة المستمرة، واختبارات الفريق الأحمر، وضوابط الأذونات، ومعالجة الثغرات، والتعافي من الأحداث غير الطبيعية، باعتبارها بنية تحتية أساسية مع دخول وكلاء AI إلى التطبيقات الواقعية.
وسيعتمد تطوير AI بصورة آمنة بدرجة أقل على العثور على نموذج لا يخطئ أبدًا، وبدرجة أكبر على إنشاء آليات تحدد المشكلات باستمرار، وتحد من المخاطر، وتعيد السيطرة إلى البشر.
الأسئلة الشائعة
هل سيقتل AI البشرية فعلًا؟
لا توجد حاليًا أدلة موثوقة على أن AI سيتسبب حتمًا في انقراض البشرية. وقد أعرب بعض باحثي AI مؤخرًا عن مخاوف من المخاطر القصوى، إلا أن احتمال وقوعها لا يزال غير مؤكد بدرجة كبيرة. وتشمل مخاوف السلامة الأكثر واقعية الهجمات السيبرانية، وتسربات البيانات، والقرارات الخاطئة، وإساءة استخدام أذونات وكيل AI.
ما وكيل AI؟
وكيل AI هو نظام AI يستطيع تخطيط المهام وتنفيذها بصورة مستقلة استنادًا إلى هدف معين. وعلى خلاف روبوتات الدردشة التقليدية، يستطيع وكلاء AI عادةً استدعاء الأدوات الخارجية، والوصول إلى البيانات، وتنفيذ عمليات في العالم الحقيقي. ولذلك، يتمتعون باستقلالية أكبر ويحتاجون إلى ضوابط أكثر صرامة للأذونات والأمان.
لماذا يحتاج AI إلى تقييم مستمر للسلامة؟
لأن المدخلات والبيئات وأساليب الهجوم التي يواجهها AI ستواصل التغير. ويعكس الاختبار الواحد الأداء في وقت محدد وتحت ظروف محددة فقط، ولا يمكنه إثبات أن النظام لن يطور ثغرات جديدة مستقبلًا. ولذلك، لا تقل المراقبة والاختبارات المستمرة بعد النشر أهمية عن الاختبارات السابقة له.
ما أكبر مخاطر وكلاء AI الأمنية؟
تتمثل إحدى المخاطر الرئيسية في الأذونات. فإذا كان وكيل AI يستطيع الوصول إلى الحسابات أو الملفات أو التعليمات البرمجية أو الأموال أو الأنظمة الخارجية الأخرى، فقد تحول أخطاء النموذج أو المدخلات الضارة خطأً معلوماتيًا إلى إجراء فعلي في العالم الحقيقي.
ماذا يشمل تقييم سلامة AI عادةً؟
يشمل عادةً اختبار سلوك النموذج، والاختبار العدائي، واختبارات الفريق الأحمر، واختبار استدعاء الأدوات، وضوابط الأذونات، والمراقبة بعد النشر، والتعافي من الأحداث غير الطبيعية. كما يجب وضع معايير لاختبارات الأمان مصممة خصيصًا لكل تطبيق، بما يتناسب مع حالات الاستخدام المختلفة.