بالنسبة للمبتدئين الذين يرسمون حدود قدرات الذكاء الاصطناعي، يجيب نموذج العالم عن سؤال ما إذا كان النظام يستطيع توقّع عواقب الأفعال، لا ما إذا كان يكتب إجابات سلسة. تغطي الأقسام التالية التعريف، وحلقة التنبؤ، وثلاثة مسارات تقنية، واختيار المهام بين نموذج العالم مقابل LLM، والاختلافات عن توليد الفيديو، وحالات الاستخدام، وحدود التقييم؛ وتظهر المفاهيم المجاورة في شروحات Gate Learn حول الذكاء الفائق (ASI) والذكاء الاصطناعي الخاص.
أهم النقاط
- القدرة الأساسية هي التنبؤ المشروط بالفعل: عند إعطاء حالة وفعل، يُنتج النظام الحالة التالية (أو التمثيل التالي) للتخطيط والتحكم.
- ثلاثة مسارات شائعة: التعلم المعزز القائم على النماذج (MBRL) / التدريب بالتخيل، والمحاكاة التفاعلية التوليدية، والتمثيلات التنبؤية بأسلوب JEPA.
- تتفوق نماذج اللغة الكبيرة في التنبؤ بالرمز التالي، وتتفوّق مولدات الفيديو في استمرارية المظهر؛ لكن لا يساوي أي منهما تلقائيًا نموذج عالم قابلًا للتخطيط.
- ينبغي أن يراقب التقييم الفيزياء الزائفة، والانحراف طويل الأمد، والفشل خارج التوزيع، والمقاييس الصارمة، والحد الفاصل مع المحاكيات المكتوبة يدويًا.
ما نموذج العالم، وما المشكلة التي يحلها؟
يعالج نموذج العالم سؤالًا عمليًا: قبل أن يتصرف الوكيل، هل يستطيع تقدير ما سيحدث بعد ذلك بصورة موثوقة؟ من دون هذه القدرة، يعتمد التعلم على التجربة والخطأ في الواقع، وهو ما يكون مكلفًا أو بطيئًا أو غير آمن في كثير من الأحيان، كما يصبح التخطيط خارج بيئة التشغيل صعبًا.
في الروبوتات، والقيادة الذاتية، ووكلاء الألعاب، وتدريب المحاكاة، خصوصًا للوكلاء المتجسدين في بيئات افتراضية أو مادية، تكون التغذية الراجعة مكلفة أو محفوفة بالمخاطر؛ فعلى سبيل المثال، قد تتسبب سياسة قيادة سيئة في حادث حقيقي قبل أن تتعلم. ينقل نموذج العالم «تجربة الأفعال» إلى ديناميكيات متعلَّمة: إذ يتقدم في فضاء كامن أو فضاء الملاحظات، ثم يعيد سياسة أقوى إلى العالم الحقيقي. يختلف هذا الهدف عن الأنظمة الحوارية التي تعيد عرض المعرفة في الأساس؛ فهو أقرب إلى الاستبصار السببي داخل بيئة تفاعلية.
يصف مدخل مسرد NVIDIA حول نماذج العالم هذه النماذج بأنها تمثيلات داخلية تساعد الذكاء الاصطناعي على فهم كيفية تطور العالم المادي والتنبؤ بها؛ ويضع Yann LeCun في A Path Towards Autonomous Machine Intelligence نماذج العالم التنبؤية ضمن مسار نحو ذكاء أكثر استقلالية؛ كما ساهم عمل David Ha لعام 2018 بعنوان “World Models” في تحديد النهج الحديث القائم على التعلم. لا يرى الوكيل عادة سوى ملاحظات جزئية، لذلك لا تكون الحالة الكاملة متاحة مباشرة. وفي جميع هذه الرؤى، يوجد التنبؤ لدعم القرارات.
كيف يعمل نموذج العالم؟ الحالة والفعل وحلقة التنبؤ
أكثر اختبار استقرارًا للنظام الموجّه نحو نموذج العالم هو التنبؤ المشروط بالفعل: أي ما إذا كانت المدخلات تتضمن فعل الوكيل صراحةً، أو إشارة تحكم، وما إذا كان الناتج هو الحالة التالية أو التمثيل التالي المشروط بهذا الفعل.
تُختصر الحلقة عادةً في ثلاث خطوات: ترميز الملاحظات في حالة؛ واشتراطها بفعل مرشح؛ ثم التنبؤ بالحالة التالية، مع تغيّر البيئة بعد ذلك الفعل وإرجاعها ملاحظات جديدة، مع إمكانية تمديد ذلك التنبؤ اختياريًا ليصبح نقطة بداية جديدة. تقارن سياسة أو مخطط المسارات المتخيلة من حيث المكافأة أو المخاطر أو القيود، ثم تنفذ الإجراء؛ وتبدأ ملاحظة جديدة عملية الترميز من جديد.
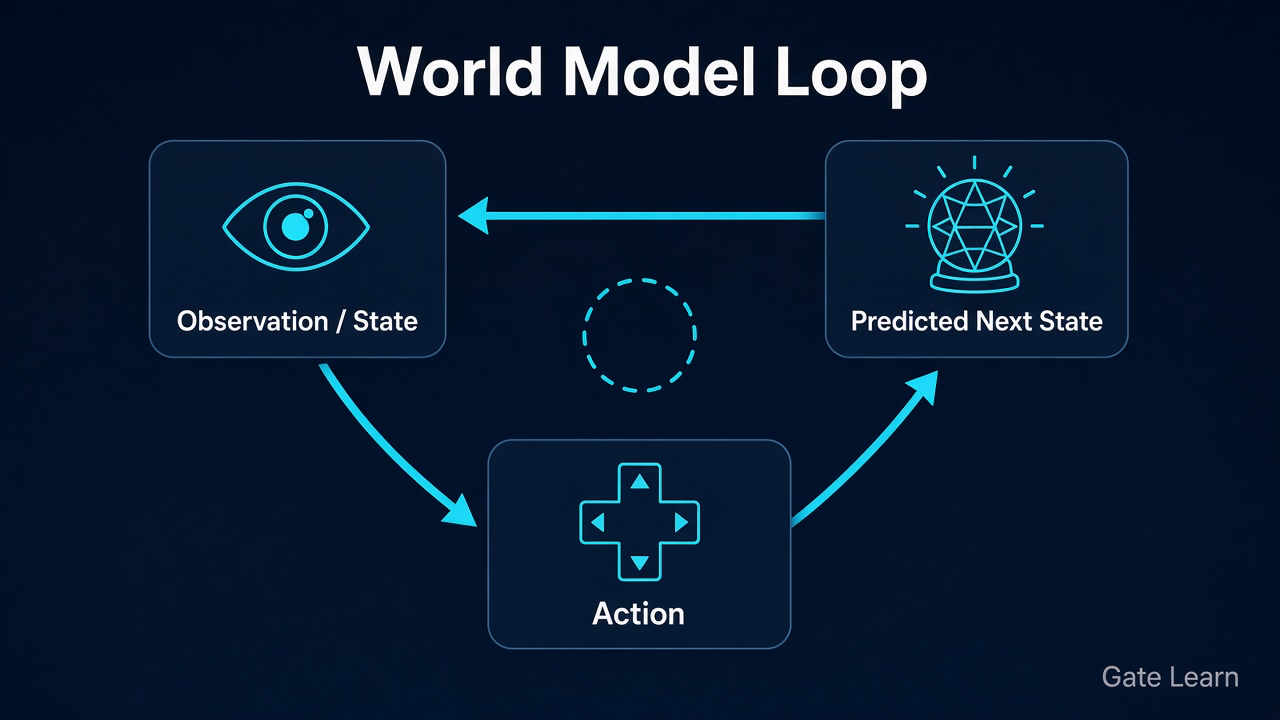
الشكل 1. حلقة نموذج العالم: تؤدي الملاحظة/الحالة مع الفعل إلى حالة تالية متوقعة تغذي الدورة التالية.
تتجنب العديد من الأنظمة العملية التنبؤ طويل الأمد بالبكسلات الأولية، وتتعلم بدلًا من ذلك ديناميكيات كامنة: إذ تضغط البيانات المرئية عالية الأبعاد في حالة مدمجة، ثم تتقدم في ذلك الفضاء. تقلل عمليات التمديد الكامنة الضوضاء البصرية وتجعل التدريب بالتخيل أقل تكلفة؛ ومع ذلك، فإن مدى التزام الحالة الكامنة بالفيزياء الحقيقية يحتاج إلى اختبارات للمهام اللاحقة واختبارات خارج التوزيع، خصوصًا لأن البيئة المادية لا تُرصد إلا جزئيًا ويجب استنتاجها عبر التغذية الراجعة.
ما المسارات التقنية الرئيسية لنماذج العالم؟
«نموذج العالم» تسمية واسعة تشمل عدة عائلات تقنية، وليست اسم خوارزمية واحدة. يبدأ الاختيار بالمهمة: سياسات قابلة للتحكم، أو محاكاة تفاعلية بالبكسلات، أو تمثيلات مجردة قابلة للنقل.
| المسار |
الفكرة الأساسية |
الأنسب لـ |
التكلفة الرئيسية |
| MBRL / التدريب بالتخيل |
تعلّم الديناميكيات، ثم تدريب سياسة على عمليات تمديد النموذج (Dreamer) |
التحكم والألعاب والتعلم المعزز بكفاءة عالية في العينات |
خطأ النموذج يفسد السياسة؛ والانحراف |
| المحاكاة التفاعلية التوليدية |
تعلّم بيئة تفاعلية تولد الإطارات/الملاحظات التالية |
زيادة البيانات وعوالم الفيديو التفاعلية |
المظهر ≠ الفيزياء؛ وتقييم مكلف |
| التمثيلات التنبؤية بأسلوب JEPA |
التنبؤ بالتضمينات المستقبلية/المقنّعة في فضاء التمثيل (I-JEPA) |
تعلم التمثيل والتنبؤ المجرد للتخطيط |
بلا بكسلات؛ ويتطلب حزمة تحكم |
قد يتمحور أحد المسارات حول نموذج فيديو يتنبأ بالإطارات المستقبلية، بينما يستهدف مسار آخر ديناميكيات كامنة جاهزة للتخطيط بدلًا من إعادة البناء البصري الكامل.
يمكن أن تتعايش المسارات الثلاثة: تؤكد الأساليب بأسلوب Dreamer على تدريب السياسات في التخيل؛ وتؤكد نماذج عالم الفيديو التوليدية على محاكاة المظهر التفاعلي؛ ويعرض I-JEPA من Meta AI التنبؤ في فضاء تضمين مشترك بدلًا من إعادة بناء كل بكسل. وتختار الأنظمة المختلفة أيضًا وصفات تدريب مختلفة تبعًا لما إذا كانت تتعلم من أزواج المدخلات والمخرجات، أو عمليات تمديد التحكم، أو التضمينات التنبؤية. حدّد المهمة أولًا، ثم ناقش التسميات.
كيف تختلف نماذج العالم عن LLMs وتوليد الفيديو؟
تتنبأ الأنظمة الثلاثة جميعًا، لكنها ضمن الذكاء الاصطناعي التوليدي تتنبأ بأشياء مختلفة وتختلف في اشتراط الفعل: تتنبأ LLMs بالرمز التالي، وتتنبأ مولدات الفيديو بمظهر الإطار التالي، بينما تتنبأ الأنظمة الموجهة نحو نماذج العالم بكيفية تطور الحالة بعد الفعل.
| البعد |
نموذج العالم |
نموذج اللغة الكبير (LLM) |
توليد الفيديو |
| هدف التنبؤ الأساسي |
الحالة التالية / الديناميكيات الكامنة، وغالبًا ما تكون مشروطة بالفعل |
الرمز التالي / بنية النص |
مظهر الإطار أو المقطع التالي |
| الارتباط بالفعل |
التنبؤ المشروط بالفعل هو محور القرار |
لا توجد عادةً حلقة تحكم مادية |
قد يكون مشروطًا بالنص/الإطار الأول، لكنه غير قابل للتنفيذ |
| الاستخدام المعتاد |
التخطيط والتحكم والذكاء الاصطناعي المتجسد |
اللغة والكتابة وتنسيق الأدوات |
توليد المحتوى والمعاينات والمحاكاة التفاعلية |
| الالتباس الشائع |
القدرة على الدردشة = نموذج عالم |
الكتابة عن الفيزياء = مهارة فيزيائية |
إطارات واقعية = ديناميكيات صحيحة |
لذلك، يمكن لمولد فيديو شبيه بـ Sora أن يعرض إطارات متماسكة بدقة بصرية عالية، بل واتساقًا مكانيًا ظاهريًا، وقد يُسمى «نموذج عالم للفيديو»، لكن هذه السمات وحدها لا تثبت فهمًا فيزيائيًا. من دون واجهة أفعال مستقرة، وانتقالات حالة قابلة للتحقق، وحلقة تخطيط، يبقى التصنيف الدقيق هو الفيديو التوليدي. ويمكن لنظام أقوى أيضًا تقييم تسلسلات الأفعال لدعم التخطيط واتخاذ القرار، وليس مجرد عرض مشاهد مرجحة بصورة سلبية. قد يروي LLM «ماذا لو دفعت الكوب قليلًا»، لكن ذلك لا ينشئ ديناميكيات بيئية قابلة للتمديد والتقييم.
أين تُستخدم نماذج العالم عادةً؟
الذكاء الاصطناعي المتجسد هو بيئة استخدام متكررة: تحتاج الأذرع والروبوتات المتنقلة إلى ذكاء مكاني، أي التفكير في التخطيطات والحركة والتغير في العالم المادي، إضافة إلى توقعات التلامس والإزاحة قبل لمس الأشياء، لأن كثيرًا من التفاعلات يصعب عكسها بمجرد بدء الحركة. يتيح التنبؤ المشروط بالفعل للأنظمة استبعاد المسارات الفاشلة في المحاكاة أو الفضاء الكامن قبل تحمّل تكلفة الاصطدامات الحقيقية؛ ويمكن للعروض التوضيحية تهيئة السلوك، لكنها لا تحل محل التعلم القائم على التفاعل.
تُعد الألعاب والتعلم المعزز القائم على النماذج مجالًا أساسيًا آخر. تحسن الأساليب بأسلوب Dreamer السياسات على المسارات المتخيلة بحيث يمكن أن يظهر تحكم قابل للاستخدام مع تفاعلات حقيقية أقل. تنتقل أفكار مشابهة إلى سجلات التحكم الصناعي التي يكون فيها المحاكي المكتوب يدويًا غير مكتمل، لكن سجل الملاحظات وفير، لأن النموذج يحاول التقاط ديناميكيات النظام من ذلك السجل.
تتضمن القيادة الذاتية، وجدولة المستودعات، ومحاكاة متعددة الوكلاء أيضًا مكونات نموذج العالم، ليس كبديل كامل لحزم التخطيط، بل كطبقة لعواقب قصيرة الأمد. ويُستخدم الاختبار الافتراضي وبيانات الفيديو المنسقة غالبًا لتدريب هذه المكونات وتقييمها عبر السيناريوهات قبل النشر الفعلي. وقد يحتوي أي نظام تحكم يجب أن «يفكر قبل التصرف» على وحدة نموذج عالم.
ما المزايا والمخاطر والحدود المهمة عند تقييم نماذج العالم؟
تتمثل الفائدة في كفاءة العينات وتجربة الخطأ والصواب الأكثر أمانًا: إذ يمكن للتخيل داخل النموذج أن يقلل الاستكشاف الخطر، ويمكن للتوقعات المشروطة بالفعل أن تجعل التخطيط قائمًا على ديناميكيات قابلة للفحص. تظهر الحدود والمخاطر غالبًا عندما يبدو النموذج صحيحًا لكنه غير جدير بالثقة، لأن التمثيل الداخلي المصقول لا يساوي سلوكًا يصمد عند النشر.
| الآلية |
ما تراه |
سبب خفائها |
أسئلة للتحقق |
| فيزياء زائفة |
مسارات سلسة تنتهك الحفظ/التلامس |
الرؤية تثق بالسلاسة |
هل تُحفظ الكميات الأساسية؟ هل يمكن للأجسام المرور عبر بعضها؟ |
| انحراف طويل الأمد |
عمليات تمديد قصيرة جيدة؛ والطويلة تنهار |
تفضّل العروض المقاطع القصيرة |
كيف ينمو الخطأ مع الخطوات؟ هل توجد إعادة تخطيط؟ |
| فشل خارج التوزيع |
يتعطل مع الأجسام أو الإضاءة أو نطاقات الأفعال الجديدة |
تبدو النتائج داخل التوزيع قوية |
هل يوجد بروتوكول OOD؟ وهل أنماط الفشل معلنة؟ |
| تقييم صارم |
لا توجد درجة مشتركة لـ «فهم العالم» |
يمتص نجاح المهمة المقياس |
إلى جانب درجة المهمة، هل يُبلّغ عن خطأ التنبؤ؟ |
| الحد الفاصل مع المحاكيات المكتوبة يدويًا |
تُعامل النماذج المتعلَّمة كمحركات موثقة |
يدمج التسويق بين المحاكي / نموذج العالم |
ما القيود المبرمجة مسبقًا؟ وما الذي ليس سوى ملاءمات؟ |
يُعد الانتقال إلى الواقع صعبًا بسبب فجوة المحاكاة إلى الواقع. ينبغي أن تسأل الاختبارات الجيدة عما إذا كان النموذج يتنبأ بنتائج قابلة للتحكم تحت تأثير الأفعال، لا بمجرد صور معقولة.
استخدم الجدول كقائمة تحقق للادعاءات: أكّد وجود واجهة مشروطة بالفعل، ثم اطلب أدلة على المدى الطويل وخارج التوزيع، وافصل أخيرًا بين «يبدو جيدًا» و«الديناميكيات قابلة للتخطيط». من دون هذه الأدلة، تكون الصياغة الأكثر أمانًا هي «يتضمن مكونات نموذج العالم أو أهدافًا بحثية»، لا «يمتلك نموذج عالم كاملًا». ولأن الوكلاء يملكون قدرة محدودة، ينبغي أن يركز التقييم على الحالة ذات الصلة بالهدف بدلًا من إعادة إنتاج المشهد بأكمله.
الملخص
تنقل نماذج العالم الذكاء الاصطناعي من «يستطيع التحدث / يستطيع الرسم» إلى «يستطيع توقّع عواقب الأفعال»، مثل التنبؤ بأن روبوتًا سيسقط كوبًا إذا اتخذ المسار الخطأ. جوهر العمل هو حلقة مغلقة من الحالة والفعل والتنبؤ، ويُعد التنبؤ المشروط بالفعل أوضح محور لاتخاذ القرار.
تخدم المسارات الثلاثة، وهي MBRL/التدريب بالتخيل، والمحاكاة التفاعلية التوليدية، والتمثيلات التنبؤية بأسلوب JEPA، أهدافًا مختلفة وليست قابلة للاستبدال. وبالمقارنة مع LLMs ومولدات الفيديو، قارن أهداف التنبؤ وواجهات الأفعال؛ وعند التقييم، أعطِ الأولوية للفيزياء الزائفة والانحراف وفشل OOD والمقاييس الصارمة وحدود المحاكيات.
الأسئلة الشائعة
ما نموذج العالم؟
نموذج العالم هو نموذج ديناميكيات داخلية متعلَّم يمثل كيفية تغير البيئة بالنظر إلى حالة حالية، أو ملاحظة، وفعل. العالم في أي لحظة أغنى مما يمكن للوكيل رصده مباشرة، لذلك يلخص النموذج المتغيرات المهمة للتخطيط، مثل موقع الروبوت بعد الانعطاف إلى اليسار. الغرض منه دعم التخطيط والتجربة والخطأ في التخيل، وليس فقط توليد النص أو مظهر الفيديو.
كيف يختلف نموذج العالم عن نموذج اللغة الكبير؟
تتنبأ نماذج اللغة الكبيرة أساسًا بالرمز التالي وتتفوّق في اللغة وتنسيق المعرفة؛ بينما تتنبأ نماذج العالم أساسًا بكيفية تطور الحالة بعد الأفعال للتحكم والتخطيط. يمكن لـ LLM مناقشة الفيزياء من دون توفير ديناميكيات بيئية قابلة للتمديد والتقييم.
كيف يعمل نموذج العالم؟
ترمز الحلقة النموذجية الملاحظات في حالة، وتشترطها بفعل مرشح، وتتنبأ بالحالة التالية بعد ذلك الفعل، وقد تتقدم في الفضاء الكامن. يقارن المخطط عمليات التمديد المتخيلة، وينفذ فعلًا، ثم يحدّث الحالة من ملاحظة جديدة.
هل يُعد Sora أو توليد الفيديو نموذج عالم؟
ليس تلقائيًا. إذا كان النظام ينتج أساسًا فيديو متماسك المظهر من دون واجهة مستقرة مشروطة بالفعل، وانتقالات حالة قابلة للتحقق، واستخدام للتخطيط، فمن الأفضل وصفه بأنه مولد فيديو. ويصبح أقرب إلى نموذج عالم فقط عند إثبات التنبؤ المشروط بالفعل وحلقة قابلة للتخطيط.
كيف يختلف نموذج العالم عن المحاكي التقليدي؟
تشفّر المحاكيات التقليدية عادةً قواعد وقيود فيزيائية مكتوبة يدويًا، بينما تتعلم نماذج العالم المعتمدة على البيانات غالبًا باستخدام الشبكات العصبية. يمكن أن تكون النماذج المتعلَّمة أكثر مرونة وأقرب إلى ضوضاء المستشعرات، لكنها أيضًا أكثر عرضة للفيزياء الزائفة والانحراف طويل الأمد، ولا ينبغي افتراض أنها تعادل محرك فيزياء موثقًا.