مع توسّع الذكاء الاصطناعي التوليدي من تدريب النماذج إلى التطبيقات التجارية واسعة النطاق، يتغير أيضًا محور المنافسة في سوق الحوسبة للذكاء الاصطناعي. لا تحتاج الشركات إلى تدريب نماذج أكثر قوة فحسب، بل تحتاج أيضًا إلى معالجة طلبات المستخدمين بصورة مستمرة وبكلفة يمكن التحكم بها، وتشغيل وكلاء الذكاء الاصطناعي، وإنشاء الصوت، وتقديم خدمات تفاعلية في الوقت الفعلي. وفي هذا السياق، حظيت بنية تسريع الاستدلال المتخصصة التي تمثلها Groq باهتمام متزايد. تستعرض هذه المقالة موقع Groq كشركة، وتقنية LPU، ونموذج أعمال GroqCloud، والمنافسة في القطاع، لتحليل دورها في البنية التحتية لاستدلال الذكاء الاصطناعي، إلى جانب التحديات التقنية والتجارية التي تواجه نهج الشرائح المتخصصة.
النقاط الرئيسية
- Groq هي شركة لتقنيات الحوسبة تركز على استدلال الذكاء الاصطناعي. وتشمل تقنياتها الأساسية شرائح LPU والمترجمات والبنية التحتية الداعمة للاستدلال.
- يتطلب تدريب الذكاء الاصطناعي واستدلاله متطلبات حوسبة مختلفة. ويولي الاستدلال في الوقت الفعلي أهمية خاصة لزمن أول رمز، وسرعة التوليد، واستقرار الخدمة.
- تعمل وحدات LPU من Groq على تحسين أعباء عمل معينة لاستدلال الذكاء الاصطناعي من خلال SRAM داخل الشريحة، والتنفيذ الحتمي، والتصميم المشترك للأجهزة والبرمجيات.
- تحوّل GroqCloud قدرات الحوسبة الأساسية إلى واجهات API سحابية، ما يتيح للمطورين استدعاء نماذج الذكاء الاصطناعي المدعومة.
- تختلف وحدات LPU ووحدات GPU في البنية وسيناريوهات الاستخدام المناسبة. ولا يمكن تقييم الأداء الإجمالي بالاعتماد فقط على سرعة توليد رمز واحد.
- تعتمد القدرة التنافسية التجارية طويلة الأجل لـ Groq على قابلية توسيع الشرائح، ومنظومتها البرمجية، وتكاليف الاستدلال، وطلب العملاء، والعائد على الاستثمار في البنية التحتية.
ما هي Groq؟ وما دورها في سلسلة قيمة حوسبة الذكاء الاصطناعي؟
Groq هي شركة تقنية تركز على حوسبة استدلال الذكاء الاصطناعي. تأسست عام 2016 على يد Jonathan Ross، الذي شارك سابقًا في مشروع Google TPU. وتطوّر الشركة بصورة أساسية شرائح تسريع متخصصة للذكاء الاصطناعي، ومترجمات، وأنظمة حوسبة للاستدلال، كما توفر قدرات استدلال النماذج للمطورين والشركات عبر خدمات مثل GroqCloud.
من المهم الإشارة إلى أن Groq وGrok ليسا المنتج نفسه. فـ Groq اسم تقني مرتبط بالبنية التحتية لحوسبة الذكاء الاصطناعي، بينما Grok هو نموذج للذكاء الاصطناعي ومنتج مساعد طورته xAI. وعلى الرغم من تشابه الاسمين، فإنهما يتبعان شركتين مختلفتين ولهما مواقع تقنية ونماذج أعمال مختلفة.
ضمن سلسلة قيمة الذكاء الاصطناعي، تتموضع Groq بصورة أساسية في طبقة البنية التحتية للحوسبة. يتضمن تطبيق الذكاء الاصطناعي التوليدي المتكامل عادةً تطوير النماذج، وحوسبة التدريب، ونشر الاستدلال، وواجهات التطبيقات، وخدمات المستخدمين النهائيين. ولا يتمثل نشاط Groq الأساسي في تطوير نماذج محادثة عامة للمستهلكين، بل يهدف إلى توفير بيئات استدلال عالية الأداء لنماذج مختلفة.
فعلى سبيل المثال، عند بناء مساعد ذكاء اصطناعي في الوقت الفعلي، يمكن للمطورين اختيار نموذج مدرّب مسبقًا واستخدام خدمة استدلال لمعالجة مدخلات المستخدم. يفهم النموذج الأسئلة ويُنشئ المحتوى، بينما تحدد منصة الحوسبة الأساسية مدى سرعة تشغيل النموذج وكمية موارد الحوسبة التي يستهلكها كل طلب.
ويُعد تحسين عملية الحوسبة هذه جوهر القيمة التي تقدمها Groq. فمن خلال معالجات وأنظمة برمجية مصممة خصيصًا، تقلل Groq النفقات التنفيذية لبعض مهام الاستدلال، ما يتيح للنماذج توليد الاستجابات بسرعة أكبر.
ويعني هذا التموضع أن فرصة Groq في السوق لا تعتمد فقط على مدى انتشار نموذج معين للذكاء الاصطناعي، بل تعتمد أيضًا على طلب الاستدلال في قطاع الذكاء الاصطناعي التوليدي، وبنى النماذج، والتغيرات في تكاليف الحوسبة.
لماذا يولي قطاع الذكاء الاصطناعي اهتمامًا أكبر بحوسبة الاستدلال؟
يمكن تقسيم حوسبة الذكاء الاصطناعي عمومًا إلى مرحلتين: التدريب والاستدلال. يتضمن التدريب استخدام كميات كبيرة من البيانات لضبط معلمات النموذج كي يكتسب قدرات مثل فهم اللغة والتعرف على الصور. أما الاستدلال، فيشير إلى تلقي نموذج مدرّب لمدخلات جديدة وتوليد مخرجات استنادًا إلى معلماته الحالية.
تتطلب المرحلتان موارد حوسبة، لكن أعباء العمل فيهما تختلف اختلافًا كبيرًا. ينطوي تدريب النماذج عادةً على معالجة مجموعات بيانات كبيرة، وحساب التدرجات، وتحديث المعلمات. وهو يركز على الحوسبة المتوازية واسعة النطاق، وسعة الذاكرة، والتنسيق بين أجهزة متعددة. أما الاستدلال، فيحتاج إلى توليد النتائج بسرعة استجابة لطلبات المستخدمين. وهذا مهم بصورة خاصة في تطبيقات المحادثة والصوت والأتمتة، حيث تؤثر أوقات الاستجابة مباشرة في تجربة المستخدم.
بالنسبة إلى نماذج اللغة الكبيرة، تتضمن عملية الاستدلال عمومًا مرحلتين: Prefill وDecode. تعالج Prefill موجّه الإدخال وتنشئ الحالة الحسابية ذات الصلة، بينما تنشئ Decode الرموز اللاحقة واحدًا تلو الآخر. ونظرًا إلى أن نماذج اللغة ذاتية الانحدار تحتاج عادةً إلى توقع الرمز التالي استنادًا إلى المحتوى المُنشأ مسبقًا، فإن عملية التوليد المستمرة تفرض متطلبات كبيرة على كفاءة الوصول إلى الذاكرة وجداول الحوسبة.
قد يتقبل مستخدمو تطبيقات المحادثة العادية انتظارًا قصيرًا. لكن في المساعدات الصوتية الفورية، وخدمات العملاء الآلية، وسيناريوهات الذكاء الاصطناعي التفاعلية، يمكن أن يؤثر تأخر الاستجابة مباشرة في مدى طبيعية المحادثة. وإذا استغرق النموذج وقتًا طويلًا لتوليد الجزء الأول من الاستجابة، أو كانت سرعة مخرجاته غير كافية للتواصل الفوري، فقد يواجه صعوبة في تلبية متطلبات الأعمال العملية حتى لو كان النموذج نفسه عالي القدرة.
كما أدى تطور وكلاء الذكاء الاصطناعي إلى زيادة الطلب على الاستدلال. فعلى عكس التفاعلات القائمة على سؤال وجواب لمرة واحدة، قد يحتاج وكيل الذكاء الاصطناعي إلى استدعاء نماذج متعددة، وتحليل بيانات خارجية، وتنفيذ عمليات أدوات، والتحقق من النتائج. وقد تؤدي مهمة مستخدم واحدة إلى جولات متعددة من الاستدلال الداخلي وطلبات API متعددة، مما يزيد إجمالي استهلاك الحوسبة.
ونتيجة لذلك، لم تعد المنافسة في البنية التحتية للذكاء الاصطناعي تقتصر على السعي إلى قدرات أكبر لتدريب النماذج، بل تركز أيضًا على تقديم خدمات استدلال بزمن استجابة أقل، وإنتاجية أعلى، وتكاليف أكثر ملاءمة.
ومع ذلك، فإن نمو الطلب على الاستدلال لا يعني أن حوسبة التدريب أصبحت أقل أهمية. فقد يستمر نمو تدريب النماذج الجديدة، والضبط الدقيق للنماذج، وتقديم خدمات الاستدلال في الوقت نفسه. والاختلاف هو أن متطلبات الأجهزة لمهام الحوسبة المختلفة أصبحت أكثر تخصصًا.
ما الخصائص الرئيسية لنهج تقنية LPU لدى Groq؟
تمثل LPU المصطلح التقني الذي تستخدمه Groq لوصف معالجها المتخصص للاستدلال. وبالمقارنة مع وحدات GPU للأغراض العامة المصممة لمجموعة واسعة من مهام الحوسبة، يركز تصميم LPU بدرجة أكبر على الحوسبة وحركة البيانات والتحكم في زمن الاستجابة لأعباء عمل محددة للذكاء الاصطناعي.
يمكن فهم تقنية LPU لدى Groq من خلال ثلاثة جوانب: الذاكرة داخل الشريحة، والتنفيذ الحتمي، والمترجمات.
كيف تؤثر SRAM داخل الشريحة في كفاءة الوصول إلى البيانات؟
لا تقتصر قيود حوسبة الذكاء الاصطناعي الحديثة على القدرات الحسابية للشريحة، بل تشمل أيضًا سرعة الوصول إلى البيانات ونقلها. أثناء استدلال نماذج اللغة الكبيرة، يجب على وحدات الحوسبة الوصول باستمرار إلى أوزان النموذج والبيانات الوسيطة. وإذا لم تصل البيانات في الوقت المناسب، فقد لا يتمكن المعالج من الاستفادة الكاملة من موارده حتى لو كانت لديه قدرة حوسبة نظرية مرتفعة.
من الخصائص المهمة لوحدات LPU لدى Groq تركيزها على SRAM داخل الشريحة، أو ذاكرة الوصول العشوائي الساكنة. وتوفر SRAM عمومًا زمن وصول أقل، ويمكنها مساعدة المعالجات على قراءة البيانات المطلوبة بسرعة. وبالمقارنة مع التصاميم التي تعتمد على ذاكرة خارجية ذات نطاق ترددي عالٍ وسعة أكبر، تحاول هذه البنية تقليل نفقات الوصول إلى البيانات لبعض مهام الحوسبة.
لكن SRAM لها أيضًا قيود في التكلفة والسعة. فعند استخدام المساحة نفسها من الشريحة، لا تستطيع SRAM عمومًا توفير نطاق التخزين نفسه الذي توفره الذاكرة الخارجية عالية السعة. لذلك، قد يتطلب نشر نماذج ذات أعداد أكبر من المعلمات تنسيقًا بين شرائح متعددة، وتقسيمًا للنموذج، وتحسينًا على مستوى النظام لتلبية متطلبات السعة.
وهذا يعني أن SRAM داخل الشريحة ليست متفوقة بطبيعتها على كل بنية ذاكرة أخرى. إذ تعتمد قيمتها على النموذج وعبء العمل المحددين، وعلى قدرة نظام الحوسبة على تنسيق تخزين البيانات ونقلها بفعالية.
لماذا يعد التنفيذ الحتمي مهمًا؟
يُعد التنفيذ الحتمي عنصرًا رئيسيًا آخر في تصميم Groq. في ظل هذا النهج المعماري، يمكن للمترجم تخطيط عدد كبير من عمليات الحوسبة وعمليات نقل البيانات مسبقًا، ما يسمح للمعالج بالعمل وفق جدول تنفيذ محدد مسبقًا.
تحتاج وحدات GPU التقليدية عمومًا إلى دعم مجموعة متنوعة من مهام الحوسبة والجدولة الديناميكية وبيئات البرمجيات المعقدة، ما يمنحها مرونة كبيرة. في المقابل، تحاول Groq تقليل بعض أوجه عدم اليقين المرتبطة بالجدولة أثناء التشغيل وتنسيق الموارد من خلال خطط تنفيذ أكثر وضوحًا.
بالنسبة إلى الاستدلال منخفض زمن الاستجابة، فإن إمكانية التنبؤ بوقت التنفيذ لها قيمة عملية. فعندما تقدم الشركات خدمات ذكاء اصطناعي فورية، فإنها لا تهتم فقط بمتوسط سرعة الاستجابة، بل أيضًا بتفاوت زمن الاستجابة بين الطلبات المختلفة. وإذا شهدت الخدمة أحيانًا تأخيرات كبيرة في الاستجابة، فقد تتأثر تجربة المستخدم حتى لو كان متوسط الأداء مرتفعًا.
ولا يعني التنفيذ الحتمي أن كل طلب سيحظى بزمن استجابة متطابق تمامًا. فقد يتأثر زمن الاستجابة الفعلي بعوامل مثل طول الإدخال، وطول المخرجات، واستراتيجيات التجميع، وحمل النظام، وظروف الشبكة.
كيف يسهم المترجم في تحسين أداء LPU؟
لا يعتمد نهج Groq التقني على الأجهزة وحدها لتحسين الأداء، بل يؤكد على التصميم المشترك للأجهزة والبرمجيات. ويحتاج المترجم إلى تحليل الرسم البياني الحسابي للنموذج وتعيين العمليات ذات الصلة لموارد الحوسبة والتخزين في الشريحة.
وفي هذه العملية، لا تقتصر مسؤولية المترجم على تحويل النموذج إلى تعليمات قابلة للتنفيذ، بل تشمل أيضًا ترتيب عمليات نقل البيانات وتسلسلات الحوسبة واستخدام الموارد بحيث تعمل وحدات الحوسبة المختلفة معًا وفق خطة محددة مسبقًا.
يتيح هذا التصميم تحسينًا عميقًا للنماذج المدعومة، لكنه يفرض أيضًا متطلبات كبيرة على سلسلة الأدوات البرمجية. وعندما تتغير بنى النماذج أو أنواع العمليات أو متطلبات الاستدلال، تحتاج المنصة إلى تحسين مترجمها وبيئة التشغيل الخاصة بها باستمرار.
لذلك، لا تأتي القدرة التنافسية التقنية لـ Groq من شريحة LPU نفسها فقط، بل أيضًا من مترجمها، وقدراتها على تكييف النماذج، وكفاءة التنسيق في نظام الاستدلال الكامل لديها.
كيف تحوّل GroqCloud حوسبة LPU إلى خدمة تجارية؟
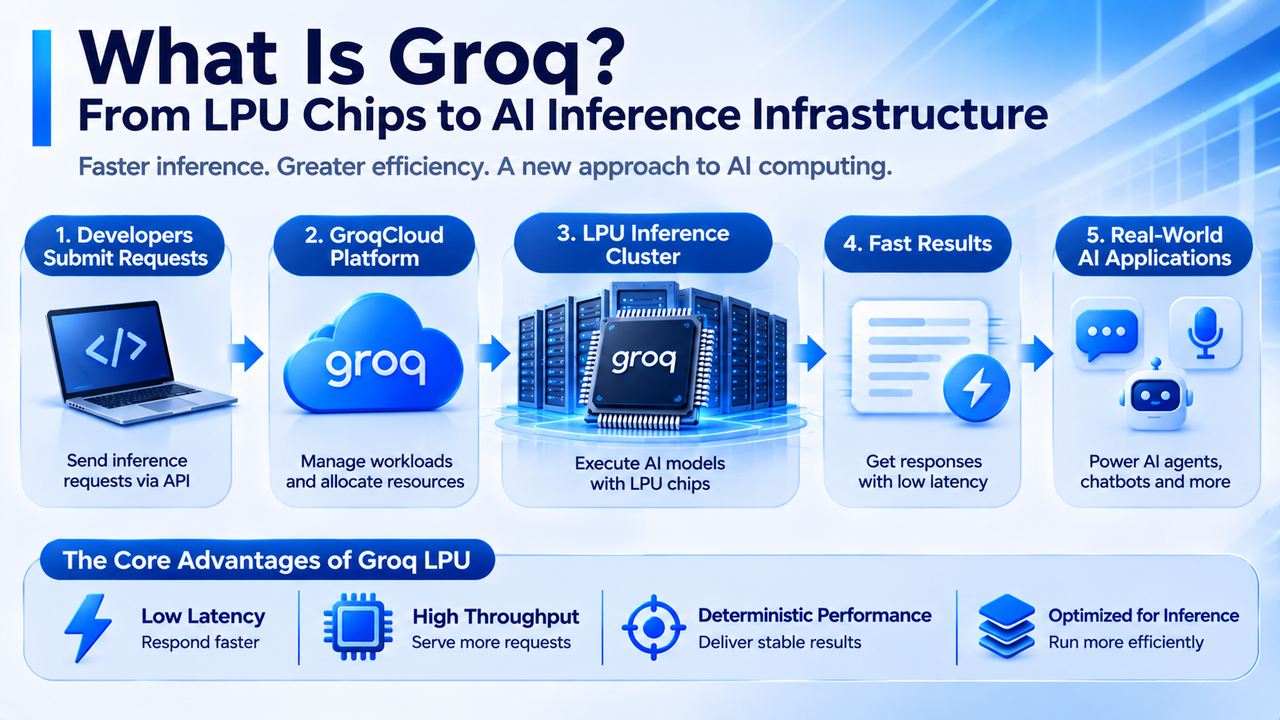
GroqCloud هي خدمة Groq السحابية لاستدلال الذكاء الاصطناعي والموجهة إلى المطورين والشركات. فهي تدمج الشرائح الأساسية وعناقيد الحوسبة وبيئات تشغيل النماذج في خدمات يمكن الوصول إليها عبر واجهات API. ويسمح ذلك للعملاء باستخدام البنية التحتية للاستدلال لدى Groq دون شراء الشرائح المتخصصة ونشرها بأنفسهم.
في تطبيق نموذجي، يختار المطورون أولًا نموذجًا تدعمه المنصة ثم يرسلون نصًا أو أنواعًا أخرى من المدخلات عبر API. تستقبل GroqCloud الطلب، وتخصص مهمة الحوسبة ذات الصلة لنظام الاستدلال الأساسي، ثم تعيد النتيجة المُنشأة إلى التطبيق. وتتضمن هذه العملية جدولة الطلبات، وتنفيذ النموذج، وإدارة الموارد، ونقل النتائج.
بالنسبة إلى عملاء الشركات، تتمثل القيمة الأساسية لاستخدام خدمة استدلال سحابية في خفض العائق أمام نشر البنية التحتية. إذ يتطلب بناء عنقود حوسبة للذكاء الاصطناعي بصورة مستقلة عادةً شراء الأجهزة، وتهيئة الشبكات، ونشر النماذج، وصيانة بيئة التشغيل. ويحوّل استخدام خدمة استدلال عبر API جزءًا من الاستثمار الثابت في البنية التحتية إلى إنفاق على الخدمات يتغير بحسب استخدام الأعمال.
كما تتوسع منصة Groq من API استدلال واحدة نحو خدمات بنية تحتية أكثر شمولًا للشركات. وتشمل محفظة منتجاتها بنية تحتية متخصصة للحوسبة، وحزمة برمجيات للاستدلال، وقدرات حوكمة وتحكم على مستوى المؤسسات، لتلبية متطلبات العملاء المختلفة في الأداء وطرق النشر وصلاحيات الإدارة.
لكن القيمة التجارية لخدمة الاستدلال السحابية لا تعتمد بالكامل على سرعة الشريحة. إذ يجب على الشركات أيضًا مراعاة دعم النماذج، واستقرار API، وتوافر الخدمة، وأمن البيانات، وتكاليف كل طلب. وإذا كانت المنصة تدعم نطاقًا محدودًا فقط من النماذج أو المشغلات، فقد لا تلبي جميع متطلبات تطبيقات الشركات حتى لو قدمت زمن استجابة منخفضًا لمهام محددة.
ومن حيث نماذج الإيرادات، يمكن لخدمات الاستدلال السحابية عادةً فرض رسوم بناءً على استخدام النموذج، أو عدد الرموز المعالجة، أو سعة الحوسبة المحجوزة. وتخلق طرق التسعير المختلفة متطلبات مختلفة لإدارة الموارد. فالفوترة القائمة على الاستخدام تعتمد بدرجة أكبر على الحجم الفعلي للطلبات، بينما تتطلب خدمات السعة المحجوزة الاهتمام بعقود العملاء، وتسليم الموارد، ومعدل استخدام المعدات.
لذلك، تعتمد قدرة GroqCloud على تسويق تقنيتها في النهاية على قدرتها على تحويل مزايا الأداء الأساسية لوحدات LPU إلى خدمات استدلال مستقرة وقابلة للتوسع وقادرة على المنافسة من حيث التكلفة.
كيف تغير شراكة Groq مع NVIDIA موقعها في القطاع؟
تُعد علاقة Groq مع NVIDIA خلفية مهمة لفهم موقعها الحالي في القطاع.
في ديسمبر 2025، أبرمت Groq وNVIDIA اتفاقية ترخيص غير حصرية لتقنية استدلال الذكاء الاصطناعي. ووفقًا لإفصاحات الطرفين، حصلت NVIDIA على ترخيص لتقنية الاستدلال ذات الصلة لدى Groq، بينما انضم مؤسس Groq، Jonathan Ross، والرئيس آنذاك Sunny Madra، وبعض أعضاء الفريق إلى NVIDIA. واستمرت Groq في العمل كشركة مستقلة تحت قيادة الرئيس التنفيذي Simon Edwards، وظل نشاط GroqCloud قائمًا.
وتعني هذه الصفقة أن القيمة التقنية لـ Groq لا تنعكس فقط في البيع المستقل لخدمات الاستدلال، بل أيضًا في دخولها إلى منظومة حوسبة الذكاء الاصطناعي الأوسع من خلال ترخيص التقنية.
وفي مارس 2026، قدمت NVIDIA كذلك بنية تسريع الاستدلال Groq 3 LPX ودمجتها مع منصة Vera Rubin. ويحاول الحل المرتبط بذلك توزيع أعباء العمل بين وحدات GPU ووحدات LPU استنادًا إلى خصائص الحوسبة للمراحل المختلفة من استدلال الذكاء الاصطناعي، بهدف تحسين كفاءة الاستدلال منخفض زمن الاستجابة. ويعكس هذا التطور التعقيد المتزايد للمنافسة في سوق شرائح الذكاء الاصطناعي. ففي السابق، كان يُنظر غالبًا إلى شرائح الاستدلال المتخصصة على أنها بدائل محتملة لوحدات GPU. أما في بُنى الحوسبة غير المتجانسة، فيمكن لأنواع مختلفة من المعالجات أيضًا أن تؤدي مهام متكاملة.
فعلى سبيل المثال، يمكن لوحدات GPU معالجة الحوسبة المتوازية واسعة النطاق وبعض عمليات الانتباه المناسبة لبنيتها، بينما يمكن لوحدات LPU معالجة مهام الحوسبة الأكثر حساسية لوقت التنفيذ وزمن تأخر نقل البيانات. ومن خلال الجدولة على مستوى النظام، قد يعمل النوعان من المعالجات معًا على عبء عمل الاستدلال نفسه.
لكن البُنى غير المتجانسة تضيف أيضًا تعقيدًا هندسيًا إضافيًا. إذ تحتاج الأنظمة إلى تنسيق نقل البيانات، وتخصيص المهام، وإدارة الذاكرة عبر أجهزة مختلفة. وإذا كانت نفقات الاتصال بين الأجهزة مرتفعة جدًا، فقد لا تتحول المزايا النظرية للأجهزة بالكامل إلى أداء عملي.
وفي أغسطس 2026، أعلنت Groq أيضًا انضمامها إلى برنامج NVIDIA Cloud Partner، ما عزز موقعها كمشغل للبنية التحتية السحابية للذكاء الاصطناعي. لذلك، لم يعد من الممكن وصف Groq ببساطة بأنها شركة شرائح مستقلة تمامًا عن منظومة NVIDIA وتركز فقط على منافسة وحدات GPU. إذ يشمل نشاطها الحالي خدمات استدلال سحابية مستقلة، وتقنية شرائح متخصصة، وتعاونًا في البنية التحتية مع NVIDIA.
كيف يتكيف نموذج أعمال Groq مع نمو سوق استدلال الذكاء الاصطناعي؟
يأتي الطلب التجاري في سوق استدلال الذكاء الاصطناعي بصورة أساسية من تطبيقات الشركات، وخدمات المطورين، ومنتجات الذكاء الاصطناعي التي تعمل باستمرار. وعلى عكس تدريب النماذج، الذي يكون عمومًا قائمًا على المشروعات ويحدث على مراحل، تحتاج خدمات الاستدلال إلى توفير قدرة حوسبة بصورة مستمرة مع تغير حركة المستخدمين. ولذلك، فإنها تركز بدرجة أكبر على استخدام الموارد، وتكاليف الوحدة، واستقرار الخدمة.
يمكن فهم نموذج أعمال Groq على ثلاثة مستويات.
-
إنشاء البنية التحتية للاستدلال. تحتاج Groq إلى بناء قدرة حوسبة قابلة للاستخدام من خلال الشرائح والخوادم والشبكات ومراكز البيانات. ولا يمكن لهذه الأصول دعم طلبات العملاء وتحقيق الإيرادات إلا بعد اكتمال نشر المعدات وتكييف النماذج وإطلاق الخدمة.
-
خدمات الاستدلال السحابية. تحوّل GroqCloud قدرة الحوسبة إلى واجهات API يمكن للمطورين استدعاؤها، دون مطالبة العملاء بإدارة الشرائح الأساسية مباشرة. وبالنسبة إلى مزود الخدمة، يعتمد نمو الإيرادات على عدد العملاء، وحجم الطلبات، وتسعير الخدمات، والاحتفاظ بالعملاء.
-
خدمات البنية التحتية للشركات. قد تتطلب بعض الشركات موارد حوسبة مخصصة، أو أساليب نشر محددة، أو متطلبات حوكمة أكثر صرامة. وقد تخلق هذه الاحتياجات علاقات عملاء أكثر استقرارًا على المدى الطويل، لكنها تتطلب أيضًا استثمارًا أكبر في الهندسة والعمليات ودعم العملاء.
في يونيو 2026، أعلنت Groq أنها حصلت على تمويل نمو بقيمة $650 مليون لتوسيع أعمالها العالمية في الحوسبة السحابية لاستدلال الذكاء الاصطناعي، مع هدف الوصول إلى قدرة بنية تحتية تقارب 200 MW بحلول عام 2027. وفي ذلك الوقت، أفصحت الشركة عن تشغيلها 13 مركز بيانات في مناطق متعددة، وخدمتها أكثر من 5 ملايين مطور، ومعالجتها عشرات التريليونات من رموز الذكاء الاصطناعي كل أسبوع.
يمكن استخدام هذه الأرقام لمتابعة وتيرة توسع الأعمال، لكنها لا تثبت الربحية بصورة مباشرة. إذ يعكس عدد المطورين وحجم الرموز وعدد مراكز البيانات مدى الوصول إلى المستخدمين، ونشاط الخدمة، وحجم البنية التحتية على التوالي. لكنها لا تعادل الإيرادات الفعلية أو الأرباح أو التدفق النقدي الحر.
فعلى سبيل المثال، لنفترض أن عدد الرموز التي تعالجها منصة استدلال كل شهر يرتفع بنسبة %100، لكن سعر الرمز ينخفض بنسبة %40 بسبب المنافسة في السوق. في هذه الحالة، قد يكون نمو إيراداتها أقل من نمو استخدامها. وإذا زادت تكاليف بناء البنية التحتية وتشغيلها أيضًا خلال الفترة نفسها، فقد تتأثر هوامش الربح أكثر.
لذلك، يتطلب تحليل إمكانات Groq التجارية النظر في الوقت نفسه إلى نمو الطلب على الاستدلال، وتسعير الخدمات، واستخدام المعدات، والنفقات الرأسمالية. ولا يمكن تقييم القيمة السوقية بالاعتماد فقط على سرعة تنفيذ النموذج.
ما التحديات التقنية وتحديات التوسع التي تواجهها Groq؟
رغم إمكانية تحسين شرائح الاستدلال المتخصصة لأعباء عمل محددة، لا تزال Groq تواجه تحديات ناشئة عن تغيرات النماذج، وتوسيع الأجهزة، والمنافسة في السوق.
تكييف النماذج. تستمر بُنى نماذج الذكاء الاصطناعي في التطور بسرعة. وقد تستخدم النماذج المختلفة آليات انتباه ومقاييس للمعلمات ودقة حوسبة واستراتيجيات استدلال مختلفة. وإذا كان على معالج متخصص دعم مزيد من النماذج، فيجب تحديث مترجمه وبيئة تشغيله وأدواته البرمجية المرتبطة باستمرار.
ويعني ذلك أيضًا أن ميزة الأداء التي يحققها جيل واحد من الشرائح على نموذج محدد قد لا تنتقل مباشرة إلى كل نموذج جديد. ومع تطور الاستدلال بالسياق الطويل، ونماذج مزيج الخبراء، والحوسبة متعددة الوسائط، تحتاج أنظمة الحوسبة الأساسية إلى التكيف باستمرار مع أعباء عمل جديدة.
التوسع متعدد الشرائح. تركز وحدات LPU لدى Groq على SRAM داخل الشريحة والتنفيذ الحتمي، لكن النماذج الكبيرة غالبًا ما تتطلب موارد تخزين وحوسبة تتجاوز قدرة شريحة واحدة. وعندما يُوزع نموذج على شرائح متعددة، يحتاج النظام إلى تنسيق نقل البيانات وتسلسلات الحوسبة بين الأجهزة.
وإذا كان الاتصال متعدد الشرائح غير فعال، فقد تتراجع ميزة زمن الاستجابة المنخفض لشريحة واحدة. ولذلك، تعد وصلات الشرائح البينية، والنطاق الترددي للنظام، وقدرات جدولة المترجم عوامل مهمة في تحديد ما إذا كانت بنية استدلال متخصصة قادرة على التوسع.
تكاليف إنشاء البنية التحتية. حتى إذا وفرت الشرائح كفاءة حوسبة مرتفعة، فإن بناء مركز بيانات للذكاء الاصطناعي لا يزال يتطلب توصيلات طاقة ومساحة للمرافق وأنظمة تبريد وبنية تحتية للشبكات. ومع توسع خدمات الاستدلال لديها، ستحتاج Groq أيضًا إلى تحمل التكاليف الرأسمالية والتشغيلية المقابلة.
المنافسة في السوق. تتنافس وحدات GPU من NVIDIA، ووحدات GPU من AMD، ووحدات TPU من Google، وغيرها من مسرعات الذكاء الاصطناعي المتخصصة على طلب حوسبة الاستدلال. وقد تتمتع المنصات المختلفة بمزايا في توافق النماذج، والإنتاجية، وزمن الاستجابة، والتكلفة، والمنظومات البرمجية.
وبالنسبة إلى عملاء الشركات، لا يتحدد الاختيار النهائي عادةً بمقياس أداء واحد. بل يعتمد على إجمالي تكاليف الخدمة، وتوافق التطبيقات، والموثوقية التشغيلية طويلة الأجل. لذلك، فإن قدرة نهج Groq التقني على بناء تنافسية مستدامة لا تعتمد فقط على بنية LPU نفسها، بل أيضًا على قدرة الشركة على الاستمرار في توسيع الدعم البرمجي، وتحسين استخدام موارد الحوسبة، والتحكم في تكلفة توسيع البنية التحتية.
ماذا تعني Groq لشرائح الذكاء الاصطناعي وقطاع الحوسبة؟
يعكس النهج التقني الذي تمثله Groq تحول قطاع حوسبة الذكاء الاصطناعي تدريجيًا من البنى التي تركز على المسرعات للأغراض العامة نحو أنظمة حوسبة غير متجانسة محسنة لأعباء عمل مختلفة. ففي المراحل المبكرة من تطور الذكاء الاصطناعي التوليدي، كانت قدرات التدريب محركًا مهمًا لتقدم القطاع. ومع دخول مزيد من النماذج إلى التطبيقات العملية، بدأت خدمات الاستدلال في خلق طلب مستمر على الحوسبة، ما يزيد متطلبات الشركات لزمن الاستجابة المنخفض وكفاءة التكلفة واستقرار الخدمة.
وهذا يتيح مجالًا لتطور شرائح الاستدلال المتخصصة. فمن خلال تحسين الأجهزة والبرمجيات لعمليات حوسبة محددة، قد تحقق البُنى المتخصصة مزايا في الأداء أو التكلفة في مهام معينة.
لكن هذا لا يعني أن وحدات GPU ستُستبدل بالكامل بشرائح استدلال متخصصة. إذ تتمتع وحدات GPU بمنظومات برمجية واسعة، ودعم شامل للنماذج، وقدرات حوسبة للأغراض العامة، ما يسمح لها بالتكيف مع أعباء عمل متنوعة للتدريب والاستدلال. وقد تلعب المسرعات المتخصصة بدلًا من ذلك دورًا في نماذج محددة أو مراحل حوسبة معينة أو سيناريوهات منخفضة زمن الاستجابة.
ويشير التعاون التقني بين NVIDIA وGroq كذلك إلى أن مراكز بيانات الذكاء الاصطناعي المستقبلية قد تنشر أنواعًا مختلفة من أجهزة الحوسبة في الوقت نفسه وتنسق بينها عبر أنظمة جدولة برمجية. وقد يحسن هذا النهج استخدام موارد الحوسبة، لكنه سيزيد أيضًا من تعقيد تصميم النظام وإدارته.
وبالنسبة إلى قطاع البنية التحتية للذكاء الاصطناعي، قد يتوسع محور المنافسة تدريجيًا من الأداء النظري للشرائح الفردية إلى القدرة على تقديم أنظمة حوسبة متكاملة. وقد يؤثر أداء الشرائح، والنطاق الترددي للذاكرة، ووصلات الأجهزة البينية، والمترجمات، وكفاءة الطاقة، وعمليات الخدمات السحابية جميعها في العائد التجاري النهائي.
كما يوضح تطور Groq أن البنية التحتية لاستدلال الذكاء الاصطناعي ليست مجرد مسألة تصنيع شرائح، بل هي قطاع متكامل يشمل بنية الأجهزة، وتحسين البرمجيات، وبناء مراكز البيانات، وتقديم الخدمات التجارية.
الخلاصة
Groq هي شركة تقنية تركز على حوسبة استدلال الذكاء الاصطناعي. تستخدم بنية LPU لديها عناصر تصميم مثل SRAM داخل الشريحة، والتنفيذ الحتمي، وجدولة المترجم لتحسين كفاءة التنفيذ لأعباء عمل محددة للذكاء الاصطناعي. وتحول GroqCloud قدرات الحوسبة الأساسية إلى خدمات استدلال سحابية، ما يتيح للمطورين والشركات استخدام البنية التحتية ذات الصلة عبر واجهات API.
ومع توسع تطبيقات الذكاء الاصطناعي إلى ما يتجاوز تدريب النماذج ليشمل التفاعل الفوري، ووكلاء الذكاء الاصطناعي، وخدمات الشركات العاملة باستمرار، تزداد أهمية زمن الاستدلال والإنتاجية والتكلفة كمقاييس تقنية. وتقدم بنية الاستدلال المتخصصة التي تمثلها Groq لقطاع حوسبة الذكاء الاصطناعي نهجًا بديلًا لوحدات GPU للأغراض العامة.
وفي الوقت نفسه، يُظهر ترخيص Groq لتقنيتها وتعاونها في البنية التحتية مع NVIDIA أن شرائح الاستدلال المتخصصة ووحدات GPU لا يلزم أن تكون في منافسة بحتة. وقد تعتمد مراكز بيانات الذكاء الاصطناعي مستقبلًا بصورة متزايدة بُنى حوسبة غير متجانسة، تتولى فيها المعالجات المختلفة المهام الملائمة لخصائص كل منها.
لكن المزايا التقنية للشرائح المتخصصة لا تتحول تلقائيًا إلى نجاح تجاري. فلا تزال Groq بحاجة إلى معالجة تكييف النماذج، والتوسع متعدد الشرائح، وتكاليف البنية التحتية، وربحية الخدمات السحابية. وسيعتمد تطورها على المدى الطويل على قدرتها على تحويل مزايا أداء الاستدلال إلى طلب مستقر من العملاء، وإيرادات مستدامة، وعوائد معقولة على رأس المال.
الأسئلة الشائعة
ما نوع الشركة التي تمثلها Groq؟
Groq هي شركة تقنية تركز على حوسبة استدلال الذكاء الاصطناعي. وتشمل مجالات أعمالها الرئيسية معالجات LPU المتخصصة، وأنظمة حوسبة الاستدلال، وخدمات الاستدلال السحابية GroqCloud.
هل Groq وGrok المنتج نفسه؟
لا. Groq هي شركة تقنية مرتبطة بالبنية التحتية لاستدلال الذكاء الاصطناعي، بينما Grok هو نموذج للذكاء الاصطناعي ومنتج مساعد طورته xAI.
ما هي LPU لدى Groq؟
LPU هي معالج متخصص لاستدلال الذكاء الاصطناعي صممته Groq. وهي تركز على SRAM داخل الشريحة، والتنفيذ الحتمي، وجدولة المترجم، والحوسبة منخفضة زمن الاستجابة.
كيف تختلف LPU لدى Groq عن GPU لدى NVIDIA؟
تركز وحدات LPU بدرجة أكبر على تحسين الحوسبة ونقل البيانات لمهام استدلال محددة، بينما توفر وحدات GPU قدرات أوسع للحوسبة المتوازية ومنظومات برمجية أوسع. ويعتمد الأداء الفعلي على النموذج، وحجم الدفعة، ومتطلبات زمن الاستجابة، وبيئة النشر.
هل استحوذت NVIDIA على Groq؟
حتى نوفمبر 2026، تواصل Groq العمل كشركة مستقلة. وأبرم الطرفان اتفاقية ترخيص تقني غير حصرية في ديسمبر 2025، وانضم بعض أعضاء فريق Groq إلى NVIDIA. ولا يعني ذلك أن NVIDIA أكملت استحواذًا شاملًا على Groq.
ما هي GroqCloud؟
GroqCloud هي خدمة Groq السحابية لاستدلال الذكاء الاصطناعي. وهي تتيح للمطورين استدعاء النماذج التي تدعمها المنصة عبر واجهات API دون شراء أجهزة الحوسبة الأساسية ونشرها بأنفسهم.
لماذا حظيت Groq بالاهتمام في سوق حوسبة الذكاء الاصطناعي؟
يحسن نهج Groq التقني زمن الاستجابة ونقل البيانات وكفاءة التنفيذ في استدلال الذكاء الاصطناعي. ويتماشى ذلك مع متطلبات كفاءة الحوسبة لتطبيقات الذكاء الاصطناعي الفورية، ووكلاء الذكاء الاصطناعي، وخدمات استدلال الشركات.
هل لدى Groq عملة مشفرة خاصة بها؟
Groq هي شركة للبنية التحتية لحوسبة الذكاء الاصطناعي. ولا تعتمد أعمال LPU وGroqCloud الخاصة بها على رمز عملة مشفرة أصلي. ولا ينبغي التعامل مباشرة مع الرموز الصادرة عن جهات خارجية ذات الأسماء المشابهة بوصفها أصولًا صادرة عن Groq أو معتمدة منها.