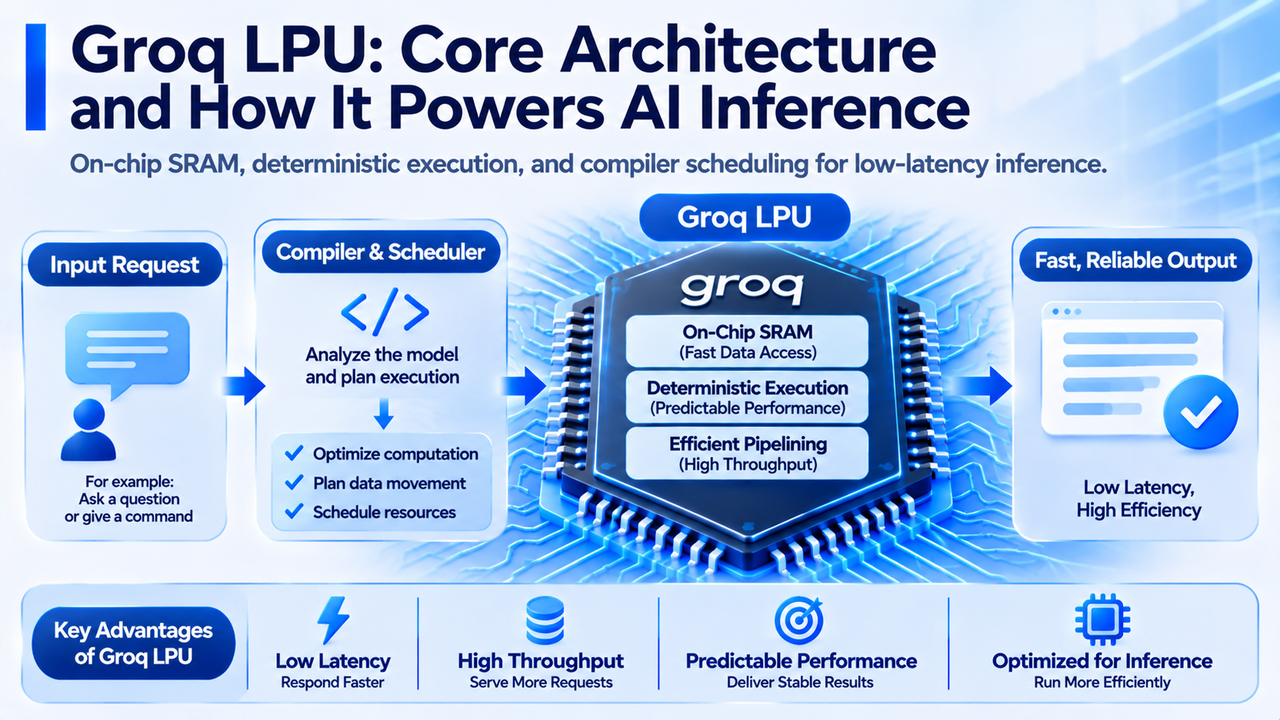
على عكس وحدات معالجة الرسومات (GPU)، المصممة لمجموعة واسعة من مهام الحوسبة المتوازية على نطاق كبير، تستخدم وحدات Groq LPU بنية تركّز على ذاكرة SRAM المدمجة في الشريحة، والجدولة الثابتة عبر المترجم، والتنفيذ الحتمي. يهدف هذا النهج إلى تقليل نقل البيانات وأعباء الجدولة أثناء التشغيل في وقت الاستدلال، بما يوفر قدرات حوسبة أكثر استهدافًا لتطبيقات الذكاء الاصطناعي في الوقت الفعلي.
مع الاستخدام المتزايد لنماذج اللغة الكبيرة في خدمة العملاء الذكية، والتفاعلات الصوتية، ووكلاء الذكاء الاصطناعي، وأتمتة المؤسسات، تتوسع متطلبات الاستدلال لتتجاوز مجرد تعظيم سرعة المعالجة، وتشمل زمن استجابة الردود واستقرار الخدمة وتكاليف الحوسبة لكل وحدة. يوفر نهج المسرّعات المخصصة الذي تمثله وحدات Groq LPU للبنية التحتية للذكاء الاصطناعي خيارًا تقنيًا مختلفًا عن بنى الحوسبة التقليدية للأغراض العامة. يقدم هذا المقال شرحًا متعمقًا لآلية عمل وحدات Groq LPU، ويحلل كيفية تأثير SRAM والتنفيذ الحتمي والمترجمات في أداء الاستدلال، ويناقش سيناريوهات استخدامها وقيودها التقنية.
النقاط الرئيسية
-
Groq LPU هو معالج مخصص لأحمال عمل استدلال الذكاء الاصطناعي، مع التركيز على زمن الاستجابة المنخفض والتنفيذ القابل للتنبؤ ونقل البيانات بكفاءة.
-
يتكون استدلال نماذج اللغة الكبيرة عمومًا من مرحلتين: التعبئة المسبقة (Prefill) وفك الترميز (Decode). ولهاتين المرحلتين متطلبات مختلفة من قدرة الحوسبة وعرض نطاق الذاكرة.
-
تستخدم وحدات Groq LPU ذاكرة SRAM المدمجة في الشريحة لتقصير بعض مسارات الوصول إلى البيانات، إلا أن سعتها التخزينية المحدودة نسبيًا داخل الشريحة تفرض أيضًا متطلبات على نشر النماذج والتوسع متعدد الشرائح.
-
يمكن للتنفيذ الحتمي والجدولة الثابتة عبر المترجم تقليل بعض أعباء الجدولة أثناء التشغيل، لكنهما لا يعنيان أن كل طلب سيحصل على زمن استجابة مطابق تمامًا.
-
تتمتع وحدات LPU بمزايا محتملة في التطبيقات منخفضة زمن الاستجابة، مثل توليد النصوص في الوقت الفعلي والتفاعلات الصوتية. ولا يزال أداؤها الفعلي يعتمد على النموذج وحمل العمل وتكوين النظام وتسعير الخدمة.
ما هي Groq LPU؟ وكيف تختلف عن مسرّعات الذكاء الاصطناعي التقليدية؟
Groq LPU هو معالج مخصص لاستدلال الذكاء الاصطناعي صممته Groq. ويرمز LPU إلى وحدة معالجة اللغة. ويهدف تصميمه إلى تحسين حركة البيانات وتنفيذ العمليات الحاسوبية والتحكم في زمن الاستجابة ضمن استدلال نماذج اللغة، بدلًا من توفير قدرات حوسبة عامة لكل أنواع المهام.
لفهم التموضع التقني لوحدات LPU، يجب أولًا إدراك اختلاف مناهج التصميم المستخدمة في مسرّعات الذكاء الاصطناعي. صُممت وحدات GPU في الأصل أساسًا لمعالجة الرسومات، ثم جرى اعتمادها على نطاق واسع لتدريب التعلم العميق والاستدلال بسبب قدراتها الحاسوبية المتوازية واسعة النطاق ومنظومتها البرمجية الناضجة. وتعزز المسرّعات المخصصة، مثل TPU، كفاءة تنفيذ مهام حوسبة محددة عبر تحسين العمليات الخاصة بالتعلم الآلي.
تركز وحدات Groq LPU بصورة أكبر على التنسيق بين المترجم والعتاد. وتهدف بنيتها إلى تخطيط الحوسبة ونقل البيانات قبل تنفيذ النموذج، بما يمكّن الشريحة من إكمال المهام وفق جدول محدد مسبقًا، وبالتالي تقليل بعض الأعباء الناتجة عن الجدولة الديناميكية.
يرتبط هذا النهج التصميمي ارتباطًا وثيقًا باتجاه تقنية Tensor Streaming Processor (TSP) الذي قدمته Groq في مراحل تطورها المبكرة. فمن خلال تنظيم موارد الحوسبة والتخزين داخل الشريحة ومسارات نقل البيانات، يتيح المعالج تنفيذ عمليات النموذج بالتسلسل الذي يرتبه المترجم.
من المهم ملاحظة أن LPU ليست فئة صناعية معيارية لجميع معالجات نماذج اللغة، بل هي تسمية تقنية تستخدمها Groq. وقد تستخدم الشركات المصنعة المختلفة تصميمات شرائح مختلفة أو تحقق استدلالًا منخفض زمن الاستجابة عبر وحدات GPU أو ASIC أو مسرّعات مخصصة أخرى.
لذلك، يتطلب تقييم القيمة التقنية لوحدات Groq LPU أكثر من النظر إلى اسم المعالج. إذ يتطلب تحليل كيفية تعاملها مع الوصول إلى البيانات وجدولة الحوسبة والاتصال متعدد الشرائح أثناء الاستدلال.
لماذا تحتاج نماذج اللغة الكبيرة إلى حوسبة منخفضة زمن الاستجابة؟
يشير استدلال نماذج اللغة الكبيرة إلى العملية التي يتلقى فيها النموذج مدخلات ويستخدم معلماته المدربة لإنتاج مخرجات. وبالنسبة إلى نماذج اللغة الانحدارية الذاتية الشائعة، يتكون الاستدلال عمومًا من مرحلتين: التعبئة المسبقة (Prefill) وفك الترميز (Decode). تعالج مرحلة التعبئة المسبقة بصورة أساسية مطالبة المستخدم وتنشئ الحالة الحاسوبية المطلوبة للتوليد اللاحق. ونظرًا إلى أن هذه المرحلة تستطيع معالجة عدة رموز إدخال في الوقت نفسه، فإنها تتسم عمومًا بخصائص حوسبة متوازية قوية.
تُولّد مرحلة فك الترميز رموز الإخراج واحدًا تلو الآخر. ويحتاج النموذج عادةً إلى توقع الرمز التالي استنادًا إلى المدخلات الحالية والمحتوى المُولّد سابقًا، ولذلك توجد تبعيات بين خطوات التوليد المتعددة. ونتيجة لذلك، لا يمكن تنفيذ هذه الخطوات بالتوازي الكامل بالسهولة نفسها التي تتم بها بعض عمليات التدريب.
يعني هذا الاختلاف أنه لا يمكن قياس أداء الاستدلال باستخدام مقياس واحد.
زمن الوصول إلى الرمز الأول (TTFT) يقيس الوقت من بدء الطلب حتى توليد أول رمز في المخرجات. ويؤثر بصورة أساسية في المدة التي يشعر المستخدمون بأنهم ينتظرون خلالها الرد.
سرعة توليد الرموز تقيس عدد الرموز التي يستطيع النموذج توليدها لكل وحدة زمنية بعد أن يبدأ في إنتاج المخرجات. وهي تؤثر مباشرة في سلاسة توليد النص المستمر. ويركز معدل الإنتاجية على عدد الطلبات أو الرموز التي يستطيع النظام معالجتها خلال فترة محددة، ويعكس القدرة الإجمالية لخدمة الاستدلال على المعالجة تحت حمل تزامني مرتفع نسبيًا.
على سبيل المثال، قد تتمكن منصتا استدلال من تشغيل نموذج اللغة نفسه، لكن قد توفر المنصة A توليدًا أسرع للرموز لطلب مستخدم واحد، بينما تحقق المنصة B معدل إنتاجية إجماليًا أعلى عند معالجة مئات الطلبات في وقت واحد.
وهذا يعني أن زمن الاستجابة المنخفض ومعدل الإنتاجية المرتفع ليسا هدف الأداء نفسه تمامًا. فقد لا يتمتع النظام المحسن للتفاعل في الوقت الفعلي مع مستخدم واحد بالمزايا نفسها في كل سيناريو لمعالجة الدُفعات أو التزامن المرتفع.
بالنسبة إلى المساعدات الصوتية والترجمة في الوقت الفعلي وتطبيقات الذكاء الاصطناعي التفاعلية، يكتسب TTFT وسرعة التوليد المستمر أهمية خاصة. إذ يتوقع المستخدمون عمومًا أن يبدأ النظام بالاستجابة بسرعة وأن يواصل إنتاج محتوى طبيعي وسلس.
أما في مهام مثل تحليل المستندات دون اتصال بالإنترنت ومعالجة البيانات على دفعات، فقد يكون زمن الاستجابة الفوري لطلب فردي أقل أهمية. وقد تركز المؤسسات بدلًا من ذلك على معدل الإنتاجية الإجمالي وتكاليف المعالجة لكل وحدة.
تتمثل إحدى أولويات تصميم وحدات Groq LPU في تحسين كفاءة التنفيذ لأحمال عمل الاستدلال الحساسة لزمن الاستجابة.
كيف تستخدم وحدات Groq LPU ذاكرة SRAM لتحسين كفاءة الوصول إلى البيانات؟
لا يعتمد أداء معالجات الذكاء الاصطناعي الحديثة على عدد العمليات التي تستطيع وحداتها الحاسوبية تنفيذها فحسب، بل يعتمد أيضًا على قدرة البيانات على الوصول إلى تلك الوحدات في الوقت المناسب.
أثناء استدلال نماذج اللغة الكبيرة، تقرأ المعالجات أوزان النموذج مرارًا، وتصل إلى النتائج الوسيطة، وتحافظ على البيانات المرتبطة بالسياق. وإذا تعذر قراءة البيانات بسرعة كافية، فقد لا تتمكن حتى الشريحة ذات القدرة الحاسوبية النظرية المرتفعة من العمل بكامل طاقتها لأنها تنتظر البيانات.
تُعرف هذه المشكلة عادةً باسم عنق زجاجة الذاكرة.
تتمثل إحدى الخصائص المعمارية الرئيسية لوحدات Groq LPU في تركيزها على استخدام SRAM المدمجة في الشريحة (ذاكرة الوصول العشوائي الساكنة) لتخزين البيانات والوصول إليها.
توفر SRAM عمومًا زمن استجابة منخفضًا للوصول، ويمكن دمجها مباشرةً في شريحة المعالج. وبالمقارنة مع البيانات التي يتم الوصول إليها عبر واجهة ذاكرة خارجية، يمكن للتخزين داخل الشريحة تقصير مسارات نقل البيانات وتقليل بعض أعباء الوصول.
لفهم هذا التصميم، من المفيد مقارنة الخصائص الأساسية لذاكرة SRAM وذاكرة النطاق الترددي العالي (HBM).
| بُعد المقارنة |
SRAM |
HBM |
| الموقع المعتاد |
داخل شريحة المعالج |
مكدس ذاكرة مستقل ضمن حزمة المعالج |
| المزايا الرئيسية |
زمن استجابة منخفض للوصول وتكامل وثيق |
سعة أكبر وعرض نطاق إجمالي مرتفع |
| القيود الرئيسية |
تكلفة مساحة مرتفعة وسعة محدودة |
لا يزال الوصول إلى البيانات يتطلب واجهة ذاكرة |
| الاستخدامات المعتادة |
ذاكرة التخزين المؤقت وذاكرة العمل داخل الشريحة |
بيانات واسعة النطاق مثل أوزان النموذج والتفعيلات |
| الأهمية للاستدلال |
تحسين بعض مسارات الوصول إلى البيانات |
دعم نماذج أكبر وحالات حوسبية أكبر |
ومع ذلك، لا يمكن الافتراض ببساطة أن SRAM أسرع من HBM في كل الحالات، أو أن استخدام SRAM يلغي عنق زجاجة الذاكرة. إذ يعتمد الأداء الفعلي أيضًا على تخطيط البيانات وأنماط الوصول المتوازي وعرض نطاق الذاكرة وبنية النموذج.
تتمثل القيود الرئيسية لذاكرة SRAM في كثافة التخزين وتكلفة مساحة الشريحة. وبالنسبة إلى نماذج اللغة ذات العدد الكبير من المعلمات، لا تكفي SRAM الموجودة على معالج واحد عمومًا لاستيعاب جميع أوزان النموذج وحالات التشغيل.
لذلك تحتاج Groq إلى استخدام التنسيق متعدد الشرائح وتخصيص البيانات على مستوى النظام لتشغيل النماذج على أنظمة حوسبة أكبر. ويعني ذلك أن مزايا وحدات LPU لا تأتي بالكامل من SRAM الموجودة على شريحة فردية، بل تنتج من التصميم الشامل للتخزين داخل الشريحة وخطوط أنابيب الحوسبة وروابط الشرائح والمترجمات.
كيف يؤثر التنفيذ الحتمي وجدولة المترجم في أداء الاستدلال؟
يُعد التنفيذ الحتمي مفهومًا رئيسيًا آخر لفهم بنية Groq LPU. وتتمثل فكرته الأساسية في تحديد ترتيب تنفيذ العمليات الحاسوبية ومسارات نقل البيانات وتخصيص الموارد إلى أقصى حد ممكن قبل تشغيل البرنامج، مما يقلل الحاجة إلى اتخاذ قرارات جدولة مؤقتة أثناء التنفيذ.
في بنى الحوسبة التقليدية للأغراض العامة، يجب أن تتكيف المعالجات مع أنواع مختلفة من البرامج وأحمال العمل. ولتحسين استخدام الموارد، تشتمل الأنظمة عادةً على جدولة ديناميكية للمهام وإدارة للذاكرة المؤقتة وآليات أخرى أثناء التشغيل. وتوفر هذه التصميمات قدرًا كبيرًا من المرونة، لكنها قد تضيف أيضًا أعباء جدولة إضافية.
تستخدم وحدات Groq LPU نهجًا تصميميًا مختلفًا. فقبل تنفيذ النموذج، يحلل المترجم الرسم البياني الحسابي للنموذج وينشئ خطة تنفيذ للعمليات الحاسوبية وحركة البيانات. ثم يعمل المعالج وفقًا لهذه الخطة، ما يتيح انتقال البيانات بين الوحدات الحاسوبية المختلفة بصورة منظمة. فعلى سبيل المثال، قد يحتاج نموذج اللغة إلى إجراء عمليات المصفوفات ودوال التفعيل وعمليات حسابية أخرى باستمرار. ويمكن للمترجم ترتيب وقت تشغيل هذه المهام مسبقًا على موارد حوسبة مختلفة وتنسيق عمليات نقل البيانات المطلوبة.
يشبه هذا النهج التخطيط المسبق لكل خطوة على خط إنتاج، بحيث تعمل المراحل المختلفة معًا وفق إيقاع محدد مسبقًا.
بالنسبة إلى استدلال الذكاء الاصطناعي، ينطوي التنفيذ الحتمي على ثلاث دلالات رئيسية.
-
يمكنه تقليل بعض أعباء الجدولة أثناء التشغيل. فلا يحتاج المعالج إلى إعادة تحديد ترتيب تنفيذ كل مهمة في كل مرحلة حوسبة، ما قد يساعد في تحسين كفاءة التنفيذ لأحمال عمل محددة.
-
يمكنه جعل أوقات تنفيذ الحوسبة أكثر قابلية للتنبؤ. وبالنسبة إلى خدمات الذكاء الاصطناعي في الوقت الفعلي، فإن اتساق أداء الاستجابة لا يقل أهمية عن انخفاض متوسط زمن الاستجابة. ولا يعني التنفيذ الحتمي أن زمن استجابة طلبات API الفعلية سيكون ثابتًا تمامًا. إذ يمكن أن يؤدي طول المدخلات وعدد رموز الإخراج واصطفاف الطلبات ونقل الشبكة وحمل الخدمة إلى اختلافات في زمن الاستجابة من طرف إلى طرف.
-
قد تقلل الجدولة الثابتة أيضًا مرونة بعض المهام الحاسوبية. فإذا كان النموذج يتضمن تدفق تحكم ديناميكيًا معقدًا أو كان مسار التنفيذ بحاجة إلى التغير بصورة متكررة وفق النتائج في الوقت الفعلي، فقد يحتاج المترجم إلى استخدام استراتيجيات معالجة إضافية.
لذلك، لا تكمن قيمة التنفيذ الحتمي في إزالة جميع أوجه عدم اليقين، بل في تحسين كفاءة استخدام موارد العتاد من خلال تخطيط تنفيذ أكثر وضوحًا للمهام الحاسوبية المناسبة.
لماذا تناسب وحدات Groq LPU استدلال الذكاء الاصطناعي منخفض زمن الاستجابة؟
لا يعتمد تصميم وحدات Groq LPU منخفض زمن الاستجابة على تقنية واحدة. بل ينتج عن التأثيرات المجمعة لذاكرة SRAM المدمجة في الشريحة والتنفيذ الحتمي وتحسين المترجم والربط البيني على مستوى النظام. أثناء توليد نماذج اللغة الكبيرة، يجب على النموذج إجراء العمليات الحسابية باستمرار وتوليد الرموز اللاحقة بناءً على النتائج الحالية. وإذا تمكن المعالج من تقليل بعض تأخيرات الوصول إلى البيانات وأعباء الجدولة أثناء التشغيل، فقد يقصر الوقت المطلوب لخطوات التوليد المتتابعة.
يتعلق هذا بصورة خاصة بمرحلة فك الترميز. فنظرًا إلى أن النماذج الانحدارية الذاتية تحتاج عمومًا إلى توليد الرموز واحدًا تلو الآخر، يتراكم زمن استجابة كل خطوة توليد ويؤثر في نهاية المطاف في سرعة إخراج النص التي يدركها المستخدمون. ومع ذلك، ليست اختناقات الأداء لمهام الاستدلال المختلفة متماثلة دائمًا. فقد تعتمد معالجة المطالبات الطويلة بدرجة أكبر على قدرات الحوسبة المتوازية واسعة النطاق، بينما قد يتأثر التوليد المستمر أكثر بالوصول إلى الذاكرة وزمن الاستجابة للتنفيذ خطوة بخطوة.
لذلك، يجب تقييم الأداء الفعلي لوحدات Groq LPU بالجمع بين نوع النموذج وطول المدخلات وطول المخرجات وعدد الطلبات المتزامنة.
من منظور التطبيقات، تكون الأنواع التالية من الخدمات حساسة بصورة خاصة للاستدلال منخفض زمن الاستجابة.
التفاعلات الصوتية في الوقت الفعلي. يحتاج المساعد الصوتي إلى تحويل كلام المستخدم إلى نص، واستدعاء نموذج لغة لتوليد استجابة، ثم إنتاج النتيجة عبر تركيب الكلام. وإذا كان نموذج اللغة يولد الاستجابات ببطء، فقد تشهد المحادثة فترات توقف ملحوظة.
وكلاء الذكاء الاصطناعي التفاعليون. عند تنفيذ المهام، قد يحتاج وكيل الذكاء الاصطناعي إلى استدعاء نموذج اللغة عدة مرات لتحديد الإجراء التالي. ويؤثر كل تأخير في الاستدلال في الوقت الإجمالي لإكمال المهمة، لذا قد يؤدي تقليل وقت انتظار الاستدلالات الفردية إلى تحسين تجربة المستخدم.
خدمة العملاء الذكية والتطبيقات في الوقت الفعلي. لا تحتاج الخدمات عبر الإنترنت التي تخدم أعدادًا كبيرة من المستخدمين إلى الاستجابة السريعة فحسب، بل تحتاج أيضًا إلى التحكم في تقلبات زمن الاستجابة بين الطلبات للحفاظ على جودة خدمة مستقرة.
ومع ذلك، لا يعني انخفاض زمن الاستجابة بالضرورة أقل تكلفة حوسبة لكل وحدة. فعلى سبيل المثال، قد تعالج منصة استدلال طلبًا فرديًا بسرعة عالية، لكن إذا كانت تكلفة اقتناء عتادها مرتفعة أو بقيت موارد كبيرة خاملة عند انخفاض الحمل، فقد تستمر تكلفة خدمتها الفعلية لكل مليون رمز في تجاوز تكلفة حلول أخرى. وعلى العكس، قد تولد منصة أخرى الرموز ببطء أكبر للطلبات الفردية، لكنها تخدم عددًا كبيرًا من المستخدمين في الوقت نفسه عبر المعالجة على دفعات، محققة في النهاية تكلفة متوسطة أقل.
لذلك، عند اختيار منصة استدلال، تحتاج المؤسسات إلى موازنة زمن الاستجابة ومعدل الإنتاجية والتكلفة وتوافق النموذج، بدلًا من اتخاذ قرار استنادًا إلى عدد الرموز في الثانية فقط.
ما القيود التقنية لوحدات Groq LPU؟
على الرغم من أن وحدات Groq LPU محسنة خصيصًا لاستدلال الذكاء الاصطناعي، فإن البنية المخصصة لا تعني أنها ستتفوق على الحلول الأخرى في كل مهمة حوسبية. وتشمل قيودها التقنية الرئيسية سعة الذاكرة والتوسع متعدد الشرائح وتوافق النماذج وتكلفة النظام.
قيود سعة SRAM داخل الشريحة. نظرًا إلى أن SRAM ذات كثافة تخزين منخفضة نسبيًا، فإن حجم التخزين المتاح داخل الشريحة الواحدة محدود. وعندما تتجاوز معلمات النموذج وحالات التشغيل سعة شريحة واحدة، يجب توزيع الحوسبة والبيانات عبر نظام متعدد الشرائح.
فعلى سبيل المثال، قد يتطلب نموذج لغة كبير عشرات الغيغابايتات من التخزين أو أكثر. ومن الصعب عمومًا تخزين كل هذه البيانات باستخدام SRAM داخل شريحة واحدة فقط. لذا يجب على النظام توزيع النموذج عبر معالجات متعددة واستخدام الروابط البينية بين الشرائح لإجراء عمليات تبادل البيانات اللازمة.
يمكن لهذا النهج زيادة حجم النماذج التي يمكن نشرها، لكنه يزيد أيضًا من تعقيد تصميم النظام.
أعباء الاتصال متعدد الشرائح. حتى إذا استطاعت وحدة LPU فردية تنفيذ العمليات الحسابية بسرعة، فقد تظل سرعة الاستدلال الإجمالية متأثرة بعرض نطاق الربط البيني وزمن استجابة الاتصال واستراتيجيات تخصيص البيانات، عندما يتطلب النموذج نقل البيانات بصورة متكررة بين الشرائح. وفي أنظمة الاستدلال واسعة النطاق، لا يعتمد الأداء على القدرة الحاسوبية لمعالج فردي فحسب، بل أيضًا على التشغيل المنسق لمجموعة الشرائح بأكملها.
توافق النماذج. تعتمد وحدات Groq LPU على المترجمات لربط عمليات النموذج الحسابية بالعتاد المخصص، ولذلك تتطلب دعمًا برمجيًا مناسبًا. وعندما تقدم نماذج ذكاء اصطناعي جديدة مشغلات حوسبة أو آليات انتباه أو أساليب تنفيذ ديناميكية مختلفة، قد تحتاج المنصة إلى تحديث مترجمها وبيئة التشغيل الخاصة بها. وبالمقارنة مع وحدات GPU للأغراض العامة التي تمتلك منظومات برمجية واسعة، تتطلب معالجات الاستدلال المخصصة تطويرًا برمجيًا مستمرًا للتكيف مع تقنيات النماذج المتغيرة بسرعة.
تكاليف البنية التحتية والتكاليف التجارية. تتطلب مزايا أداء وحدات LPU نظام حوسبة متكاملًا. ولا يزال النشر الفعلي يتضمن تكاليف تصنيع الشرائح والخوادم والشبكات والطاقة ومرافق التبريد. وبالنسبة إلى مزودي خدمات الاستدلال السحابية، يحدد استخدام المعدات وطلب العملاء أيضًا العائد على الاستثمار.
لذلك، ينبغي تقييم وحدات Groq LPU مع ظروف نشرها الفعلية. إذ إن سرعة توليد رموز مرتفعة في اختبار معين لا تثبت مباشرةً كفاءة تكلفة أعلى عبر جميع النماذج والسيناريوهات التجارية.
ماذا تعني وحدات Groq LPU لمستقبل البنية التحتية لاستدلال الذكاء الاصطناعي؟
يعكس تطوير وحدات Groq LPU التخصص المتزايد في سوق حوسبة الذكاء الاصطناعي. ومع توسع تطبيقات الذكاء الاصطناعي التوليدي، بدأت المؤسسات في اختيار بنى حوسبة أكثر تخصصًا بناءً على أحمال العمل المختلفة، بدلًا من التركيز فقط على الأداء النظري الأقصى لمعالج واحد.
في تدريب النماذج، تظل الحوسبة المتوازية واسعة النطاق وسعة الذاكرة والاتصال بين أجهزة متعددة مهمة. أما في الاستدلال، فقد أصبحت TTFT وسرعة التوليد المستمر ومعدل الإنتاجية المتزامن والتكلفة لكل رمز مقاييس تجارية أكثر مباشرة.
تتيح الاختلافات بين المهام الحاسوبية مجالًا لتطور شرائح الاستدلال المخصصة. وفي الوقت نفسه، لا تربط المعالجات المخصصة ووحدات GPU بالضرورة علاقة استبدال بحتة. ففي مارس 2026، قدمت NVIDIA بنية استدلال تجمع بين Groq 3 LPX ومنصة Vera Rubin، لاستكشاف كيفية تعامل أنواع مختلفة من أجهزة الحوسبة مع مهام الاستدلال المناسبة لخصائص كل منها.
يعكس هذا الاتجاه مسار تطور الحوسبة غير المتجانسة. وفي المستقبل، قد تنشر مراكز بيانات الذكاء الاصطناعي وحدات GPU ومسرّعات استدلال مخصصة وأجهزة حوسبة أخرى في الوقت نفسه، مع تنسيق الأنظمة البرمجية لتنفيذ مهام مختلفة.
فعلى سبيل المثال، يمكن استخدام موارد GPU المناسبة لأحمال العمل التي تتطلب معالجة متوازية واسعة النطاق، بينما قد توفر معالجات الاستدلال المخصصة مزايا لبعض مهام التوليد شديدة الحساسية لزمن الاستجابة. ومع ذلك، لا تعني الحوسبة غير المتجانسة أن مجرد إضافة أنواع أكثر من الشرائح سيحسن الكفاءة. إذ يجب على الأنظمة أيضًا معالجة الاتصال عبر الأجهزة وجدولة المهام وتوافق البرمجيات وتكاليف البنية التحتية.
بالنسبة إلى صناعة شرائح الذكاء الاصطناعي، يعني ذلك أن المنافسة تتوسع من أداء مكونات العتاد الفردية إلى كفاءة أنظمة الحوسبة المتكاملة. وقد تصبح بنية المعالج والمترجمات وأنظمة الذاكرة وتقنيات الربط البيني وعمليات الخدمات السحابية عوامل تحدد الأداء النهائي والقيمة التجارية.
يوفر النهج التقني الذي تمثله وحدات Groq LPU مثالًا محددًا على هذا التحول. ولن تعتمد قيمتها على المدى الطويل على سرعة استدلال جيل معين من الشرائح فحسب، بل أيضًا على قدرتها على مواصلة التكيف مع تطور النماذج وتحويل الأداء التقني إلى خدمات حوسبة مستقرة وقابلة للتوسع.
الخلاصة
Groq LPU هو معالج مخصص لاستدلال الذكاء الاصطناعي. ويستخدم تقنيات مثل SRAM المدمجة في الشريحة والتنفيذ الحتمي والجدولة الثابتة عبر المترجم لتحسين الوصول إلى البيانات وتنفيذ الحوسبة لأحمال عمل محددة لنماذج اللغة الكبيرة.
وبالمقارنة مع وحدات GPU للأغراض العامة، تركز وحدات Groq LPU بدرجة أكبر على انخفاض زمن الاستجابة وقابلية التنبؤ بالتنفيذ لمهام استدلال محددة. ويصلح هذا التصميم لاستكشاف تحسين الأداء في تطبيقات مثل توليد النصوص في الوقت الفعلي والتفاعلات الصوتية ووكلاء الذكاء الاصطناعي، لكنه لا يعني أن وحدات LPU يمكن أن تحل محل وحدات GPU في كل سيناريو للنماذج والحوسبة.
وفي الوقت نفسه، تظل سعة SRAM والاتصال متعدد الشرائح وتكييف النماذج وتكاليف البنية التحتية مسائل مهمة يجب أن تعالجها بنى الاستدلال المخصصة.
ومع توسع قطاع الذكاء الاصطناعي من تطوير النماذج إلى التطبيقات واسعة النطاق، تتحول المنافسة في حوسبة الاستدلال من مجرد تعظيم القدرة الحاسوبية إلى تحسين زمن الاستجابة ومعدل الإنتاجية والتكلفة وكفاءة النظام الإجمالية. ويبين تطوير وحدات Groq LPU أن المسرّعات المخصصة قد تؤدي دورًا أكثر أهمية في البنية التحتية المستقبلية للذكاء الاصطناعي، لكن قيمتها الفعلية لا تزال بحاجة إلى التحقق من خلال أحمال عمل محددة ونتائج النشر التجاري.
الأسئلة الشائعة
ما هي Groq LPU؟
Groq LPU هو معالج مخصص لاستدلال الذكاء الاصطناعي صممته Groq. ويستخدم بصورة أساسية تقنيات مثل SRAM المدمجة في الشريحة والتنفيذ الحتمي وجدولة المترجم لتحسين مهام استدلال محددة لنماذج اللغة.
ما الفروق الرئيسية بين وحدات LPU ووحدات GPU؟
تركز وحدات LPU بدرجة أكبر على تحسين التنفيذ ونقل البيانات لمهام استدلال محددة، بينما توفر وحدات GPU قدرات حوسبة متوازية واسعة ومنظومة برمجية ناضجة. وتعتمد فروق أدائها على النموذج المحدد وبيئة التشغيل.
لماذا تستخدم وحدات Groq LPU ذاكرة SRAM؟
توفر SRAM وصولًا منخفض زمن الاستجابة إلى البيانات داخل الشريحة، ما قد يساعد في تقليل أعباء قراءة البيانات في بعض مهام الاستدلال. ومع ذلك، فإن سعة SRAM محدودة، لذا يتطلب نشر النماذج الكبيرة عمومًا تنسيقًا متعدد الشرائح.
ماذا يعني التنفيذ الحتمي؟
يعني التنفيذ الحتمي تخطيط ترتيب الحوسبة ونقل البيانات وتخصيص الموارد إلى أقصى حد ممكن قبل تشغيل البرنامج. ويمكن أن يقلل ذلك من بعض أعباء الجدولة أثناء التشغيل، ويجعل تنفيذ الحوسبة أكثر قابلية للتنبؤ.
هل يمكن استخدام وحدات Groq LPU لتدريب نماذج الذكاء الاصطناعي؟
صُممت وحدات Groq LPU أساسًا لأحمال عمل الاستدلال، وليست مخصصة بالدرجة الأولى لتدريب النماذج واسعة النطاق للأغراض العامة. ويعتمد دعمها الفعلي على بنية العتاد وسلسلة أدوات البرمجيات.
هل تكون وحدات Groq LPU أسرع دائمًا من وحدات NVIDIA GPU في الاستدلال؟
ليس بالضرورة. إذ يمكن أن تؤثر النماذج المختلفة وأطوال المدخلات وأطوال المخرجات ومستويات التزامن وبيئات الاختبار في النتائج. ولا تعني سرعة توليد رموز أعلى لمستخدم واحد بالضرورة معدل إنتاجية إجماليًا أفضل أو تكاليف أقل لكل رمز.
لماذا تناسب وحدات Groq LPU وكلاء الذكاء الاصطناعي؟
قد يحتاج وكلاء الذكاء الاصطناعي إلى إجراء عدة استدعاءات استدلال بالتسلسل. وقد يؤدي تقليل زمن استجابة كل طلب إلى تقصير وقت تنفيذ المهمة الإجمالية، لكن النتيجة النهائية تعتمد أيضًا على استدعاءات الأدوات ونقل الشبكة ومراحل المعالجة الأخرى.