


老叶1999.eth

用户暂无简介
【上新】DeepSeek 满血模型上线,全部 5 折!
现已上线国内大厂直供的 DeepSeek 满血模型,本次上新包括:
DeepSeek-V4-1-Flash-0910
DeepSeek-V4-Pro-0813
DeepSeek-V4-Flash-0731
以上模型全部 5 折,质量媲美官方,服务稳定,可用于生产环境!
👉 详细模型 ID 及价格:
现已上线国内大厂直供的 DeepSeek 满血模型,本次上新包括:
DeepSeek-V4-1-Flash-0910
DeepSeek-V4-Pro-0813
DeepSeek-V4-Flash-0731
以上模型全部 5 折,质量媲美官方,服务稳定,可用于生产环境!
👉 详细模型 ID 及价格:
- 1
OpenAI 风控升级,这降智是装都不装了!
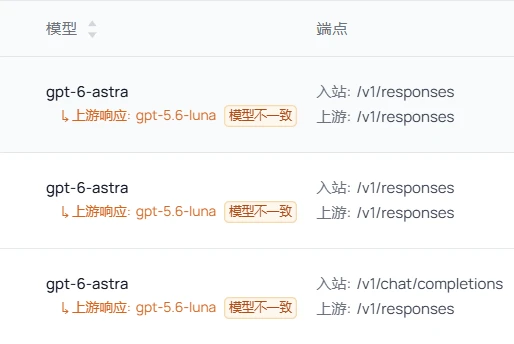
今天突然发现个别账户响应模型异常,明明访问的是 GPT-6 Astra 上游 OpenAI 实际响应的模型却是 GPT-5.6-luna。
我仔细排查了一下,出现这种问题的账户,虽然只有少数几个,但是这种迹象表明 ,OpenAI 可能是开始灰度测试这种新的降智方式。
在我中转站使用服务的用户,出现了上述情况的,将会自动获得原价补偿。
并且我们已将该种异常情况纳入监测,其他异常还包括:频繁过载、频繁429限流以及出现降智的账户,我们都会自动停止该账户调度。
目前,OpenAI 的种种风控手段,主要还是 GPT-6 Astra 太受欢迎了,算力不足了。所以先是停止 PROx20套餐的订阅,再用各种手段限制分发,导致中转站的成本越来越高,以及稳定性的下降,迫使更多的企业转向使用其高昂的原价 API。
这场矛与盾的较量恐怕还会继续。希望国产模型早日迎头赶超,让用户多一些选择,少一些被动。
今天突然发现个别账户响应模型异常,明明访问的是 GPT-6 Astra 上游 OpenAI 实际响应的模型却是 GPT-5.6-luna。
我仔细排查了一下,出现这种问题的账户,虽然只有少数几个,但是这种迹象表明 ,OpenAI 可能是开始灰度测试这种新的降智方式。
在我中转站使用服务的用户,出现了上述情况的,将会自动获得原价补偿。
并且我们已将该种异常情况纳入监测,其他异常还包括:频繁过载、频繁429限流以及出现降智的账户,我们都会自动停止该账户调度。
目前,OpenAI 的种种风控手段,主要还是 GPT-6 Astra 太受欢迎了,算力不足了。所以先是停止 PROx20套餐的订阅,再用各种手段限制分发,导致中转站的成本越来越高,以及稳定性的下降,迫使更多的企业转向使用其高昂的原价 API。
这场矛与盾的较量恐怕还会继续。希望国产模型早日迎头赶超,让用户多一些选择,少一些被动。
- 2
- 1
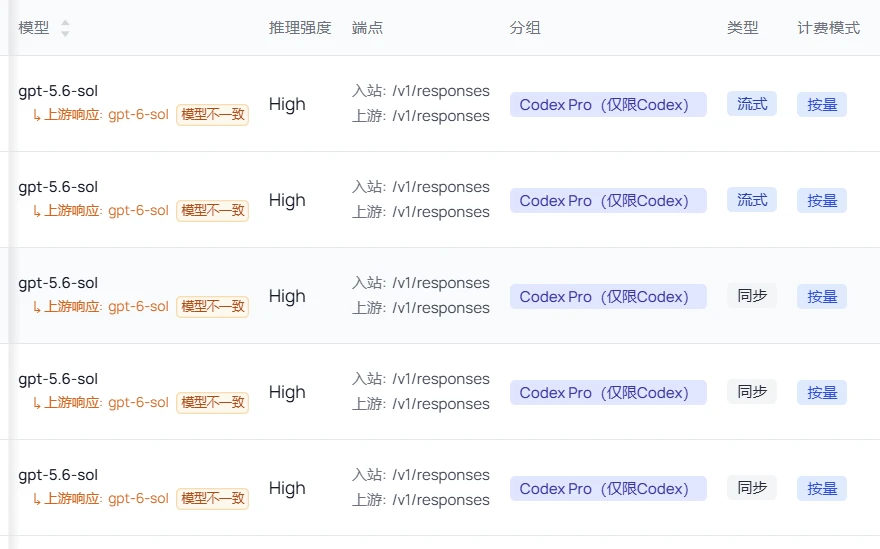
OpenAI 已经偷偷在灰度 GPT-6 Sol,我们很多请求 5.6-sol 实际都是在调用 GPT-6 Sol。
看来官方很快就会发布这个新模型了,而且我估计智商仅次于 GPT-6 Astra ,但是价格会跟 GPT-5.6 Sol 保持一致,还是挺香的。
看来官方很快就会发布这个新模型了,而且我估计智商仅次于 GPT-6 Astra ,但是价格会跟 GPT-5.6 Sol 保持一致,还是挺香的。
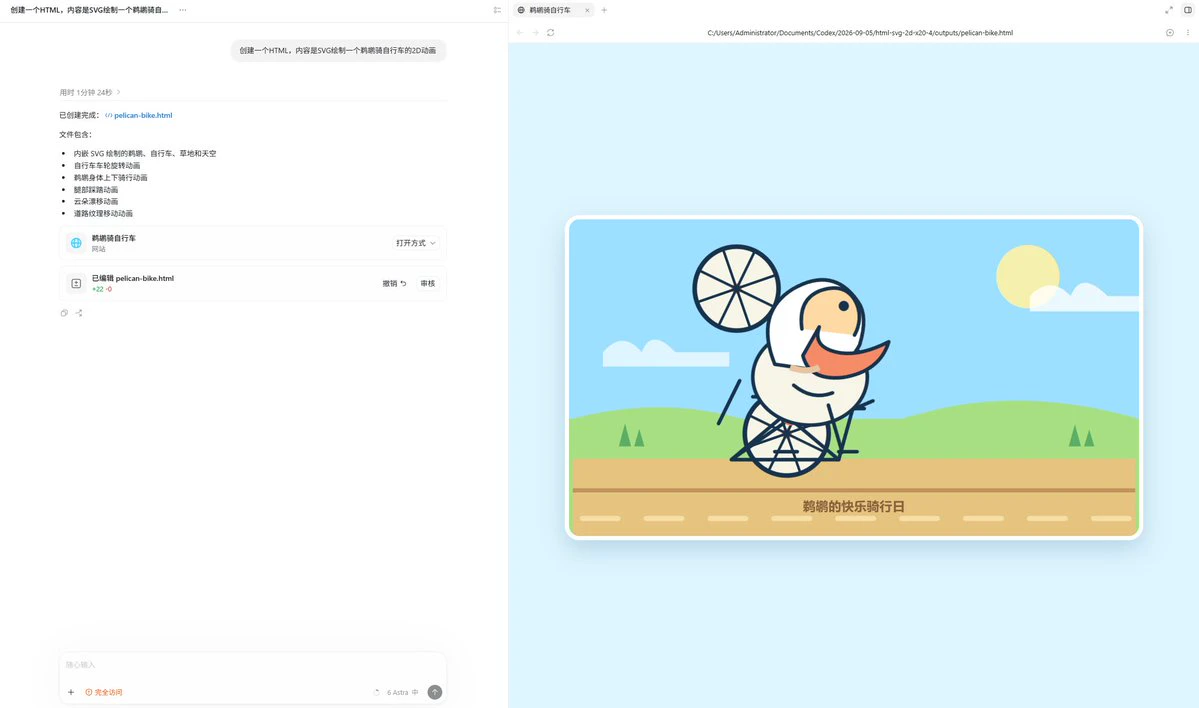
听说 GPT 6 Astra 前端很强!
试了一下,怎么感觉画风不太对?
试了一下,怎么感觉画风不太对?
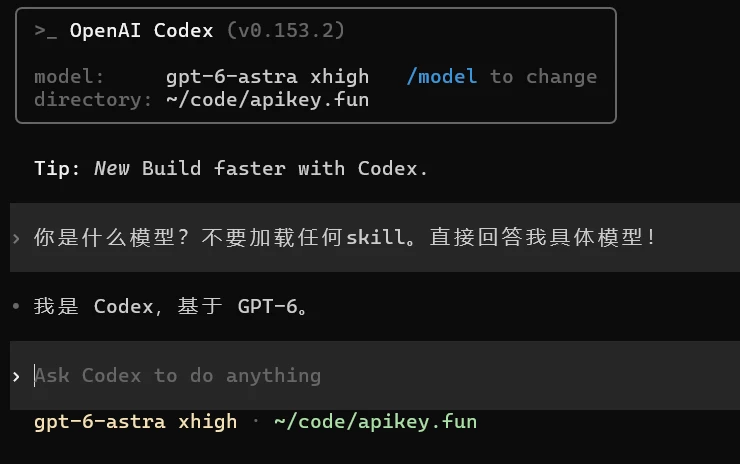
🚨 GPT-6-Astra 已悄悄在 Pro 套餐开放使用了!
先将 Codex CLI 和 App 更新到最新版。虽然网页端暂时还看不到模型切换入口,但 Codex 已经可以抢先使用。
如果界面里没有显示,直接修改:
~/.codex/config.toml
model = "gpt-6-astra"
review_model = "gpt-6-astra"
保存后重启 Codex 即可尝试。
网页端还没跟上,CLI 用户已经可以先用起来了。
#Codex #GPT6Astra #OpenAI
先将 Codex CLI 和 App 更新到最新版。虽然网页端暂时还看不到模型切换入口,但 Codex 已经可以抢先使用。
如果界面里没有显示,直接修改:
~/.codex/config.toml
model = "gpt-6-astra"
review_model = "gpt-6-astra"
保存后重启 Codex 即可尝试。
网页端还没跟上,CLI 用户已经可以先用起来了。
#Codex #GPT6Astra #OpenAI
现在的 AI 已经很强了,但有时还是会强得很荒诞。
去理发,我提醒 Tony:“别动我的眉毛。”
Tony:“本来也不会动。”
我:“那就好。”
Tony:“不过既然你提了,剪完我再加一道验收流程,确认两条眉毛都还在。”
这就是 GPT-5.6-sol:
你提醒它别做一件本来就没做的事,它马上补一个单元测试,证明自己确实没做。
去理发,我提醒 Tony:“别动我的眉毛。”
Tony:“本来也不会动。”
我:“那就好。”
Tony:“不过既然你提了,剪完我再加一道验收流程,确认两条眉毛都还在。”
这就是 GPT-5.6-sol:
你提醒它别做一件本来就没做的事,它马上补一个单元测试,证明自己确实没做。
豆包 —— 你的理财专家!
你值得拥有!
你值得拥有!
豆包 —— 你的理财专家!
也没那么差嘛,不要崇洋媚外好吗?😅
也没那么差嘛,不要崇洋媚外好吗?😅
DeepSeek 曾经对她爱搭不理,现在的她你有点高攀不起!
grok 4.6 也来了!
它几乎跟 DeepSeek-V4-Pro-0813 同时发布!
说实话看到 grok 4.6 的参数,我还是挺激动的!grok 4.5 就已经是我日常最喜欢的模型之一了,因为它的速度真的非常快,而且他没有那么多限制,非常适合日常使用。
然而这次的 grok 4.6 直接拉到与头部两家旗舰模型很接近的参数,并且拥有比他们更快的速度。
老马的 grok 这次是真的上桌了!我觉得它真的能顶替 成为新的御三家选手!
它几乎跟 DeepSeek-V4-Pro-0813 同时发布!
说实话看到 grok 4.6 的参数,我还是挺激动的!grok 4.5 就已经是我日常最喜欢的模型之一了,因为它的速度真的非常快,而且他没有那么多限制,非常适合日常使用。
然而这次的 grok 4.6 直接拉到与头部两家旗舰模型很接近的参数,并且拥有比他们更快的速度。
老马的 grok 这次是真的上桌了!我觉得它真的能顶替 成为新的御三家选手!

官宣了!DeepSeek-V4-Pro-0813 马上来了!
就在刚刚,DeepSeek 官网的文档已经把 DeepSeek-V4-Pro 正式版的模型ID公布出来了,根据上面的日期,定档时间应该就是 8月13日。
并且 V4-Pro 正式版,也开始支持 Responses API,可以直接在 codex 上面使用,而不需要任何转换。
就在刚刚,DeepSeek 官网的文档已经把 DeepSeek-V4-Pro 正式版的模型ID公布出来了,根据上面的日期,定档时间应该就是 8月13日。
并且 V4-Pro 正式版,也开始支持 Responses API,可以直接在 codex 上面使用,而不需要任何转换。
炸了,OpenAI 这波有点狠。
Pro x20 套餐刚重置完额度,我一看直接傻眼了
周限额度疑似只剩之前的 1/3。
不是小砍,是直接砍到肉里。
最近两天 OpenAI 的模型访问一直在过载,动不动就卡、限流、排队。
所以现在就两个可能:
要么是额度配置出 Bug 了,
要么就是 OpenAI 真扛不住了,开始主动收紧 Pro 用户额度。
如果是后者,那 Pro x20 这个套餐的性价比就得重新算了。
不知道是不是个例。
有 x20 的兄弟看下自己额度,看看是不是也被砍了。
Pro x20 套餐刚重置完额度,我一看直接傻眼了
周限额度疑似只剩之前的 1/3。
不是小砍,是直接砍到肉里。
最近两天 OpenAI 的模型访问一直在过载,动不动就卡、限流、排队。
所以现在就两个可能:
要么是额度配置出 Bug 了,
要么就是 OpenAI 真扛不住了,开始主动收紧 Pro 用户额度。
如果是后者,那 Pro x20 这个套餐的性价比就得重新算了。
不知道是不是个例。
有 x20 的兄弟看下自己额度,看看是不是也被砍了。
新版 Codex App 使用第三方 API 无法生图,解决方法来了。
最近不少人应该都遇到了这个问题:
在新版 Codex App 里接入中转站 API 后,调用内置的 imagegen 技能时,模型看起来已经完成了生图,但图片就是不会在客户端里显示。
一开始我还以为是第三方 API 没有正确返回图片,后来对 Codex 的配置和请求逻辑做了一些分析,才发现问题出在新版客户端对第三方 Provider 的权限校验上。
目前网上好像还没有看到比较完整的公开解决方案,所以先把我们测试可用的方法分享出来。
方法一:手动修改 config.toml
首先找到 Codex 的配置文件:
Windows:
C:\Users\Administrator\.codex\config.toml
注意:其中的 Administrator 需要替换成你自己电脑的 Windows 用户名。
例如你的用户名是 zhang,路径就是:
C:\Users\zhang\.codex\config.toml
macOS / Linux / WSL:
~/.codex/config.toml
建议修改之前,先备份一下原来的 config.toml。
然后将配置修改为:
model_provider = "custom"
model = "gpt-5.6-sol"
review_model = "gpt-5.6-so
最近不少人应该都遇到了这个问题:
在新版 Codex App 里接入中转站 API 后,调用内置的 imagegen 技能时,模型看起来已经完成了生图,但图片就是不会在客户端里显示。
一开始我还以为是第三方 API 没有正确返回图片,后来对 Codex 的配置和请求逻辑做了一些分析,才发现问题出在新版客户端对第三方 Provider 的权限校验上。
目前网上好像还没有看到比较完整的公开解决方案,所以先把我们测试可用的方法分享出来。
方法一:手动修改 config.toml
首先找到 Codex 的配置文件:
Windows:
C:\Users\Administrator\.codex\config.toml
注意:其中的 Administrator 需要替换成你自己电脑的 Windows 用户名。
例如你的用户名是 zhang,路径就是:
C:\Users\zhang\.codex\config.toml
macOS / Linux / WSL:
~/.codex/config.toml
建议修改之前,先备份一下原来的 config.toml。
然后将配置修改为:
model_provider = "custom"
model = "gpt-5.6-sol"
review_model = "gpt-5.6-so
深度体验了一整天 GPT-5.6-sol。
我的态度大概经历了三个阶段:
兴奋 → 质疑 → 理解并接受。
先说一个很容易被混淆的地方:
GPT-5.6-sol 本身最高的推理等级其实还是 xhigh,UI 里显示的 Max 和 Ultra,更多指的是客户端的工作流模式,并不只是单纯把模型“调得更聪明”。
今天 Ultra 被吐槽最多的地方,就是它很喜欢自动派发大量子代理。
哪怕只是一个不算复杂的任务,也可能瞬间拉起一堆代理,消耗大量 Token,整个过程看起来声势浩大,但实际收益未必能匹配成本。
我刚开始用的时候也有点怀疑:
这到底是在干活,还是在拿 Token 堆排场?
后来理解了它的机制,我把推理等级降到 High,又重新跑了一些真实任务,体验反而好了很多。
速度比 GPT-5.5 xhigh 更快,能力和稳定性又明显更强,Token 消耗也没有 Ultra 那么夸张。
至少以我今天的体验来看:
GPT-5.6-sol + High,可能才是目前最适合日常使用的组合。
复杂重构、全项目 Review、需要并行探索的大任务,可以再考虑 Ultra。
普通开发任务没必要一上来就拉满。
这个模型不是不能用,也不是一定要无脑开最高档。
真正的问题是,很多人还没搞清楚 Max、Ultra 和推理等级的区别,就已经开始拿 Ultra 当默认模式了。
用对了,确实比 5.5 强不少。
用错
我的态度大概经历了三个阶段:
兴奋 → 质疑 → 理解并接受。
先说一个很容易被混淆的地方:
GPT-5.6-sol 本身最高的推理等级其实还是 xhigh,UI 里显示的 Max 和 Ultra,更多指的是客户端的工作流模式,并不只是单纯把模型“调得更聪明”。
今天 Ultra 被吐槽最多的地方,就是它很喜欢自动派发大量子代理。
哪怕只是一个不算复杂的任务,也可能瞬间拉起一堆代理,消耗大量 Token,整个过程看起来声势浩大,但实际收益未必能匹配成本。
我刚开始用的时候也有点怀疑:
这到底是在干活,还是在拿 Token 堆排场?
后来理解了它的机制,我把推理等级降到 High,又重新跑了一些真实任务,体验反而好了很多。
速度比 GPT-5.5 xhigh 更快,能力和稳定性又明显更强,Token 消耗也没有 Ultra 那么夸张。
至少以我今天的体验来看:
GPT-5.6-sol + High,可能才是目前最适合日常使用的组合。
复杂重构、全项目 Review、需要并行探索的大任务,可以再考虑 Ultra。
普通开发任务没必要一上来就拉满。
这个模型不是不能用,也不是一定要无脑开最高档。
真正的问题是,很多人还没搞清楚 Max、Ultra 和推理等级的区别,就已经开始拿 Ultra 当默认模式了。
用对了,确实比 5.5 强不少。
用错
gpt-5.6-sol 还没用上的,真的赶紧去用。
我刚用 ultra 模式,把自己的中转站项目完整 review 了一遍。
耗时 1 小时 32 分钟,硬生生揪出了 19 个问题。
说实话,我人都看傻了。
我一直有个习惯:每次发版前必须做一次 review。原本以为项目已经挺干净了,结果还是挖出一堆历史遗留问题。
现在终于明白了:
gpt-5.5 留下的屎山,得靠 gpt-5.6 来擦。
至于 gpt-5.6 留下的屎山……
那就等 GPT-6.0 来擦吧。
我刚用 ultra 模式,把自己的中转站项目完整 review 了一遍。
耗时 1 小时 32 分钟,硬生生揪出了 19 个问题。
说实话,我人都看傻了。
我一直有个习惯:每次发版前必须做一次 review。原本以为项目已经挺干净了,结果还是挖出一堆历史遗留问题。
现在终于明白了:
gpt-5.5 留下的屎山,得靠 gpt-5.6 来擦。
至于 gpt-5.6 留下的屎山……
那就等 GPT-6.0 来擦吧。
gpt-5.6-sol 已经出现在 Codex 仓库的 models.json 文件中了。
我最关心的上下文大小也基本明确了:372K。相比上一代 gpt-5.5 的 272K,提升了大概 36.7%。
不过说实话,看到这个数字还是有点小遗憾。毕竟 opus 4.8 和 fable-5 都已经做到 1M 上下文了,372K 放在现在看确实不算特别夸张。
但好在 Codex 的压缩能力一直很强,长任务里多轮压缩之后,稳定性依然保持得不错。所以实际用起来,影响可能没有数字看上去那么大。
总的来说,算是稳步升级吧,但还是希望下一代能把上下文直接拉满。
我最关心的上下文大小也基本明确了:372K。相比上一代 gpt-5.5 的 272K,提升了大概 36.7%。
不过说实话,看到这个数字还是有点小遗憾。毕竟 opus 4.8 和 fable-5 都已经做到 1M 上下文了,372K 放在现在看确实不算特别夸张。
但好在 Codex 的压缩能力一直很强,长任务里多轮压缩之后,稳定性依然保持得不错。所以实际用起来,影响可能没有数字看上去那么大。
总的来说,算是稳步升级吧,但还是希望下一代能把上下文直接拉满。
gpt-5.6-sol 已经出现在 models.json 仓库里了。
我最关心的上下文大小也基本明确了:372K。相比上一代 gpt-5.5 的 272K,提升了大概 36.7%。
不过说实话,看到这个数字还是有点小遗憾。毕竟 opus 4.8 和 fable-5 都已经做到 1M 上下文了,372K 放在现在看确实不算特别夸张。
但好在 Codex 的压缩能力一直很强,长任务里多轮压缩之后,稳定性依然保持得不错。所以实际用起来,影响可能没有数字看上去那么大。
总的来说,算是稳步升级吧,但还是希望下一代能把上下文直接拉满。
我最关心的上下文大小也基本明确了:372K。相比上一代 gpt-5.5 的 272K,提升了大概 36.7%。
不过说实话,看到这个数字还是有点小遗憾。毕竟 opus 4.8 和 fable-5 都已经做到 1M 上下文了,372K 放在现在看确实不算特别夸张。
但好在 Codex 的压缩能力一直很强,长任务里多轮压缩之后,稳定性依然保持得不错。所以实际用起来,影响可能没有数字看上去那么大。
总的来说,算是稳步升级吧,但还是希望下一代能把上下文直接拉满。
热门话题
#GT突破11美元
30.1k 浏览量4.87k 人讨论中
#BTC突破84000美元
46.65k 浏览量18.3k 人讨论中
#GateVoyage
7.96k 浏览量9.31k 人讨论中
#加密货币总市值重返2.8万亿美元
42.43k 浏览量688 人讨论中
#Gate BTC及ETH持仓位居全网前二
45.72k 浏览量39.06k 人讨论中
#ETH突破2700美元
15.21k 浏览量761 人讨论中
#GarrettJin平仓ZEC空单亏损3613万美元
40.02k 浏览量745 人讨论中
#Strive持仓突破2.5万枚比特币
10.73k 浏览量1.38k 人讨论中
#Gate股票永续合约覆盖数量行业第一
41.3k 浏览量1.3k 人讨论中
#美联储卡什卡利称通胀仍过高
98.78k 浏览量3.24k 人讨论中